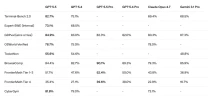
Con l'avanzamento dei grandi modelli linguistici nell'esecuzione di compiti complessi come il ragionamento, la ricerca automatizzata e la sicurezza informatica, i metodi tradizionali di valutazione dei modelli si trovano ad affrontare nuove sfide.Da tempo, il rilascio di un modello è accompagnato da una tabella di risultati che include vari test di benchmark, che spaziano dalla matematica, alla programmazione, alle domande scientifiche, alla sicurezza informatica e al ragionamento conoscitivo, e questi risultati vengono confrontati con quelli del modello precedente.