Noam Brown, científico de OpenAI: el verdadero límite de la IA, que nadie puede permitirse medir
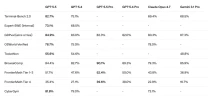
A medida que los grandes modelos de lenguaje comienzan a abordar tareas complejas como la inferencia, la investigación automatizada y la seguridad cibernética, los métodos tradicionales de evaluación de modelos se enfrentan a nuevos desafíos.Durante mucho tiempo, el lanzamiento de modelos ha ido acompañado de tablas de resultados que incluyen una variedad de pruebas de referencia relacionadas con matemáticas, programación, preguntas y respuestas científicas, seguridad cibernética, inferencia de conocimiento, etc., y se comparan con los modelos de la generación anterior.