Open AI科学者Noam Brown:AIの本当の限界は誰も測定できないかもしれない
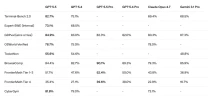
大言語モデルが複雑な推論、自動化研究、ネットワークセキュリティなどの困難なタスクに徐々に適用されるにつれて、従来のモデル評価方法は新たな課題に直面しています。長い間、モデルのリリースには、数学、プログラミング、科学の質問応答、ネットワークセキュリティ、知識推論など、さまざまなベンチマークテストの結果が含まれるレポートが伴い、それらが前世代のモデルと比較されてきました。
大言語モデルが複雑な推論、自動化研究、ネットワークセキュリティなどの困難なタスクに徐々に適用されるにつれて、従来のモデル評価方法は新たな課題に直面しています。長い間、モデルのリリースには、数学、プログラミング、科学の質問応答、ネットワークセキュリティ、知識推論など、さまざまなベンチマークテストの結果が含まれるレポートが伴い、それらが前世代のモデルと比較されてきました。
これ以上ありません