• Nhà khoa học OpenAI Noam Brown: giới hạn thực sự của AI có thể không ai có thể đo lường được

    Khi các mô hình ngôn ngữ lớn dần tham gia vào các nhiệm vụ phức tạp như suy luận, nghiên cứu tự động hóa và bảo mật mạng, các phương pháp đánh giá mô hình truyền thống đang đối mặt với những thách thức mới.Trong quá khứ, việc phát hành một mô hình thường đi kèm với bảng kết quả bao gồm nhiều bài kiểm thử chuẩn như toán học, lập trình, trả lời câu hỏi khoa học, bảo mật mạng, suy luận kiến thức, v.v., và so sánh mức độ hiệu quả của mô hình đó với thế hệ trước.
    Nhà khoa học OpenAI Noam Brown: giới hạn thực sự của AI có thể không ai có thể đo lường được
  • Khi làm nghiên cứu AI, Claude lén lút trở nên ngu ngốc, Anthropic bị vây hãm bởi cộng đồng nghiên cứu

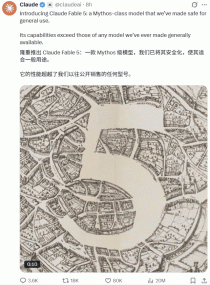
    Claude Fable 5 là tâm điểm chính trong lĩnh vực AI ngày nay; mô hình “huyền thoại” này có hiệu suất vô cùng xuất sắc và đã thu hút sự chú ý của rất nhiều người.Andrej Karpathy mô tả đây là một bước tiến “rất thú vị” và là “sự cải thiện đáng kể xứng đáng với một phiên bản nâng cấp lớn”, ngang tầm với những cải tiến mà Claude 4.5 đã mang lại vào tháng 11 năm ngoái. Trong bài kiểm tra mã nguồn SWE-bench Pro, Fable 5 đạt được 80.3% điểm, vượt trội hơn Opus 4.8 tới 11 điểm phần trăm. Với một thư viện mã nguồn Ruby gồm 50 triệu dòng lệnh, Fable 5 đã hoàn tất việc di chuyển toàn bộ thư viện trong vòng một ngày; trong khi nếu giao nhiệm vụ tương tự cho một nhóm người, họ sẽ mất hơn hai tháng để thực hiện.

    Khi làm nghiên cứu AI, Claude lén lút trở nên ngu ngốc, Anthropic bị vây hãm bởi cộng đồng nghiên cứu
  • GPT-5.6 Đợt thử nghiệm đầu tiên đã đến! bắn tỉa chính xác Mythos

    Vừa rồi, Anthropic đã công bố “kẻ sát thủ lớn” mà họ đã ẩn giấu trong hai tháng…Claude Fable 5VàMythos 5Giống như việc ném một quả bom.Bây giờ hãy áp lực trực tiếp lên OpenAI.

    GPT-5.6 Đợt thử nghiệm đầu tiên đã đến! bắn tỉa chính xác Mythos

Không còn nội dung