• นักวิทยาศาสตร์ OpenAI Noam Brown: ขีด จํากัด ที่แท้จริงของ AI อาจไม่มีใครสามารถวัดได้เลย

    เมื่อโมเดลภาษาขนาดใหญ่เริ่มเข้าสู่งานที่ซับซ้อน เช่น การอนุมาน การวิจัยอัตโนมัติ และความปลอดภัยทางไซเบอร์ วิธีการประเมินโมเดลแบบดั้งเดิมก็กำลังเผชิญกับความท้าทายใหม่ๆมาเป็นเวลานานแล้ว การเปิดตัวโมเดลมักจะมาพร้อมกับตารางผลลัพธ์ที่ประกอบด้วยการทดสอบมาตรฐานหลากหลายประเภท เช่น คณิตศาสตร์ การเขียนโปรแกรม คำถาม-คำตอบทางวิทยาศาสตร์ ความปลอดภัยทางไซเบอร์ และการอนุมานความรู้ และจะมีการเปรียบเทียบผลลัพธ์เหล่านั้นกับโมเดลรุ่นก่อนหน้า
    นักวิทยาศาสตร์ OpenAI Noam Brown: ขีด จํากัด ที่แท้จริงของ AI อาจไม่มีใครสามารถวัดได้เลย
  • เมื่อทำการวิจัยด้าน AI คลอด์ (Claude) มักจะทำตัวโง่ลงอย่างไม่คาดคิด และ Anthropic ก็ถูกวงการวิจัยโจมตีอย่างหนัก

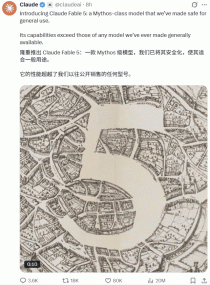
    Claude Fable 5 เป็นประเด็นร้อนแรงในวงการ AI ในวันนี้ โมเดล “ระดับตำนาน” นี้มีประสิทธิภาพที่ยอดเยี่ยม และได้รับความสนใจอย่างมากAndrej Karpathy เรียกมันว่า “น่าตื่นเต้นมาก” และเป็น “ความก้าวหน้าที่สำคัญที่คู่ควรกับการอัปเกรดเวอร์ชันใหญ่” ซึ่งอยู่ในระดับเดียวกับการปรับปรุงที่ Claude 4.5 นำมาในเดือนพฤศจิกายนปีที่แล้ว SWE-bench Pro ซึ่งเป็นเครื่องมือวัดประสิทธิภาพการเขียนโปรแกรม ให้คะแนน Fable 5 ได้ 80.3% ซึ่งสูงกว่า Opus 4.8 ถึง 11 จุดเปอร์เซ็นต์ Fable 5 มีคลังโค้ดที่มีขนาด 50 ล้านบรรทัดภาษา Ruby และสามารถทำการย้ายทั้งคลังโค้ดได้ภายในหนึ่งวัน ในขณะที่หากให้ทีมงานมนุษย์ทำงานเดียวกันนี้ จะต้องใช้เวลามากกว่าสองเดือน

    เมื่อทำการวิจัยด้าน AI คลอด์ (Claude) มักจะทำตัวโง่ลงอย่างไม่คาดคิด และ Anthropic ก็ถูกวงการวิจัยโจมตีอย่างหนัก
  • GPT-5.6 การทดสอบจริงครั้งแรกมา!ความแม่นยําตํานาน

    เมื่อสักครู่นี้ Anthropic ได้เปิดตัว “The Big Killer” ที่ถูกซ่อนเอาไว้เป็นเวลาสองเดือน…Claude Fable 5และMythos 5มันเหมือนกับการโยนระเบิดลงไปตอนนี้เราควรเริ่มกดดัน OpenAI โดยตรง

    GPT-5.6 การทดสอบจริงครั้งแรกมา!ความแม่นยําตํานาน

ไม่มีเนื้อหาเพิ่มเติม