OpenAI科學家Noam Brown:AI的真正上限,可能根本沒人測得起
隨著大語言模型逐漸進入複雜的推理、自動化研究和網絡安全等困難任務,傳統的模型評價方法正面臨著新的挑戰。長期以來,模型發佈往往伴隨著由數學、編程、科學問答、網絡安全、知識推理等多種基準測試組成的結果表,並與上一代模型進行水平比較。...
隨著大語言模型逐漸進入複雜的推理、自動化研究和網絡安全等困難任務,傳統的模型評價方法正面臨著新的挑戰。長期以來,模型發佈往往伴隨著由數學、編程、科學問答、網絡安全、知識推理等多種基準測試組成的結果表,並與上一代模型進行水平比較。...
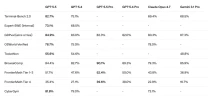
Claude Fable 5 是今天 AI 該領域的核心熱點,這個「神話級」模型性能非常出色,吸引了無數的關注。Andrej Karpathy 稱其「非常令人興奮」,是「配得上大版本升級的躍遷式進步」,與去年 11 月 Claude 4.5 所帶來的提升屬於同一水平。SWE-bench Pro 編程基準,Fable 5 拿到了 80.3% 得分,超越 Opus 4.8 整整 11 一個百分點。擁有一個 5000 萬行代碼的 Ruby 在代碼庫中,它在一天內完成了全庫遷移,如果將同樣的工作量交給人類團隊,需要兩個多月的時間。...
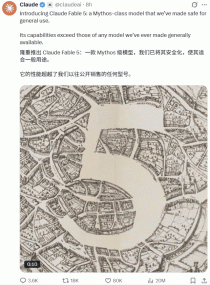
剛才,Anthropic發佈了藏了兩個月的大殺手——Claude Fable 5和Mythos 5,就像扔下一枚炸彈。現在直接給OpenAI施加壓力。...
沒有更多了