تيان يوان دونغ: بعد كتابة آخر ورقة بحثية مع GPT-5، أدركت أنني سأفقد وظيفتي خلال الخمس سنوات القادمة.
في الأيام القليلة الماضية، قامت OpenAI بنشر 722 مخطوطة بحثية رياضية دفعة واحدة على موقع GitHub. تم تصنيف هذه المخطوطات ضمن 372 مجموعة نتائج، تغطي 17 مجالًا رياضيًا مختلفًا، وجميعها من تأليف شخص لم يتم الكشف عن اسمه بعد، ولم يتم نشر أي من هذه الأعمال بشكل عام.النموذج الداخلي——أداؤه يتفوق بكثير على أداء GPT-6 Astra.
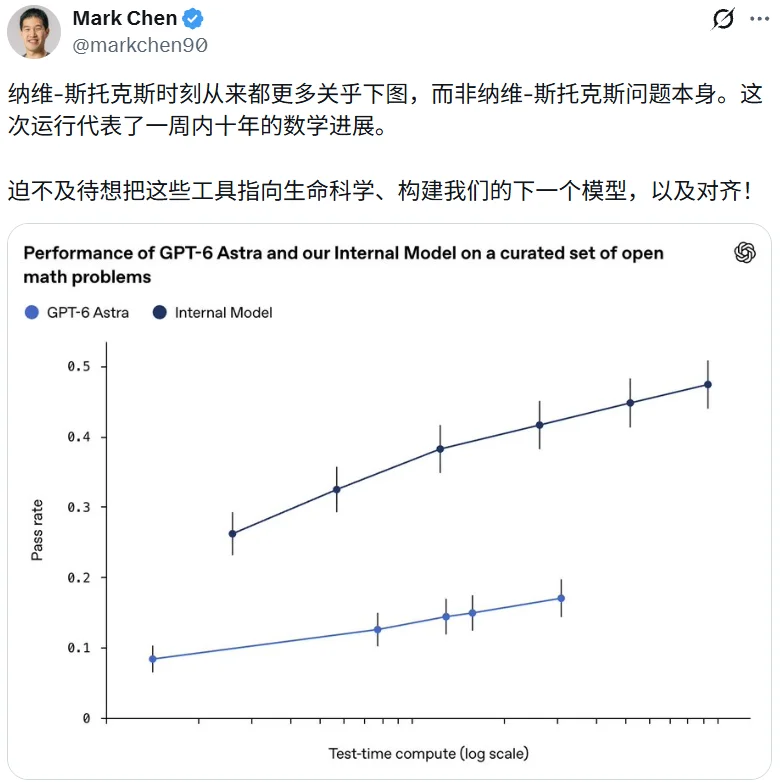
تغريدة من مارك تشن، كبير الباحثين في OpenAI
بالطبع، لا تزال هناك العديد من الجدالات في الأوساط الرياضية حول جودة هذه النتائج وطريقة الكشف عنها، ولكن هناك شيء واحد لا يمكن إنكاره:بدأت سرعة إنتاج نتائج البحث العلمي بواسطة الذكاء الاصطناعي في الاحتساب بوحدات "مئات الأوراق البحثية".。
تقريبًا في نفس الوقت، في أحدث حلقة من بودكاست The Information Bottleneck، قال أحد الخبراء في مجال التعلم العميق جملة أثارت قلق العديد من الباحثين: “بعد إنهاء هذا المشروع والحصول على نتائج مثيرة للاهتمام، أدركت فجأة: واو…”سيتم استبدال وظيفتي خلال حوالي خمس سنوات.。」
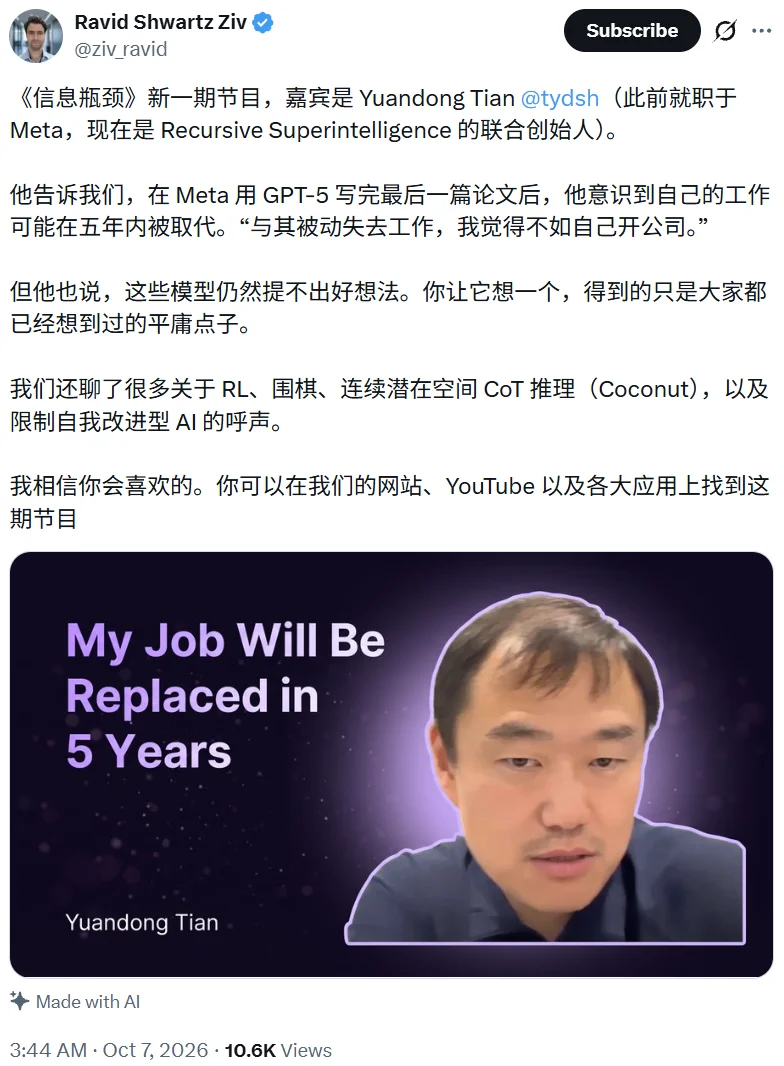
عنوان البودكاست: https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
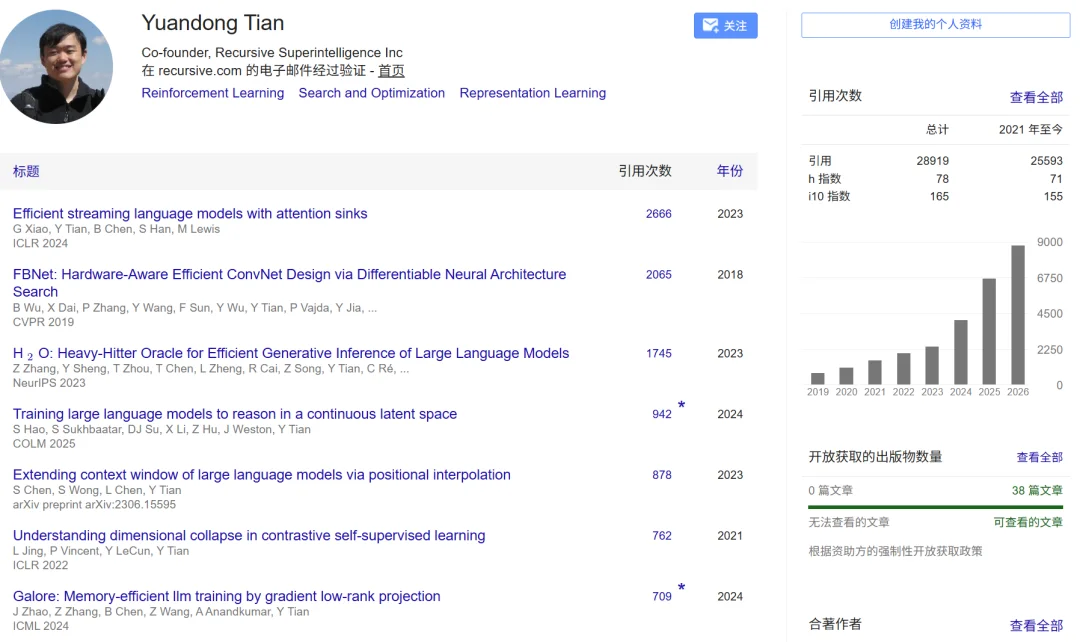
الشخص الذي قال هذه الكلمات هوتيان يوان دونغلقد قضى ما يقرب من عشر سنوات في Meta FAIR، حيث عمل في مجالات الذكاء الاصطناعي للغو الصيني، والتعلم التعزيزي، وقابلية تفسير الشبكات العصبية، وهو أيضًا أحد مؤلفي ورقة البحث حول Coconut (سلسلة التفكير في الفضاءات المتواصلة).
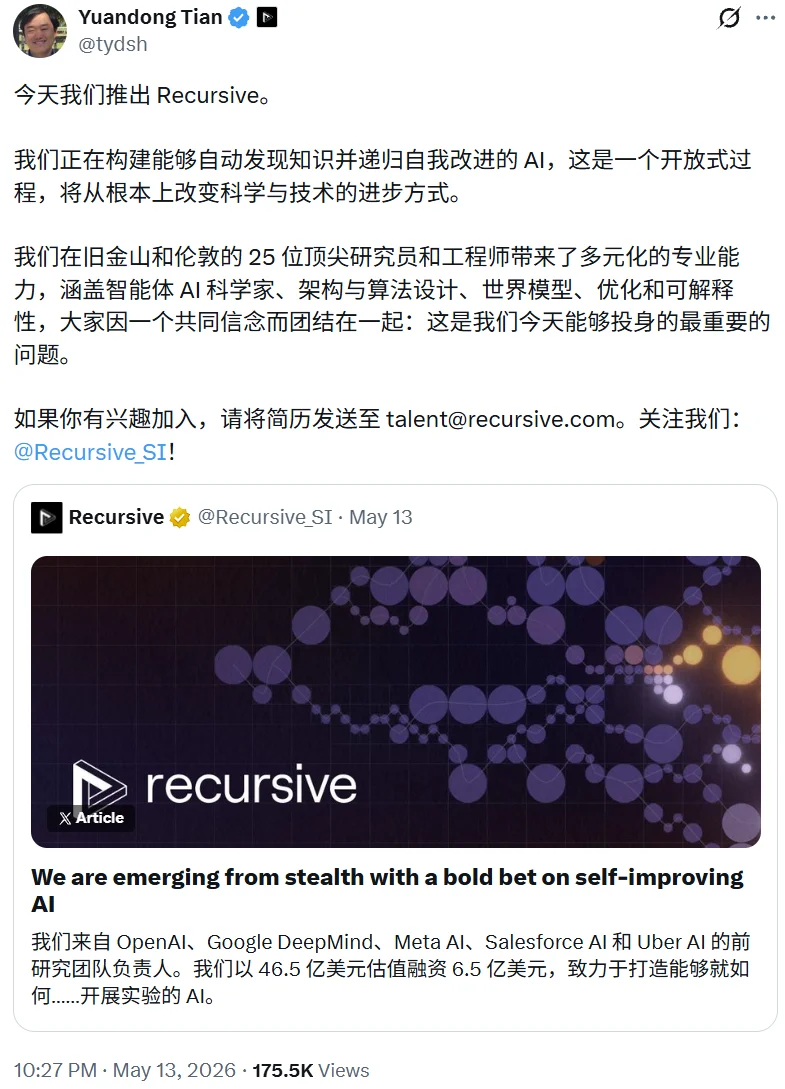
اليوم، هويته هي Recursive Superintelligence أحد المؤسسين المشاركين للشركة. في مايو من هذا العام، انتهت الشركة من فترة الخفاء وأعلنت عن إتمام جولة تمويل بقيمة 650 مليون دولار أمريكي، بقيمة تقديرية تبلغ 4.65 مليار دولار أمريكي، بقيادة شركتي GV وGreycroft، مع مشاركة كل من شركتي Nvidia وAMD.
في هذه الحلقة من البودكاست التي يقدمها رافيد شوارتز-زيف، شرح تاناوا ميتسوهيكو سبب خروجه لبدء مشروعه الخاص:بدلاً من أن تفقد وظيفتك بشكل سلبي، من الأفضل أن تبادر بتأسيس شركة تسير في هذا الاتجاه.لكنه أيضًا ألقى بعض البرود على الذكاء الاصطناعي في البرنامج. قال: "إذا طلبت من النموذج أن يأتي بأفكاره الخاصة، فسوف يقدم لك أفكارًا عادية للغاية، وهي أفكار يعرفها الجميع بالفعل، وليست في اتجاهات مثيرة للاهتمام."
خلال محادثة استمرت قرابة ساعة، تحدث تاناوا ميتسوهيكو عن AlexNet من أيامه في جامعة CMU، وتطورات الذكاء الاصطناعي في لعبة الغو، ومفهوم "مساحة الحركات" واستنتاجات المساحات الخفية، وأخيرًا تناول مواضيع التحسين الذاتي التكراري، والأنظمة الهيكلية الجديدة، والمصادر المفتوحة. فيما يلي ملخص لهذه المحادثة.
الجدال داخل قاعة سميث: هل كانت شبكة AlexNet مجرد حادث عرضي؟
تيان يوان دونغ جاء إلى الولايات المتحدة في عام 2008 ليدرس الدكتوراه في معهد أبحاث الروبوتات بجامعة كارنيغي ميلون. في ذلك الوقت، لم يكن تعلم الآلات يحظى بالمكانة التي يحظى بها اليوم. "في ذلك الوقت، كان الكثيرون لا يعتقدون أن تعلم الآلات هو الطريق الصحيح للمضي قدمًا، فكان الناس يقولون إنه غير فعال بسبب مشكلة التعلم الزائد، وكان من الصعب فهم ما يحدث داخله."
موضوع أطروحة الدكتوراه الخاصة به كان في مجال الرؤية الحاسوبية.مشكلات التحسين غير المحدبةعلى سبيل المثال، استعادة تشوهات الصور الناتجة عن انكسار أشعة الضوء على سطح الماء. استخدم طريقة متعددة الطبقات لتحسين النتائج، وأثبت أنه حتى عندما لا تكون المشكلة من نوع "محدب" (convex)، يمكن إثبات الأمثلية إلى حد ما طالما كانت البيانات كافية. "مزيج البيانات المدفوعة بالحقائق مع التحسين مثير للاهتمام حقًا، وما زلت فخورًا بهذا العمل حتى الآن."
في عام 2012، ظهر AlexNet فجأة. أرسل تاناوا ميتسوهيرو رسالة إلكترونية إلى أليكس كريزhevsky وطلب الحصول على الكود ليقوم بتجربته بنفسه. سرعان ما أدرك أن عملية المعالجة المتدرجة للشبكات التفاعلية كانت في الواقع نفس فكرة التحسين المتدرجة التي طرحها في ورقته البحثية، وقال: «ربما كان هذا ما كنت أسعى وراءه دائمًا، فقط بشكل مختلف».
لكن الأجواء في جامعة كارنيغي مونتغمري (CMU) في ذلك الوقت لم تكن ودية. “كان الجميع يأتون إلى المكتب كل يوم، ويناقشون بشدة في قاعة سميث (Smith Hall) ما إذا كانت نتائج نموذج AlexNet نتيجة للصدفة أم اختراق حقيقي. كان معظم الناس يقولون إنها مجرد صدفة، لأن ذلك لا يتوافق مع المنطق.”
عند تخرجه في عام 2013، تلقى تيان يوان دونغ عروضًا من عدة مؤسسات كانت ترغب في العمل في مجال التعلم العميق، لكنه في النهاية اختار فريق القيادة الآلية في جوجل. السبب الأول كان السمعة الطيبة للشركة، والسبب الثاني كان توصية من صديق. ومع ذلك، لم يتمكن خلال العام والثلاثة أشهر التي قضاها هناك من تحقيق أي تقدم في مجال التعلم العميق، لأن الفريق كان أشبه بشركة ناشئة تحتاج إلى استخدام حلول مثبتة لحل المشكلات العملية، بدلاً من القيام بالبحث العلمي. لذلك، انتقل إلى شركة FAIR، ووصف هذا القرار بأنه "واحد من أفضل القرارات التي اتخذها في حياته".
شخصان، وحدة معالجة رسومات واحدة: ذكريات تيان يوان دونغ في لعبة الغو
في FAIR، كان أول مشروع بدأه تاناوا ميتسوهيكو هو مشروع الذكاء الاصطناعي للغة الغو. في عام 2015، قام فريقه بإنجاز... DarkForestتمكنت شبكة التقاطعات من هزيمة أفضل اللاعبين الهواة على الإنترنت. بعد عدة أشهر، في ربيع عام 2016، هزمت AlphaGo اللاعبين المحترفين.
في مواجهة هذا النوع من "التصادمات"، يعتقد تاناوا ميتسوهيدو أن لدى AlphaGo نقطتين لا يمتلكهما:
- شبكة القيمفي ذلك الوقت، كانت DarkForest تمتلك شبكة استراتيجيات فقط؛
- لم يكن لديه تقريبًا أي شيء من قبلالتعلم المعززالخلفية: "كان الأمر في الأساس يتمثل في التعلم أثناء العمل، تمامًا كما لو كنت أقوم بتعزيز التعلم الذاتي". هذه التجربة دفعته لاحقًا إلى التركيز على الكثير من أبحاث التعلم الذاتي.
عندما سُئل عما إذا كانت قدرة AlphaGo مفاجئة، كان رده مثيرًا للاهتمام: الطريقة نفسها ليست مذهلة، لأن...تستطيع شبكات التقطيع التقاط أنماط لوحة الشطرنج التي يعتمد عليها البشر أثناء لعب الشطرنج.،"المفاجأة الحقيقية هي أنه استطاع هزيمة لاعبي الشطرنج المحترفين".
في عام 2018، قام الفريق بإعادة إنشاء نموذج AlphaZero، وهو نموذج يلعب الشطرنج بشكل تلقائي بالكامل دون الاعتماد على أي خطط لعب بشرية، وقاموا ببعض التحسينات على كفاءته، مما أدى إلى تحقيق نتائج جيدة. OpenGoهذا الذكاء الاصطناعي، في مباراة رسمية مع أكاديمية الشطرنج الكورية، استخدم وحدة معالجة الرسوميات V100 واحدة فقط، وتمكن من منع أربعة لاعبين محترفين من الفوز بأي نقطة. "أعتقد أن السبب ربما يكون..."لأول مرة، تمكن شخص ما من هزيمة لاعب شطرنج محترف باستخدام وحدة معالجة رسومات واحدة فقط (GPU).。」
قبل المباراة، حدثت مقولة صغيرة. طلب الفريق من أصدقائهم اللاعبين المحترفين وشبه المحترفين تقييم قوة لعبة OpenGo، وكان رد اللاعبين أنهم يمكنهم فهم بداية اللعبة، لكن بعد ذلك أصبح من المستحيل عليهم فهم ما يحدث، وقالوا فقط: «يبدو الأمر قويًا جدًا، لكنني لا أعرف إذا كانوا حقًا قويين أم لا». لذلك قرر تاناوا ميتسوهيدو: دعونا نلعب مباراة مباشرة مع لاعبين محترفين حقيقيين.
مساحة العمل أكثر أهمية من الخوارزمية
عند الحديث عن تقنيات التعلم القوي في تلك الحقبة، يعتقد تاناوا ميتسوهيكوهناك العديد من الطرق التي ما زالت تُقلل من شأنها حتى اليوممثلًاتعلم التعزيز الموزع، استخدم توزيع المكافآت بدلاً من متغير واحد قياسي لضبط النموذج؛ وعلى سبيل المثال طرق النمذجة المختلفة مثل تعلم Q (Q-learning)"لكن الآن، في معظم الأوقات، نستخدم تدرج الاستراتيجيات، وهذا يمثل عصرًا مختلفًا تمامًا."
هو أيضًا متفائل بهذا الأمر.لا توجد طرق لتحسين التدرج (Gradient Optimization Methods)ويعتقدون أيضًا أن النماذج الكبيرة قدمت لهم إمكانيات جديدة: "النماذج الكبيرة لديها الآن فهم أعمق للنظام وللدوال المستهدفة التي يجب تحسينها، وهذا الفهم الأعمق أكثر فائدة بكثير من معلومات الانحدارات المحلية." في الحالات التي تكون فيها الانحدارات متقلبة بشدة والحلول المحلية موجودة في كل مكان، قد تقود الانحدارات الناس إلى طرق مسدودة، بينما تحتوي الطرق غير القائمة على الانحدارات بشكل طبيعي على عنصر الاستكشاف، "وهو شيء لم تفعله الطرق القائمة على الانحدارات أبدًا."
حوالي عامي 2018 و2019، بدأ تاناوا ميتسوهيد في محاولة تطبيق تقنيات التعلم المعزز على مشكلات في العالم الحقيقي، وكانت النتائج مفاجئة إلى حد ما:الأمر المهم حقًا ليس الخوارزميات، بل تصميم مساحة الإجراءات ومساحة الحالات.」
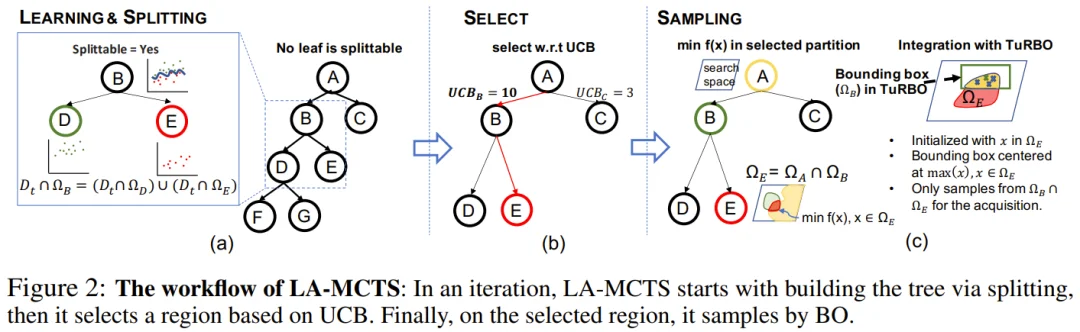
لقد أخذ كمثال على ذلك بحث الهياكل العصبية. يعلم البشر أن عمق الشبكة مهم للغاية، لكن الذكاء الاصطناعي لا يدرك ذلك. إذا بدأ الذكاء الاصطناعي في البحث عن تفاصيل مثل حجم النوى التجميعية في الطبقة الأولى، فإن أداء جميع الفروع سيكون متشابهًا تقريبًا، ولن تعطي دالة القيمة إشارات مفيدة، وسيكون عليه البحث تدريجيًا عميقًا أكثر، مما يؤدي إلى تفجير حجم مساحة البحث بشكل أسي، "وفي هذه الحالة، لن يكون أي خوارزمية مفيدة". من ناحية أخرى، إذا تم إعادة تنظيم مساحة الإجراءات بحيث يدرك الذكاء الاصطناعي أولاً أهمية العمق، فسيكون هناك فرق واضح بين الشبكات العميقة والضحلة، ويمكن ملاحظة الاتجاه بعد عدة محاولات. استنادًا إلى ذلك، اقترح الفريق...بحث شجرة مونتي كارلو في الفضاء الخفي (LA-MCTS)الفكرة الأساسية هي العثور تلقائيًا على مساحة الإجراءات التي توفر أعلى درجة من التمييز لفضاء البحث.
كوكونات: «عندما أفكر، لا أستخدم اللغة أبدًا».
ذكر المقدم المشترك مشاركة تيان يوان دونغ. Coconut الورقة البحثية، والتي تتيح للنموذج التفكير في أبعاد مستمرة من الفضاء الخفي بدلاً من فضاء الرموز (token space). يقول تاناوا موتو: «جاءت هذه الفكرة من ملاحظتي الخاصة: أنا لا أستخدم اللغة أبدًا أثناء التفكير. أستطيع أن أشعر بوضوح أنني أستخدم جزءًا آخر من دماغي أثناء التفكير، ثم يجب علي ترجمة أفكاري إلى لغة حتى أتمكن من التواصل بسلاسة مع الآخرين.»
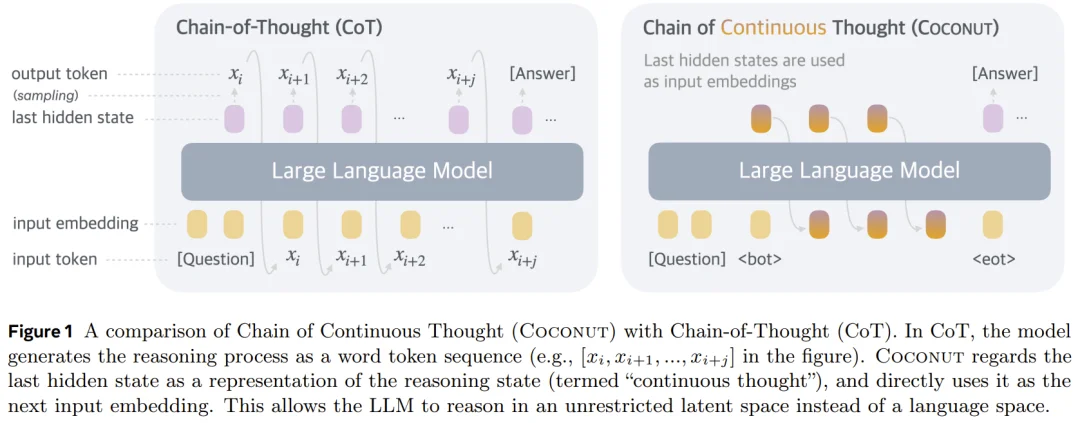
استنادًا إلى هذا الحدس، قام الفريق بإجراء استنتاجات نظرية واكتشف أن التمثيلات المحتملة يمكن أن تكون حالات متراكمة لأفكار متعددة. استخدموا هذا الاكتشاف للتفكير في مشاكل مثل تصفح الرسوم البيانية، ووجدوا أنه قد يوفر ميزة كبيرة، "ربما ليست بشكل أسي، ولكن على الأقل هناك ميزة معينة".
لماذا لم تتبنى النماذج الرائدة حتى الآن سلسلة تفكير متواصلة؟ قدم تاناوا ميتسوهيدا سببين لذلك.
- البياناتتم تسجيل الكثير من عمليات التفكير البشرية بشكل لغوي، بينما لا تتوفر مثل هذه البيانات في الفضاء الخفي (المجال الخفي).
- التعبيرات المحتملة قد تكون شديدة التخصيص"كل شخص يستخدم، إلى حد ما، تمثيلاته الخاصة الكامنة"، ولكن كفاءة تعلم النماذج الكبيرة أقل بكثير من كفاءة البشر، لذلك يتم استخدام اللغة كبديل مؤقت.
سأل رافيد شوارتز-زيف، هل هذا مشابه لمشكلة التنظيم (regularization) التي تواجهها الطرق ذاتية التدريب مثل JEPA. أجاب تاناوا موتو بالموافقة وأعمق القضية: قد يكون الانحدار التدريجي نفسه قد وقع في نوع من "التحسين المحلي على مستوى أعلى" (meta-level local optimization)، وهناك بعض التمثيلات الجيدة جدًا التي قد لا يمكن تعلمها بالفعل باستخدام نماذج التدريب الحالية، "نحن لا نعرف حاليًا أين تكمن الحدود".
في رأيه، هذا بالضبط ما يجب أن يحدث.دراسات القابلية للتفسيرمعنى ذلك، "مثل الفرق بين الخيمياء والكيمياء". لكن النماذج الحالية قوية جدًا، والجميع يركزون على النتائج فقط، ولا يوجد ما يكفي من الأشخاص والوقت للمشاركة في هذا المجال.
بعد كتابة الورقة البحثية الأخيرة بالتعاون مع GPT-5
عند الحديث عن التحول في عصر النماذج الكبيرة، يعتقد تيان يوان دونغ أن التحليل الذي قام به باستمرار منذ عام 2018 في ديناميكيات تدريب الشبكات العصبية يمكن تطبيقه أيضًا على النماذج الكبيرة، وأن هناك استمرارية في الأساليب دون أي انقطاع. الصدمة الحقيقية تكمن على المستوى التجريبي: حيث كان الباحثون في الماضي يقترحون الفرضيات، يجرون التجارب، ويستنتجون النتائج بأنفسهم، وهذه العملية لا تختلف جوهريًا عما كانت عليه قبل مائة أو مائتي عام؛ وكلما أصبح النموذج أقوى، أصبح بإمكاني إنتاج الأفكار بنفسي."قد يضطر الباحثون إلى التفكير على مستوى البنية الأساسية، بدلاً من قضاء وقتهم في طرح فرضيات محددة واحدة تلو الأخرى".
في الوقت نفسه،تحسنت مكانة القدرات الهندسية بشكل كبيرفي عصر النماذج الكبيرة، الكثير من الأعمال الجيدة تتطلب «نصفها بحثًا ونصفها هندسة». ولكن مع ظهور وكلاء البرمجة الذكية في مجال الذكاء الاصطناعي، تغير الوضع مرة أخرى: أصبح بإمكان الباحثين ذوي الخبرة الواسعة أن يجعلوا هؤلاء الوكلاء ينفذون الأفكار بسرعة ويحددون المشكلات الرئيسية، «وفجأة أصبح لديهم قدرات خارقة تمكنهم من استكشاف الأمور الأعمق حقًا».
نقطة التحول كانت في آخر ورقة بحثية له في Meta، والتي كان هو المؤلف الوحيد فيها. تناولت هذه الورقة البحثية موضوع الشبكات العصبية. grokking الظاهرة تتمثل في أن الشبكة تقوم أولاً بحفظ المعلومات بشكل ميكانيكي، ثم في لحظة معينة تتعلم فجأة كيفية التعميم (أي تطبيق المعرفة على حالات جديدة غير متوقعة).
خلال العملية بأكملها،لقد اعتبر GPT-5 كشريك له.اسأله أسئلة، وأعطه "واجبات منزلية"، ودعه يثبت النظريات، ويتحقق مما إذا كانت النظريات صحيحة، ونقوم معًا بعمليات تفكير جماعي (brainstorming).
النتيجة هيتم تحسين الكفاءة بمقدار 6 إلى 10 أضعاف تقريبًا.،وهذا مجرد تقدير متحفظ، لأنني في ذلك الوقت كنت أكتب الكود بنفسي. اليوم، يمكننا تسليم المهام المتعلقة بالكود والتنفيذ إلى الذكاء الاصطناعي القوي، والسرعة ستكون أسرع بكثير.
وهكذا نشأت الجملة في البداية. يعترف تاناوا موتو بأن الباحثين عادةً ما يترددون في أن يصبحوا شركاء مؤسسين في شركات صغيرة، لأنهم يضطرون للقلق بشأن العديد من الأمور خارج البحث، "لكنني أعتقد أن هذه هي لحظة تغيير جذري، وإذا لم أفعل شيئًا الآن، فقد يصبح الأمر غير مهم في المستقبل".
رد المقدم المشارك مازحًا نصفًا، قائلًا إن طريقته في التعامل كانت أن يتعلم كيفية القيام بالأعمال اليدوية، لكن للأسف «أنا لست بارعًا في ذلك».
الذكاء الاصطناعي لا يزال غير قادر على التوصل إلى أفكار جيدة.
لكن، تيان يوان دونغ لا يعتقد أن البشرية يمكن أن تتراجع الآن.لا أعتقد أن النماذج الحالية قادرة على تقديم نتائج جيدة دون أي تدخل بشري.حتى في تلك الورقة البحثية التي كُتبت بالتعاون مع GPT-5، كانت الأفكار العامة من صيغته هو، ولم يترك الأمر للنموذج ليفكر بنفسه.
البشر ما زالوا مسؤولين عن:
- بدء،تحديد أي المشكلات تستحق العناية والاهتمام
- التحقق،لتحديد ما إذا كان الحل الذي قدمته التكنولوجيا الذكاء الاصطناعي موثوقًا به أم لا
ذكر رافيد شوارتز-زيف أن العديد من المشاريع الأخيرة التي تهدف إلى جعل الوكلاء الذكيين يقومون بالتدريب اللاحق ويتنافسون في مسابقات Kaggle قد كشفت عن مشاكل مثل ضيق مجال الأفكار وسهولة التعرض للتكيف المفرط مع المؤشرات. يعتقد تاناوا ميتسوهيكو أن هذا الأمر مؤقت إلى حد ما: فالنماذج تُطلب منها التعامل مع التفاصيل دون وجود سياق كافٍ، ولكن إذا تم منحها المزيد من المعلومات الخلفية، فقد تقدم أفكارًا أكثر إثارة للاهتمام من مجرد تعديل المعلمات الخاصة بها.
لكنه أيضًا اعترف بأن إضافة السياق هي مجرد "إصلاح مؤقت". النماذج الحالية ماهرة في الأعمال المتكررة، لأن بيانات الإنترنت مليئة بهذا النوع من المحتوى؛إذا أرادت النماذج أن تتجاوز حدودها الحالية بشكل حقيقي، فسنحتاج إلى هيكل جديد.لكي يتمكن من التقاط الإشارات الجديدة بسرعة باستخدام كمية قليلة جدًا من البيانات، "نحتاج إلى قفزة كبيرة من العمل المتكرر الروتيني إلى المستوى التالي."
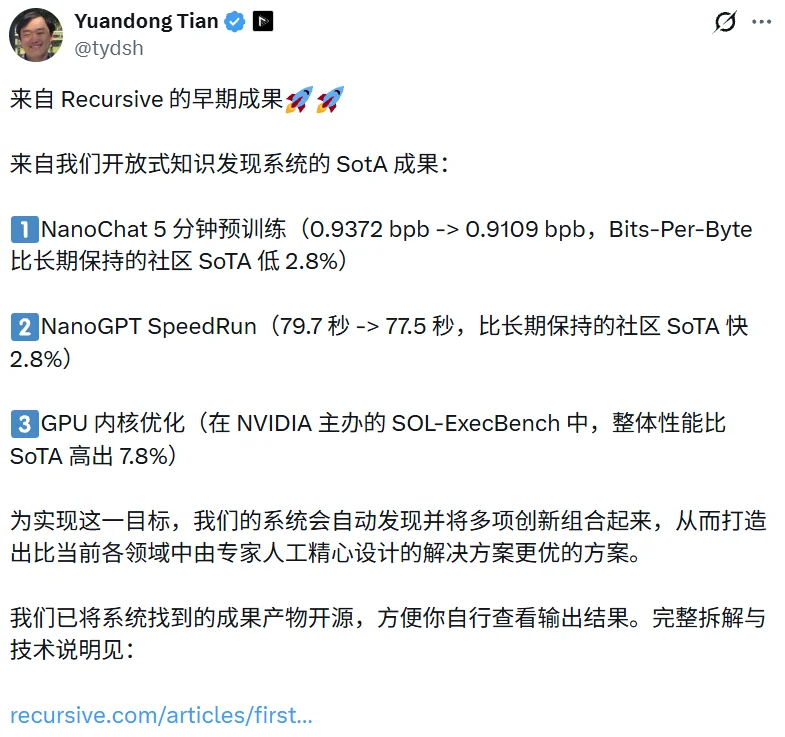
في دورة البحث التي تتكون من "طرح الأفكار، كتابة الكود، تنفيذ التجارب، وتحليل النتائج"، يعتقدأصعب الأمور في التحويل إلى نظام آلي هي الأفكار نفسها.عندما سُئل عن إنجازه في تحسين وقت التدريب في NanoGPT Speedrun، من 79.7 ثانية إلى 77.5 ثانية، ما إذا كان ذلك اكتشافًا حقيقيًا أم مجرد بحث فعال عن تقنيات معروفة مسبقًا، أجاب تاناوا ميتسوهيدو بأن الأمر يشمل كلا الأمرين. على سبيل المثال، فكرة إضافة معلومات الـ "bigram" إلى نظام الانتباه (attention mechanism) يمكن العثور على أفكار مماثلة لها في أبحاث DeepSeek وGemma 3، بالإضافة إلى الأوراق البحثية التي شارك فيها في Meta حول موضوع STEM، لكن كيفية استخدام جداول الإدخال (embedding tables) المختلفة في طبقات مختلفة ودمج هذه الأفكار معًا يتطلب إبداعًا جديدًا.
لماذا تفشل الأنظمة الجديدة دائمًا عندما تصل إلى مرحلة التوسع؟
لقد اقترحت العديد من الشركات بنى بديلة لنموذج Transformer، وقد أظهرت نتائج مبهرة في التجارب على نطاق صغير، لكنها لم تتمكن أبدًا من التوسع لتشمل النماذج الكبيرة. وهذا ما يفسره تيان يوان دونغ.تلخيص التحيز (Inductive Bias)عندما يكون حجم البيانات صغيرًا، لا تكفي البيانات المتاحة، ويصبح من الضروري إدخال افتراضات هيكلية إضافية، وبالطبع تكون النتائج أفضل في هذه الحالة؛ ولكن عندما يزداد حجم البيانات، يكون أفضل ما يمكن فعله هو السماح للنموذج نفسه بالبحث عن الأنماط والقواعد. وقد استشهد بمثال ViT: على مستوى بيانات ImageNet، لم يكن أداء ViT مثل أداء الشبكات التفاعلية (Convolutional Networks)، ولكن عندما يصل حجم البيانات إلى مئات الملايين، فإن أداء النماذج من نوع Transformer يتفوق على النماذج الأخرى.
إذًا، كيف يمكن التحقق من صحة الهيكل الجديد؟
يعتقد تاناوا ميتسوكو بالطبعابدأ بمقياس صغيرلكن الأمر الرئيسي هو فهم ما يحدث داخل الشبكة بالضبط، "نحن بحاجة إلى معرفة أن هناك بعض الرؤى التي يمكن تطبيقها على نطاق أوسع، حتى نكون واثقين من ذلك". وإلا، إذا اكتفينا باتباع قوانين التوسع (scaling laws) بشكل أعمى، فلن نتمكن أبدًا من إثبات أن ما ينجح على نطاق صغير سينجح أيضًا على نطاق أكبر، "والنتيجة الوحيدة ستكون أن الشركة التي تمتلك أكبر قدرة حسابية هي التي ستفوز".
الهدف الأطول الأمد في نظره هوالعثور على كفاءة تعلم مماثلة لتلك التي لدى البشرالدماغ البشري يستهلك فقط من عشرين إلى ثلاثين واط من الطاقة وكمية قليلة جدًا من البيانات، ومع ذلك يمكنه فهم الأشياء في وقت قصير جدًا. يؤكد مجال الروبوتات اليوم على الحاجة إلى كميات هائلة من البيانات، ولكن في رأيه، هذا مجرد متطلب للنموذج الحالي. "انظر إلى القطط والكلاب وغيرها من الكائنات الحية، فهي لا تحتاج إلى الكثير من البيانات، ومعالجاتها بسيطة جدًا، ومع ذلك يمكنها البقاء في عوالم معقدة، وبالتأكيد هناك خوارزميات جديدة وراء ذلك".وقد يكون التعلم المعزز والتحسين الذاتي هما الطريق الأسرع للوصول إلى هناك.
هل تقييد التحسين الذاتي أمر ضروري؟ "الحدود غامضة للغاية"
في نهاية البرنامج، سأل المقدم عن إحدى القضايا الساخنة في مجال أمن الذكاء الاصطناعي حاليًا: هناك من يدعو إلى تقييد استخدام أحدث النماذج، وطالب بالتنسيق الصناعي بشأن عملية التحسين الذاتي التكراري.
كان رد تاناوا ميتسوكو مباشرًا: "بصراحة، أعتقد أن من الصعب جدًا منع الناس من القيام بذلك." في رأيه، الحدود نفسها غير واضحة: عندما تناقش الأفكار الجديدة مع الذكاء الاصطناعي البرمجي وتجعله يتطور، فهذا في جزء منه تحسين ذاتي؛ وعندما تعمل مع الآخرين على كتابة أوراق بحثية، أيضًا هذا يعتبر تحسينًا ذاتيًا. بالإضافة إلى ذلك، مع تزايد قوة النماذج المفتوحة المصدر، هل يعتبر استخدامها في الأبحاث تحسينًا ذاتيًا أيضًا؟ وكيف يمكننا الرقابة على ذلك؟
أوضح بشكل قاطع أن...سيتم نشر النتائج البحثية المتعلقة بالتكنيقة الريكورسيف (Recursive) كمصدر مفتوح (open source).قبل ذلك، نشرت مقالات مدونة الشركة المصدر الكامل للنواة وخطط التدريب، مما سمح للعامة بفحصها والاستمرار في تطويرها على أساسها. إلا أنه يقلق أكثر من سيناريو آخر: "أسوأ السيناريوهات هو أن مجموعة صغيرة من النخب تسيطر على أقوى النماذج في العالم، ثم تجبر الجميع الآخرين على دفع علاوات باهظة لاستخدامها."
هو متفائل جدًا بأن النماذج المفتوحة المصدر يمكن أن تلحق بالنماذج المغلقة المصدر.استخدم كيمي كمثال، واعتبر أنها فعالة جدًا، لكن عملية التفكير فيها قد تكون أطول قليلاً. في رأيه، لا تحتاج الوكائل البرمجية إلى “نيوتن الذكاء الاصطناعي” أو “أينشتاين الذكاء الاصطناعي” لمساعدتك في كتابة الكود؛ فمجرد أن يتجاوز النموذج خطًا معينًا يعتبر كافيًا.
المختبرات الرائدة قد تجاوزت الحدود بالفعل، والنماذج المفتوحة المصدر أيضًا في طريقها لتجاوز الحدود؛ "بمجرد أن تتجاوز الحدود، سيتم تجارتها، وسيستخدم الجميع النموذج الذي يفضلونه".
منذ الجدل الذي دار في قاعة سميث حول ما إذا كانت تقنية AlexNet مجرد حظ سعيد، مرت أربعة عشر عامًا. التعلم العميق الذي كان موضع شك في ذلك الوقت، بدأ الآن في كتابة الأوراق البحثية الخاصة به، وتعديل الكود، وتحطيم الأرقام القياسية. اختار تاناوا ميتسوهيدو أن يكون في طليعة هذا التيار، وبكلماته، السؤال الحقيقي الذي يواجهنا الآن هو: «كيف يمكننا استخدام جميع هذه النماذج للقيام بأشياء أفضل وأكبر؟»
المقال مأخوذ من "قلب الآلة"، تأليف "باندا".
رابط المقال:https://www.airai.cc/ar/ai-news/60/
有用吗?