田淵棟:與GPT-5合寫最後一篇論文後,我意識到自己5年內會失業
前些時日,OpenAI 在 GitHub 上一口氣放出了 722 篇數學論文手稿。這些手稿被歸為 372 個結果「家族」,橫跨 17 個數學領域,全部出自一個尚未發佈、也沒有公開名字的內部模型——其性能遠勝 GPT-6 Astra。
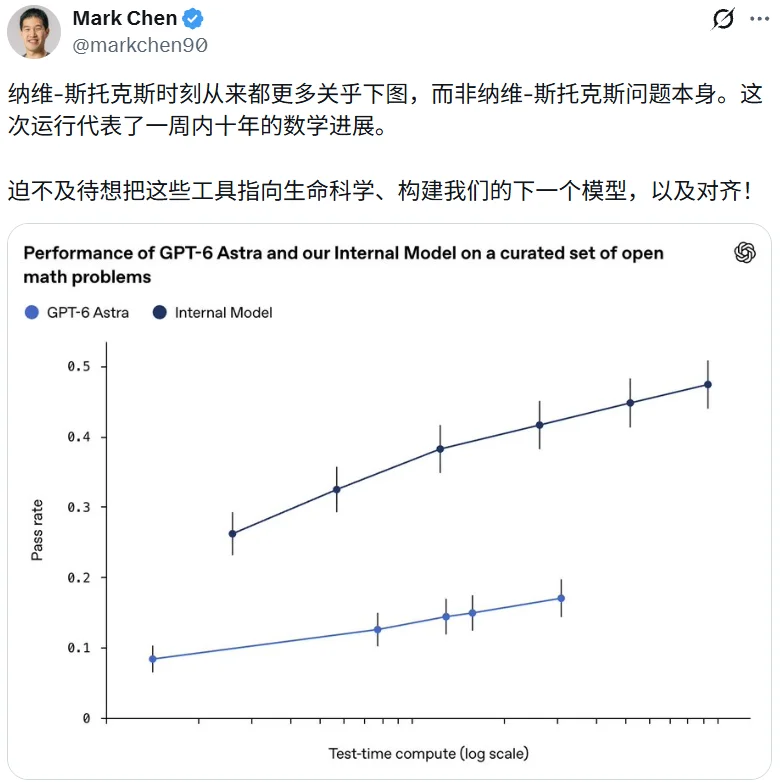
OpenAI 首席研究官 Mark Chen 的推文
當然,數學界對這批成果的質量和披露方式仍有不少爭議,但有一點已經很難否認:AI 產出研究成果的速度,開始以「百篇」為單位計算了。
幾乎在同一時間,最新一期 The Information Bottleneck 播客里,一位深度學習老兵說出了一句讓不少研究者心頭一緊的話:「做完這個項目,拿到一些挺有意思的結果之後,我突然意識到:哇,我的工作大概五年內就會被取代。」
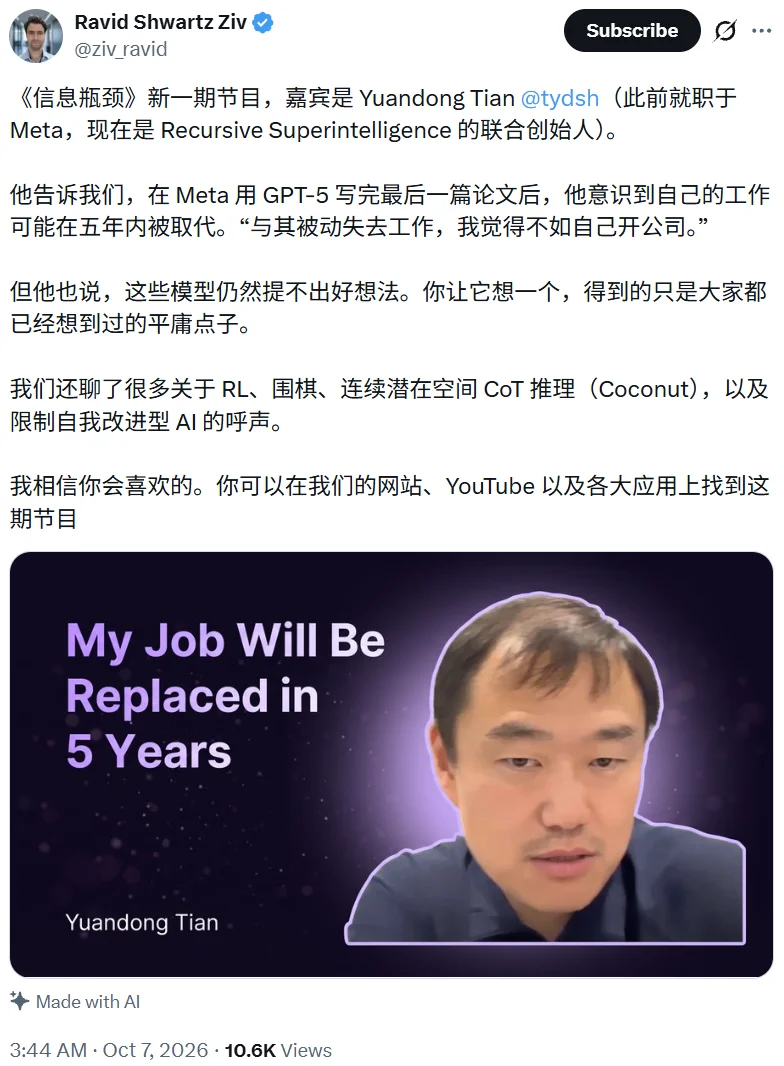
播客地址:https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
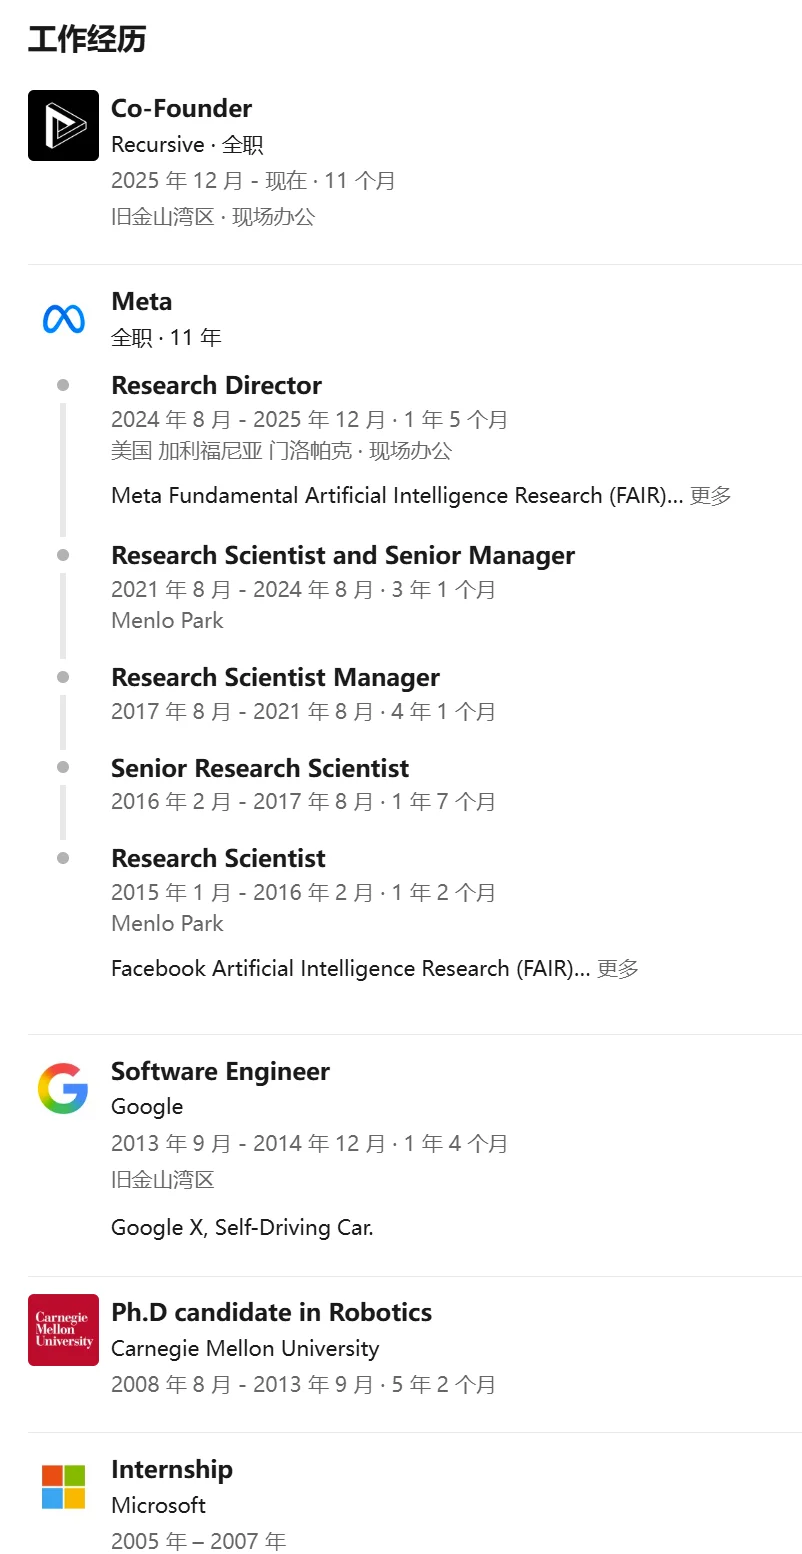
說這話的是田淵棟。他在 Meta FAIR 待了近十年,做過圍棋 AI、強化學習、神經網絡可解釋性,也是 Coconut(連續潛空間思維鏈)論文的作者之一。
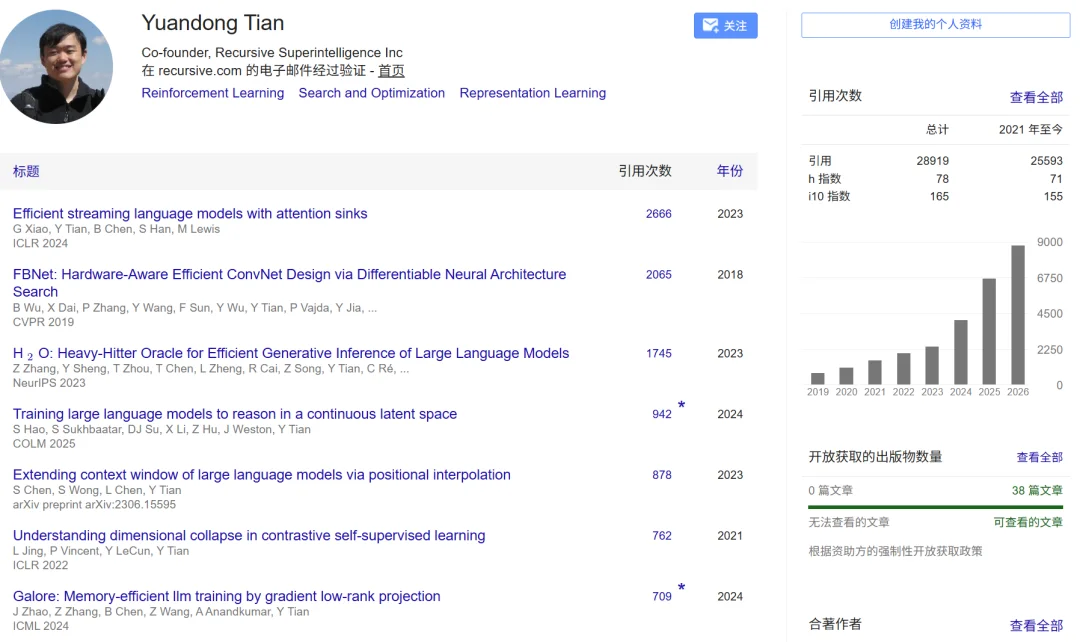
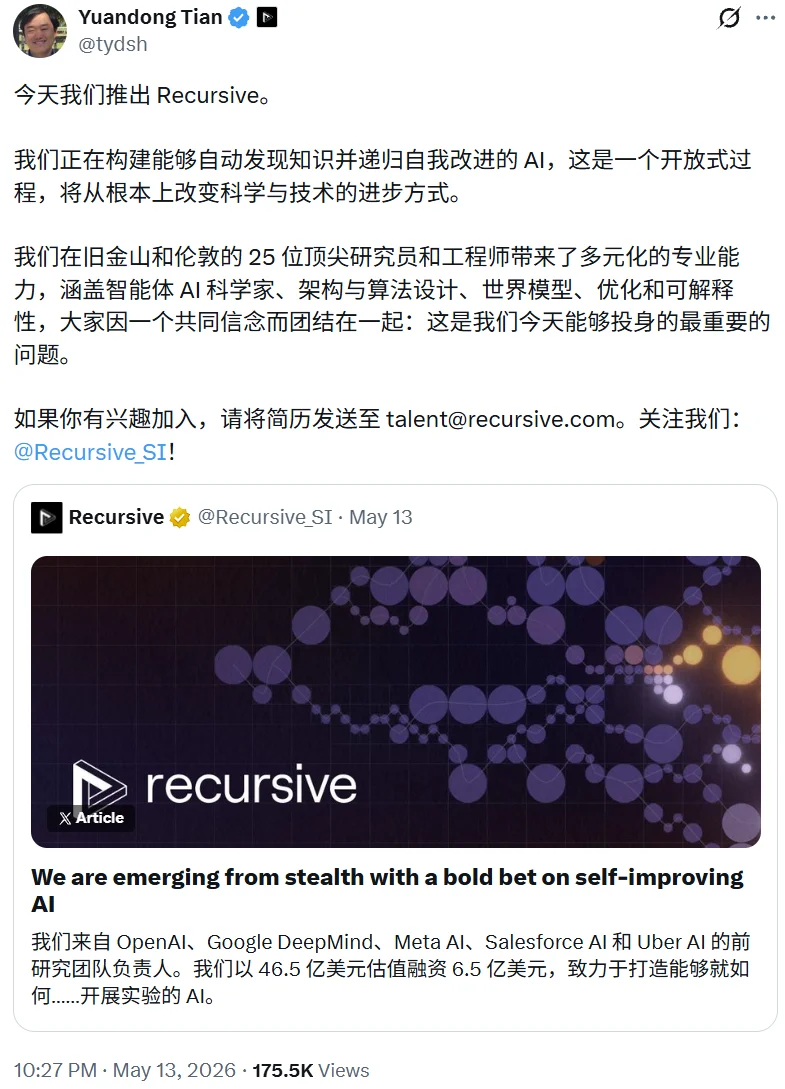
如今,他的身份是 Recursive Superintelligence 的聯合創始人。今年 5 月,這家公司結束隱身狀態,宣佈以 46.5 億美元估值完成超過 6.5 億美元融資,由 GV 和 Greycroft 領投,英偉達和 AMD 參投。
在 Ravid Shwartz-Ziv 主持這一期播客中,田淵棟解釋了自己為甚麼出來創業:「與其被動地丟掉工作,不如主動去開一家朝這個方向走的公司。」不過,他也在節目里給 AI 潑了點冷水。「如果你讓模型自己想點子,它會給你一些非常平庸的想法,基本上誰都知道,也不是甚麼有意思的方向。」
在將近一小時的對話里,田淵棟從 CMU 時代的 AlexNet 爭論講到圍棋 AI,從「動作空間」講到潛空間推理,最後落到遞歸自我改進、新架構和開源。以下是這場對話的整理。
Smith Hall 里的爭吵:AlexNet 到底是不是個意外?
田淵棟 2008 年來到美國,在卡內基梅隆大學機器人研究所讀博。那時,機器學習遠沒有今天的地位。「當時很多人其實不認為機器學習是一條靠譜的路,大家會說它不太行,因為會過擬合,也搞不清楚裡面發生了甚麼。」
他的博士課題是計算機視覺里的非凸優化問題,比如還原水面折射造成的圖像畸變。他用一種分層的方法去優化,並證明瞭即便問題非凸,只要數據足夠多,仍然可以在一定程度上證明最優性。「數據驅動加上優化,這個組合挺有意思的,我到現在都還挺為這份工作驕傲。」
2012 年 AlexNet 橫空出世。田淵棟給 Alex Krizhevsky 發了封郵件,要來代碼自己擺弄了一番。他很快意識到,卷積網絡的層級化處理,和自己論文里的分層優化思路其實是一回事,「可能是我一直在追求的東西,只是換了一種形式」。
但當時 CMU 的氣氛並不友好。「大家每天來辦公室,在 Smith Hall 里激烈爭論 AlexNet 的結果到底是僥倖還是真正的突破。大多數人都說只是僥倖,因為這不合常理。」
2013 年畢業時,田淵棟拿到了幾家想做深度學習的機構的 offer,最終卻選擇了 Google 自動駕駛團隊,一方面是名氣,一方面是朋友內推。可在那裡的一年零三個月里,他並沒能做成深度學習,因為團隊更像創業公司,需要用成熟方案解決實際問題,而不是做科學探索。於是他跳槽去了 FAIR,並稱這是「當時做過的最好的選擇之一」。
兩個人、一塊 GPU:田淵棟的圍棋往事
在 FAIR,田淵棟啓動的第一個項目是圍棋 AI。2015 年,他的團隊做出了 DarkForest,靠卷積網絡在網上擊敗了頂尖業餘棋手。幾個月後,AlphaGo 在 2016 年春天擊敗了職業棋手。
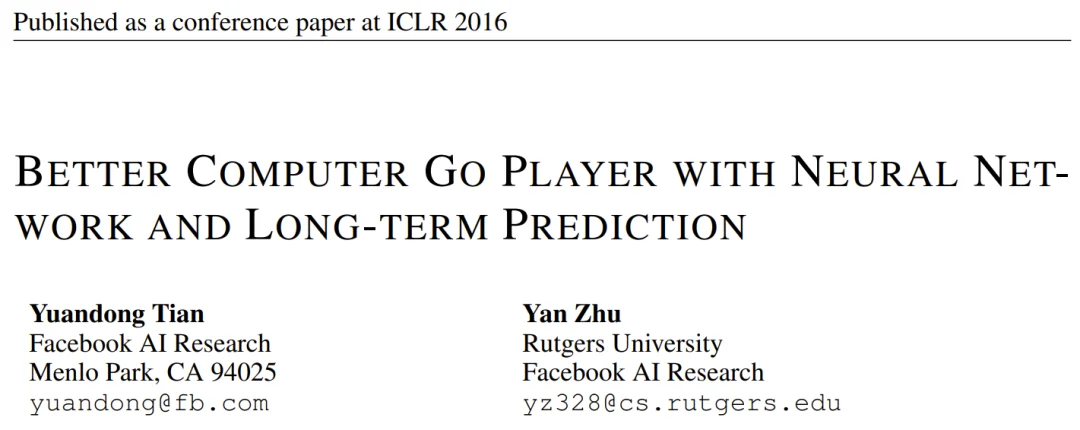
面對這樣的「撞車」,田淵棟的復盤認為 AlphaGo 有兩點自己沒有的:
- 價值網絡,DarkForest 當時只有策略網絡;
- 他本人此前幾乎沒有強化學習背景,「基本是邊做邊學,就像對自己做強化學習」。這段經歷讓他之後轉向了大量強化學習研究。
被問到 AlphaGo 是否令人意外,他的回答很有意思:方法本身並不驚人,因為卷積網絡能捕捉到人類下棋時依賴的棋盤模式,「真正讓人驚訝的是,它居然能打敗職業棋手」。
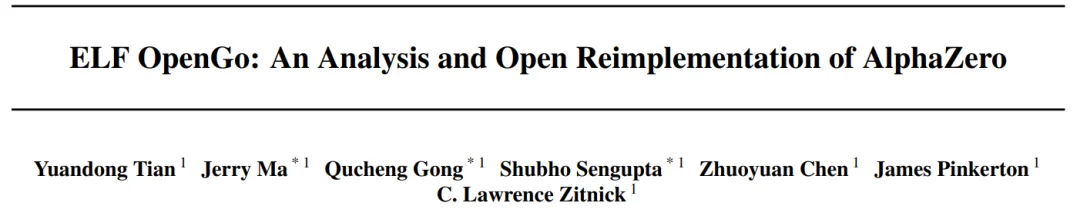
2018 年,團隊復現了 AlphaZero,即完全不依賴人類棋譜、從零自我對弈的方案,並做了一些效率改進,得到了 OpenGo。這個 AI 在與韓國棋院的正式對局中,只用一塊 V100 GPU,就讓四位職業棋手一盤未勝。「我想那大概是第一次有人用單塊 GPU 戰勝職業棋手。」
比賽前還有個小插曲。團隊請職業和半職業棋手朋友評估 OpenGo 的棋力,結果對方表示,開局還看得懂,之後就完全看不明白了,只能說「看起來很強,但我也不知道是不是真的強」。於是田淵棟決定:那就直接找真正的職業棋手下一場。
動作空間比算法更重要
談到那個時代的強化學習,田淵棟認為有不少方法至今仍被低估。比如分布式強化學習,用獎勵的分布而非單個標量來調整模型;又比如 Q-learning 等不同的建模方式。「但現在我們大多數時候用的都是策略梯度,這是很不一樣的時代。」
他同樣看好無梯度優化方法,而且認為大模型給了它們新的可能性:「大模型現在對系統、對要優化的目標函數有更好的高層理解,這種高層理解比局部梯度信息要有用得多。」在梯度起伏劇烈、局部最優隨處可見的情況下,梯度可能會把人帶進死衚衕,而無梯度方法天然包含探索,「這是梯度方法從來不會做的事」。
2018、2019 年前後,田淵棟開始嘗試把強化學習用在真實世界的問題上,結論頗為出人意料:「真正重要的不是算法,而是動作空間和狀態空間的設計。」
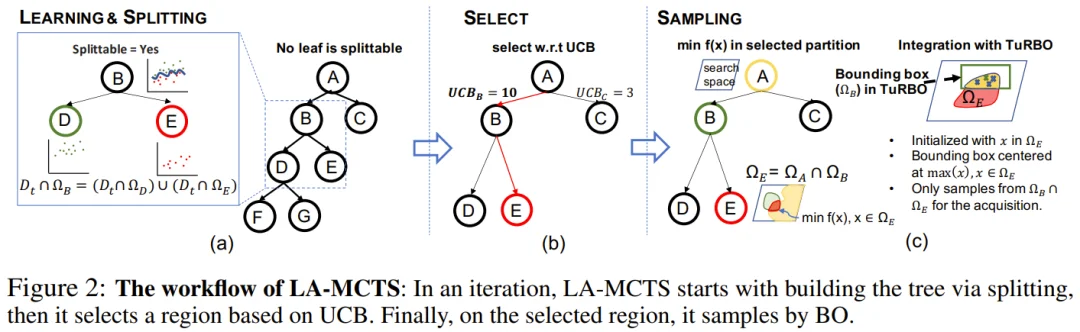
他以神經架構搜索為例。人類知道網絡深度很關鍵,但 AI 不知道。如果 AI 一開始去搜索第一層卷積核大小這樣的細節,所有分支的表現都差不多,價值函數給不出有用信號,只能逐層深入,搜索空間就會指數爆炸,「這時你用甚麼算法都沒用」。反過來,如果能把動作空間重新組織,讓 AI 先「意識到」深度很重要,深網絡和淺網絡之間就會出現鮮明對比,幾次 rollout 就能看出方向。團隊據此提出了潛空間蒙特卡洛樹搜索(LA-MCTS),核心思想就是自動找到能讓搜索子空間區分度最高的動作空間。
Coconut:「我思考的時候從來不用語言」
聯合主持人提到了田淵棟參與的 Coconut 論文,即讓模型在連續潛空間而非 token 空間中推理。田淵棟說,這個想法源於他對自己的觀察:「我思考的時候從來不用語言。我能清楚地感覺到,思考時用的是大腦的另一個部分,然後必須把想法翻譯成語言,才能和別人順暢交流。」
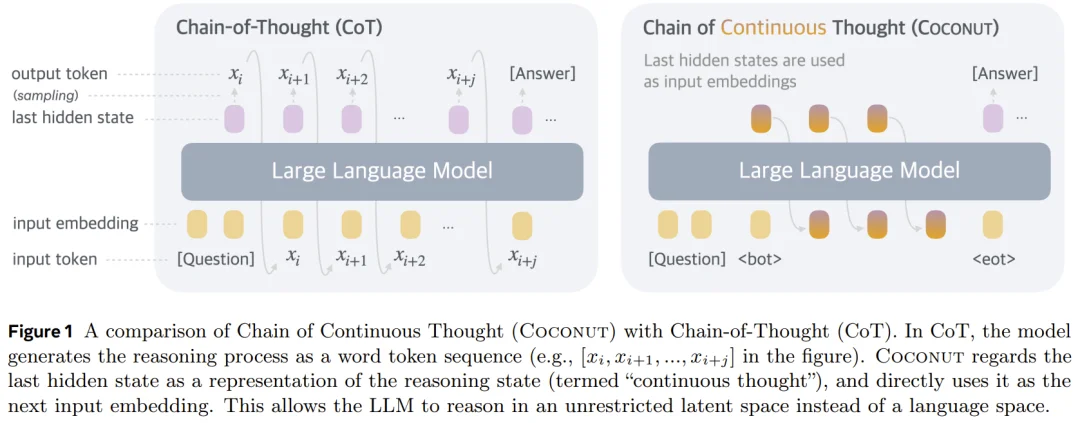
從這個直覺出發,團隊做了理論推導,發現潛在表示可以是多種想法的疊加態,用它來推理,在圖遍歷之類的問題上可能獲得顯著優勢,「也許不是指數級的,但至少有一定優勢」。
那為甚麼前沿模型至今沒有採用連續思維鏈?田淵棟給了兩個原因。
- 數據:人類大量的思考過程以語言形式被記錄下來,潛空間則沒有這樣的數據。
- 潛在表示可能是高度個人化的,「每個人多少都在用自己的潛在表示」,而大模型的學習效率遠低於人類,只能先用語言作為替代。
Ravid Shwartz-Ziv 追問,這是否和 JEPA 等自監督方法面臨的正則化難題類似。田淵棟表示認同,並把問題推得更深:梯度下降可能本身就陷入了一種「元層面的局部最優」,有些很好的表示,現在的訓練範式也許根本學不到,「我們現在並不知道邊界在哪」。
在他看來,這正是可解釋性研究的意義所在,「就像煉金術和化學的區別」。只不過當下模型太強,所有人都在追結果,願意投身這個方向的人和時間都還不夠。
和 GPT-5 合寫最後一篇論文之後
說到大模型時代的轉型,田淵棟認為,自己從 2018 年起持續在做的神經網絡訓練動力學分析,換到大模型上方法依然相通,並沒有帶來斷裂。真正的衝擊在實證層面:研究者過去自己提假設、做實驗、得結論,這一流程和一兩百年前沒甚麼本質區別;而當模型越來越強,自己就能產出想法,「研究者可能被迫在元層面思考,而不是把時間花在提出一個個具體假設上」。
同時,工程能力的地位大幅抬升。大模型時代的許多好工作「一半是研究,一半是工程」。直到 AI 編程智能體出現,局面又發生了變化:有扎實經驗的研究者可以讓智能體快速實現想法、定位關鍵問題,「突然之間就擁有了超能力,可以去探索真正深層的東西」。
轉折點是他在 Meta 的最後一篇論文——他也是唯一作者。這篇論文研究的是神經網絡的 grokking 現象,即網絡先死記硬背、訓練到某一時刻突然學會泛化。
整個過程中,他把 GPT-5 當作合作者:問它問題,給它「佈置作業」,讓它證明定理、檢查定理是否成立、一起頭腦風暴。
結果是效率提升了大約 6 到 10 倍,「而且這還是保守估計,因為當時我還在自己寫代碼」。如今代碼和實現也可以交給強大的智能體,速度只會更快。
於是有了開頭那句話。田淵棟坦言,研究者通常不願去小公司當聯合創始人,因為要操心大量研究之外的事情,「但我覺得現在是一次相變,如果我甚麼都不做,以後可能就無關緊要了」。
聯合主持人半開玩笑地回應,自己的應對方式是去學動手乾活,可惜「我並不擅長動手」。
AI 還想不出好點子
不過,田淵棟並不認為人類已經可以退場。「我不覺得現在的模型能在沒有任何人類乾預的情況下給出很好的結果。」即便是那篇和 GPT-5 合寫的論文,高層思路也是他給的,而不是讓模型自己想。
人類目前仍然要負責:
- 發起,決定甚麼問題值得做
- 驗證,判斷 AI 給出的方案靠不靠譜
Ravid Shwartz-Ziv 提到,近期不少讓智能體自主做後訓練、刷 Kaggle 的工作,都暴露出想法空間狹窄、容易對指標過擬合的問題。田淵棟認為,這在一定程度上是暫時的:模型被要求處理細節卻缺乏上下文,給它更多背景,它就可能提出比調超參數更有意思的想法。
但他也承認,補上下文只是「臨時修補」。現在的模型擅長重復性工作,因為互聯網數據里充滿了這類內容;如果要模型真正跳出框框,就需要新的架構,讓它能用極少的數據快速捕捉新信號。「從常規的重復性工作走到下一個層級,我們需要一次大的躍遷。」
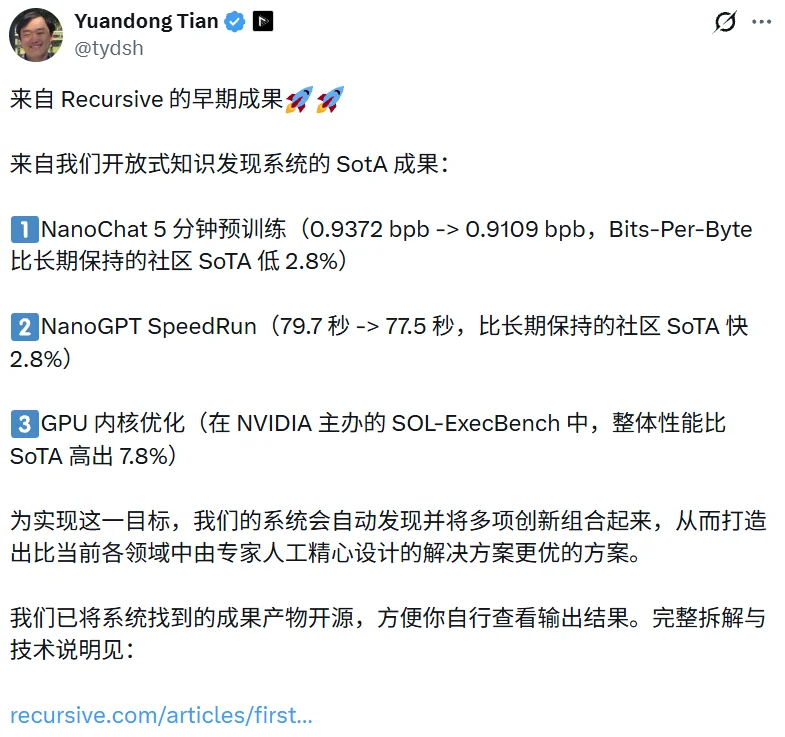
在「提出想法、寫代碼、跑實驗、分析結果」這個研究閉環里,他認為最難自動化的是想法。當被問到 Recursive 在 NanoGPT Speedrun 上的成績,即把訓練時間從 79.7 秒壓到 77.5 秒,究竟是真正的發現,還是對已知技巧的高效搜索時,田淵棟的回答是「兩者兼有」。比如在注意力里加入 bigram 信息的做法,可以在 DeepSeek、Gemma 3 乃至他在 Meta 時參與的 STEM 論文中找到相近思路,但如何在不同層使用不同的嵌入表、把這些想法組合起來,又包含了新的創造性。
新架構為何總在規模化時「失靈」?
不少公司提出過 Transformer 的替代架構,在小規模實驗上表現亮眼,卻始終沒能擴展到大模型。田淵棟的解釋是歸納偏置:小規模時數據不足,必須引入額外的結構假設,效果自然好;數據一多,最好的做法反而是讓模型自己去找規律。他舉了 ViT 的例子:ImageNet 量級的數據上,ViT 不如卷積網絡,但數據量到了數億級別,Transformer 就反超了。
那麼,新架構該怎麼驗證?
田淵棟認為當然要從小規模開始,但關鍵在於理解網絡內部到底發生了甚麼,「我們需要知道其中有某種洞見是能擴展到更大規模的,這樣才有信心」。否則,如果只是盲目遵循 scaling law,就永遠無法證明小規模上有效的東西在大規模上也有效,「那唯一的結果就是,算力最多的公司贏」。
他心目中更長遠的目標,是找到與人類相當的學習效率。人腦只用二三十瓦功耗和極少的數據,就能在很短時間內理解事物。機器人領域今天強調需要海量數據,在他看來只是當前範式的要求,「看看貓、狗這些具身的生物,它們並不需要那麼多數據,處理器也很粗糙,卻能在複雜世界里生存,那裡面一定有新的算法」。而強化學習和自我改進,可能是通往那裡最快的路。
限制自我改進?「邊界太模糊了」
節目最後,主持人問到了當下 AI 安全領域的一個熱點:有人呼籲限制最新模型,並就遞歸自我改進進行行業協調。
田淵棟的回答很直接:「說實話,我覺得很難阻止人們這麼做。」在他看來,邊界本身就模糊不清:你和編程智能體討論新想法、讓它迭代,某種程度上就是自我改進;你和別人合作寫論文,也是自我改進。再加上越來越強的開源模型,用它們做研究算不算自我改進?又該如何監管?
他明確表示,Recursive 會開源研究成果。此前公司的博客文章就開源了全部內核和訓練方案,讓外界可以檢驗、在此基礎上繼續開發。他更擔心另一種局面:「最糟糕的情況是,一小撮精英掌控著世界上最強的模型,然後讓其他所有人支付高昂溢價來使用。」
對於開源模型能否追上閉源,他相當樂觀。他以 Kimi 為例,認為它已經很好用,只是思考過程可能略長。在他看來,編程智能體並不需要「AI 牛頓」、「AI 愛因斯坦」上門幫你寫代碼,只要模型越過某條可用的線就夠了。
前沿實驗室早已越線,開源模型也正在越線,「一旦越過,它就會被商品化,每個人都會用自己喜歡的模型」。
從 Smith Hall 里那場關於 AlexNet 是否「僥倖」的爭論算起,已經過去了十四年。當年被質疑的深度學習,如今已經開始自己寫論文、改代碼、刷記錄。田淵棟選擇站到這股浪潮的最前面,用他的話說,接下來真正的問題是:「我們如何利用所有這些模型,去做更好、更大的事情。」
文章來自於"機器之心",作者 "Panda"。
有用嗎?