Tian Yuan Dong: Dopo aver scritto l'ultimo articolo in collaborazione con GPT-5, mi sono reso conto che avrei perso il lavoro entro 5 anni.
Di recente, OpenAI ha pubblicato su GitHub 722 manoscritti di articoli di matematica in una sola volta. Questi manoscritti sono stati raggruppati in 372 “famiglie” di risultati, che coprono 17 campi della matematica, e provengono tutti da una ricerca che non è ancora stata pubblicata e la cui identità non è stata resa nota al pubblico.Modello internoLa sua prestazione è di gran lunga superiore a quella di GPT-6 Astra.
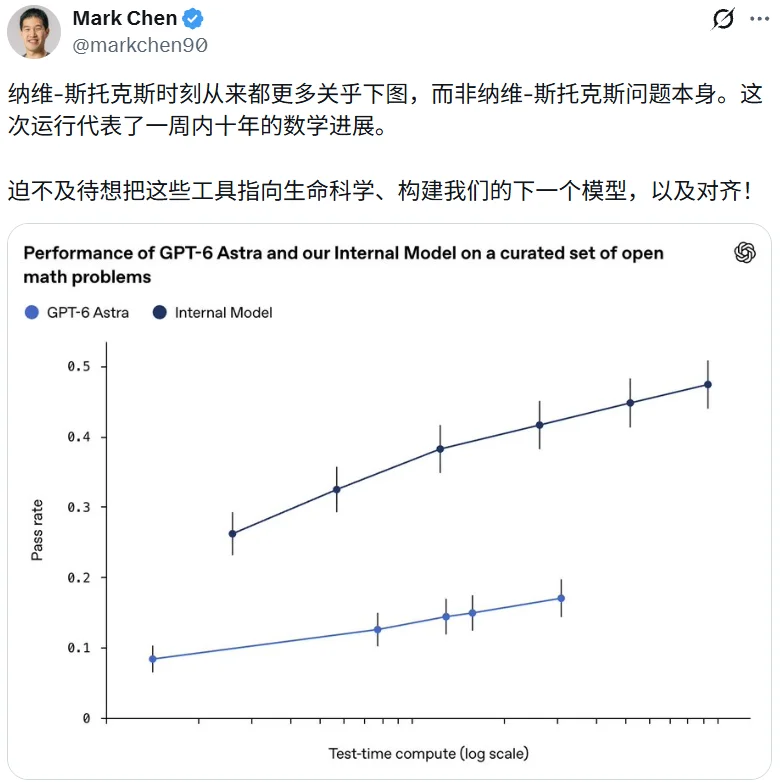
Tweet di Mark Chen, Chief Research Officer di OpenAI
Certo, nel mondo matematico ci sono ancora molte controversie sulla qualità di questi risultati e sul modo in cui sono stati divulgati, ma c'è una cosa che ormai è difficile da negare:La velocità con cui l’AI produce risultati di ricerca inizia ora ad essere misurata in “centinaia” di articoli.。
Quasi nello stesso momento, nell’ultimo episodio del podcast The Information Bottleneck, un veterano del campo dell’apprendimento automatico ha detto qualcosa che ha fatto preoccupare molti ricercatori: “Dopo aver completato questo progetto e ottenuto alcuni risultati interessanti, mi sono improvvisamente reso conto: Wow...”Il mio lavoro probabilmente sarà sostituito entro circa cinque anni.。」
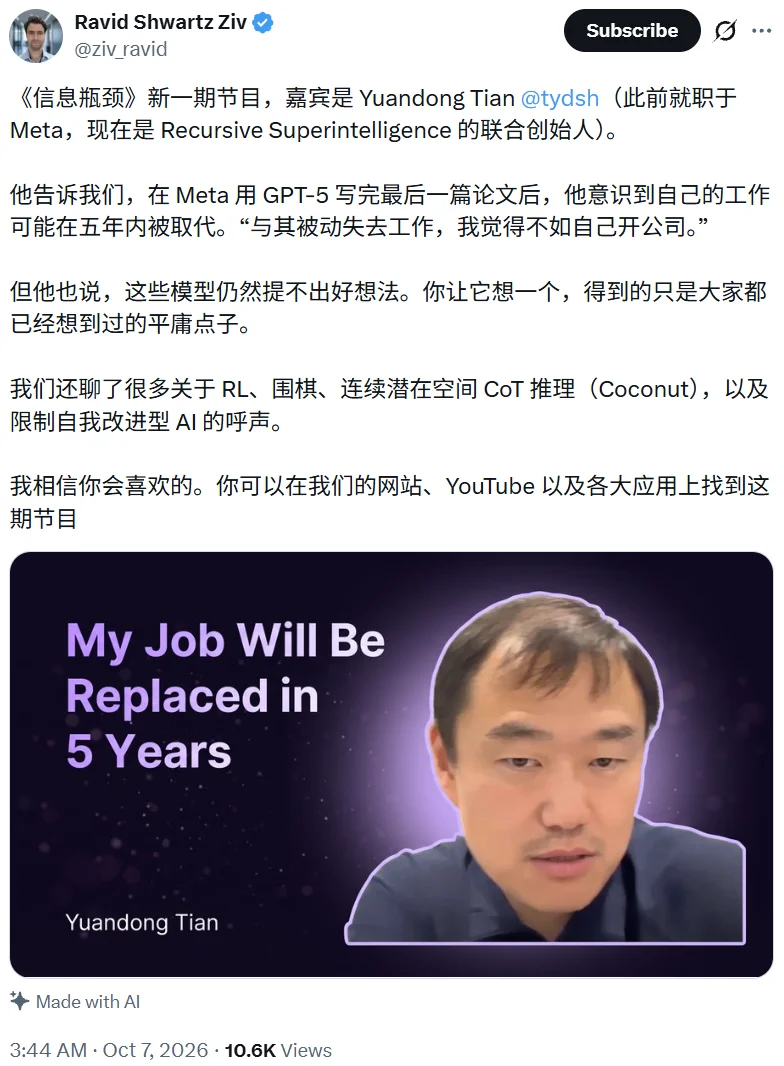
Indirizzo del podcast: https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
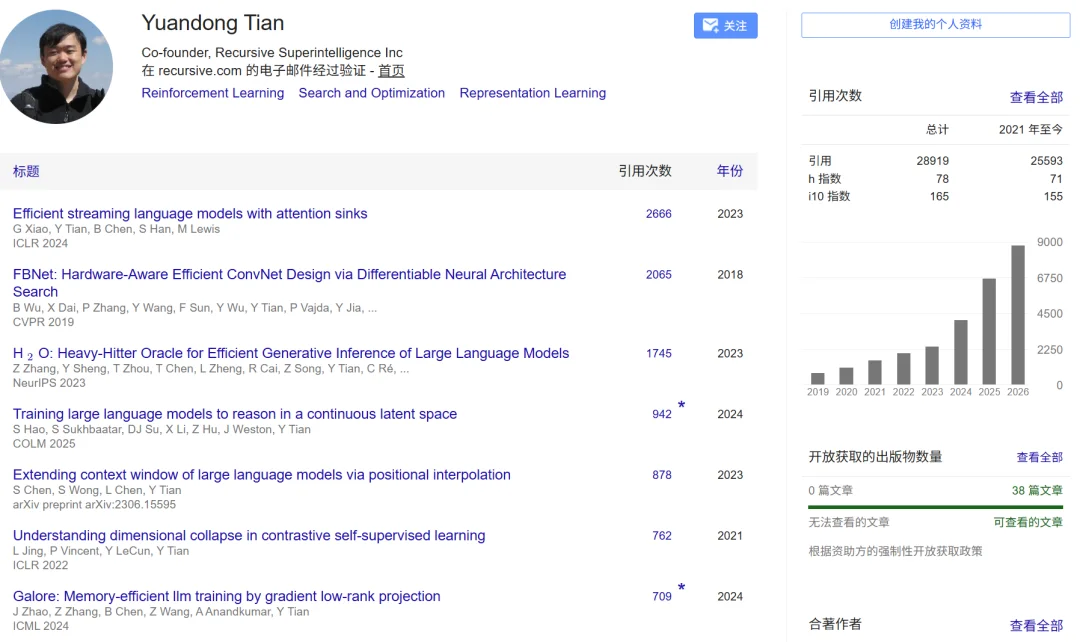
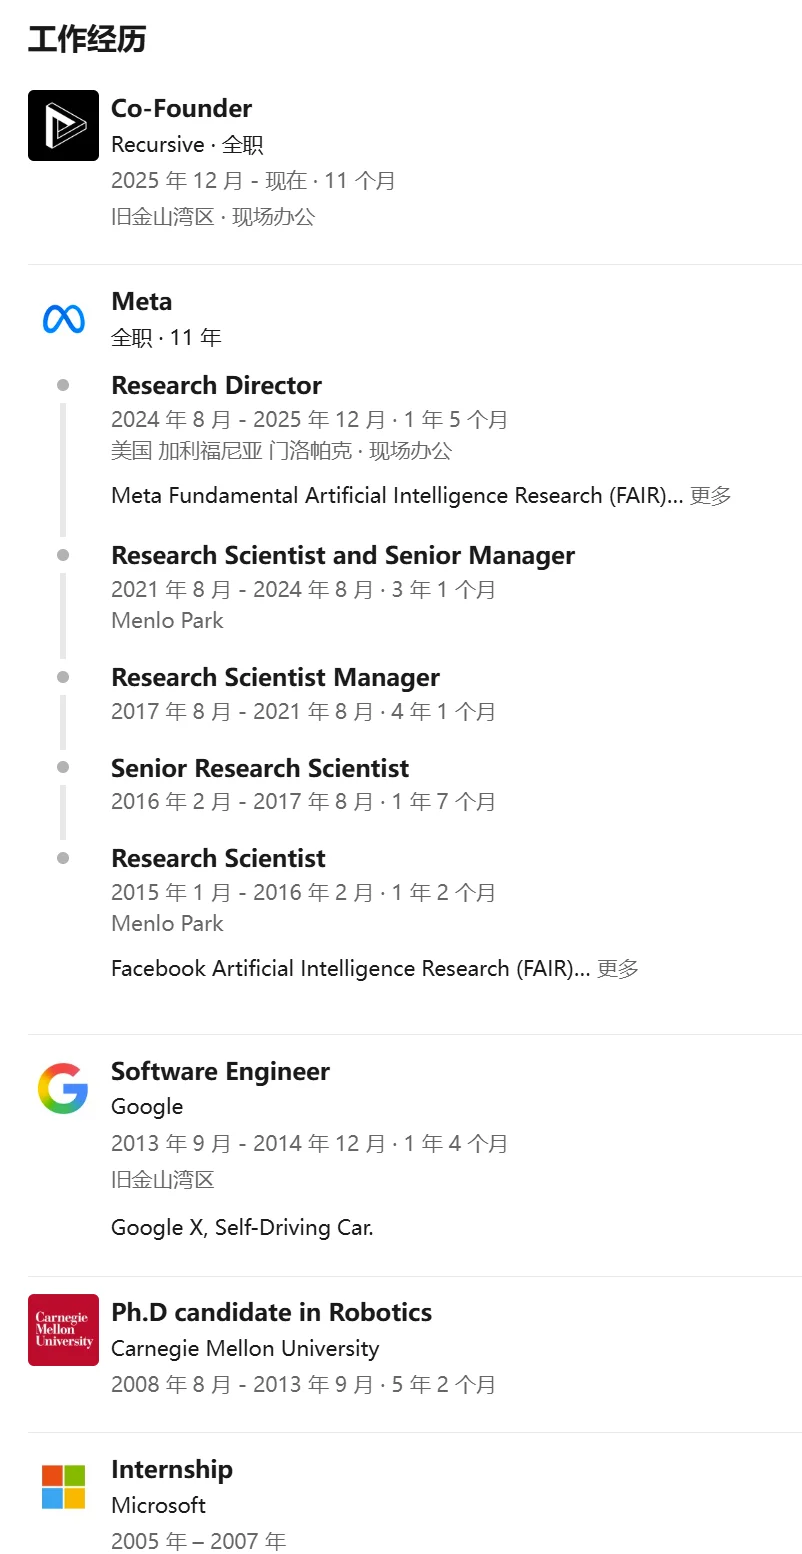
Chi ha detto queste parole è...Tian Yuan DongÈ stato a Meta FAIR per quasi dieci anni, ha lavorato su intelligenza artificiale per il gioco del Go, apprendimento rinforzato e interpretabilità delle reti neurali, ed è anche uno degli autori della ricerca su Coconut (una catena di pensiero nello spazio continuo).
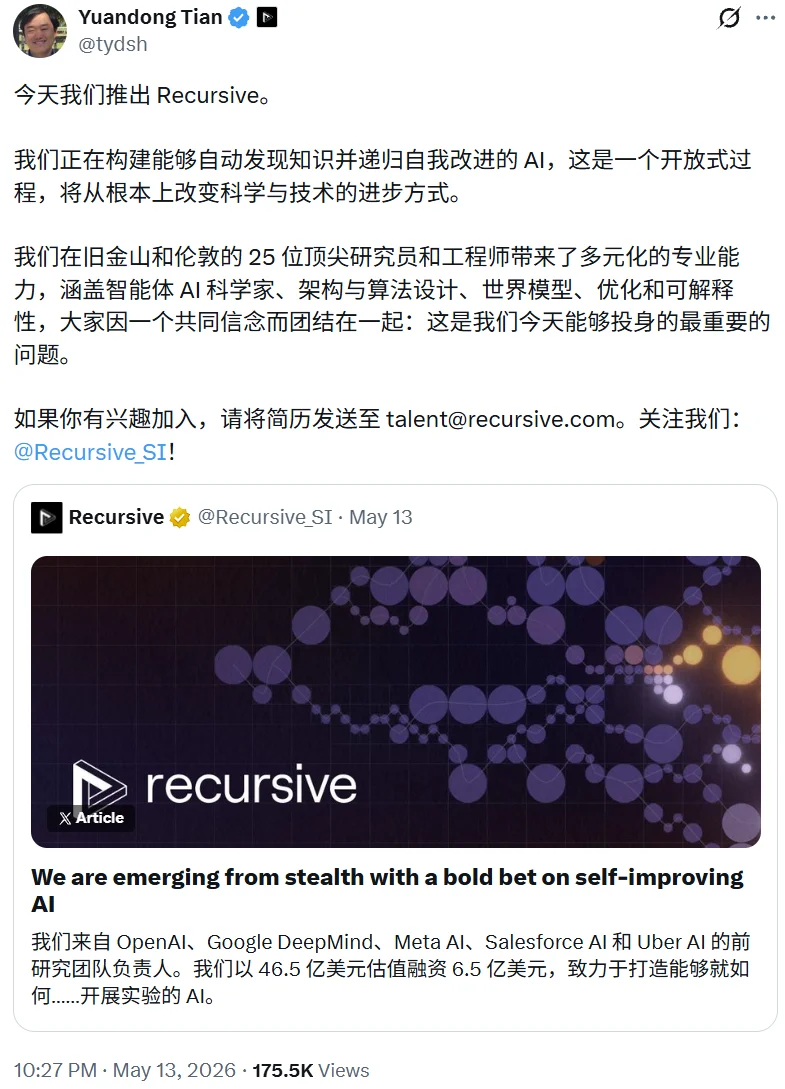
Oggi, la sua identità è Recursive Superintelligence Co-fondatore di [nome dell'azienda]. A maggio di quest'anno, l'azienda ha terminato la sua fase di “incognito” (non è più una società sconosciuta al pubblico) e ha annunciato di aver completato un round di finanziamento da oltre 650 milioni di dollari, con un valore di mercato stimato di 4,65 miliardi di dollari. Il round è stato guidato da GV e Greycroft, con partecipazione di Nvidia e AMD.
In questo episodio del podcast condotto da Ravid Shwartz-Ziv, Tanihara Tatsuhiko spiega il motivo per cui ha deciso di avviare una propria attività:Piuttosto che perdere il lavoro in modo passivo, è meglio avviare un’azienda che si muova in questa direzione.Tuttavia, ha anche gettato un po’ di acqua fredda sull’AI nel programma: “Se lasci che il modello pensi da solo, ti darà idee molto banali, che praticamente tutti conoscono e che non rappresentano nessuna direzione interessante.”
Durante quasi un’ora di conversazione, Tagawa Tadao ha parlato di vari argomenti, partendo dall’AlexNet degli anni al CMU, passando per l’intelligenza artificiale nel gioco del Go, dall’“spazio delle azioni” alla ragionamento nello spazio potenziale, fino ad arrivare all’autoperfezionamento ricorsivo, a nuove architetture e all’open source. Ecco un riassunto di questa discussione.
La lite in Smith Hall: AlexNet è davvero un incidente?
Tian Yuan Dong è arrivato negli Stati Uniti nel 2008 per frequentare il dottorato di ricerca presso il Laboratorio di Robotica dell'Università Carnegie Mellon. A quel tempo, l'apprendimento automatico non aveva ancora la rilevanza che ha oggi. “Molte persone non ritenevano che l'apprendimento automatico fosse una strada promettente; dicevano che non funzionasse bene, perché tendeva ad overfitting e che non si capisse bene cosa stesse succedendo al suo interno.”
Il suo progetto di dottorato riguarda il campo della visione artificiale.Problemi di ottimizzazione non convessaAd esempio, per ripristinare le distorsioni nell'immagine causate dalla rifrazione dell'acqua. Ha utilizzato un approccio stratificato per ottimizzare il problema e ha dimostrato che, anche se il problema non è convesso, è ancora possibile dimostrare l'ottimalità in una certa misura, a condizione che ci siano abbastanza dati. “L'uso di dati per guidare il processo di ottimizzazione è una combinazione interessante; sono ancora molto orgoglioso di questo lavoro.”
Nel 2012 è emerso AlexNet. Tanaka Masaaki ha inviato un’e-mail ad Alex Krizhevsky, chiedendo il codice per poterlo esaminare personalmente. Ha rapidamente realizzato che il processo di elaborazione a livelli delle reti convoluzionali corrispondeva in realtà al concetto di ottimizzazione stratificata descritto nel suo articolo scientifico: “Forse è proprio ciò che stavo cercando, solo presentato in una forma diversa”.
Ma all'epoca l'atmosfera al CMU non era affatto cordiale. “Tutti venivano in ufficio ogni giorno e discutevano animatamente in Smith Hall se i risultati ottenuti con AlexNet fossero dovuti a una semplice fortuna o a un vero e proprio progresso tecnologico. La maggior parte delle persone era dell’opinione che si trattasse solo di fortuna, perché non sembrava plausibile.”
Al momento della laurea nel 2013, Tagawa Masaaki ha ricevuto offerte da diverse aziende interessate allo sviluppo di tecnologie di deep learning, ma alla fine ha scelto di unirsi al team di autonomia di Google. Da un lato, è stata la fama dell'azienda a spingerlo; dall'altro, un consiglio di un amico ha avuto un ruolo importante nella sua decisione. Tuttavia, durante il suo anno e mezzo di permanenza lì, non è riuscito a realizzare nulla significativo nel campo del deep learning, poiché il team operava più come una startup, concentrata sulla risoluzione di problemi pratici attraverso soluzioni mature piuttosto che sull'esplorazione scientifica. Per questo motivo, ha cambiato lavoro e si è unito a FAIR, definendo questa scelta "una delle migliori che abbia mai fatto".
Due persone, una sola GPU: i ricordi di Tian Yuan Dong sul gioco del Go
A FAIR, il primo progetto avviato da Takahashi Mifune è stato l'AI per il gioco del Go. Nel 2015, il suo team ha realizzato... DarkForestHa sconfitto i migliori giocatori amatoriali online grazie a una rete convoluzionale. Pochi mesi dopo, nell'estate del 2016, AlphaGo ha battuto anche i giocatori professionisti.
Di fronte a questo tipo di “scontro”, Tanihara Masaaki ritiene che AlphaGo abbia due aspetti che lui stesso non possiede:
- Rete di Valori,DarkForest all'epoca disponeva solo di una rete di strategie;
- Prima di questo, lui stesso aveva quasi nessuna esperienza in materia.Apprendimento rafforzatoContesto: "In pratica, ho imparato facendo, proprio come se stessi applicando i principi dell'apprendimento automatico intensivo a me stesso". Questa esperienza lo ha portato in seguito a dedicarsi a un gran numero di ricerche nel campo dell'apprendimento automatico intensivo.
Alla domanda se AlphaGo fosse stato sorprendente, la sua risposta è stata molto interessante: il metodo in sé non è sorprendente, perchéLe reti convoluzionali sono in grado di catturare i modelli del tabellone di scacchi su cui gli esseri umani fanno affidamento durante la partita.“La cosa davvero sorprendente è che sia in grado di battere giocatori professionisti di scacchi”.
Nel 2018, il team ha riprodotto AlphaZero, un sistema in grado di giocare da solo a scacchi senza alcun riferimento a partite umane, e ha apportato alcune migliorie per aumentarne l’efficienza, ottenendo risultati significativi. OpenGoQuesto AI, in una partita ufficiale contro l'Accademia di Scacchi della Corea, ha utilizzato soltanto una GPU V100 e ha fatto sì che nessuno dei quattro giocatori professionisti riuscisse a vincere una partita. “Penso che sia probabilmente…”Per la prima volta, qualcuno è riuscito a sconfiggere un giocatore professionista utilizzando un singolo GPU.。」
Prima della partita c'è stato un piccolo episodio. Il team ha chiesto ad amici giocatori professionisti e semiprofessionisti di valutare le capacità di gioco di OpenGo, e questi hanno risposto che all'inizio riuscivano a capire la strategia di apertura, ma poi non hanno più potuto seguirla, dicendo solo: "Sembra molto forte, ma non so se lo sia davvero". Così, Tagawa Takahiro ha deciso: allora affronteremo direttamente un vero giocatore professionista.
Lo spazio di azione è più importante dell'algoritmo.
Parlando dell'apprendimento automatico in quell'epoca, Tagawa Tadao riteneva cheCi sono molti metodi che ancora oggi vengono sottovalutati.Ad esempioApprendimento rafforzato distribuitoAdatta il modello utilizzando la distribuzione dei premi invece di un singolo valore scalare; per esempio, Metodi di modellazione diversi come l’apprendimento basato su domande e risposte (Q-learning)「Ma ora la maggior parte delle volte utilizziamo il gradiente strategico, si tratta di un’epoca molto diversa.”
Anche lui è ottimista.Metodi di ottimizzazione senza gradienteE ritengono che i grandi modelli offrano nuove possibilità: “I grandi modelli ora hanno una migliore comprensione di livello superiore dei sistemi e delle funzioni obiettivo da ottimizzare, una comprensione che è molto più utile delle informazioni sui gradienti locali”. In situazioni in cui i gradienti cambiano drasticamente e i punti ottimali locali sono ovunque, i metodi basati sui gradienti possono portare a un vicolo cieco, mentre i metodi senza gradienti includono naturalmente un elemento di esplorazione, “qualcosa che i metodi basati sui gradienti non fanno mai”.
Intorno al 2018 e al 2019, Tagaki Takahide iniziò a provare ad applicare l'apprendimento rinforzato a problemi del mondo reale, e le conclusioni furono piuttosto sorprendenti:Quello che è davvero importante non è l’algoritmo, ma la progettazione dello spazio delle azioni e dello spazio degli stati.」
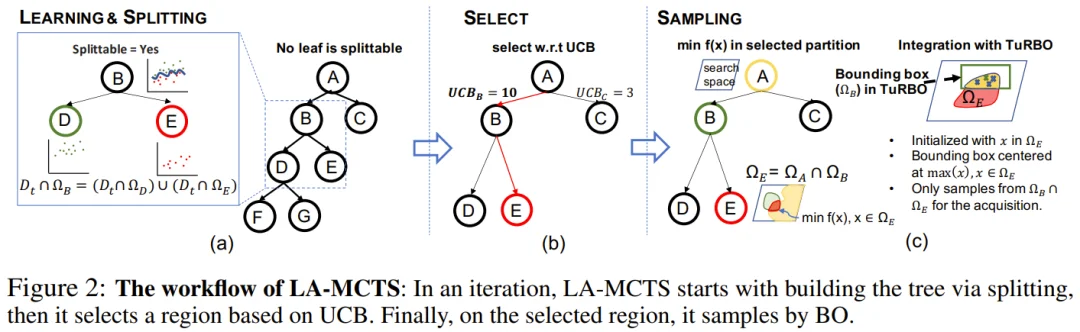
Ha preso come esempio la ricerca di architetture neurali. Gli esseri umani sanno che la profondità della rete è fondamentale, ma l’AI non lo sa. Se l’AI iniziasse a cercare dettagli come le dimensioni dei primi nuclei convoluzionali, il comportamento di tutte le ramificazioni sarebbe simile e la funzione di valutazione non fornirebbe segnali utili; quindi, per esplorare più in profondità, lo spazio di ricerca esploderebbe esponenzialmente, e “in quel caso, nessun algoritmo sarebbe efficace”. D’altra parte, se lo spazio delle possibili configurazioni potesse essere riorganizzato in modo che l’AI “si rendesse conto” fin dall’inizio dell’importanza della profondità, ci sarebbe un netto contrasto tra reti profonde e superficiali, e dopo pochi tentativi si potrebbe individuare la direzione corretta. Sulla base di questo, il team ha proposto…Ricerca degli alberi Monte Carlo nello spazio nascosto (LA-MCTS)L'idea principale è quella di trovare automaticamente lo spazio delle azioni che permette la massima distinzione tra i sottospazi di ricerca.
Coconut: “Quando penso, non uso mai il linguaggio.”
Il co-presentatore ha menzionato la partecipazione di Tanno Tadaoka. Coconut Il paper propone di far ragionare i modelli in uno spazio continuo di potenziale, piuttosto che nello spazio dei token. Tanaka Masaaki afferma che questa idea deriva dalle sue osservazioni personali: “Quando penso, non uso mai il linguaggio. Posso sentire chiaramente che durante il pensiero utilizzo una parte diversa del cervello, e poi devo tradurre i miei pensieri in parole per poter comunicare efficacemente con gli altri.”
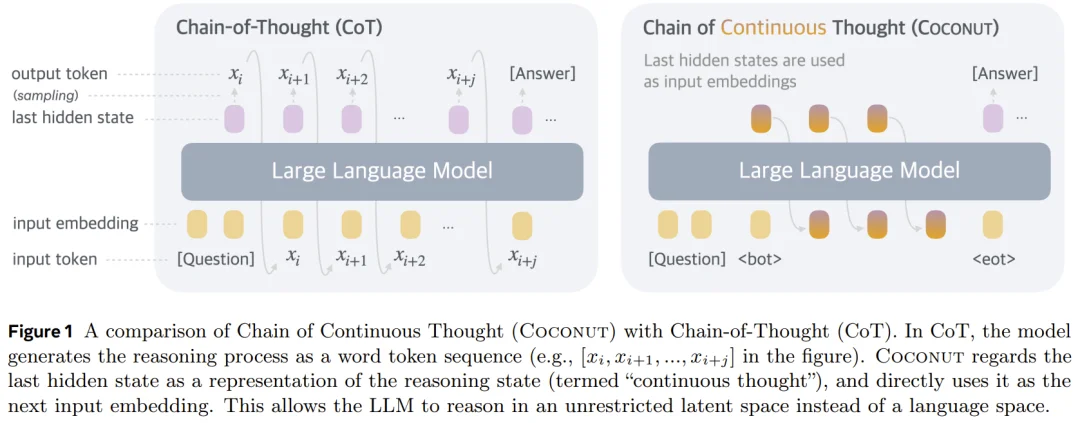
Partendo da questa intuizione, il team ha condotto delle deduzioni teoriche e ha scoperto che la rappresentazione potenziale può essere uno stato sovrapposto di molteplici idee. Utilizzandola per il ragionamento, si potrebbero ottenere vantaggi significativi in problemi come l'iterazione dei grafici; “forse non esponenziali, ma almeno un certo vantaggio”.
Allora, perché i modelli di punta non hanno ancora adottato catene di pensiero continue? Tanaka Masaaki ha fornito due ragioni.
- DatiGran parte del processo di pensiero umano viene registrato in forma di linguaggio, ma lo spazio potenziale (il “spazio latente”) non dispone di tali dati.
- Le potenziali rappresentazioni potrebbero essere altamente personalizzate.“Ognuno, in qualche modo, utilizza la propria rappresentazione potenziale”, ma l’efficienza di apprendimento dei grandi modelli è molto inferiore a quella umana, quindi per il momento si deve utilizzare il linguaggio come sostituto.
Ravid Shwartz-Ziv chiede se questo sia simile ai problemi di regolarizzazione che affrontano i metodi di auto-supervisione come JEPA. Tanaka Masaaki concorda e approfondisce il discorso: il metodo della discesa del gradiente potrebbe essersi intrappolato in una sorta di “ottimo locale a livello meta”, e alcune rappresentazioni molto efficaci potrebbero semplicemente non essere apprese con i paradigmi di addestramento attuali. “Non sappiamo nemmeno dove si trovino i confini”, afferma.
Secondo lui, questo è proprio ciò che...Ricerca sull'interpretabilitàIl significato risiede nel fatto che è “come la differenza tra alchimia e chimica”. Tuttavia, i modelli attuali sono troppo potenti, e tutti sono concentrati sui risultati; non ci sono abbastanza persone e tempo disponibili per impegnarsi in questa direzione.
Dopo aver scritto insieme l'ultimo articolo con GPT-5
Parlando della transizione all'era dei grandi modelli, Tanaka Masaaki ritiene che l'analisi della dinamica dell'addestramento delle reti neurali che ha svolto costantemente dal 2018 possa essere applicata anche ai grandi modelli, senza alcun cambiamento metodologico significativo. L'impatto reale si trova a livello empirico: i ricercatori, come in passato, formulano ipotesi, conducono esperimenti e raggiungono conclusioni, e questo processo non è essenzialmente diverso da quello di un secolo o due fa;Man mano che il modello diventa più potente, è in grado di generare idee da solo.“I ricercatori potrebbero essere costretti a riflettere a un livello più astratto, invece di dedicare il loro tempo a formulare ipotesi specifiche una per una”.
Nello stesso tempo,La posizione delle capacità ingegneristiche è notevolmente migliorata.Molte delle buone opportunità nell'era dei grandi modelli richiedono "metà ricerca e metà ingegneria". Tuttavia, con l'emergere degli agenti di programmazione AI, la situazione è cambiata: ricercatori con esperienza possono far sì che questi agenti realizzino rapidamente le idee e individuino i problemi chiave, "dando loro improvvisamente superpoteri per esplorare cose davvero profonde".
Il punto di svolta è stato il suo ultimo articolo su Meta, di cui era l’unico autore. Questo articolo riguardava lo studio dei reti neurali. grokking Il fenomeno consiste nel fatto che il sistema impara a memoria i dati disponibili in rete e, dopo un certo periodo di addestramento, improvvisamente acquisisce la capacità di generalizzare (di applicare le conoscenze apprese a nuovi contesti).
Durante l'intero processo,Lui considera GPT-5 come un collaboratore.Ponigli domande, assegnagli “compiti”, fagli dimostrare i teoremi, verificare se i teoremi sono corretti, e fare brainstorming insieme.
Il risultato èL'efficienza è migliorata di circa 6 a 10 volte."E inoltre, questa è solo una stima conservativa, perché all'epoca stavo ancora scrivendo il codice da solo". Oggi il codice e l'implementazione possono essere affidati ad agenti intelligenti molto potenti, e la velocità sarà ancora maggiore.
Ecco quindi la frase iniziale. Tanaka Masaaki ammette che di solito i ricercatori non vogliono diventare co-fondatori di piccole aziende, poiché devono occuparsi di molte cose oltre alla ricerca stessa: “Ma penso che ora ci sia un cambiamento cruciale; se non faccio nulla, potrebbe diventare irrilevante in futuro”.
Il co-conduttore ha risposto scherzando, dicendo che il suo modo di affrontare la situazione era imparare a fare cose con le mani, ma purtroppo “non sono bravo in questo”.
L'AI non riesce ancora a pensare a una soluzione migliore.
Tuttavia, Tanaka Miki non ritiene che gli esseri umani possano ormai ritirarsi dalla scena.Non credo che i modelli attuali siano in grado di fornire risultati eccellenti senza alcun intervento umano.Anche per quel paper scritto in collaborazione con GPT-5, l'idea di base è stata fornita da lui, non è stata lasciata all'autoapprendimento del modello.
L'umanità deve ancora assumersi la responsabilità di:
- AvviaDecidere quali problemi meritino di essere affrontati
- VerificaValutare se la soluzione proposta dall'AI sia affidabile o meno
Ravid Shwartz-Ziv ha sottolineato che molti recenti progetti che utilizzano agenti intelligenti per eseguire il training autonomo e partecipare a competizioni come Kaggle hanno evidenziato problemi legati a una limitata gamma di idee e a una facile overfitting degli indicatori di prestazione. Tanihara Takashi ritiene che questo fenomeno sia, in parte, temporaneo: i modelli vengono sollecitati a gestire dettagli specifici ma mancano di contesto; fornendo loro più informazioni di contesto, potrebbero produrre idee più interessanti rispetto al semplice ottimizzazione dei parametri di configurazione.
Ma ammette anche che aggiungere il contesto è solo una “riparazione temporanea”. I modelli attuali sono bravi nel svolgere lavori ripetitivi, poiché i dati di Internet sono pieni di questo tipo di contenuti;Se il modello vuole davvero “uscire dai confini” (ovvero funzionare in modi non previsti o convenzionali), è necessaria una nuova architettura.“Per essere in grado di catturare nuovi segnali con pochissimi dati, dobbiamo fare un grande salto dal lavoro ripetitivo convenzionale al livello successivo.”
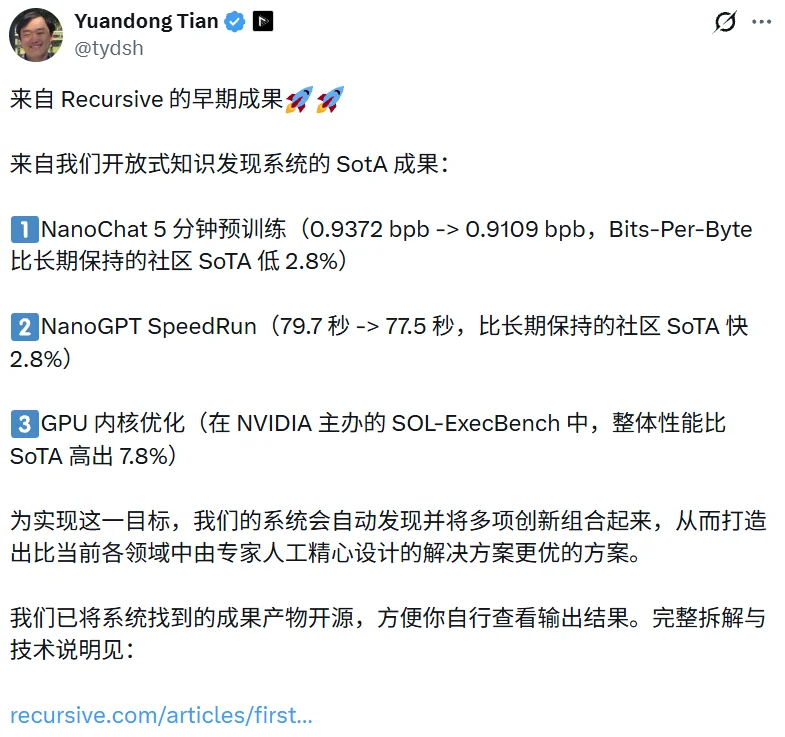
Nel ciclo di ricerca che comprende “proporre idee, scrivere codice, eseguire esperimenti e analizzare i risultati”, lui ritiene che…La cosa più difficile da automatizzare sono le idee.Quando gli è stato chiesto quale sia stato il contributo di “Recursive” nel miglioramento dei tempi di training di NanoGPT Speedrun, ovvero passando da 79,7 secondi a 77,5 secondi, se si tratti di una vera scoperta o semplicemente di un utilizzo più efficiente di tecniche già conosciute, la risposta di Takao Tagawa è stata “entrambi”. Ad esempio, l’aggiunta di informazioni di tipo “bigram” all’algoritmo di attenzione (attention mechanism) è un approccio simile a quello trovato in progetti come DeepSeek, Gemma 3, nonché nei suoi articoli scientifici su STEM pubblicati su Meta. Tuttavia, il modo in cui sono stati utilizzati diversi tipi di embedding in diversi livelli dell’algoritmo e come queste idee sono state combinate rappresenta una vera e propria forma di creatività.
Perché le nuove architetture tendono sempre a “fallire” quando vengono scalate?
Molte aziende hanno proposto architetture alternative al Transformer, che hanno mostrato buone prestazioni in esperimenti su piccola scala, ma non sono mai riuscite ad essere adattate per modelli di grandi dimensioni. La spiegazione di Tagaki Tadao è...Induzione del biasQuando il dataset è di piccole dimensioni, non ci sono abbastanza dati per formulare ipotesi strutturali dettagliate, quindi è necessario introdurre assunzioni aggiuntive, il che naturalmente influisce positivamente sulle prestazioni del modello; tuttavia, quando il volume dei dati aumenta, la strategia migliore è lasciare che il modello stesso individui le regolarità presenti nel dataset. Ha fatto l’esempio di ViT: su dataset di dimensioni simili a quelle di ImageNet, ViT non è all’altezza delle reti convoluzionali, ma quando il volume dei dati raggiunge i miliardi di elementi, i Transformer superano nettamente le altre tecnologie.
Allora, come si dovrebbe verificare la nuova architettura?
Tian Yuan Dong pensa di sì, ovviamente.Iniziare su piccola scalaMa la cosa fondamentale è capire cosa realmente accade all’interno della rete; “Dobbiamo sapere che esista qualche intuizione che possa essere estesa a scale più ampie, solo così possiamo avere fiducia”. Altrimenti, se ci limitiamo a seguire ciecamente le leggi di scalabilità, non saremo mai in grado di dimostrare che ciò che funziona su piccola scala funziona anche su larga scala. “L’unico risultato sarebbe che vincerebbero le aziende con il maggior potere di calcolo”.
L'obiettivo a più lungo termine che ha in mente èRaggiungere un efficienza di apprendimento paragonabile a quella umanaIl cervello umano, con un consumo energetico di soli venticinque-trenta watt e utilizzando pochissimi dati, è in grado di comprendere le cose in tempi molto brevi. Secondo lui, l’enfasi attuale nel campo dei robot sull’uso di grandi quantità di dati è solo una conseguenza del paradigma attuale. “Basta guardare gli animali corporei come gatti e cani: non hanno bisogno di così tanti dati, e i loro processori sono piuttosto semplici, ma riescono comunque a sopravvivere in un mondo complesso. Ci devono essere nuovi algoritmi alla base di questo fenomeno.”E l'apprendimento automatico potenziato e l'autoperfezionamento potrebbero essere la strada più veloce per arrivarci.
Limitare il proprio miglioramento? “I confini sono troppo vaghi”.
Alla fine del programma, il presentatore ha affrontato un argomento caldo nel campo della sicurezza dell’AI: alcune voci chiedono di limitare i modelli più recenti e di coordinare l’industria per quanto riguarda il processo di auto-miglioramento ricorsivo.
La risposta di Tanaka Miki è molto diretta: “Onestamente, penso che sia difficile impedire alle persone di farlo.” Secondo lui, i confini stessi sono piuttosto sfumati: discutere nuove idee con un agente di programmazione e farlo iterare è, in un certo senso, un processo di auto-miglioramento; collaborare con altri per scrivere un articolo scientifico è anch’esso un modo di auto-migliorarsi. Inoltre, con i modelli open source che diventano sempre più potenti, utilizzarli per la ricerca può essere considerato un atto di auto-miglioramento? E come dovremmo regolamentare tutto questo?
Ha espresso chiaramente che,I risultati della ricerca su “Recursive” saranno resi disponibili in codice sorgente.Prima di questo, gli articoli del blog dell'azienda avevano reso open source l'intero kernel e i piani di training, permettendo a tutti di verificarli e svilupparli ulteriormente su quella base. Tuttavia, lui teme un'altra situazione: "Il caso peggiore è che un piccolo gruppo di élite controlli i modelli più potenti del mondo, costringendo tutti gli altri a pagare un prezzo elevato per utilizzarli."
È abbastanza ottimista riguardo al fatto che i modelli open source possano raggiungere i modelli chiusi (non open source).Ha preso Kimi come esempio, ritenendo che sia già molto utile, anche se il processo di pensiero potrebbe essere un po’ più lungo. Secondo lui, gli agenti di programmazione non hanno bisogno di “AI Newton” o “AI Einstein” che vengano a scrivere il codice al posto loro; basta che il modello superi una certa soglia di efficacia.
I laboratori di ricerca all'avanguardia hanno già superato i limiti consentiti, e anche i modelli open source stanno per farlo. “Non appena lo faranno, saranno commercializzati, e tutti potranno utilizzare il modello che preferiscono.”
Sono passati quattordici anni da quella discussione in Smith Hall riguardo al fatto che AlexNet fosse stato un caso di “fortuna”. Il deep learning, che all’epoca era stato messo in dubbio, oggi è in grado di scrivere i propri articoli scientifici, modificare il codice e battere record. Tanaka Masaaki ha scelto di stare in prima linea di questa tendenza, e secondo le sue parole, la vera domanda che ci si pone ora è: “Come possiamo utilizzare tutti questi modelli per realizzare cose migliori e più importanti?”
L'articolo proviene da "Machine Heart", scritto da "Panda".
Link dell’articolo:https://www.airai.cc/it/ai-news/60/
有用吗?