ทานาบุ ทากาฮาชิ:หลังจากเขียนบทความชิ้นสุดท้ายร่วมกับ GPT-5 ฉันก็ตระหนักว่าฉันอาจจะตกงานภายใน 5 ปีข้างหน้า
เมื่อไม่นานมานี้ OpenAI ได้ปล่อยต้นฉบับงานวิจัยทางคณิตศาสตร์จำนวน 722 ฉบับลงบน GitHub ต้นฉบับเหล่านี้ถูกจัดอยู่ใน 372 กลุ่มผลลัพธ์ ครอบคลุม 17 สาขาของคณิตศาสตร์ และทั้งหมดนี้มาจากผลงานที่ยังไม่ได้รับการเผยแพร่และยังไม่มีชื่อเปิดเผยรูปแบบแบบจำลองภายใน——ประสิทธิภาพของมันเหนือกว่า GPT-6 Astra เป็นอย่างมาก。
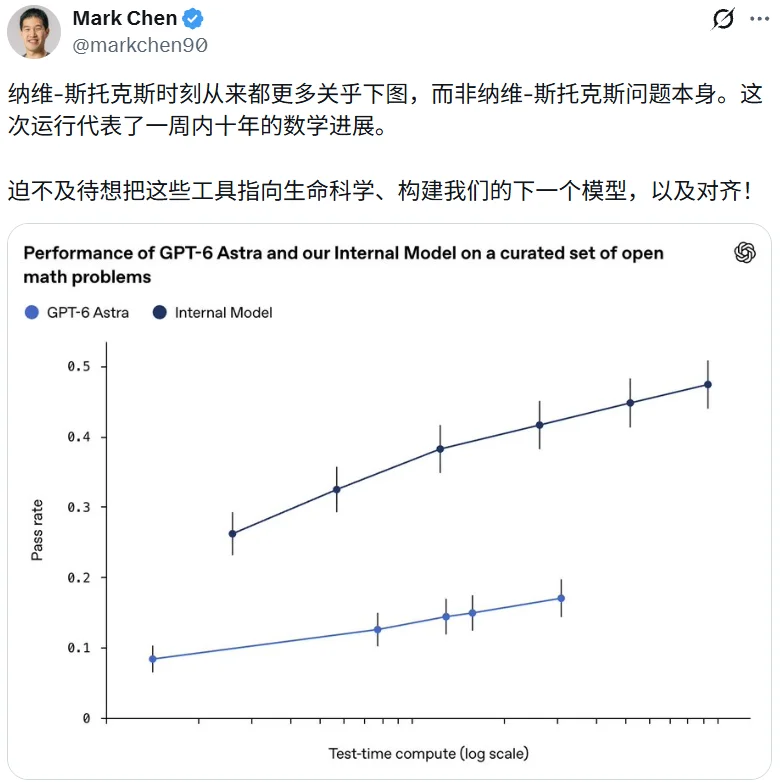
ทวีตจาก Mark Chen หัวหน้านักวิจัยของ OpenAI
แน่นอนว่าในแวดวงคณิตศาสตร์ยังมีการถกเถียงกันอย่างมากเกี่ยวกับคุณภาพและวิธีการเปิดเผยผลงานเหล่านี้ แต่มีสิ่งหนึ่งที่แทบจะไม่สามารถปฏิเสธได้เลย:ความเร็วในการผลิตงานวิจัยด้าน AI เริ่มถูกนับในหน่วย “ร้อยบทความ” แล้ว。
เกือบจะพร้อมกันนั้นเอง ในรายการพอดแคสต์ The Information Bottleneck ฉบับล่าสุด ผู้เชี่ยวชาญด้านการเรียนรู้ของเครื่อง (deep learning) คนหนึ่งได้พูดประโยคที่ทำให้นักวิจัยหลายคนรู้สึกกังวล: “หลังจากที่ทำโปรเจกต์นี้เสร็จสิ้นและได้ผลลัพธ์ที่น่าสนใจมาบ้าง ฉันก็รู้สึกตกใจขึ้นมาว่า: ว้า…”งานของฉันน่าจะถูกแทนที่ภายในประมาณห้าปีข้างหน้า。」
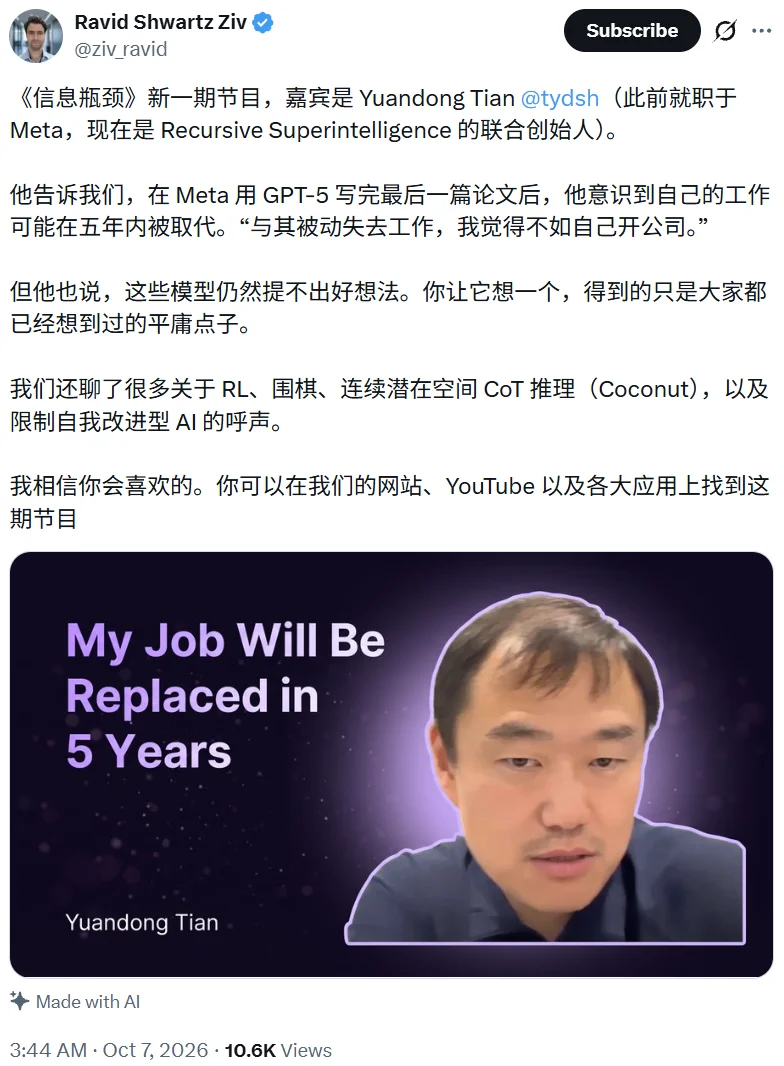
ที่อยู่ของพอดแคสต์: https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
คนที่พูดคำนี้คือทานาบุ ทากาฮาชิเขาอยู่ที่ Meta FAIR เป็นเวลาเกือบสิบปี ทำงานด้าน AI สำหรับเกมโกะ การเรียนรู้เชิงเสริม (reinforcement learning) และความเข้าใจได้ของเครือข่ายประสาท (neural network interpretability) นอกจากนี้เขายังเป็นหนึ่งในผู้เขียนบทความเกี่ยวกับ Coconut (ชุดแนวคิดเชิงพื้นที่ลึกต่อเนื่อง) อีกด้วย
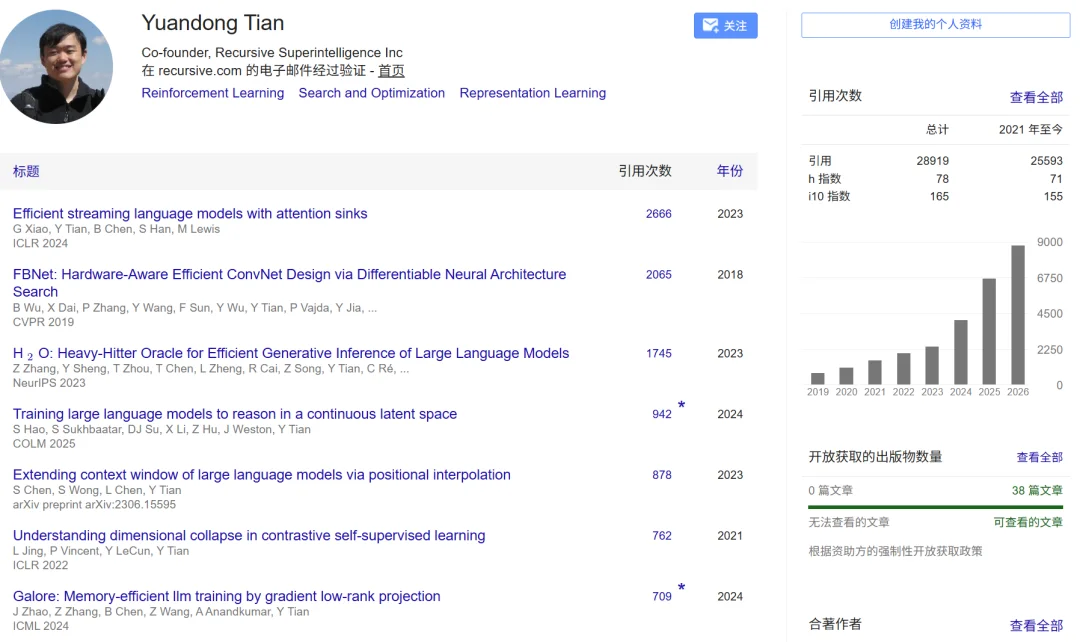
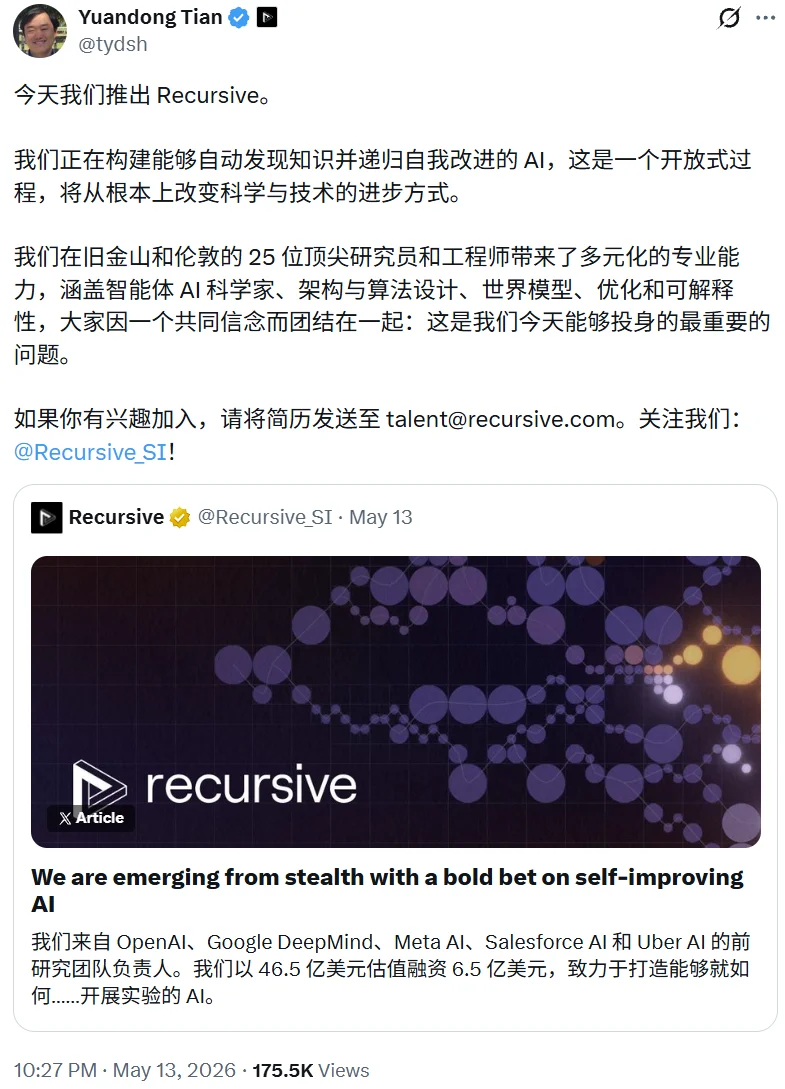
ปัจจุบัน สถานะของเขาคือ Recursive Superintelligence หนึ่งในผู้ก่อตั้งร่วมของบริษัทดังกล่าว ในเดือนพฤษภาคมปีนี้ บริษัทได้เลิกการซ่อนตัวและประกาศว่าได้รับเงินทุนมากกว่า 650 ล้านดอลลาร์สหรัฐ โดยมีมูลค่าบริษัทอยู่ที่ 4.65 พันล้านดอลลาร์สหรัฐ โดยมี GV และ Greycroft เป็นผู้นำการลงทุน รวมถึง NVIDIA และ AMD ก็มีส่วนร่วมด้วย
ในรายการพอดแคสต์นี้ที่ Ravid Shwartz-Ziv เป็นผู้ดำเนินรายการ ทานาบาอากิ ทานาบากะ ได้อธิบายถึงเหตุผลที่เขาตัดสินใจเริ่มต้นธุรกิจของตัวเอง:แทนที่จะปล่อยให้ตัวเองตกงานอย่างไม่มีทางเลือก การเริ่มต้นธุรกิจของตัวเองที่เดินไปในทิศทางนั้นน่าจะเป็นทางเลือกที่ดีกว่าอย่างไรก็ตาม เขาก็ได้พูดในรายการเพื่อทำให้ความคิดเห็นเกี่ยวกับ AI ดูเย็นลงหน่อย “ถ้าคุณปล่อยให้โมเดลคิดค้นไอเดียเอง มันจะให้คุณไอเดียที่ธรรมดามาก ๆ ซึ่งแทบทุกคนก็รู้จักอยู่แล้ว และมันก็ไม่ใช่ทิศทางที่น่าสนใจอะไรเลย”
ในการสนทนาที่กินเวลาเกือบหนึ่งชั่วโมง ทานาบุมิ ทาคาฮาชิได้พูดถึงหัวข้อต่างๆ ตั้งแต่ AlexNet ในสมัยที่เขาเรียนที่ CMU ไปจนถึง AI สำหรับเกมโกะ จาก “พื้นที่การเคลื่อนไหว” (action space) ไปจนถึงการอนุมานในพื้นที่แฝง (latent space) และสุดท้ายก็มาพูดถึงการปรับปรุงตัวเองแบบเรียกซ้ำ (recursive self-improvement) สถาปัตยกรรมใหม่ และการเปิดแหล่งโค้ด (open source) นี่คือสรุปของการสนทนาครั้งนั้น
การโต้เถียงใน Smith Hall: AlexNet นั้นเป็นเพียงอุบัติเหตุหรือไม่?
เทนโกะ ดานาบา มาถึงสหรัฐอเมริกาในปี 2008 และเริ่มศึกษาระดับปริญญาเอกที่สถาบันวิจัยหุ่นยนต์แห่งมหาวิทยาลัยคาร์เนกีเมลอน ในขณะนั้น การเรียนรู้ของเครื่อง (machine learning) ยังไม่มีความสำคัญเท่าที่มีในปัจจุบัน “หลายคนไม่คิดว่าการเรียนรู้ของเครื่องเป็นเส้นทางที่น่าเชื่อถือ พวกเขาบอกว่ามันไม่ค่อยได้ผล เพราะมันมักจะเกิดปัญหาการปรับตัวเกินความเหมาะสม (overfitting) และยังไม่เข้าใจว่ามีอะไรเกิดขึ้นภายในกระบวนการนั้น”
หัวข้อวิทยานิพนธ์ปริญญาเอกของเขาเกี่ยวข้องกับด้านวิทยาการภาพคอมพิวเตอร์ปัญหาการออปติมไซซ์ที่ไม่เป็นโค้ง (Non-convex optimization problems)เช่น การฟื้นฟูความบิดเบี้ยวของภาพที่เกิดจากการหักเหของแสงบนผิวน้ำ เขาใช้วิธีการแบ่งชั้นเพื่อปรับปรุงประสิทธิภาพ และได้พิสูจน์ว่าแม้ปัญหานั้นจะไม่ใช่ปัญหาแบบโค้งเว้า (non-convex) ก็ตาม หากมีข้อมูลเพียงพอ ก็ยังสามารถพิสูจน์ถึงความเหมาะสมสูงสุดได้ในระดับหนึ่ง “การใช้ข้อมูลเป็นแรงขับเคลื่อนร่วมกับการปรับปรุง การผสมผสานนี้น่าสนใจมาก และฉันยังคงภูมิใจในงานนี้อยู่จนถึงทุกวันนี้”
ในปี 2012 AlexNet ได้ถือกำเนิดขึ้น ทานาบาอากิ ทานากาวะได้ส่งอีเมลถึงอเล็กซ์ คริเซฟสกี้ (Alex Krizhevsky) เพื่อขอรับโค้ดและนำไปทดลองใช้ด้วยตัวเอง เขาเร็วๆ นั้นก็ตระหนักว่าวิธีการประมวลผลแบบเลเยอร์ละชั้นของเครือข่ายคอนเวอเลชันนั้น เป็นสิ่งเดียวกันกับแนวคิดการปรับปรุงแบบมีหลายชั้นที่เขาได้เขียนไว้ในงานวิจัยของตัวเอง “มันอาจเป็นสิ่งที่ฉันกำลังแสวงหามาตลอด แค่มันอยู่ในรูปแบบที่แตกต่างกันเท่านั้น”
แต่ในขณะนั้นบรรยากาศที่ CMU ไม่ค่อยเป็นมิตรเท่าไหร่ “ทุกคนมาที่ออฟฟิศทุกวันและมีการถกเถียงกันอย่างดุเดือดใน Smith Hall ว่าผลลัพธ์ของ AlexNet เป็นเพียงความบังเอิญหรือเป็นการพัฒนาที่แท้จริง คนส่วนใหญ่บอกว่ามันเป็นเพียงความบังเอิญ เพราะมันไม่สมเหตุสมผล”
เมื่อจบการศึกษาในปี 2013 ทานาบุ ทานาบุ ได้รับข้อเสนอจากหลายองค์กรที่สนใจด้านการเรียนรู้เชิงลึก (deep learning) แต่สุดท้ายเขาเลือกที่จะเข้าร่วมทีมงานด้านระบบขับขี่อัตโนมัติของ Google ด้วยเหตุผลหลายประการ หนึ่งในนั้นคือชื่อเสียงของบริษัท และอีกเหตุผลคือการแนะนำจากเพื่อน อย่างไรก็ตาม ในช่วงหนึ่งปีครึ่งที่เขาทำงานที่นั่น เขาไม่สามารถทำงานด้านการเรียนรู้เชิงลึกได้สำเร็จ เพราะทีมงานมีลักษณะคล้ายกับบริษัทสตาร์ทอัพมากกว่า ซึ่งต้องใช้วิธีการที่เป็นระบบและแก้ปัญหาในโลกแห่งความเป็นจริง มากกว่าจะเน้นการสำรวจทางวิทยาศาสตร์ เขาจึงย้ายไปทำงานที่ FAIR และกล่าวว่านี่เป็นหนึ่งในการตัดสินใจที่ดีที่สุดที่เขาเคยทำมา
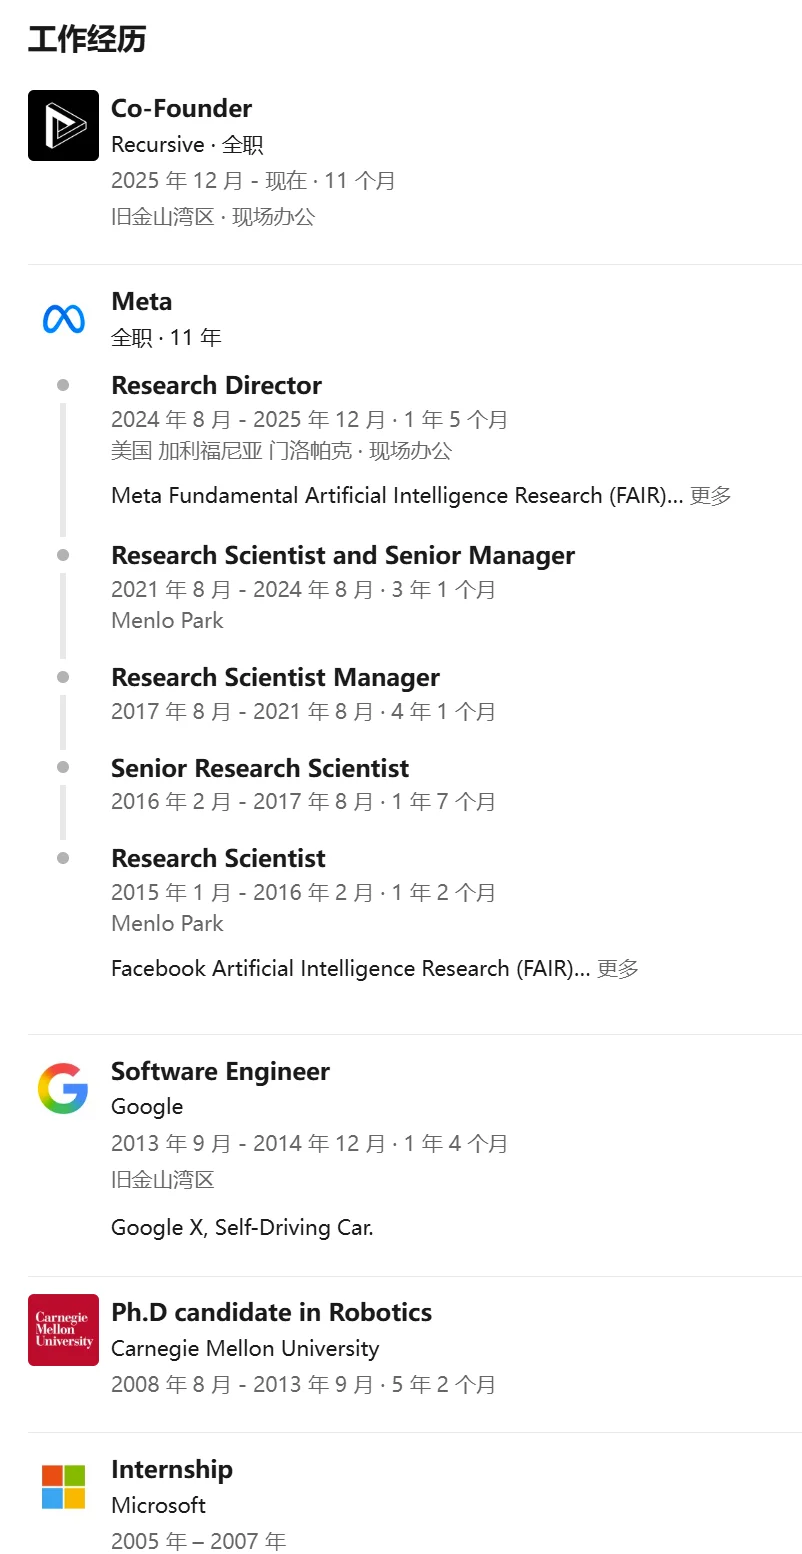
สองคน หนึ่งตัว GPU: เรื่องราวการเล่นโกะของทานาบุมิ ทาคาฮาชิ
ที่ FAIR โครงการแรกที่ทานาบาอากิ ทาคาฮาชิเริ่มต้นคือ AI สำหรับเกมโกะ ในปี 2015 ทีมของเขาได้สร้างสิ่งนั้นขึ้นมา DarkForestAlphaGo สามารถเอาชนะนักเล่นหมากรุกสมัครเล่นระดับแนวหน้าบนอินเทอร์เน็ตได้ด้วยการใช้เครือข่ายการประมวลผลแบบคอนโวลูชัน (Convolutional Networks) หลังจากนั้นไม่กี่เดือน ในฤดูใบไม้ผลิปี 2016 AlphaGo ก็สามารถเอาชนะนักเล่นหมากรุกมืออาชีพได้
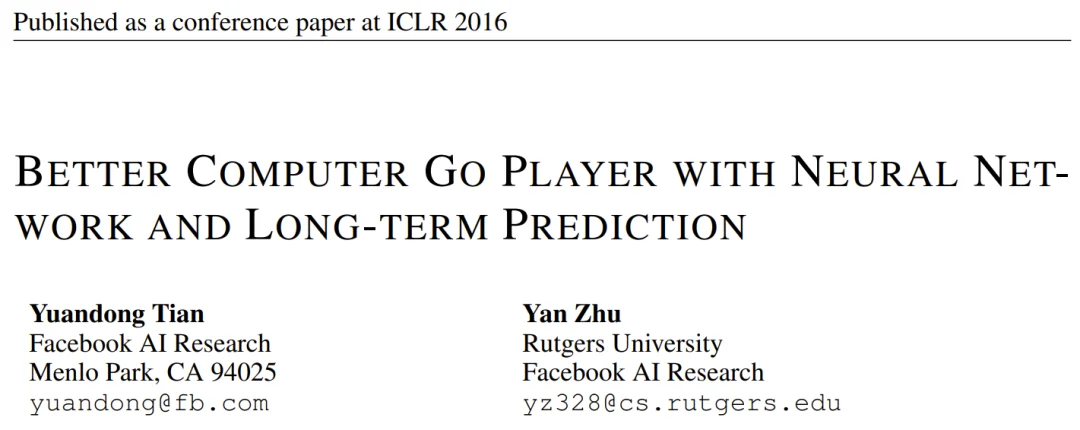
ในการเผชิญกับ “การชนกัน” แบบนี้ ทานาบุมิ ทาคาฮิโดะเชื่อว่า AlphaGo มีสองสิ่งที่เขาไม่มี:
- เครือข่ายคุณค่าในขณะนั้น DarkForest มีเพียงเครือข่ายกลยุทธ์ (strategy network) เท่านั้น;
- เขาเองก่อนหน้านี้แทบไม่มี…การเรียนรู้เชิงเสริม (Reinforcement Learning)พื้นหลังคือ “โดยพื้นฐานแล้วเรียนรู้ไปพร้อมกับการทำงาน ก็เหมือนกับการฝึกการเรียนรู้เชิงเสริม (强化学习) ให้กับตัวเอง” ประสบการณ์นี้ทำให้เขาหันมาศึกษาเรื่องการเรียนรู้เชิงเสริมอย่างกว้างขวางในภายหลัง
เมื่อถูกถามว่า AlphaGo นั้นน่าประหลาดใจหรือไม่ คำตอบของเขาน่าสนใจมาก: วิธีการเองไม่ได้น่าทึ่งอะไร เพราะเครือข่ายการประมวลผลแบบคอนเวอลูชันสามารถจับจับรูปแบบของกระดานหมากรุกที่มนุษย์ใช้ในการเล่นหมากรุกได้“สิ่งที่น่าประหลาดใจจริงๆ ก็คือ มันสามารถเอาชนะนักเล่นหมากรุกมืออาชีพได้”
ในปี 2018 ทีมได้ทำการซ้ำสร้าง AlphaZero ซึ่งเป็นระบบที่ไม่ต้องพึ่งพาข้อมูลเกมจากมนุษย์เลย และสามารถเล่นเกมได้ด้วยตัวเองจากศูนย์ โดยทำการปรับปรุงประสิทธิภาพบางอย่าง และได้รับผลลัพธ์ที่ดีขึ้น OpenGoAI นี้ในการแข่งขันอย่างเป็นทางการกับสถาบันหมากรุกของเกาหลี ใช้เพียง GPU ที่มีชื่อว่า V100 เท่านั้น แต่ก็ทำให้นักหมากรุกมืออาชีพทั้งสี่คนไม่สามารถชนะได้เลย “ฉันคิดว่านั่นน่าจะเป็นเพราะ...”ครั้งแรกที่มีใครสามารถเอาชนะนักเล่นชั้นมืออาชีพด้วย GPU เพียงตัวเดียว。」
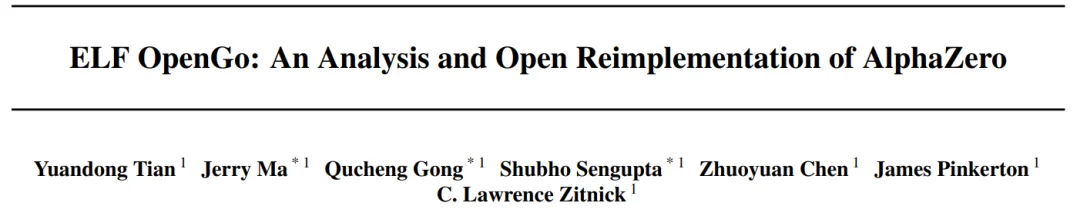
ก่อนการแข่งขันยังมีเหตุการณ์เล็กๆ น้อยๆ เกิดขึ้น ทีมได้ขอให้เพื่อนๆ นักชิกเกิร์ตทั้งมืออาชีพและมือสมัครเล่นมาประเมินความสามารถของ OpenGo ผลปรากฏว่า ในช่วงต้นเกมพวกเขายังพอเข้าใจได้ แต่หลังจากนั้นก็เข้าใจไม่ได้เลย และพวกเขาก็แค่บอกว่า “ดูแข็งแกร่งมาก แต่ฉันก็ไม่แน่ใจว่าจริงๆ แล้วแข็งแกร่งหรือเปล่า” ดังนั้น ทานาบาอากิ ทานากาวะ จึงตัดสินใจว่า จะลองเล่นกับนักชิกเกิร์ตมืออาชีพจริงๆ ดูสักครั้ง
Action space is more important than the algorithm.
เมื่อพูดถึงการเรียนรู้เชิงเสริม (Reinforcement Learning) ในยุคนั้น ทานาบุมิ ทาคาฮาชิ (Tanabumi Takahashi) เชื่อว่ามีหลายวิธีที่ยังคงถูกประเมินค่าต่ำอยู่จนถึงทุกวันนี้ตัวอย่างเช่นการเรียนรู้ด้วยการเสริมแรงแบบกระจาย (Distributed Reinforcement Learning)ใช้การกระจายของรางวัลแทนตัวแปรเดียวเพื่อปรับแต่งโมเดล; หรืออีกตัวอย่างหนึ่งคือ วิธีการสร้างแบบจำลองที่แตกต่างกัน เช่น Q-learning「แต่ตอนนี้เราส่วนใหญ่แล้วใช้เทคนิคของ ‘Strategic Gradient’ กัน ซึ่งเป็นยุคที่แตกต่างออกไปมาก」
เขาก็มองโลกในแง่บวกเช่นกันวิธีการปรับแต่งโดยไม่มีการหาค่าเกรเดียนต์และยังเชื่อว่าโมเดลขนาดใหญ่ได้มอบโอกาสใหม่ๆ ให้กับพวกมัน: “โมเดลขนาดใหญ่ในปัจจุบันมีความเข้าใจระดับสูงที่ดีขึ้นเกี่ยวกับระบบและฟังก์ชันเป้าหมายที่ต้องการปรับปรุง ซึ่งความเข้าใจระดับสูงนี้มีประโยชน์มากกว่าข้อมูลเกรดที่เฉพาะเจาะจง” ในสถานการณ์ที่เกรดมีการเปลี่ยนแปลงอย่างรุนแรงและโซลูชันที่ดีที่สุดในระดับท้องถิ่นสามารถพบได้ทุกหนทุกแห่ง เกรดอาจนำผู้คนไปสู่ทางตัน ในขณะที่วิธีการที่ไม่ใช้เกรดมีคุณสมบัติในการสำรวจโดยธรรมชาติ “ซึ่งเป็นสิ่งที่วิธีการที่ใช้เกรดไม่เคยทำได้”
ราวปี 2018 และ 2019 ทานาบาอากิ ทานาคาวะ เริ่มทดลองนำเทคนิคการเรียนรู้เสริม (Reinforcement Learning) ไปประยุกต์ใช้กับปัญหาในโลกแห่งความเป็นจริง และผลลัพธ์ที่ได้นั้นค่อนข้างน่าประหลาดใจ:สิ่งที่สำคัญจริงๆ ไม่ใช่อัลกอริทึม แต่เป็นการออกแบบของพื้นที่การดำเนินการ (action space) และพื้นที่สถานะ (state space)」
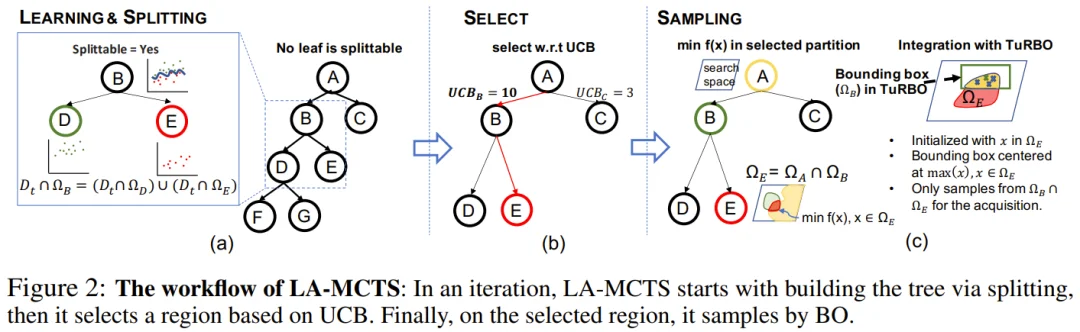
เขายกตัวอย่างการค้นหาโครงสร้างประสาท (neural architecture search) ขึ้นมา มนุษย์รู้ดีว่าความลึกของเครือข่ายมีความสำคัญมาก แต่ AI ไม่รู้เรื่องนั้น หาก AI เริ่มต้นด้วยการค้นหารายละเอียดเล็กๆ น้อยๆ เช่น ขนาดของเครื่องมือคอนโวลูชัน (convolutional kernel) ในชั้นแรก ผลลัพธ์จากทุกการแบ่งสาขา (branch) จะคล้ายคลึงกัน ฟังก์ชันค่า (value function) จะไม่สามารถให้สัญญาณที่มีประโยชน์ได้ และ AI จะต้องค้นหาต่อไปทีละชั้น ทำให้พื้นที่การค้นหาเพิ่มขึ้นอย่างรวดเร็ว (exponentially) “ในกรณีนี้ ไม่ว่าคุณจะใช้อัลกอริทึมอะไรก็ไม่มีประโยชน์เลย” ในทางกลับกัน หากสามารถจัดระเบียบพื้นที่การดำเนินการ (action space) ใหม่ เพื่อให้ AI “ตระหนัก” ถึงความสำคัญของความลึกก่อน จะเกิดความแตกต่างที่ชัดเจนระหว่างเครือข่ายที่มีความลึกมากกับเครือข่ายที่มีความลึกน้อย และหลังจากการทดลองหลายครั้ง (rollout) ก็จะสามารถเห็นทิศทางที่ควรไปได้ ทีมงานจึงได้เสนอแนวทางนี้ขึ้นมาการค้นหาด้วยต้นไม้มอนเตคาร์โลในพื้นที่ซ่อน (LA-MCTS)แนวคิดหลักก็คือการหาพื้นที่การดำเนินการ (action space) ที่สามารถทำให้ความแตกต่างของโซนการค้นหา (search subspace) สูงที่สุดได้โดยอัตโนมัติ
Coconut:“当我思考的时候,我从来不用语言。”
ผู้ดำเนินรายการร่วมได้กล่าวถึงการมีส่วนร่วมของทานาบาอุจิ ทาคาฮาชิ Coconut บทความนี้กล่าวถึงการให้แบบจำลองทำการคิดในพื้นที่แบบต่อเนื่อง (continuous latent space) แทนที่จะเป็นพื้นที่ของโทเค็น (token space) ทานาบาอากิ ทาคาฮาชิ กล่าวว่าแนวคิดนี้มาจากการสังเกตของเขาเองว่า “เวลาฉันคิด ฉันไม่เคยใช้ภาษาเลย ฉันสามารถรู้สึกได้อย่างชัดเจนว่าส่วนอื่นของสมองคือส่วนที่ใช้ในการคิด และจากนั้นฉันต้องแปลความคิดเหล่านั้นเป็นภาษาก่อนที่จะสามารถสื่อสารกับคนอื่นได้อย่างราบรื่น”
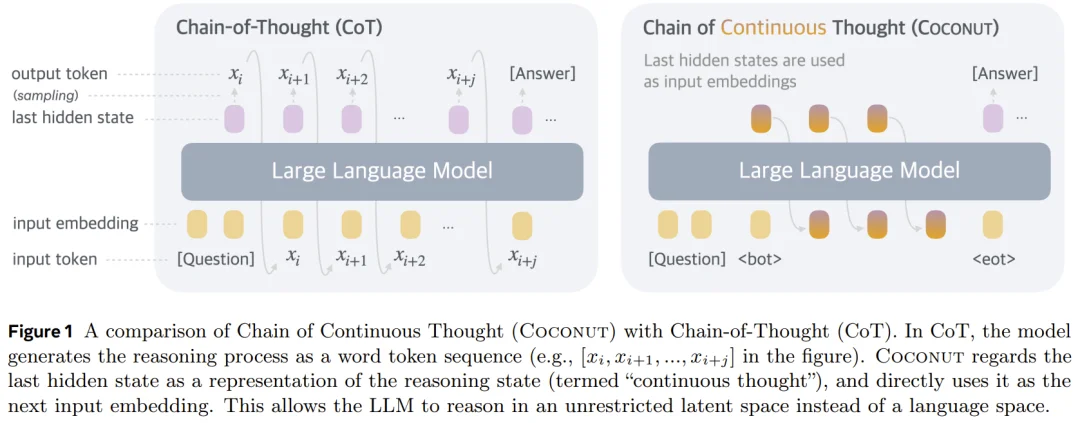
จากสัญชาตญาณนี้ ทีมได้ทำการอนุมานทางทฤษฎี และพบว่าการแสดงผลที่เป็นไปได้นั้นอาจเป็นสถานะทับซ้อนของความคิดต่างๆ การใช้มันในการอนุมานอาจให้ข้อได้เปรียบอย่างมากในปัญหาต่างๆ เช่น การเดินทางในกราฟ “อาจไม่ใช่ในระดับทวีคูณ แต่อย่างน้อยก็มีข้อได้เปรียบบางอย่าง”
ทำไมแบบจำลองล่าสุดจึงยังไม่ได้ใช้ห่วงโซ่ความคิดแบบต่อเนื่องกันนะ? ทานาบาอุจิ มิตสึฮิโดะได้ให้เหตุผลสองประการ
- ข้อมูลกระบวนการคิดของมนุษย์จำนวนมากถูกบันทึกไว้ในรูปแบบของภาษา ในขณะที่พื้นที่แห่งความคิดที่ซ่อนเร้น (潜空间) นั้นไม่มีข้อมูลประเภทนี้
- Potential representations may be highly personalized.“ทุกคนต่างก็ใช้การแสดงออกที่ซ่อนอยู่ในตัวเองในระดับหนึ่ง” แต่ประสิทธิภาพการเรียนรู้ของโมเดลขนาดใหญ่นั้นต่ำกว่ามนุษย์มาก ดังนั้นจึงต้องใช้ภาษาเป็นทางเลือกชั่วคราวก่อน
Ravid Shwartz-Ziv ถามต่อว่า ปัญหานี้คล้ายกับปัญหาการปรับแต่ง (regularization) ที่วิธีการเรียนรู้แบบ self-supervised เช่น JEPA ต้องเผชิญหรือไม่ ทานาบาอุจิ มิตสึฮิโดะ (Tanabuchi Mitsuhido) กล่าวเห็นด้วย และยังขยายความถามให้ลึกซึ้งยิ่งขึ้นว่า การลดความลาดชัน (gradient descent) เองอาจตกอยู่ในสถานะของ “ความเหมาะสมที่เป็นท้องถิ่นในระดับมาตรฐาน” (meta-level local optimum) ซึ่งบางรูปแบบการแสดงข้อมูลที่ดีมากอาจไม่สามารถเรียนรู้ได้ด้วยแบบจำลองการฝึกปัจจุบันเลย “ตอนนี้เรายังไม่รู้ด้วยซ้ำว่าขอบเขตของปัญหาอยู่ที่ไหน”
ในมุมมองของเขา นี่แหละคือสิ่งที่การศึกษาเรื่องความเข้าใจได้ความหมายของมันก็เหมือนกับความแตกต่างระหว่างเวทมนตร์ดำและเคมีนั่นแหละ แต่ตอนนี้แบบจำลองต่าง ๆ มีประสิทธิภาพมากเกินไป ทุกคนต่างก็มุ่งเน้นไปที่ผลลัพธ์เป็นหลัก และยังไม่มีคนหรือเวลามากพอที่จะลงทุนในทิศทางนี้
หลังจากที่เขียนบทความวิจัยชิ้นสุดท้ายร่วมกับ GPT-5
เมื่อพูดถึงการเปลี่ยนแปลงในยุคของโมเดลขนาดใหญ่ ทานาบุ โทมิโอะเชื่อว่าการวิเคราะห์พลวัตการฝึกของเครือข่ายประสาทที่เขาได้ทำมาอย่างต่อเนื่องตั้งแต่ปี 2018 นั้น สามารถนำมาประยุกต์ใช้กับโมเดลขนาดใหญ่ได้เช่นกัน และไม่มีการหยุดชะงักใดๆ ผลกระทบที่แท้จริงอยู่ที่ระดับการพิสูจน์เชิงประจักษ์: นักวิจัยยังคงต้องตั้งสมมติฐาน ทำการทดลอง และได้ข้อสรุปด้วยตนเอง ซึ่งกระบวนการนี้ไม่แตกต่างอย่างมีนัยสำคัญจากเมื่อหนึ่งหรือสองร้อยปีก่อนเมื่อแบบจำลองมีความสามารถมากขึ้นเรื่อยๆ เราก็จะสามารถสร้างความคิดหรือแนวทางการทำงานขึ้นมาได้ด้วยตัวเอง“นักวิจัยอาจจะถูกบังคับให้ต้องคิดในระดับมาโทรลอจิก (meta-level) แทนที่จะใช้เวลาไปกับการเสนอสมมติฐานที่เฉพาะเจาะจงแต่ละข้อ”
ในขณะเดียวกัน,สถานะของความสามารถด้านวิศวกรรมได้รับการยกระดับอย่างมากในยุคของโมเดลขนาดใหญ่ งานที่ดีๆ มากมายนั้น “ครึ่งหนึ่งเป็นการวิจัย และอีกครึ่งหนึ่งเป็นการออกแบบ/การพัฒนาเทคโนโลยี” แต่เมื่อ AI ที่สามารถเขียนโปรแกรมได้ปรากฏขึ้น สถานการณ์ก็เปลี่ยนไปอีกครั้ง: นักวิจัยที่มีประสบการณ์สามารถช่วยให้ AI นำแนวคิดต่างๆ ไปใช้ได้อย่างรวดเร็ว ระบุปัญหาสำคัญได้ และ “พวกเขาก็มีพลังพิเศษขึ้นมาทันที สามารถสำรวจสิ่งที่ลึกซึ้งจริงๆ ได้”
จุดเปลี่ยนแปลงคืองานวิจัยชิ้นสุดท้ายของเขาใน Meta ซึ่งเขาเป็นผู้เขียนคนเดียว งานวิจัยนี้เกี่ยวกับเครือข่ายประสาท grokking ปรากฏการณ์ที่ว่าเครือข่ายเรียนรู้จากการท่องจำอย่างตายตัวในตอนแรก แล้วจู่ ๆ ก็สามารถเรียนรู้ที่จะประยุกต์ใช้ความรู้นั้นได้อย่างกว้างขวาง (เรียนรู้การเป็นนามธรรม) ในช่วงเวลาหนึ่ง
ตลอดกระบวนการนี้,เขามอง GPT-5 เป็นผู้ร่วมงานถามมันคำถาม มอบ "การบ้าน" ให้มัน ให้มันพิสูจน์ทฤษฎีบท ตรวจสอบว่าทฤษฎีบทนั้นถูกต้องหรือไม่ และร่วมกันคิดหาวิธีแก้ปัญหา
ผลลัพธ์คือประสิทธิภาพเพิ่มขึ้นประมาณ 6 ถึง 10 เท่า“และนี่ยังเป็นเพียงการประมาณการที่ระมัดระวังเท่านั้น เพราะในตอนนั้นฉันยังคงเขียนโค้ดด้วยตัวเอง” ปัจจุบันนี้ เราสามารถมอบหมายให้ AI ที่มีประสิทธิภาพสูงทำหน้าที่เขียนโค้ดและดำเนินการต่างๆ ได้ และความเร็วก็จะยิ่งเพิ่มขึ้นไปอีก
ดังนั้นจึงเกิดประโยคที่กล่าวมาในตอนต้น ทานาบุมิ ทาคาฮาชิ ยอมรับว่านักวิจัยมักไม่ต้องการไปเป็นผู้ร่วมก่อตั้งบริษัทขนาดเล็ก เพราะต้องดูแลเรื่องอื่นๆ มากมายนอกเหนือจากการวิจัย “แต่ฉันคิดว่าตอนนี้เป็นช่วงเวลาแห่งการเปลี่ยนแปลง ถ้าฉันไม่ทำอะไรเลย ในอนาคตมันอาจจะไม่สำคัญอีกต่อไป”
ผู้ดำเนินรายการร่วมตอบกลับอย่างขำๆ ว่าวิธีที่เธอใช้คือการเรียนรู้ที่จะทำงานด้วยตัวเอง แต่น่าเสียดายที่ “ฉันไม่ค่อยเก่งเรื่องการทำงานด้วยมือเท่าไหร่”
AI ยังคิดไม่ออกวิธีที่ดีกว่านี้
อย่างไรก็ตาม ทานาบุมิ ทาคาฮาชิไม่คิดว่ามนุษย์สามารถถอนตัวออกไปได้แล้วฉันไม่คิดว่าแบบจำลองในปัจจุบันจะสามารถให้ผลลัพธ์ที่ดีได้โดยไม่มีการแทรกแซงจากมนุษย์เลยแม้แต่งานวิจัยที่เขียนร่วมกับ GPT-5 แนวคิดหลักก็มาจากเขาเอง ไม่ใช่ให้แบบจำลองคิดเอง
มนุษย์ยังคงต้องรับผิดชอบในสิ่งต่อไปนี้:
- เริ่มต้น,ตัดสินใจว่าปัญหาใดควรได้รับการแก้ไข
- การยืนยันวิเคราะห์ว่าแผนที่ AI นำเสนอมานั้นน่าเชื่อถือหรือไม่
Ravid Shwartz-Ziv ได้กล่าวว่า ในช่วงเวลาที่ผ่านมา มีงานมากมายที่ให้ AI ทำการปรับแต่งโมเดลหลังการฝึก (post-training) และแข่งขันบน Kaggle ซึ่งปรากฏปัญหาว่าแนวคิดที่ใช้นั้นมีขอบเขตจำกัด และมีแนวโน้มที่จะเกิดการปรับแต่งโมเดลให้เหมาะสมกับตัวชี้วัด (overfitting) มากเกินไป ทานาบุ ทาคาฮาชิ มองว่าปัญหานี้เป็นเรื่องชั่วคราวในระดับหนึ่ง เนื่องจากโมเดลถูกกำหนดให้ต้องจัดการกับรายละเอียดเล็กๆ น้อยๆ โดยขาดบริบทที่เหมาะสม แต่ถ้าเราให้ข้อมูลเพิ่มเติมแก่มัน มันอาจจะสามารถสร้างแนวคิดที่น่าสนใจได้มากกว่าการปรับแต่งพารามิเตอร์ต่างๆ
แต่เขาก็ยอมรับว่าการเติมเนื้อหาเพิ่มเติมเข้าไปเป็นเพียงการ “ซ่อมแซมชั่วคราว” เท่านั้น โมเดลในปัจจุบันมีความสามารถในการทำงานที่ซ้ำๆ เนื่องจากข้อมูลบนอินเทอร์เน็ตเต็มไปด้วยเนื้อหาประเภทนี้;ถ้าต้องการให้แบบจำลองสามารถทำงานได้อย่างอิสระจากข้อจำกัดที่มีอยู่ ก็จำเป็นต้องมีโครงสร้างใหม่“เพื่อให้สามารถจับสัญญาณใหม่ๆ ได้อย่างรวดเร็วด้วยข้อมูลที่น้อยที่สุด เราจำเป็นต้องมีการเปลี่ยนแปลงครั้งใหญ่จากการทำงานที่ซ้ำซากตามปกติไปสู่ระดับถัดไป”
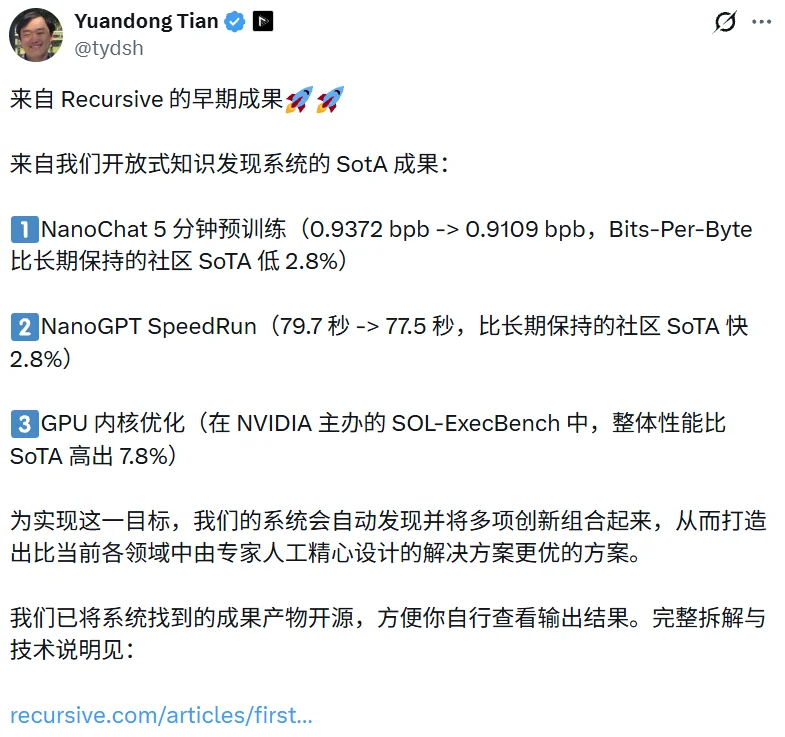
ในวัฏจักรการวิจัยที่ประกอบด้วย “การเสนอความคิด การเขียนโค้ด การทดลอง และการวิเคราะห์ผลลัพธ์” เขาเชื่อว่าสิ่งที่ยากที่สุดในการทำให้เป็นระบบอัตโนมัติคือ “ความคิด”เมื่อถูกถามถึงผลการแข่งขันของ Recursive ใน NanoGPT Speedrun ซึ่งสามารถลดเวลาการฝึกจาก 79.7 วินาทีเหลือ 77.5 วินาที ว่านั่นเป็นการค้นพบที่แท้จริง หรือเพียงแค่การค้นหาเทคนิคที่มีอยู่อย่างมีประสิทธิภาพ คำตอบของทานาบาซาวะ ทาคาชิกะคือ “ทั้งสองอย่าง” ตัวอย่างเช่น การเพิ่มข้อมูล bigram เข้าไปในระบบการให้ความสนใจ (attention) นั้นสามารถพบแนวคิดที่คล้ายคลึงกันในงานวิจัยของ DeepSeek, Gemma 3 และในบทความ STEM ที่เขาเข้าร่วมทำที่ Meta แต่การใช้ตารางการเข้ารหัส (embedding tables) ที่แตกต่างกันในแต่ละชั้น และการรวมความคิดเหล่านั้นเข้าด้วยกันนั้น ก็เป็นการสร้างสรรค์ใหม่ๆ ด้วยเช่นกัน
ทำไมโครงสร้างใหม่ๆ ถึงมักจะ “ล้มเหลว” เมื่อถูกนำไปใช้ในระดับขนาดใหญ่?
มีหลายบริษัทที่เสนอโครงสร้างทดแทนของ Transformer ซึ่งแสดงผลได้อย่างน่าประทับใจในการทดลองขนาดเล็ก แต่ก็ยังไม่สามารถขยายไปใช้กับโมเดลขนาดใหญ่ได้ คำอธิบายของทานาบุ ทาคาฮาชิคาวะ (Tanae Takahashikaawa) คือการสรุปอคติ (Inductive Bias)เมื่อข้อมูลมีปริมาณน้อย จำเป็นต้องนำสมมติฐานเชิงโครงสร้างเพิ่มเติมเข้ามา ซึ่งจะทำให้ผลลัพธ์ดีขึ้น แต่เมื่อข้อมูลมีปริมาณมากขึ้น วิธีที่ดีที่สุดคือปล่อยให้โมเดลหากฎเกณฑ์ด้วยตัวมันเอง เขายกตัวอย่างของ ViT ว่า บนข้อมูลขนาด ImageNet ViT อาจไม่ดีเท่ากับเครือข่ายการเรียกโครงสร้าง (convolutional networks) แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นถึงระดับหลายร้อยล้านชุด Transformer กลับมีประสิทธิภาพดีกว่า
แล้ว เราจะตรวจสอบความถูกต้องของโครงสร้างใหม่นี้อย่างไร?
ทานาบุมิ ทาคาชิกะคิดว่าแน่นอนเริ่มต้นจากขนาดเล็กก่อนแต่สิ่งสำคัญคือการเข้าใจว่าเกิดอะไรขึ้นภายในเครือข่ายจริงๆ “เราต้องการรู้ว่ามีข้อค้นพบบางอย่างที่สามารถนำไปประยุกต์ใช้ในขนาดที่ใหญ่กว่าได้ เพื่อที่เราจะมีความมั่นใจ” มิฉะนั้น หากเราเพียงแค่ทำตามกฎของการขยายขนาด (scaling law) อย่างไม่มีเหตุผล เราก็จะไม่มีวันสามารถพิสูจน์ได้ว่าสิ่งที่ได้ผลในขนาดเล็กจะได้ผลในขนาดใหญ่เช่นกัน “ผลลัพธ์เดียวที่จะเกิดขึ้นก็คือ บริษัทที่มีพลังการประมวลผลมากที่สุดจะชนะ”
เป้าหมายระยะยาวที่สุดในใจของเขาคือหาวิธีการเรียนรู้ที่มีประสิทธิภาพเทียบเท่ากับมนุษย์มนุษย์สามารถเข้าใจสิ่งต่างๆ ได้ในเวลาอันรวดเร็ว โดยใช้พลังงานเพียง 20-30 วัตต์และข้อมูลเล็กน้อย ในขณะที่วงการหุ่นยนต์ในปัจจุบันเน้นความจำเป็นในการใช้ข้อมูลปริมาณมหาศาล ซึ่งในมุมมองของเขานั้นเป็นเพียงข้อกำหนดของกรอบความคิดปัจจุบันเท่านั้น “ลองดูสัตว์เช่นแมวหรือสุนัข พวกมันไม่จำเป็นต้องใช้ข้อมูลมากมายเลย และพวกมันก็ใช้โปรเซสเซอร์ที่ไม่ซับซ้อน แต่ก็สามารถดำรงชีวิตอยู่ในโลกที่ซับซ้อนได้ ซึ่งแสดงให้เห็นว่าต้องมีอัลกอริทึมใหม่ๆ อยู่แน่นอน”การเรียนรู้เชิงเสริมและการปรับปรุงตนเอง อาจเป็นเส้นทางที่รวดเร็วที่สุดสู่จุดนั้น
การจำกัดการพัฒนาตนเอง? “ขอบเขตมันคลุมเครือเกินไป”
ในตอนท้ายของรายการ พิธีกรได้ถามถึงประเด็นที่กำลังเป็นที่สนใจในด้านความปลอดภัยของ AI ในปัจจุบัน นั่นคือ มีคนเรียกร้องให้มีการจำกัดการใช้งานโมเดล AI รุ่นใหม่ๆ และมีการประสานงานระหว่างอุตสาหกรรมเกี่ยวกับกระบวนการปรับปรุงตัวเองแบบเรียกซ้ำ (recursive self-improvement)
คำตอบของทานาบุอากิ โทะมิกาวะชัดเจนมาก: “พูดตามตรงนะ ฉันคิดว่ามันยากมากที่จะหยุดผู้คนไม่ให้ทำแบบนั้น” ในมุมมองของเขา ขอบเขตนั้นค่อนข้างคลุมเครือ: การที่คุณพูดคุยกับอัจฉริยะการเขียนโปรแกรมเกี่ยวกับแนวคิดใหม่ๆ และให้มันปรับปรุงตัว ก็ถือเป็นการพัฒนาตัวเองในระดับหนึ่ง; การที่คุณร่วมงานกับคนอื่นเพื่อเขียนบทความก็เป็นการพัฒนาตัวเองเช่นกัน แล้วการใช้โมเดลโอเพนซอร์สที่มีประสิทธิภาพสูงขึ้นในการวิจัย นั่นถือเป็นการพัฒนาตัวเองหรือไม่? แล้วเราควรควบคุมสิ่งนี้อย่างไร?
เขาได้แสดงความเห็นอย่างชัดเจนว่า“Recursive” จะเปิดแหล่งข้อมูลการวิจัยที่ได้รับการพัฒนาให้สาธารณะก่อนหน้านี้ บทความบล็อกของบริษัทได้เปิดเผยโค้ดซอร์สของเคอร์เนลและแผนการฝึกอบรมทั้งหมด ทำให้ผู้คนสามารถตรวจสอบและพัฒนาต่อไปได้ แต่เขากังวลถึงสถานการณ์อีกแบบหนึ่งว่า “สถานการณ์ที่เลวร้ายที่สุดคือ กลุ่มคนเล็กๆ ที่มีความเชี่ยวชาญควบคุมโมเดลที่ทรงพลังที่สุดในโลก แล้วให้คนอื่นๆ ต้องจ่ายค่าธรรมเนียมสูงเพื่อใช้งานมัน”
เขาค่อนข้างมองโลกในแง่ดีเกี่ยวกับความสามารถของโมเดลโอเพนซอร์สในการเทียบเท่ากับโมเดลที่มีลิขสิทธิ์เขายกตัวอย่าง Kimi มาอธิบาย โดยคิดว่ามันใช้งานได้ดีอยู่แล้ว แค่กระบวนการคิดอาจจะใช้เวลานานสักหน่อย ในมุมมองของเขา อัจฉริยะในการเขียนโปรแกรมไม่จำเป็นต้องมี “AI Newton” หรือ “AI Einstein” มาช่วยเขียนโค้ดให้คุณ แค่แบบจำลองสามารถทำงานได้ดีกว่าระดับที่กำหนดก็เพียงพอแล้ว
ห้องปฏิบัติการชั้นนำได้ก้าวข้ามขอบเขตไปแล้ว และโมเดลที่เปิดแหล่งโค้ด (open-source models) ก็กำลังจะก้าวข้ามขอบเขตเช่นกัน “เมื่อก้าวข้ามไปแล้ว มันจะถูกนำไปใช้ในเชิงพาณิชย์ และทุกคนก็จะใช้โมเดลที่ตัวเองชอบ”
ตั้งแต่การถกเถียงใน Smith Hall เกี่ยวกับว่า AlexNet เป็นเพียง “โชคดี” หรือไม่ ก็ผ่านไปแล้วสิบสี่ปี ปัจจุบัน การเรียนรู้ด้วยเทคโนโลยีปัญญาประดิษฐ์ (Deep Learning) ที่เคยถูกตั้งคำถามในอดีต ก็ได้เริ่มเขียนบทความวิจัย ปรับแก้โค้ด และสร้างสถิติของตัวเองแล้ว ทานาบุ ทานาบุ (Tanae Tanae) เลือกที่จะยืนอยู่ในแนวหน้าของกระแสนี้ และด้วยคำพูดของเขาเอง ปัญหาที่แท้จริงต่อไปคือ: “เราจะใช้โมเดลเหล่านี้ทำอะไรให้ดีขึ้นและใหญ่ขึ้นได้อย่างไร”
บทความนี้มาจาก "Machine Heart" โดยผู้เขียน "Panda"
有用吗?