전원 도: GPT-5와 함께 마지막 논문을 쓴 후, 저는 5년 안에 실직할 것이라는 것을 깨달았습니다.
얼마 전, OpenAI는 GitHub에 722편의 수학 논문 원고를 한 번에 공개했습니다. 이 원고들은 17개의 수학 분야에 걸쳐 있는 372개의 “결과 그룹”으로 분류되었으며, 모두 아직 공개되지 않았고 이름도 알려지지 않은 연구에서 나온 것입니다.내부 모델——그 성능은 GPT-6 Astra를 훨씬 능가합니다.
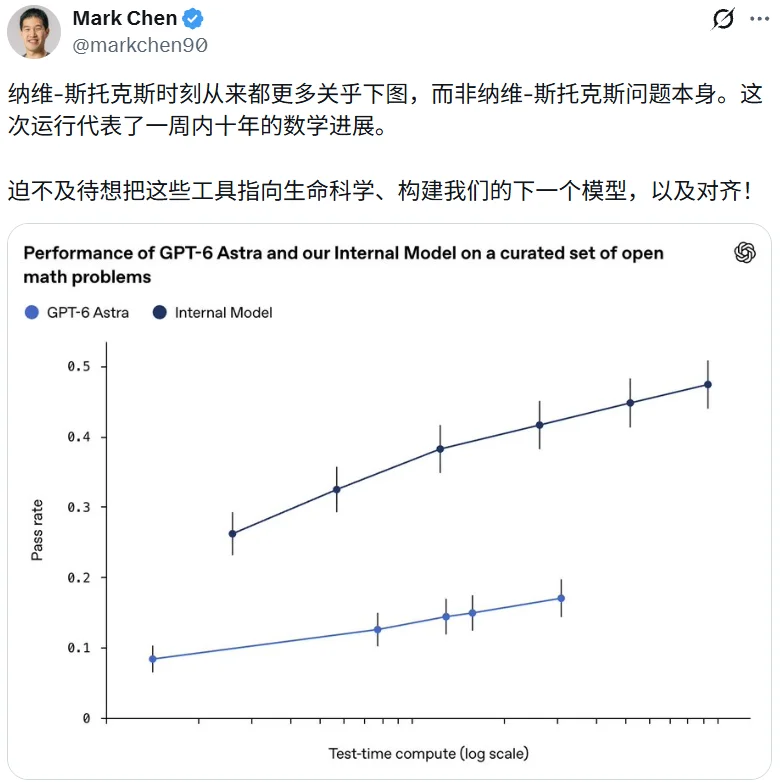
오픈AI의 수석 연구 책임자인 마크 첸(Mark Chen)의 트윗
물론, 수학계에서는 이러한 연구 결과의 질과 공개 방식에 대해 여전히 많은 논란이 있지만, 한 가지는 부인하기 어렵습니다:AI가 연구 결과를 생성하는 속도가 이제 “백 편” 단위로 측정되기 시작했습니다.。
거의 동시에, 최신 에피소드의 The Information Bottleneck 팟캐스트에서 한 딥러닝 분야의 베테랑이 연구자들의 마음을 조마하게 하는 말을 했습니다: “이 프로젝트를 마치고 꽤 흥미로운 결과를 얻은 후에, 갑자기 깨달았어요: 와,내 일은 아마도 5년 안에 대체될 것입니다.。」
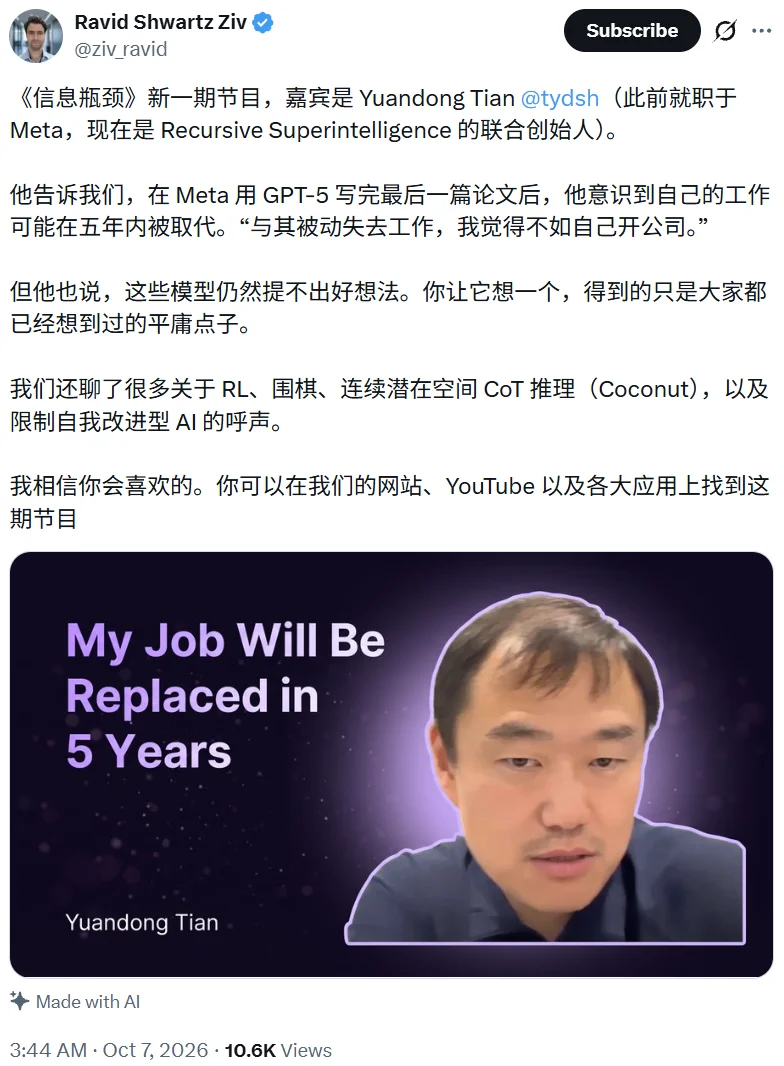
팟캐스트 주소: https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
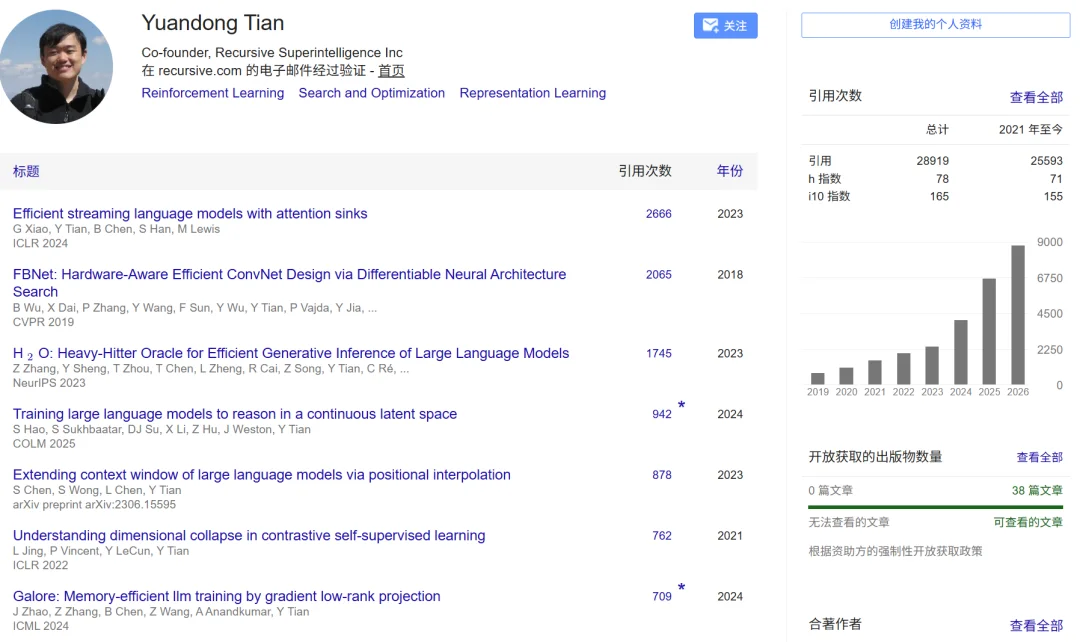
이 말을 한 사람은전원 도무그는 Meta FAIR에서 거의 10년 동안 일해왔으며, 바둑 AI, 강화 학습, 신경망의 해석 가능성에 대한 연구를 해왔습니다. 또한 Coconut(연속적인 잠재 공간 사고 체인) 논문의 공동 저자 중 한 명이기도 합니다.
요즘, 그의 신분은 Recursive Superintelligence 이 회사의 공동 창립자입니다. 올해 5월, 이 회사는 은밀한 상태를 벗어나 46억 5천만 달러의 가치로 6억 5천만 달러 이상의 자금을 조달했다고 발표했으며, GV와 Greycroft가 주도적으로 투자를 했고, 엔비디아와 AMD도 참여했습니다.
Ravid Shwartz-Ziv가 이번 팟캐스트를 진행하는 동안, Tanaka Mifune는 자신이 왜 창업을 결심했는지에 대해 설명했습니다:차라리 수동적으로 일자리를 잃는 대신, 그 방향으로 나아가는 회사를 스스로 차리는 것이 낫습니다.하지만 그는 프로그램에서 AI에게도 차가운 물을 끼얹었습니다. “만약 모델에게 스스로 아이디어를 내도록 한다면, 그것은 당신에게 매우 평범한 생각들만을 줄 것이고, 기본적으로 누구나 알고 있는 것들일 뿐이며, 특별히 흥미로운 방향도 아닙니다.”
거의 한 시간 동안의 대화에서, 다나오 마토시는 CMU 시절의 AlexNet 논쟁부터 바둑 AI에 이르기까지, “행동 공간”에서 잠재 공간 추론에 이르기까지, 그리고 마지막으로는 재귀적 자기 개선, 새로운 아키텍처, 오픈 소스에 대해 이야기했습니다. 다음은 이 대화의 요약입니다.
Smith Hall에서의 다툼: AlexNet이 정말 우연의 일이었을까?
"""타나부 미토시는 2008년에 미국으로 건너가 카네기 멜론 대학교의 로봇 연구소에서 박사 학위를 받았습니다. 당시에는 머신 러닝이 오늘날과 같은 중요성을 갖지 못했습니다. ""많은 사람들이 머신 러닝이 신뢰할 수 있는 방법이라고 생각하지 않았으며, 과적합 문제가 있고 그 내부에서 무슨 일이 일어나고 있는지도 잘 이해하지 못했습니다."""
그의 박사 학위 논문 주제는 컴퓨터 비전 분야였습니다.비볼록 최적화 문제예를 들어, 수면의 굴절로 인해 발생하는 이미지 왜곡을 복원하는 것입니다. 그는 계층화된 방법을 사용하여 최적화를 수행했으며, 문제가 비볼록하더라도 데이터가 충분하다면 어느 정도 최적성을 증명할 수 있다는 것을 입증했습니다. “데이터 기반의 접근 방식과 최적화의 조합은 매우 흥미롭습니다. 저는 지금도 이 일을 매우 자랑스럽게 생각합니다.”
2012년에 AlexNet이 등장했습니다. 다나오 미타노는 알렉스 크리제프스키에게 이메일을 보내서 코드를 받아 직접 살펴보았습니다. 그는 곧이어 컨볼루션 네트워크의 계층화된 처리 방식이 자신의 논문에 제시된 계층적 최적화 개념과 사실상 같다는 것을 깨달았습니다. “아마도 이것이 내가 항상 추구해온 것이었을 텐데, 단지 다른 형태로 표현된 것일 뿐이야.”
하지만 당시 CMU의 분위기는 그리 친절하지 않았습니다. “모두가 매일 사무실에 와서 Smith Hall에서 AlexNet의 결과가 우연의 일치인지 진정한 돌파구인지에 대해 열렬히 논쟁했습니다. 대부분의 사람들은 그것이 단지 우연이라고 말했는데, 그것은 이치에 맞지 않았기 때문입니다.”
2013년에 졸업했을 때, 다나오 도마가는 딥러닝 분야에서 일하고 싶어하는 여러 기업으로부터 제안을 받았지만, 결국 구글의 자율주행 팀을 선택했습니다. 한편으로는 그 기업의 명성 때문이었고, 다른 한편으로는 친구의 추천도 영향을 받았습니다. 하지만 그곳에서 보낸 1년 3개월 동안 그는 딥러닝 프로젝트를 성공적으로 완수하지 못했습니다. 왜냐하면 그 팀은 스타트업과 같았기 때문에, 실제 문제를 해결하기 위한 성숙한 솔루션을 필요로 했지, 단순한 과학적 탐구가 아니었습니다. 그래서 그는 FAIR로 이직했으며, 그곳에서의 경험을 “당시 내가 한 최고의 선택 중 하나”라고 말했습니다.
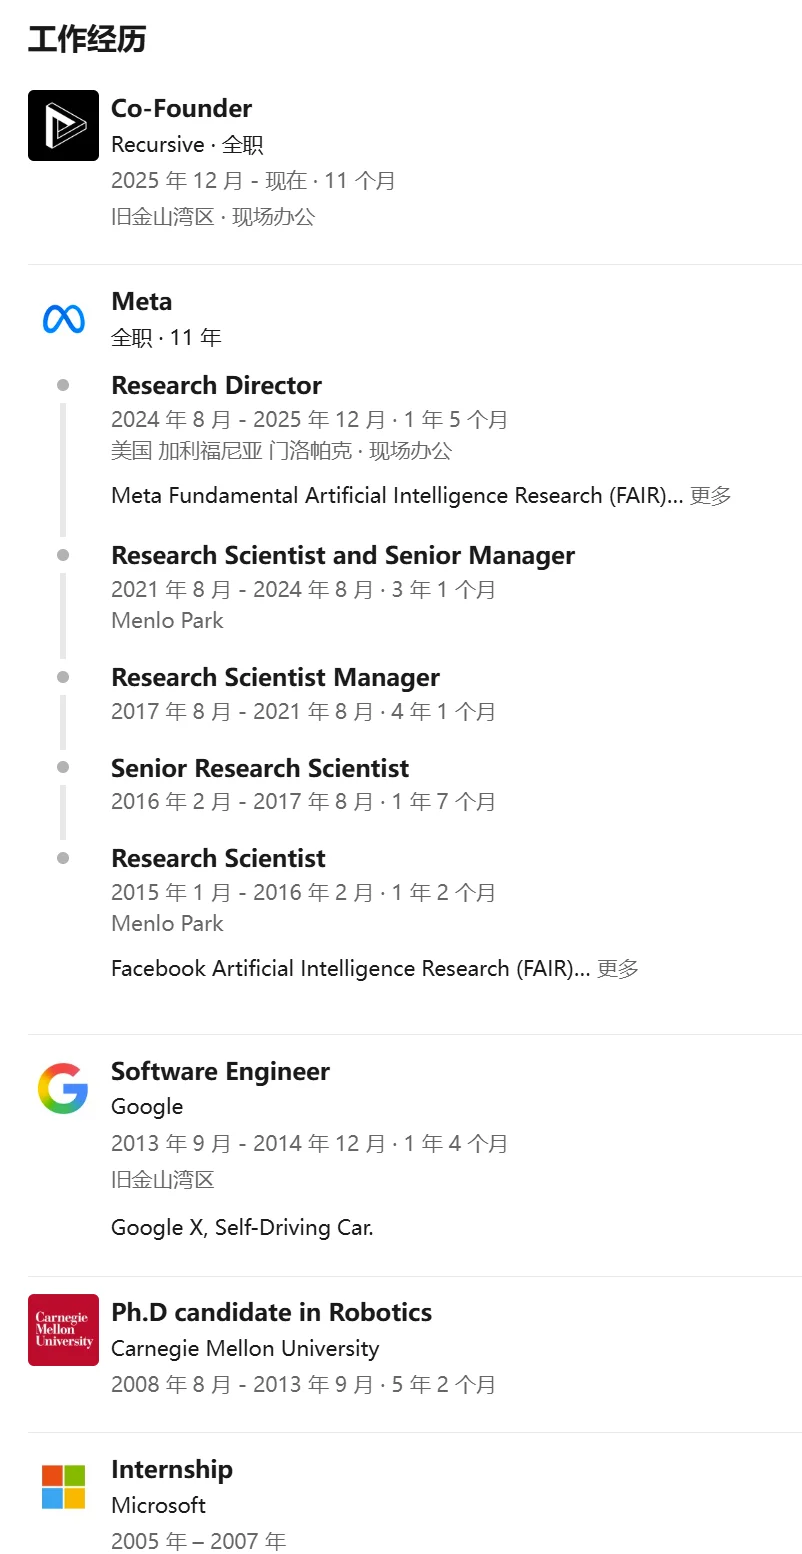
두 사람, 하나의 GPU: 다나오 도모토의 바둑 이야기
FAIR에서, 다나베 도모히로가 시작한 첫 번째 프로젝트는 바둑 AI였습니다. 2015년에 그의 팀은 DarkForest컨볼루션 네트워크를 사용하여 인터넷에서 최고의 아마추어 바둑 선수들을 이겼습니다. 몇 달 후, 2016년 봄에 AlphaGo는 프로 바둑 선수들도 이겼습니다.
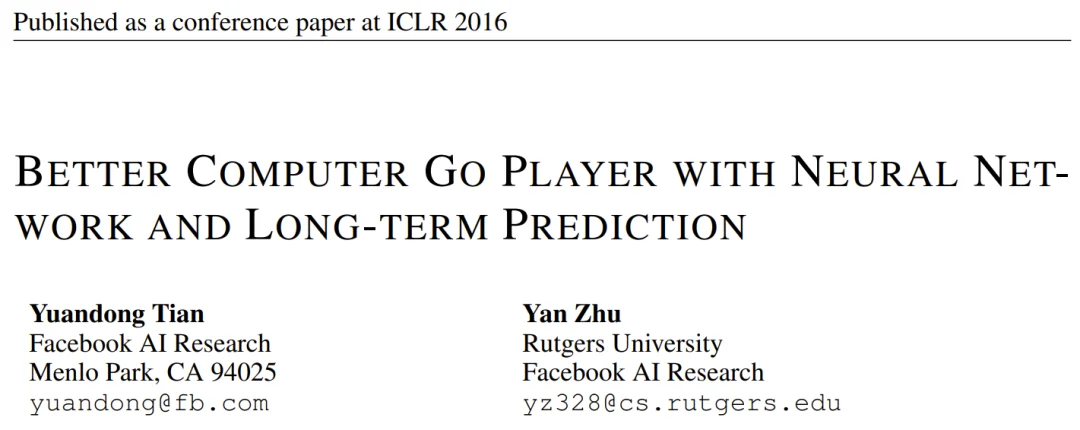
이러한「충돌」 상황에 직면하여, 다나베 도모토는 AlphaGo가 자신들이 가지고 있지 않은 두 가지 점이 있다고 생각했습니다:
- 가치 네트워크당시 DarkForest에는 전략 네트워크만 존재했습니다;
- 그는 이전에 거의 없었습니다.강화 학습배경으로, “기본적으로는 하면서 배웠어요, 마치 자신에게 강화 학습을 적용하는 것처럼요.” 이 경험 덕분에 그는 이후에 많은 강화 학습 연구로 방향을 전환하게 되었습니다.
AlphaGo가 놀랍다는 질문에 그의 대답은 매우 흥미로웠습니다: 그 방법 자체는 놀라운 것이 아니었는데, 왜냐하면컨볼루션 네트워크는 사람들이 체스를 할 때 의존하는 체스판 패턴을 포착할 수 있습니다.“정말 놀라운 것은, 그것이 프로 바둑 선수들을 이길 수 있다는 점입니다.”
2018년, 팀은 AlphaZero를 재현했습니다. AlphaZero는 인간의 체스 기보에 전혀 의존하지 않고 스스로 대결하는 알고리즘으로, 효율성을 개선한 버전을 만들었습니다. OpenGo이 AI는 한국 기원과의 공식 대국에서 단 하나의 V100 GPU만을 사용하여 네 명의 프로 기사를 모두 패배시켰습니다. “아마도 그 이유는…”처음으로 누군가가 단일 GPU를 사용하여 프로 바둑 기사를 이겼습니다.。」
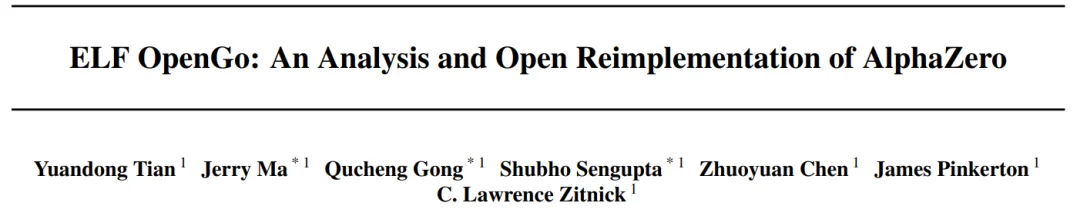
경기 전에 작은 에피소드가 있었습니다. 팀은 프로와 아마추어 체스 선수 친구들에게 OpenGo의 실력을 평가해달라고 부탁했는데, 그들은 초반은 이해할 수 있었지만 이후에는 전혀 이해할 수 없다고 말했습니다. 그들은 “보기에는 매우 강해 보이지만, 실제로 그렇게 강한지는 모르겠다”고만 했습니다. 그래서 다나오 다나베는 진짜 프로 체스 선수와 한 번 경기를 해보기로 결정했습니다.
Action space is more important than the algorithm.
그 시대의 강화 학습에 대해 이야기할 때, 다나오 미토시는아직도 과소평가되고 있는 많은 방법들이 있습니다.예를 들어분산 강화 학습모델을 조정할 때는 개별 스칼라 값이 아닌 보상 분포를 사용하세요; 예를 들어 Q-learning을 포함한 다양한 모델링 방법들「하지만 지금은 대부분의 경우 전략적 그라디언트(strategic gradient)를 사용하고 있어요. 이건 정말 다른 시대입니다。」
그도 마찬가지로 긍정적으로 보고 있습니다.그래디언트 최적화 방법이 없습니다.그리고 대형 모델들이 새로운 가능성을 제공한다고 생각합니다: “대형 모델은 이제 시스템과 최적화하려는 목표 함수에 대해 더 높은 수준의 이해를 가지고 있으며, 이러한 높은 수준의 이해는 부분적인 그래디언트 정보보다 훨씬 유용합니다.” 그래디언트의 변동이 심하고 부분적인 최적점이 어디에나 존재하는 상황에서, 그래디언트는 사람을 막다른 길로 이끌 수 있지만, 그래디언트가 없는 방법은 본질적으로 탐색을 포함하고 있습니다. “이것은 그래디언트 방법이 결코 할 수 없는 일입니다.”
2018년과 2019년경, 다나오 미토시는 강화 학습을 실제 세계의 문제에 적용해 보기 시작했으며, 그 결과는 상당히 놀라웠습니다:정말 중요한 것은 알고리즘이 아니라, 액션 공간과 상태 공간의 설계입니다.」
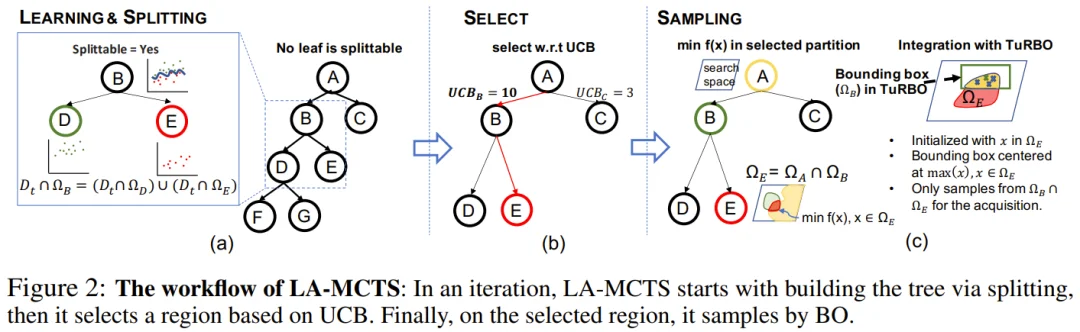
그는 신경 구조 검색을 예로 들었습니다. 인간은 네트워크의 깊이가 매우 중요하다는 것을 알고 있지만, AI는 그렇지 않습니다. 만약 AI가 처음부터 첫 번째 층의 컨볼루션 커널 크기와 같은 세부 사항을 검색한다면, 모든 분기의 성능이 비슷할 것이고, 가치 함수는 유용한 신호를 제공하지 못할 것입니다. 그래서 계층별로 점차 깊이 들어가야 하며, 검색 공간은 기하급수적으로 증가하게 됩니다. “이럴 때 어떤 알고리즘을 사용해도 소용이 없습니다.” 반대로, 행동 공간을 재조직하여 AI가 먼저 깊이의 중요성을 “인식”하게 할 수 있다면, 깊은 네트워크와 얕은 네트워크 간에 명확한 대비가 생기고, 몇 번의 반복 시도만으로도 방향을 파악할 수 있을 것입니다. 팀은 이에 기반하여잠재 공간 몬테카를로 트리 검색(LA-MCTS)핵심 아이디어는 검색 자율 공간의 구별도를 가장 높일 수 있는 동작 공간을 자동으로 찾는 것입니다.
코코넛:「저는 생각할 때 언어를 전혀 사용하지 않아요」
공동 진행자는 다나오 마토시가 참여한 것에 대해 언급했습니다. Coconut 논문에서는 모델이 토큰 공간이 아닌 연속적인 잠재 공간에서 추론하도록 합니다. 다나와 마사토는 자신의 관찰에서 이 아이디어가 비롯되었다고 말합니다: “저는 생각할 때 언어를 사용하지 않습니다. 생각할 때는 뇌의 다른 부분을 사용하고 있으며, 그 생각을 언어로 번역해야 다른 사람들과 원활하게 소통할 수 있습니다.”
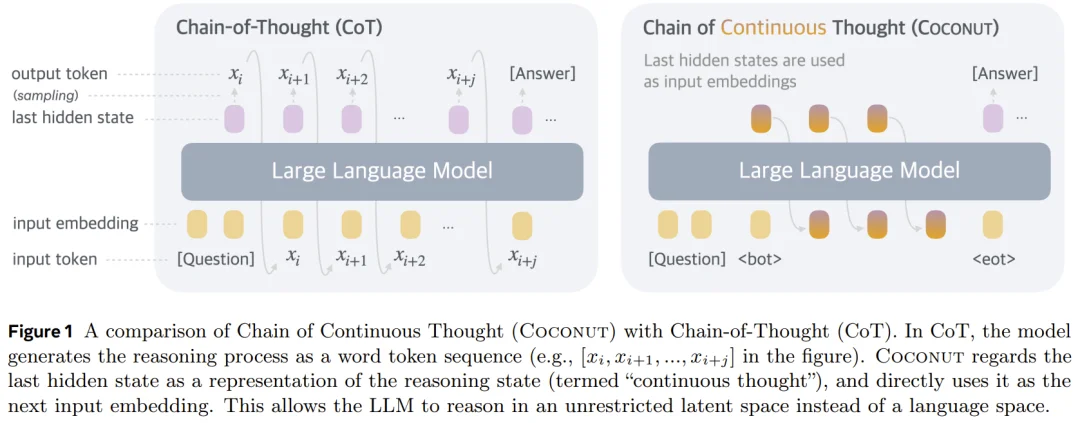
이 직관에서 출발하여 팀은 이론적 추론을 했고, 잠재적인 표현이 다양한 아이디어의 중첩 상태일 수 있다는 것을 발견했습니다. 이를 이용하면 그래프 탐색과 같은 문제에서 상당한 이점을 얻을 수 있을 것입니다. “아마도 지수적인 수준은 아니겠지만, 적어도 어느 정도의 이점은 있을 것입니다.”
그렇다면 왜 최신 모델들은 아직 연속적인 사고 과정을 채택하지 않았을까요? 다나가와 도모토는 두 가지 이유를 제시했습니다.
- 데이터인간의 많은 사고 과정이 언어의 형태로 기록되어 있지만, 잠재적 공간(potential space)에는 그러한 데이터가 없습니다.
- 잠재적인 표현은 매우 개인화될 수 있습니다.“모든 사람은 각자의 잠재적 표현 방식을 사용하고 있지만,” 대형 모델의 학습 효율은 인간에 비해 훨씬 낮아서, 일단은 언어를 대체 수단으로 사용할 수밖에 없습니다.
Ravid Shwartz-Ziv이 물었습니다. 이것이 JEPA와 같은 자가 감독 학습 방법들이 직면하는 정규화 문제와 유사한가요? Tanaka Masaaki는 동의하며 문제를 더 깊이 있게 파고들었습니다: 경사 하강 자체가 일종의 “메타 수준의 지역 최적”에 빠질 수 있으며, 현재의 훈련 패러다임으로는 학습할 수 없는 좋은 표현들이 있을 수 있다고 말했습니다. “우리는 지금 어디에 경계가 있는지 모릅니다.”
그에게 있어, 이것이 바로해석 가능성 연구"""그 의미는, 마치 연금술과 화학의 차이점과 같다""는 것입니다. 다만 현재의 모델들이 너무 강력해서 모두가 결과만을 추구하고 있으며, 이 분야에 투자할 의향이 있는 사람들과 시간이 아직 충분하지 않습니다."
GPT-5와 함께 마지막 논문을 공동으로 작성한 후
대규모 모델 시대의 전환에 대해 이야기할 때, 다나가와 토모야는 2018년부터 지속해온 신경망 훈련 동역학 분석이 대규모 모델에도 적용될 수 있으며, 방법론적으로 큰 변화가 없었다고 생각합니다. 진정한 변화는 실증적인 측면에서 나타났습니다. 과거 연구자들은 스스로 가설을 세우고 실험을 수행한 후 결론을 도출했는데, 이 과정은 100년 전이나 지금이나 본질적으로 다르지 않습니다.모델이 점점 더 강력해질수록, 스스로 아이디어를 만들어낼 수 있게 됩니다.「연구자들은 아마도 개별적인 가설을 제시하는 데 시간을 보내는 대신, 메타 수준에서 생각하도록 강요받을 것입니다」。
동시에,공학 능력의 위상이 크게 향상되었습니다.대형 모델 시대의 많은 좋은 일들은 “반은 연구이고, 반은 공학”입니다. AI 프로그래밍 에이전트가 등장하면서 상황이 다시 변했습니다: 충분한 경험을 가진 연구자들은 에이전트가 아이디어를 빠르게 구현하고 핵심 문제를 파악할 수 있게 해주었으며, “갑자기 초능력을 갖게 되어 진정으로 깊은 것들을 탐구할 수 있게 되었습니다”.
전환점은 그가 Meta에서 발표한 마지막 논문이었습니다. 그 논문은 그의 유일한 저자 작품이었으며, 신경망에 관한 연구를 다루고 있었습니다. grokking 현상, 즉 네트워크가 처음에는 암기를 통해 학습하다가 어느 순간 갑자기 일반화 능력을 갖추게 되는 것입니다.
전체 과정에서,그는 GPT-5를 협력자로 여겼습니다.질문을 하고, “과제”를 주어서 그것이 정리를 증명하게 하고, 정리가 성립하는지 확인하며, 함께 브레인스토밍을 해보세요.
결과는효율성이 약 6배에서 10배까지 향상되었습니다.“게다가 이것은 보수적인 추정치일 뿐입니다. 왜냐하면 당시에는 아직 제가 직접 코드를 작성하고 있었거든요.” 지금은 코드와 구현을 강력한 인공지능에게 맡길 수 있으며, 속도는 훨씬 더 빨라질 것입니다.
그래서 첫 문장이 나온 것입니다. 다나오 마우라는 연구자들이 보통 작은 회사에서 공동 창립자가 되기를 꺼린다고 말했습니다. 왜냐하면 연구 외에도 많은 일들을 신경 써야 하기 때문이죠. “하지만 저는 지금이 변화의 시점이라고 생각합니다. 만약 저가 아무것도 하지 않는다면, 나중에는 아무런 의미가 없을 수도 있습니다.”
공동 진행자는 반쯤 농담조로 자신의 대처 방법이 실제로 일을 하는 법을 배우는 것이었다고 말했지만, 안타깝게도 “저는 실제로 일을 하는 데는 잘하지 못해요”라고 덧붙였습니다.
AI는 아직 좋은 아이디어를 생각해내지 못하고 있어요.
하지만, 다나베 도모는 인류가 이제 물러날 수 있다고 생각하지 않습니다.저는 현재의 모델이 인간의 개입 없이도 좋은 결과를 낼 수 있다고 생각하지 않습니다."""심지어 GPT-5와 함께 작성된 그 논문조차도, 고위급의 전반적인 아이디어는 그가 제시한 것이지, 모델이 스스로 생각해낸 것이 아닙니다."
현재 인류는 여전히 다음과 같은 책임을 져야 합니다:
- """시작""어떤 문제가 해결할 가치가 있는지 결정하는 것입니다.
- """확인"""AI가 제시한 솔루션이 신뢰할 수 있는지 판단해 보세요.
Ravid Shwartz-Ziv은 최근에 에이전트가 스스로 후처리를 수행하고 Kaggle 대회에 참가하는 많은 연구들이 아이디어의 폭이 좁고 지표에 과적합되는 경향이 있다고 언급했습니다. Tanaka Masaaki는 이것이 어느 정도는 일시적인 문제라고 생각합니다. 모델은 세부 사항을 처리하도록 요구받지만 필요한 맥락이 부족하기 때문에, 더 많은 배경 정보를 제공하면 모델이 초매개변수 조정보다 더 흥미로운 아이디어를 제시할 수 있을 것이라고 합니다.
하지만 그는 상황을 보완하는 것이 단지 “임시적인 수리”에 불과하다는 것도 인정했습니다. 현재의 모델들은 반복적인 작업에 능숙한데, 인터넷 데이터가 이런 종류의 콘텐츠로 가득 차 있기 때문입니다;모델이 실제로 기존의 틀을 벗어나려면 새로운 아키텍처가 필요합니다."새로운 신호를 매우 적은 데이터로 빠르게 포착할 수 있도록 해야 합니다. '일반적인 반복적인 작업에서 다음 단계로 나아가기 위해서는 큰 도약이 필요합니다.'"
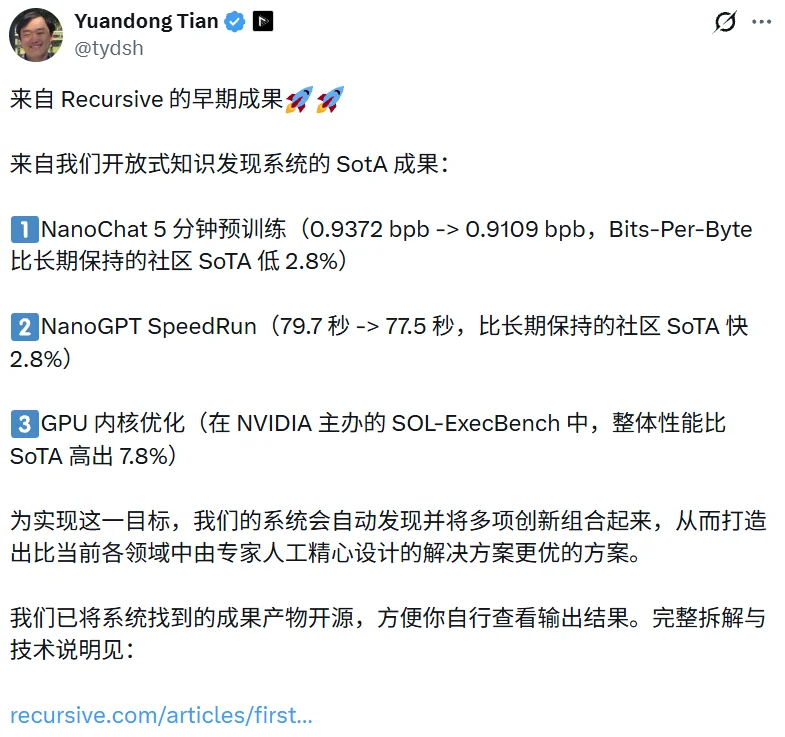
「아이디어를 내고, 코드를 작성하고, 실험을 수행하고, 결과를 분석하는」이라는 연구의 순환 과정에서, 그는가장 자동화하기 어려운 것은 아이디어입니다.NanoGPT Speedrun에서 ‘Recursive’가 기록한 성과, 즉 훈련 시간을 79.7초에서 77.5초로 단축한 것이 진정한 발견인지, 아니면 기존에 알려진 기술들을 효율적으로 활용한 결과인지에 대한 질문에 대해, 다나가와 토모야의 답변은 “둘 다입니다”였습니다. 예를 들어, 주의 메커니즘에 ‘bigram’ 정보를 추가하는 방법은 DeepSeek, Gemma 3, 그리고 그가 Meta에서 참여했던 STEM 논문들에서 비슷한 아이디어를 찾아볼 수 있지만, 다양한 계층에서 서로 다른 임베딩 테이블을 사용하고 이러한 아이디어들을 결합하는 방법에는 새로운 창의성이 포함되어 있습니다.
새로운 아키텍처가 왜 규모 확장 시에 항상 “실패”하는 걸까요?
많은 회사들이 Transformer의 대체 아키텍처를 제안했으며, 소규모 실험에서는 뛰어난 성과를 보였지만 대규모 모델로 확장하는 데는 실패했습니다. 다나베 도모토의 설명에 따르면Inductive Bias소규모 데이터의 경우 데이터가 부족하기 때문에 추가적인 구조적 가정을 도입해야 하며, 그 결과는 당연히 좋습니다. 하지만 데이터가 많아지면 모델이 스스로 패턴을 찾도록 하는 것이 최선의 방법입니다. 그는 ViT의 예를 들었습니다: ImageNet 규모의 데이터에서는 ViT가 컨볼루션 네트워크보다 성능이 떨어졌지만, 데이터 양이 수억 개 수준에 이르면 Transformer가 그 성능을 뛰어넘었습니다.
그렇다면, 새로운 아키텍처는 어떻게 검증해야 할까요?
전원 도는 당연하다고 생각합니다.소규모로 시작해야 합니다.하지만 핵심은 네트워크 내부에서 실제로 무슨 일이 일어나고 있는지 이해하는 것입니다. “우리는 그 안에 더 큰 규모로 확장할 수 있는 어떤 통찰력이 있다는 것을 알아야만 자신감을 가질 수 있습니다.” 그렇지 않으면, 단순히 스케일링 법칙을 맹목적으로 따른다면, 소규모에서 효과적인 것이 대규모에서도 효과적일 것이라는 것을 결코 증명할 수 없습니다. “그 결과는 단 하나뿐입니다: 가장 많은 컴퓨팅 성능을 가진 회사가 이긴다는 것입니다.”
그의 마음속에서 더 장기적인 목표는인간과 비슷한 학습 효율성을 찾기인간의 뇌는 단지 20~30와트의 전력 소비와 극소량의 데이터만으로도 매우 짧은 시간 안에 사물을 이해할 수 있습니다. 로봇 분야에서는 오늘날 대량의 데이터가 필요하다고 강조하지만, 그에 따르면 이는 단지 현재 패러다임의 요구일 뿐입니다. “고양이나 개와 같은 실체를 가진 생물들을 보세요. 그들은 그렇게 많은 데이터가 필요하지 않고, 프로세서도 매우 단순하지만 복잡한 세상에서 살아남을 수 있습니다. 그 안에는 분명 새로운 알고리즘이 있을 것입니다.”강화 학습과 자기 개선이 아마도 그곳으로 가는 가장 빠른 길일 것입니다.
자기 개선을 제한하는 것인가? “경계가 너무 모호하다”
프로그램이 끝날 때, 진행자는 현재 AI 보안 분야의 핫이슈에 대해 물었습니다: 일부 사람들은 최신 모델의 사용을 제한할 것을 촉구하고 있으며, 재귀적인 자가 개선에 대한 업계 간의 협력이 필요하다고 하고 있습니다.
"""타나베 도마의 대답은 매우 직설적이었습니다: ‘솔직히 말해서, 사람들이 그런 행동을 막는 것은 매우 어렵다고 생각합니다.’ 그에 따르면, 경계선 자체가 모호하기 때문입니다. 프로그래밍 인공지능과 새로운 아이디어를 논의하고 그것을 반복적으로 개선시키는 것은 어느 정도 자기 개선의 과정이며, 다른 사람들과 협력하여 논문을 쓰는 것도 마찬가지입니다. 게다가 점점 더 강력해지는 오픈소스 모델들을 사용하여 연구를 하는 것도 자기 개선에 해당할까요? 그렇다면 이를 어떻게 규제해야 할까요?’"
그는 명확하게 말했다,Recursive는 연구 성과를 오픈소스로 공개할 예정입니다.이전에 회사의 블로그 글에서는 모든 커널과 훈련 방법을 오픈소스로 공개하여 외부에서 검증하고 그 기반 위에서 더 발전시킬 수 있도록 했습니다. 그는 또 다른 상황을 더 우려하고 있습니다: “가장 나쁜 경우는, 소수의 엘리트들이 세계에서 가장 강력한 모델을 장악하고 나머지 모든 사람들에게 높은 가격을 지불하고 사용하도록 강요하는 것입니다.”
오픈소스 모델이 클로즈드소스 모델을 따라잡을 수 있을지에 대해 그는 상당히 낙관적입니다.그는 킴미(Kimi)를 예로 들며, 킴미가 이미 충분히 유용하다고 생각하지만 생각 과정이 조금 더 길 수 있다고 말했습니다. 그의 의견에 따르면, 프로그래밍 에이전트는 “AI 뉴턴”이나 “AI 아인슈타인”이 와서 코드를 대신 작성해주는 것을 필요로 하지 않습니다. 모델이 사용 가능한 기준을 넘어서기만 하면 충분하다고 합니다.
"""선진 연구소들은 이미 한계를 넘어섰으며, 오픈소스 모델들도 마찬가지입니다. 일단 그 한계를 넘으면 상품화될 것이고, 모든 사람들이 자신이 좋아하는 모델을 사용하게 될 것입니다."""
Smith Hall에서 AlexNet이 “운이 좋았는지”에 대한 논쟁이 있었던 지 14년이 지났습니다. 당시 의문을 받았던 딥러닝은 이제 스스로 논문을 쓰고, 코드를 수정하며, 기록을 경신하고 있습니다. 다나오 다나모토는 이 흐름의 최전선에 서기로 결정했으며, 그의 말에 따르면, 앞으로 진짜로 해결해야 할 문제는 “우리가 이 모든 모델들을 어떻게 활용하여 더 좋고 더 큰 일을 이룰 수 있을지”입니다.
이 글은 "기계의 마음"에서 발췌한 것이며, 저자는 "판다(Panda)"입니다.
有用吗?