Tian Yuan Dong : Après avoir co-écrit la dernière thèse avec GPT-5, j'ai réalisé que je serais au chômage dans les 5 prochaines années.
Il y a quelque temps, OpenAI a publié d'un coup 722 manuscrits de thèses mathématiques sur GitHub. Ces manuscrits ont été regroupés en 372 « familles » de résultats, couvrant 17 domaines mathématiques, et proviennent tous d'une source qui n'a pas encore été rendue publique et dont le nom n'a pas été dévoilé.Modèle interne——Sa performance est bien supérieure à celle de GPT-6 Astra.
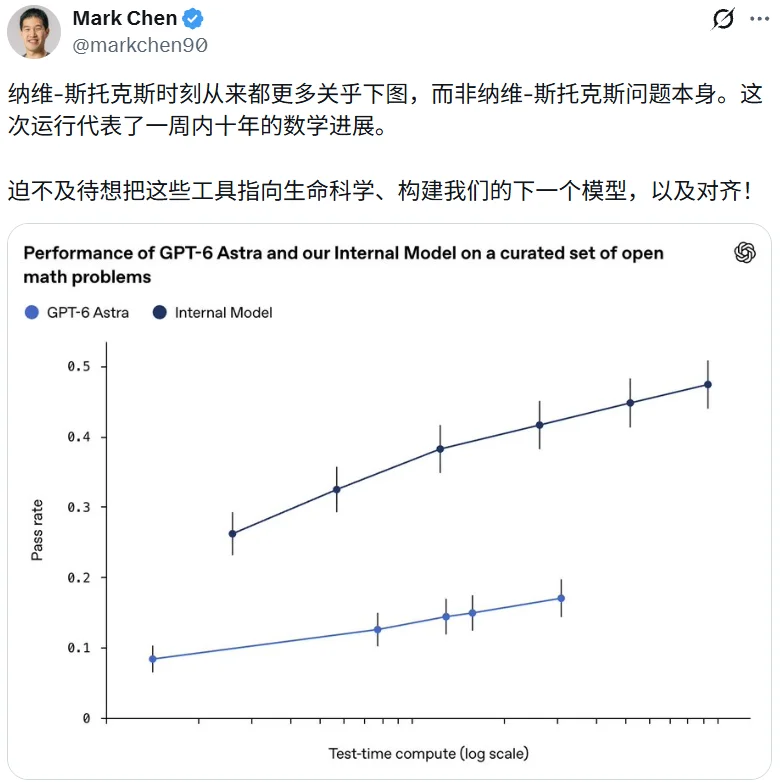
Tweet de Mark Chen, directeur de la recherche chez OpenAI
Bien sûr, il existe encore de nombreuses controverses au sein de la communauté mathématique concernant la qualité de ces résultats et la manière dont ils ont été présentés, mais un point est devenu difficile à nier :La vitesse à laquelle la recherche scientifique est produite par l'IA commence à être mesurée en « cent articles ».。
Presque en même temps, dans la dernière édition de la podcast The Information Bottleneck, un vétéran de l'apprentissage profond a dit quelque chose qui a inquiété de nombreux chercheurs : « Après avoir terminé ce projet et obtenu des résultats plutôt intéressants, j'ai soudain réalisé : wow... »Mon travail sera probablement remplacé dans les cinq prochaines années.。」
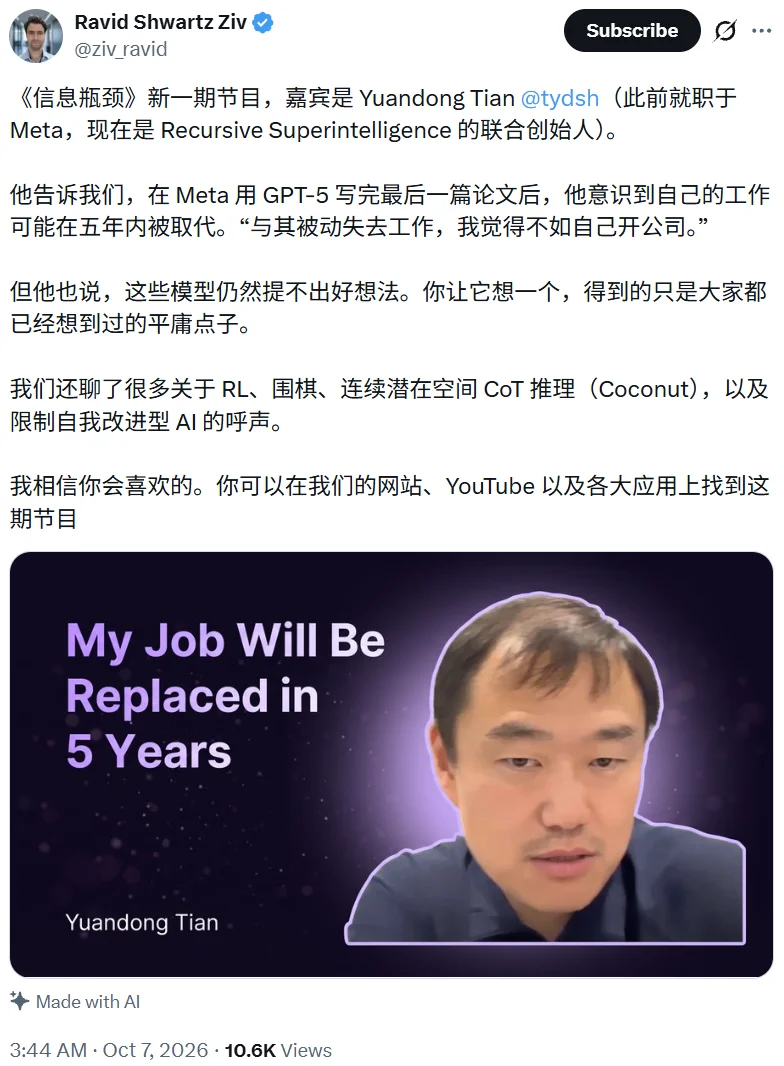
Adresse du podcast : https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
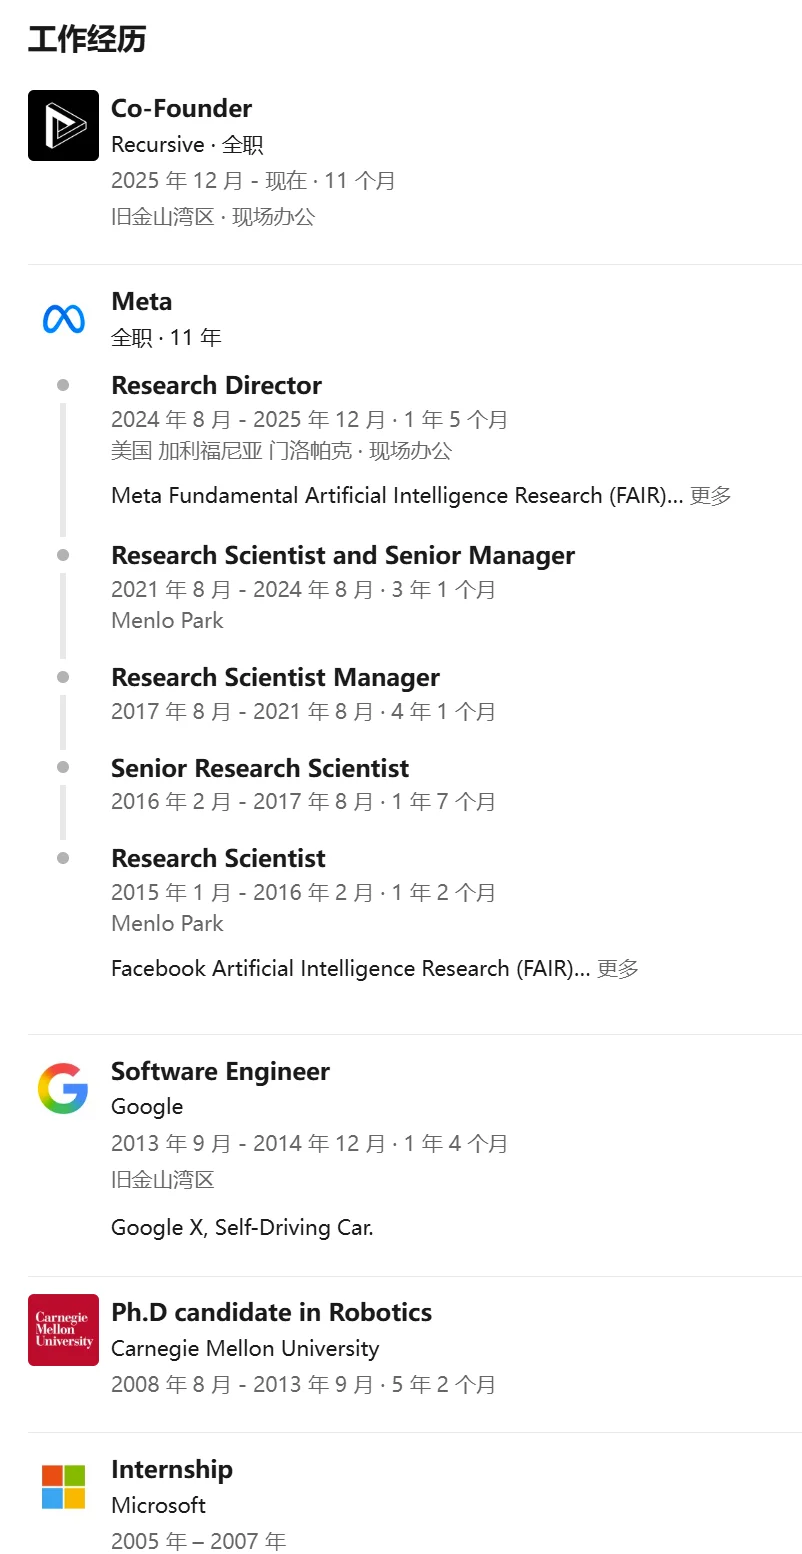
Celui qui a dit cela estTian Yuan Dong.Il a travaillé chez Meta FAIR pendant près de dix ans, s'est occupé de l'intelligence artificielle au go, de l'apprentissage renforcé et de l'interprétabilité des réseaux de neurones, et est également l'un des auteurs de la thèse sur Coconut (la chaîne de pensée dans l'espace latent continu).
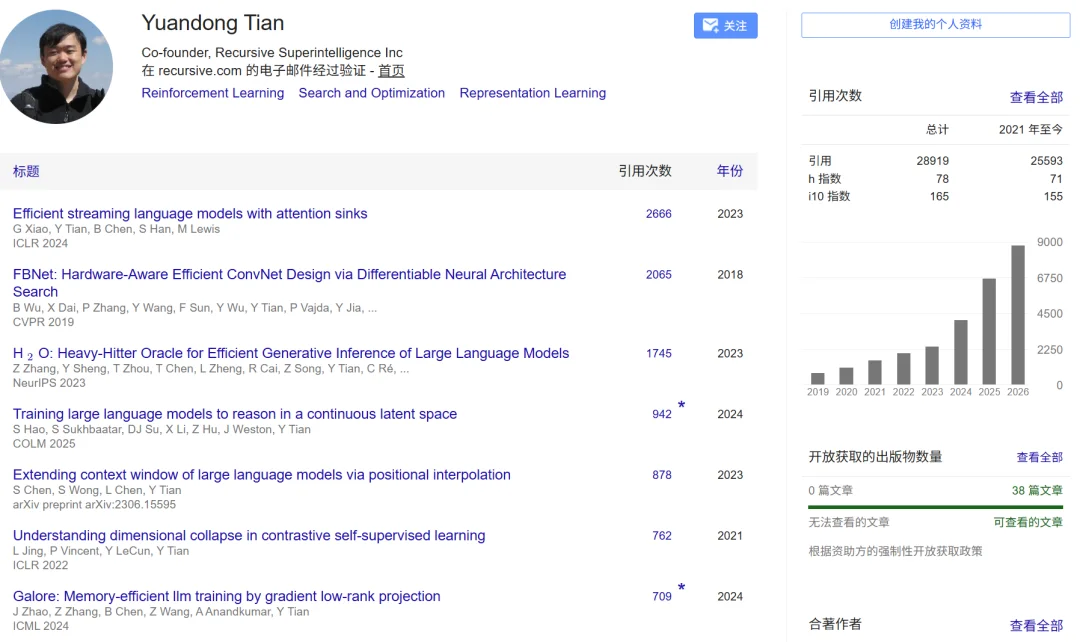
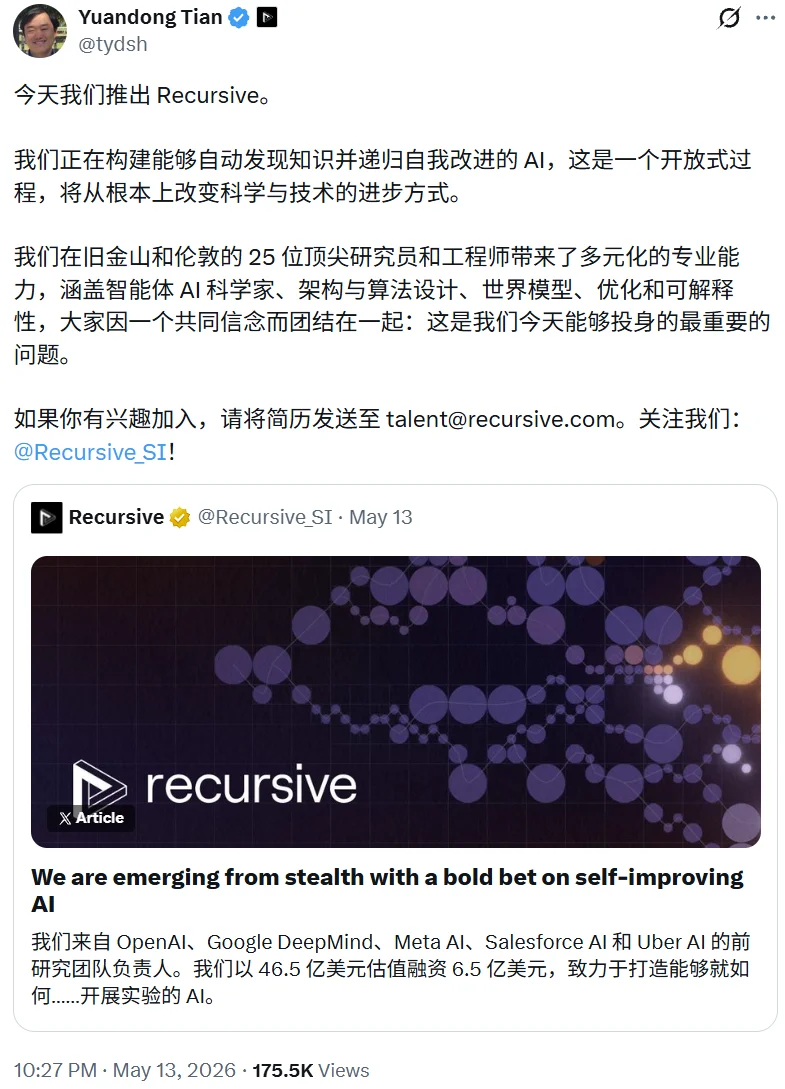
Aujourd'hui, son rôle est... Recursive Superintelligence Cofondateur de la société. En mai de cette année, l'entreprise a mis fin à son état de confidentialité et a annoncé avoir levé plus de 650 millions de dollars, pour une valeur estimée à 4,65 milliards de dollars, avec GV et Greycroft en tant que principaux investisseurs, ainsi que Nvidia et AMD.
Dans cette émission de podcast présentée par Ravid Shwartz-Ziv, Tagawa Tadao explique pourquoi il a décidé de monter sa propre entreprise :Plutôt que de perdre son emploi de manière passive, il vaut mieux prendre l'initiative de créer une entreprise qui évolue dans cette direction.Cependant, il a également jeté un froid sur les espoirs de l'IA dans l'émission : « Si vous laissez le modèle trouver ses propres idées par lui-même, il vous proposera des choses très banales, des choses que tout le monde connaît déjà et qui ne sont pas vraiment intéressantes. »
Au cours d'une conversation d'environ une heure, Tagaki Takahide a abordé divers sujets allant de AlexNet à l'époque de CMU, en passant par l'IA au jeu de Go, du « espace des actions » à la raisonnement dans l'espace latent, pour finalement se concentrer sur l'amélioration récursive, de nouvelles architectures et l'open source. Voici un résumé de cette discussion.
La dispute à Smith Hall : AlexNet était-il vraiment un accident ?
Tian Yuan Dong est arrivé aux États-Unis en 2008 pour poursuivre ses études de doctorat au Robotics Institute de l'Université Carnegie Mellon. À cette époque, l'apprentissage automatique n'avait pas la place qu'il occupe aujourd'hui. « Beaucoup de gens ne considéraient pas vraiment l'apprentissage automatique comme une voie prometteuse ; ils pensaient que cela ne fonctionnerait pas bien, en raison du problème de l'overfitting, et ils ne comprenaient pas vraiment ce qui se passait à l'intérieur des algorithmes. »
Son sujet de thèse de doctorat porte sur la vision par ordinateur.Problèmes d'optimisation non convexePar exemple, pour restaurer les distorsions d'image causées par la réfraction à la surface de l'eau. Il a utilisé une méthode de segmentation pour optimiser le problème et a démontré que même si le problème n'est pas convexe, il est encore possible de prouver l'optimalité dans une certaine mesure à condition que les données soient suffisamment abondantes. « La combinaison de l'approche basée sur les données et de l'optimisation est plutôt intéressante, et je suis toujours fier de ce travail. »
En 2012, AlexNet est apparu sur la scène. Tagawa Masaaki a envoyé un e-mail à Alex Krizhevsky et a obtenu le code pour l'expérimenter par lui-même. Il a rapidement réalisé que le traitement par couches des réseaux de convolution était en fait la même idée que la stratégie d'optimisation par couches décrite dans sa propre thèse : « C'est peut-être ce que j'ai toujours cherché, simplement sous une forme différente. »
Mais à l’époque, l’atmosphère à l’CMU n’était pas très agréable. « Tout le monde venait au bureau tous les jours et débattait vigoureusement dans le Smith Hall pour savoir si les résultats d’AlexNet étaient le fruit du hasard ou d’une véritable percée. La plupart des gens pensaient que c’était juste du hasard, car cela ne semblait pas logique. »
Lors de son diplôme en 2013, Tagawa Masaaki a reçu des offres de plusieurs entreprises intéressées par le domaine de l'apprentissage profond, mais il a finalement choisi l'équipe de conduite autonome de Google, d'une part en raison de sa réputation et d'autre part grâce à la recommandation d'un ami. Cependant, au cours de cette année et demie passées là-bas, il n'a pas réussi à travailler sur des projets liés à l'apprentissage profond, car l'équipe ressemblait plus à une start-up qui devait utiliser des solutions matures pour résoudre des problèmes pratiques plutôt que de se concentrer sur de la recherche scientifique. Il a donc changé d'emploi pour rejoindre FAIR, déclarant que c'était « l'une des meilleures décisions qu'il ait prises à l'époque ».
Deux personnes, une seule carte graphique (GPU) : Les souvenirs de Tagawa Masaaki dans le monde du go
À FAIR, le premier projet lancé par Takayama Tadao était l'IA pour le jeu de go. En 2015, son équipe a réalisé... DarkForestIl a battu des joueurs amateurs de haut niveau en ligne grâce à un réseau de convolution. Quelques mois plus tard, en printemps 2016, AlphaGo a battu un joueur professionnel.
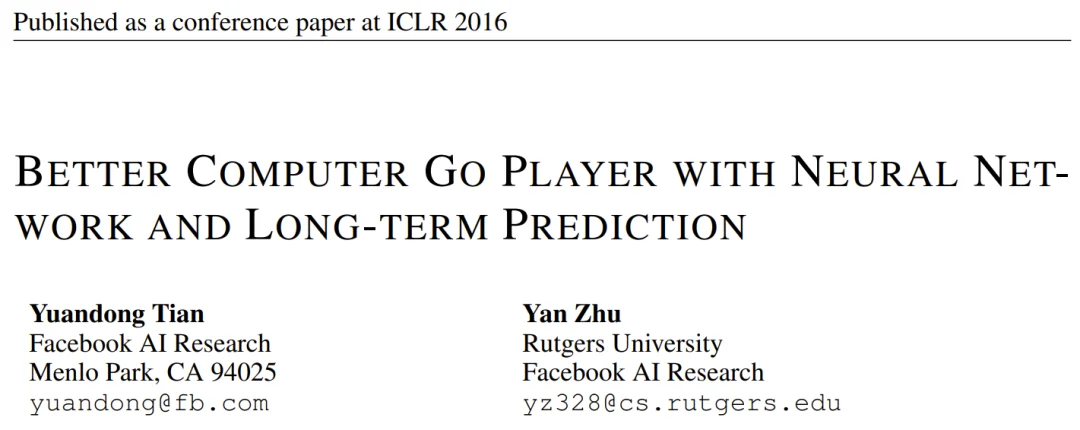
Face à un tel « accident », Tanihara Masaaki a reconnu que AlphaGo possédait deux avantages que lui-même n'avait pas :
- Réseau de valeurÀ l'époque, DarkForest n'avait que des réseaux de stratégies ;
- Il n'avait presque jamais...Apprentissage renforcéContexte : « En gros, j'ai appris en faisant, comme si je m'entraînais moi-même en apprentissage automatique. » Cette expérience l'a poussé à se consacrer par la suite à de nombreuses recherches en apprentissage automatique.
Lorsqu'on lui a demandé si AlphaGo était surprenant, sa réponse était intéressante : la méthode en elle-même n'était pas extraordinaire, carLes réseaux de convolution sont capables de détecter les motifs du plateau de jeu sur lesquels les humains s'appuient lorsqu'ils jouent aux échecs.Ce qui est vraiment surprenant, c'est qu'il parvient à battre des joueurs d'échecs professionnels.
En 2018, l'équipe a reproduit AlphaZero, une solution qui ne s'appuie pas du tout sur les parties d'échecs jouées par des humains et qui joue contre elle-même à partir de zéro, et a apporté quelques améliorations à son efficacité, ce qui a permis d'obtenir de bons résultats. OpenGoCette intelligence artificielle, lors d'un match officiel contre l'Académie de Go de Corée, n'a utilisé qu'une seule carte graphique V100 et a réussi à empêcher quatre joueurs professionnels de remporter le moindre match. « Je pense que c'est probablement...Pour la première fois, quelqu'un a battu un joueur professionnel d'échecs à l'aide d'une seule carte graphique (GPU).。」
Il y a eu une petite anecdote avant le match. L'équipe a demandé à des amis joueurs professionnels et semi-professionnels d'évaluer les capacités de jeu d'OpenGo. Ils ont répondu qu'ils pouvaient comprendre le début du jeu, mais qu'ensuite, ils ne comprenaient plus rien du tout, et ne pouvaient que dire : « Cela semble très fort, mais je ne sais pas vraiment si c'est vraiment le cas ». C'est alors que Tagawa Takahiro a décidé : « Alors, allons jouer directement contre un vrai joueur professionnel. »
L'espace d'action est plus important que l'algorithme.
En parlant de l'apprentissage automatique renforcé de cette époque, Tagawa Masaaki pense queIl existe de nombreuses méthodes qui sont encore sous-estimées à ce jour.Par exempleApprentissage renforcé distribuéAjustez le modèle en utilisant la distribution des récompenses plutôt qu'un seul vecteur scalaire ; par exemple Diverses méthodes de modélisation telles que l'apprentissage par Q (Q-learning)Mais maintenant, la plupart du temps, nous utilisons les gradients de stratégie, et c'est une époque très différente.
Il est également optimiste.Pas de méthode d'optimisation sans gradientDe plus, il est considéré que les grands modèles offrent de nouvelles possibilités : « Les grands modèles ont maintenant une meilleure compréhension globale des systèmes et des fonctions cibles à optimiser, une compréhension qui est bien plus utile que les informations sur les gradients locaux. » Lorsque les gradients varient fortement et que les optima locaux sont omniprésents, les méthodes basées sur les gradients peuvent mener à des impasses, tandis que les méthodes sans gradient incorporent naturellement une composante d'exploration, « quelque chose que les méthodes basées sur les gradients ne font jamais ».
Vers 2018 et 2019, Mita Fumihiko a commencé à essayer d'appliquer l'apprentissage renforcé à des problèmes du monde réel, et les conclusions étaient plutôt surprenantes :Ce qui est vraiment important, ce n'est pas l'algorithme, mais la conception de l'espace d'action et de l'espace d'état.」
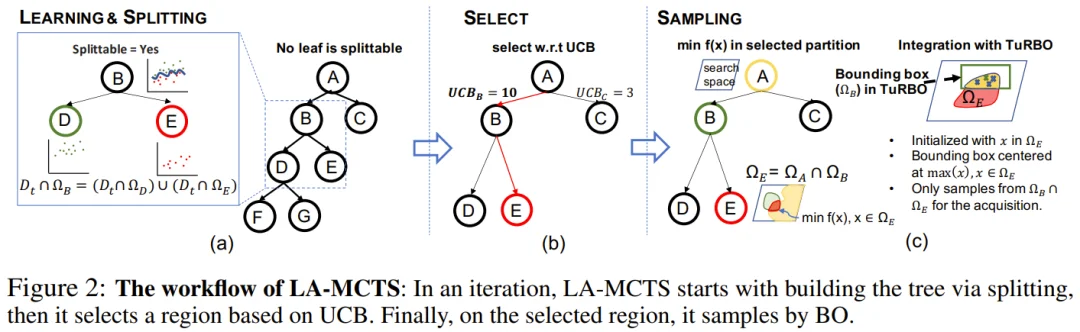
Il prend l'exemple de la recherche d'architectures de réseaux neuronaux. Les humains savent que la profondeur du réseau est cruciale, mais l'IA ne le sait pas. Si l'IA commence par rechercher des détails tels que la taille des noyaux de convolution de la première couche, toutes les branches ont à peu près le même comportement, et la fonction de valeur ne fournit pas de signaux utiles. Il ne reste donc qu'à approfondir la recherche couche par couche, ce qui entraîne une explosion exponentielle de l'espace de recherche ; « à ce stade, aucun algorithme ne sera efficace ». En revanche, si l'on peut réorganiser l'espace des actions de manière que l'IA prenne conscience de l'importance de la profondeur, une différence marquée apparaîtra entre les réseaux profonds et les réseaux peu profonds, et quelques tests suffiront à déterminer la bonne direction. Sur cette base, l'équipe a proposé...Recherche par arbre de Monte-Carlo dans l'espace latent (LA-MCTS)L'idée principale est de trouver automatiquement l'espace d'action qui permet de maximiser la distinction entre les sous-espaces de recherche.
Coconut : « Je n’utilise jamais de langage quand je réfléchis. »
L'animateur conjoint a mentionné la participation de Tagawa Takahiko. Coconut Les articles scientifiques consistent à faire raisonner les modèles dans un espace latent continu, et non dans un espace de tokens. Tanaka Masaaki explique que cette idée provient de ses propres observations : « Lorsque je réfléchis, je n’utilise jamais de langage. Je peux sentir clairement que c’est une autre partie de mon cerveau qui est en activité pendant la réflexion, et ensuite je dois traduire ces idées en langage pour pouvoir communiquer efficacement avec les autres. »
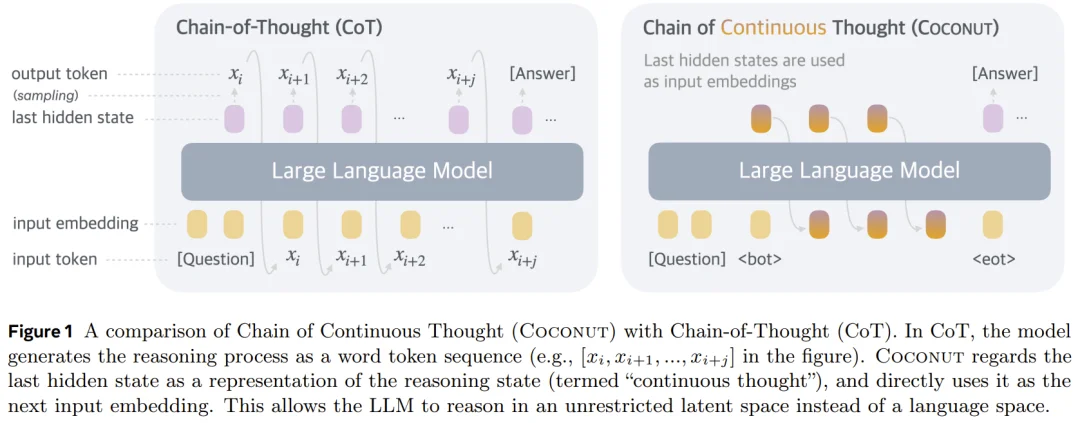
Partant de cette intuition, l'équipe a effectué des déductions théoriques et a découvert que la représentation potentielle pouvait être un état superposé de plusieurs idées. En utilisant cette approche, il est possible d'obtenir un avantage significatif dans des problèmes tels que la traversée de graphes, « peut-être pas exponentiel, mais au moins un certain avantage ».
Alors pourquoi les modèles de pointe n'adoptent-ils pas encore de chaînes de pensée continues ? Tanaka Masaaki a donné deux raisons.
- DonnéesUne grande partie des processus de pensée humains est enregistrée sous forme de langage, tandis que l'espace latent ne dispose pas de tels données.
- Les représentations potentielles pourraient être très personnalisées.Chacun utilise, dans une certaine mesure, sa propre représentation potentielle, mais les grandes modèles ont une efficacité d'apprentissage bien inférieure à celle des humains, ce qui les oblige à utiliser le langage comme substitut temporaire.
Ravid Shwartz-Ziv demande si cela est similaire aux problèmes de régularisation auxquels sont confrontés les méthodes auto-entraînées comme JEPA. Tanaka Masaaki est d'accord et approfondit la question : la descente de gradient pourrait elle-même être piégée dans une sorte de « optimum local au niveau métaphysique », de sorte que certains bons représentations ne pourraient tout simplement pas être appris avec les paradigmes d'entraînement actuels. « Nous ne savons pas vraiment où se trouvent les limites pour l'instant. »
À ses yeux, c'est précisément ce qu'il faut.Recherche sur l'interprétabilitéLa signification réside dans la différence entre l'alchimie et la chimie. C'est juste que les modèles actuels sont trop puissants, tout le monde se concentre sur les résultats, et il n'y a pas encore assez de personnes ni de temps pour s'engager dans cette direction.
EtGPT-5Après avoir rédigé la dernière thèse
En ce qui concerne la transition à l'ère des grands modèles, Tanabata Masaaki estime que l'analyse de la dynamique de l'entraînement des réseaux de neurones qu'il mène depuis 2018 peut être appliquée également aux grands modèles, sans que cela ne représente de rupture significative dans la méthodologie. Le véritable changement réside au niveau de la preuve empirique : les chercheurs proposent des hypothèses, mènent des expériences et tirent des conclusions de la même manière qu'il y a cent ou deux cents ans.Plus le modèle devient puissant, plus il est capable de générer des idées par lui-même.Les chercheurs pourraient être contraints de réfléchir à un niveau métaphysique, plutôt que de passer leur temps à formuler des hypothèses concrètes une par une.
En même temps,La position de la capacité de projet a considérablement augmenté.Dans l'ère des grands modèles, beaucoup de bonnes tâches impliquent « la moitié de la recherche et la moitié de l'ingénierie ». Cependant, avec l'apparition des agents de programmation basés sur l'IA, la situation a changé : des chercheurs expérimentés peuvent permettre à ces agents de mettre en œuvre rapidement des idées et de cibler les problèmes clés, « et soudainement, ils acquièrent des super-pouvoirs pour explorer des choses vraiment profondes ».
Le tournant a été sa dernière publication dans Meta, pour laquelle il était également l’unique auteur. Cette publication portait sur les réseaux de neurones. grokking Phénomène où le réseau apprend d'abord par cœur, puis, à un certain moment, il acquiert soudainement la capacité à généraliser.
Pendant tout le processus,Il considère GPT-5 comme un collaborateur.Posez-lui des questions, donnez-lui des « devoirs » pour qu'il prouve des théorèmes, vérifie si ces théorèmes sont corrects, et réfléchissez ensemble.
Résultat :L'efficacité a été améliorée d'environ 6 à 10 fois.«Et c'est encore une estimation conservatrice, car à l'époque, je codais tout moi-même.» Aujourd'hui, le code et la mise en œuvre peuvent être confiés à des agents intelligents puissants, ce qui accélère encore les choses.
Ainsi est né le premier paragraphe. Tanaka Mifune admet que les chercheurs ont généralement peu envie de devenir cofondateurs dans de petites entreprises, car cela signifie de s'occuper de nombreuses choses en plus de la recherche elle-même. « Mais je pense que nous sommes actuellement à un tournant décisif ; si je ne fais rien, cela pourrait devenir insignifiant par la suite. »
L'animatrice co-présentatrice a répondu sur un ton semi-ironique en disant que sa stratégie était d'apprendre à faire des choses elle-même, mais malheureusement « je ne suis pas très douée pour les tâches pratiques ».
L'IA n'a pas encore trouvé de bonne idée.
Cependant, Tagawa Miki ne pense pas que l'humanité puisse déjà se retirer.Je ne pense pas que les modèles actuels soient capables de fournir de bons résultats sans aucune intervention humaine.Même pour cet article écrit en collaboration avec GPT-5, c'est lui qui a défini la ligne directrice générale, et non le modèle qui a réfléchi par lui-même.
Les humains doivent toujours être responsables de :
- LancerDéterminer quelles problématiques méritent d'être abordées
- VérificationComment juger si la solution proposée par l'IA est fiable ?
Ravid Shwartz-Ziv a mentionné que de nombreuses recherches récentes sur l'autonomisation des agents pour effectuer l'entraînement postérieur et participer aux compétitions sur Kaggle révèlent des problèmes tels qu'un espace de réflexion limité et une tendance à surapprendre les indicateurs (指标) utilisés pour évaluer les performances. Tanihara Takahiko pense que cela est en partie temporaire : les modèles sont confrontés à des tâches exigeantes en termes de détails sans pour autant disposer de contexte suffisant. En leur fournissant plus d'informations contextuelles, il est possible qu'ils proposent des idées plus intéressantes que simplement ajuster les paramètres de configuration (超参数).
Mais il reconnaît également que l'ajout de contexte n'est qu'une « réparation temporaire ». Les modèles actuels sont doués pour des tâches répétitives, car les données sur Internet sont pleines de ce type de contenu ;Si nous voulons que le modèle dépasse réellement les limites actuelles, nous avons besoin d'une nouvelle architecture.Il doit être capable de capturer de nouveaux signaux rapidement avec très peu de données. « Pour passer du travail répétitif habituel au niveau suivant, nous avons besoin d'un grand bond en avant. »
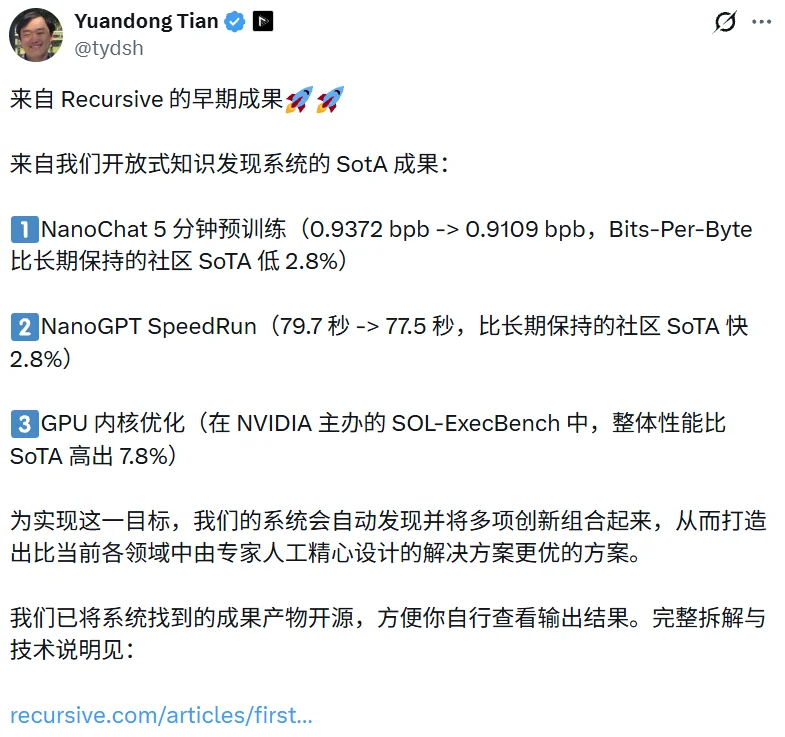
Dans le cycle de recherche qui consiste à « proposer des idées, écrire du code, exécuter des expériences et analyser les résultats », il pense queCe qui est le plus difficile à automatiser, ce sont les idées.Lorsqu'on lui a demandé quel était le résultat de « Recursive » dans le NanoGPT Speedrun, c'est-à-dire la réduction du temps d'entraînement de 79,7 secondes à 77,5 secondes, s'il s'agissait d'une véritable découverte ou simplement d'une recherche efficace de techniques déjà existantes, la réponse de Tadao Tagawa a été « les deux ». Par exemple, l'ajout d'informations de type bigram dans le mécanisme d'attention est une approche similaire à celle trouvée dans des travaux comme DeepSeek, Gemma 3, ainsi que dans les articles scientifiques sur l'IA (STEM) auxquels il a participé chez Meta. Cependant, la manière de utiliser des tableaux d'encodage différents à différents niveaux et de combiner ces idées représente une nouvelle forme de créativité.
Pourquoi les nouvelles architectures « échouent-elles » systématiquement lorsqu'elles sont mises à l'échelle ?
De nombreuses entreprises ont proposé des architectures alternatives au Transformer, qui ont montré de bons résultats dans des expériences à petite échelle, mais n'ont jamais réussi à être étendues aux grands modèles. L'explication de Tagaki Tadao est...Induction biasLorsque la quantité de données est faible, il est nécessaire d'introduire des hypothèses structurelles supplémentaires, et les résultats sont naturellement meilleurs ; mais lorsque la quantité de données augmente, la meilleure approche est de laisser le modèle trouver les règles par lui-même. Il a pris l'exemple de ViT : sur des données de l'ordre de ImageNet, ViT n'est pas aussi performant que les réseaux convolutifs, mais lorsque la quantité de données atteint des centaines de millions, les Transformer prennent l'avantage.
Alors, comment vérifier la nouvelle architecture ?
Tian Yuan Dong pense bien sûr que c'est le cas.Il faut commencer à petite échelle.Mais l'essentiel est de comprendre ce qui se passe réellement à l'intérieur du réseau. « Nous devons savoir s'il existe une certaine perspicacité qui peut être généralisée à une échelle plus large, afin d'avoir confiance ». Sinon, si nous suivons simplement la loi de l'échelle de manière aveugle, nous ne pourrons jamais prouver que ce qui fonctionne à petite échelle fonctionne également à grande échelle. « Le seul résultat sera que les entreprises disposant de la plus grande puissance de calcul gagneront ».
Son objectif à plus long terme est de...Trouver une efficacité d'apprentissage comparable à celle des humainsLe cerveau humain, avec seulement une consommation d’énergie de vingt à trente watts et une quantité très faible de données, est capable de comprendre les choses en très peu de temps. Dans le domaine des robots, l’accent est mis aujourd’hui sur la nécessité de grandes quantités de données, ce qui, à son avis, est simplement une exigence du paradigme actuel. « Regardez les animaux tels que les chats et les chiens : ils n’ont pas besoin de tant de données, et leurs processeurs sont assez rudimentaires pourtant ils parviennent à survivre dans un monde complexe. Il doit y avoir de nouveaux algorithmes là-dedans. »Et l'apprentissage automatique renforcé ainsi que l'amélioration continue peuvent être les chemins les plus rapides pour y parvenir.
Restreindre l'amélioration de soi-même ? « Les frontières sont trop floues »
À la fin de l’émission, le présentateur a abordé un sujet brûlant dans le domaine de la sécurité de l’IA : certaines personnes appellent à limiter les derniers modèles et demandent une coordination au sein de l’industrie concernant l’amélioration récursive de ces modèles.
La réponse de Tanaka Miki est très directe : « Pour être honnête, je pense qu’il est très difficile d’empêcher les gens de faire cela. » À son avis, les frontières sont elles-mêmes floues : lorsque vous discutez de nouvelles idées avec un agent de programmation et que vous le laissez itérer, c’est en quelque sorte une forme d’amélioration de soi ; lorsque vous travaillez avec d’autres personnes sur une publication scientifique, c’est également une forme d’amélioration de soi. De plus, avec les modèles open source de plus en plus puissants, est-ce considéré comme une forme d’amélioration de soi de les utiliser pour la recherche ? Et comment pourrait-on les réguler ?
Il a clairement indiqué queLes résultats de la recherche récursive seront rendus publics sous forme de code open source.Auparavant, les articles de blog de l'entreprise avaient déjà mis à disposition le noyau complet et les schémas d'entraînement, permettant à l'extérieur de les vérifier et de continuer à les développer sur cette base. Il s'inquiète davantage d'une autre situation : « Le pire scénario serait que un petit groupe d'élites contrôle les modèles les plus puissants du monde, puis oblige tous les autres à payer un prix élevé pour les utiliser. »
Il est plutôt optimiste quant à la possibilité que les modèles open source rattrapent ceux qui sont fermés.Il prend Kimi comme exemple et pense que celui-ci est déjà très fonctionnel, même si le processus de réflexion peut être un peu long. À son avis, les agents de programmation n’ont pas besoin que des « AI Newton » ou des « AI Einstein » viennent leur écrire du code ; il suffit que le modèle dépasse un certain niveau de performance.
Les laboratoires de pointe ont déjà dépassé les limites, et les modèles open-source sont également en train de le faire. « Une fois que cela est fait, ils seront commercialisés, et tout le monde utilisera le modèle de son choix. »
Il s'est écoulé quatorze ans depuis le débat au Smith Hall sur le fait que AlexNet était un « coup de chance ». L'apprentissage profond, qui était remis en question à l'époque, commence aujourd'hui à écrire ses propres articles, à modifier des codes et à battre des records. Tanaka Takahiko a choisi de se tenir à l'avant-garde de cette tendance. Selon ses propres mots, la vraie question qui se pose maintenant est : « Comment pouvons-nous utiliser tous ces modèles pour faire des choses meilleures et plus importantes ? »
L'article provient de "Machine Heart", l'auteur est "Panda".
Lien de l’article :https://www.airai.cc/fr/ai-news/60/
有用吗?