Tian Yuan Dong: Después de escribir el último artículo en colaboración con GPT-5, me di cuenta de que me quedaría desempleado en los próximos 5 años.
Hace unos días, OpenAI publicó de una vez 722 manuscritos de artículos matemáticos en GitHub. Estos manuscritos están divididos en 372 "familias" de resultados, que abarcan 17 campos matemáticos, y todos provienen de un trabajo que aún no ha sido publicado y cuyo nombre no ha sido revelado.Modelo interno——Su rendimiento supera con creces al de GPT-6 Astra.
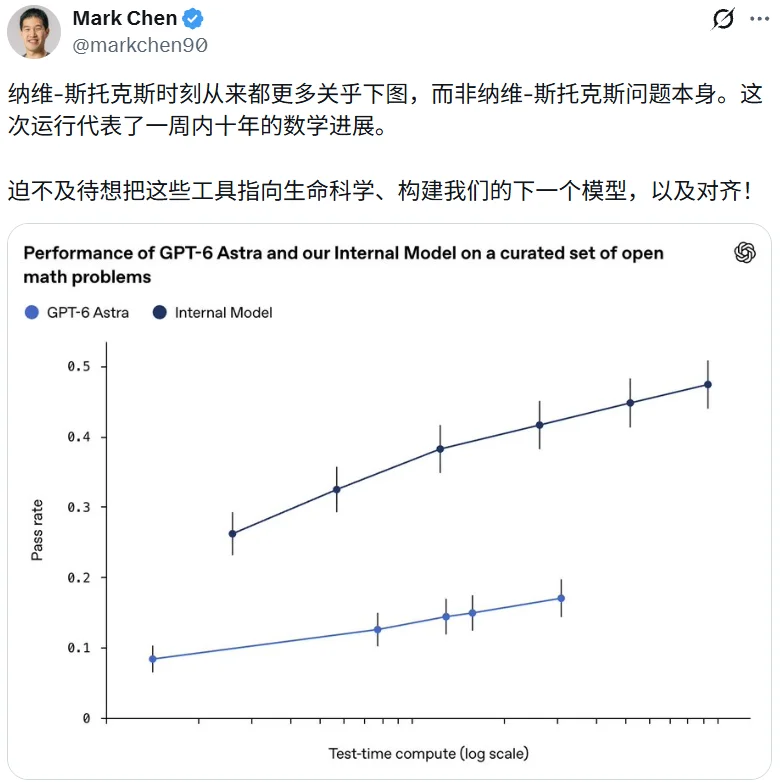
Tuit de Mark Chen, director de investigación de OpenAI
Por supuesto, todavía hay muchas controversias en el mundo matemático sobre la calidad de estos resultados y la forma en que fueron divulgados, pero hay algo que ya es difícil de negar:La velocidad a la que la IA produce resultados de investigación ha comenzado a medirse en términos de «cientos de artículos».。
Casi al mismo tiempo, en el último episodio del podcast The Information Bottleneck, un veterano del aprendizaje profundo dijo algo que hizo que muchos investigadores se sintieran preocupados: «Después de terminar este proyecto y obtener algunos resultados interesantes, de repente me di cuenta de que: wow...»Mi trabajo probablemente será reemplazado en aproximadamente cinco años.。」
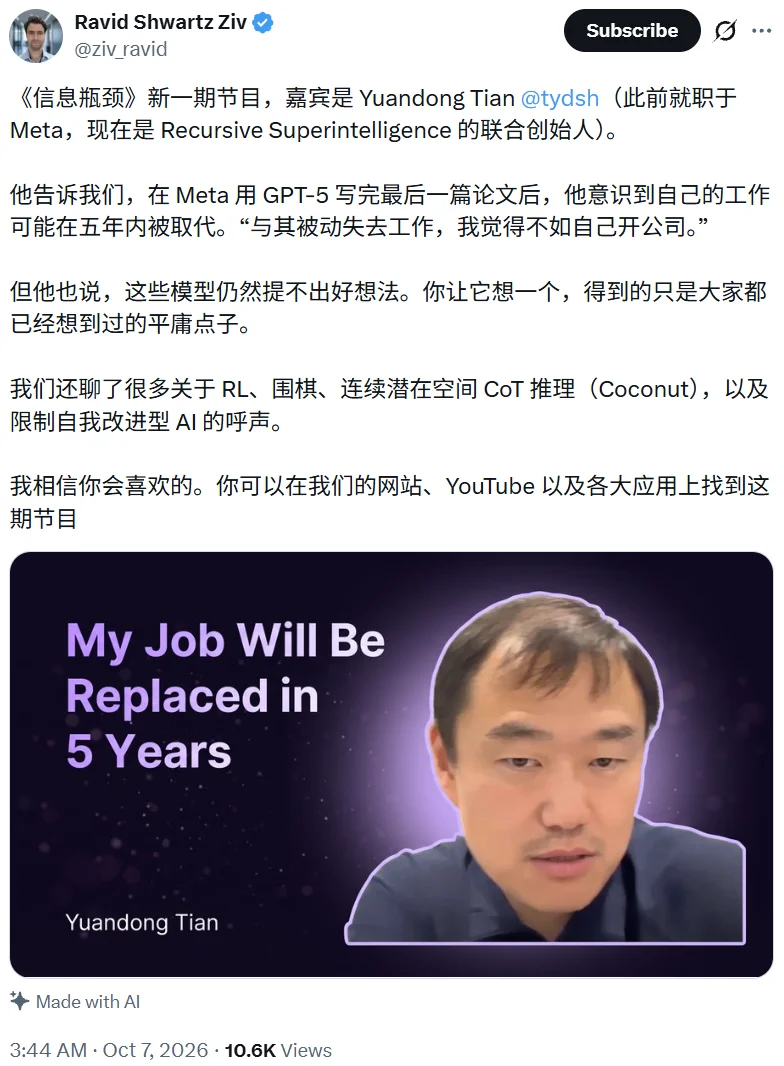
Dirección del podcast: https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
Quien dijo esto fueTian Yuan DongEstuvo en Meta FAIR durante casi diez años, trabajando en IA para el juego del Go, aprendizaje automático reforzado, y la explicabilidad de las redes neuronales. También es uno de los autores del artículo sobre Coconut (una cadena de pensamiento en espacios continuos).
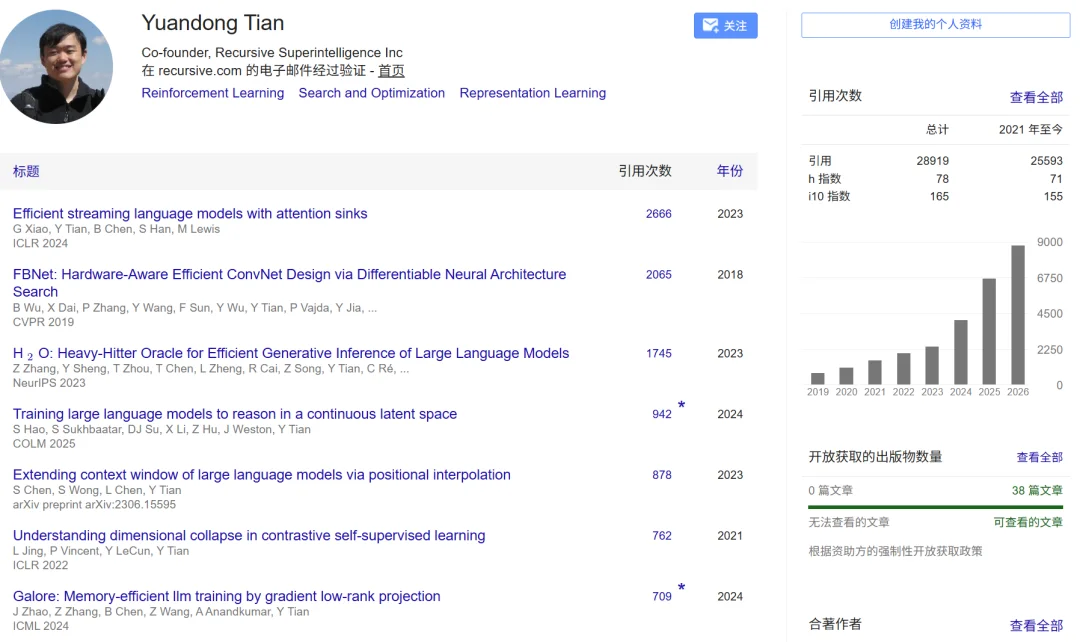
Hoy en día, su identidad es Recursive Superintelligence Cofundador de la empresa. En mayo de este año, la compañía dejó de operar de manera encubierta y anunció la finalización de una ronda de financiación de más de 650 millones de dólares, con una valoración de 4.65 mil millones de dólares, liderada por GV y Greycroft, y con la participación de NVIDIA y AMD.
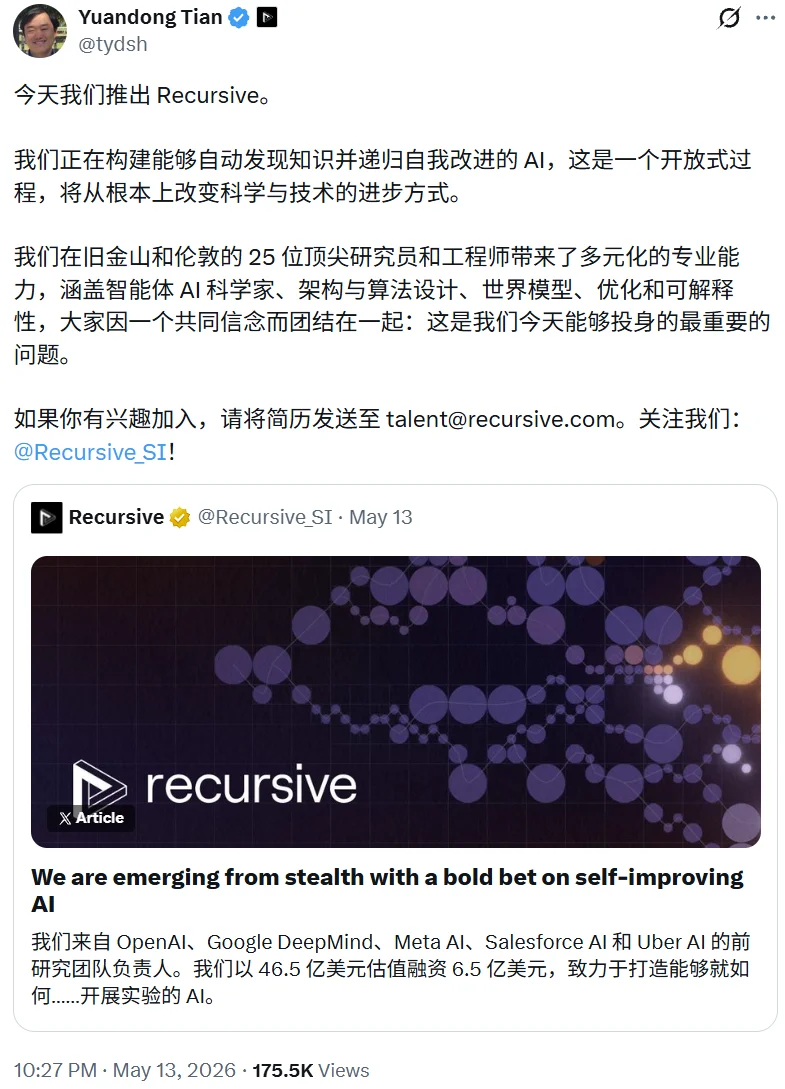
En este episodio del podcast presentado por Ravid Shwartz-Ziv, Tagaki Takahashi explica por qué decidió emprender:En lugar de perder el trabajo de manera pasiva, es mejor tomar la iniciativa y abrir una empresa que avance en esa dirección.Sin embargo, también puso algo de agua fría sobre la IA en el programa. «Si dejas que el modelo piense por sí mismo, te dará algunas ideas muy mediocres, que básicamente todos conocen y que no representan ninguna dirección interesante.»
Durante una conversación de casi una hora, Tagawa Takahiko habló sobre el AlexNet de sus tiempos en la CMU, pasando por la IA para el juego del Go, el “espacio de acciones” y la inferencia en espacios ocultos, hasta llegar al autoaperfeccionamiento recursivo, nuevas arquitecturas y el código abierto. A continuación se presenta un resumen de esta conversación.
El argumento en Smith Hall: ¿Es realmente el caso de AlexNet un accidente?
Tian Yuan Dong llegó a Estados Unidos en 2008 para obtener su doctorado en el Instituto de Robótica de la Universidad Carnegie Mellon. En ese momento, el aprendizaje automático no tenía la importancia que tiene hoy en día. «En aquel entonces, muchas personas no consideraban que el aprendizaje automático fuera un camino fiable; decían que no funcionaba bien porque tendía a sobreajustarse y que no se entendía bien lo que ocurría dentro de los algoritmos».
Su tesis doctoral trata sobre visión computacional.Problemas de optimización no convexaPor ejemplo, restaurar las distorsiones en las imágenes causadas por la refracción de la superficie del agua. Utilizó un método de capas para optimizar el problema y demostró que, incluso si el problema no es convexo, siempre es posible probar la optimidad hasta cierto punto con suficientes datos. "La combinación de datos y optimización es bastante interesante; todavía estoy orgulloso de este trabajo."
En el año 2012, AlexNet hizo su aparición de manera sorprendente. Taniwaki Takahide envió un correo electrónico a Alex Krizhevsky y solicitó el código para poder jugar con él. Pronto se dio cuenta de que el procesamiento en capas de las redes convolucionales era en realidad lo mismo que el enfoque de optimización por capas que describía en su artículo: «Podría ser lo que he estado buscando todo este tiempo, solo que presentado de una forma diferente».
Pero en ese momento, el ambiente en la CMU no era amigable. “Todos venían a la oficina todos los días y discutían acaloradamente en Smith Hall si los resultados de AlexNet eran solo una casualidad o realmente un avance significativo. La mayoría pensaba que era solo una casualidad, porque no parecía lógico.”
Al graduarse en 2013, Tian Yuan Dong recibió ofertas de varias instituciones interesadas en el campo del aprendizaje profundo, pero finalmente eligió unirse al equipo de conducción autónoma de Google. Por un lado, fue por la reputación de la empresa; por otro, debido a la recomendación de un amigo. Sin embargo, durante el año y tres meses que pasó allí, no logró avanzar significativamente en su trabajo relacionado con el aprendizaje profundo, ya que el equipo se asemejaba más a una empresa emergente, enfocada en resolver problemas prácticos con soluciones ya existentes en lugar de dedicarse a la exploración científica. Por eso, decidió cambiar de empleo y se unió a FAIR, describiéndolo como «una de las mejores decisiones que he tomado en ese momento».
Dos personas, una sola GPU: Los recuerdos de Go de Tanaka Mifune
En FAIR, el primer proyecto iniciado por Takao Tagawa fue el de IA para el juego del Go. En 2015, su equipo logró... DarkForestCon una red de convolución, derrotó a los mejores jugadores aficionados en línea. Unos meses después, en la primavera de 2016, AlphaGo venció a jugadores profesionales.
Frente a tal "colisión", Tanihara Masaaki cree que AlphaGo tiene dos aspectos que él no posee:
- Red de valorEn ese momento, DarkForest solo contaba con una red de estrategias;
- Él mismo casi no había tenido nada antes.Aprendizaje reforzadoEl contexto es el siguiente: «Básicamente, aprendía mientras trabajaba, como si estuviera realizando aprendizaje automático para mí mismo». Esta experiencia lo llevó a dedicarse posteriormente a una gran cantidad de investigación en el campo del aprendizaje automático.
Cuando se le preguntó si AlphaGo fue una sorpresa, su respuesta fue muy interesante: el método en sí no es nada asombroso, porqueLas redes convolucionales pueden capturar los patrones del tablero en los que los humanos basan su juego de ajedrez.Lo que realmente sorprende es que sea capaz de derrotar a jugadores profesionales de ajedrez.
En 2018, el equipo reprodujo el algoritmo AlphaZero, que es capaz de jugar contra sí mismo desde cero sin depender en absoluto de partidas previas jugadas por humanos, y realizó algunas mejoras en su eficiencia, lo que les permitió obtener resultados significativos. OpenGoEste AI, en una partida oficial contra el Instituto Coreano de Ajedrez, utilizó solo una GPU del tipo V100 y logró que ninguno de los cuatro jugadores profesionales ganara. «Supongo que eso debe ser...»Por primera vez, alguien ha derrotado a un jugador profesional de ajedrez utilizando solo una sola GPU.。」
Antes del partido, ocurrió un pequeño incidente. El equipo pidió a amigos jugadores profesionales y semiprofesionales que evaluaran el nivel de juego de OpenGo. El resultado fue que, aunque pudieron entender el comienzo del juego, no lograron comprenderlo más adelante, y solo pudieron decir: «Parece muy fuerte, pero no estoy seguro de si realmente lo es». Entonces, Tagawa Takahiko decidió: «Entonces, mejor jugamos directamente contra un jugador profesional de verdad».
El espacio de acción es más importante que el algoritmo.
Hablando del aprendizaje automático reforzado de esa época, Tanaka Mifune cree queHay muchos métodos que todavía no se valoran lo suficiente.Por ejemploAprendizaje reforzado distribuidoAjusta el modelo utilizando la distribución de recompensas en lugar de un solo escalar; por ejemplo, Diferentes métodos de modelado como el aprendizaje por preguntas (Q-learning)「Pero ahora, la mayoría de las veces utilizamos el gradiente de estrategia, lo cual representa una época muy diferente。」
Él también tiene una visión positiva al respecto.Métodos de optimización sin gradienteAdemás, se considera que los grandes modelos han abierto nuevas posibilidades: «Los grandes modelos ahora tienen una comprensión de mayor nivel de los sistemas y de las funciones objetivo que se deben optimizar, y esta comprensión de mayor nivel es mucho más útil que la información de los gradientes locales». En situaciones donde los gradientes varían drásticamente y los óptimos locales son comunes, los gradientes pueden llevar a un callejón sin salida, mientras que los métodos sin gradientes inherentemente incluyen la exploración, algo que los métodos basados en gradientes nunca hacen.
Alrededor de 2018 y 2019, Tagaki Takahiro comenzó a probar el uso del aprendizaje reforzado en problemas del mundo real, y las conclusiones fueron bastante sorprendentes:Lo que realmente importa no es el algoritmo, sino el diseño del espacio de acciones y el espacio de estados.」
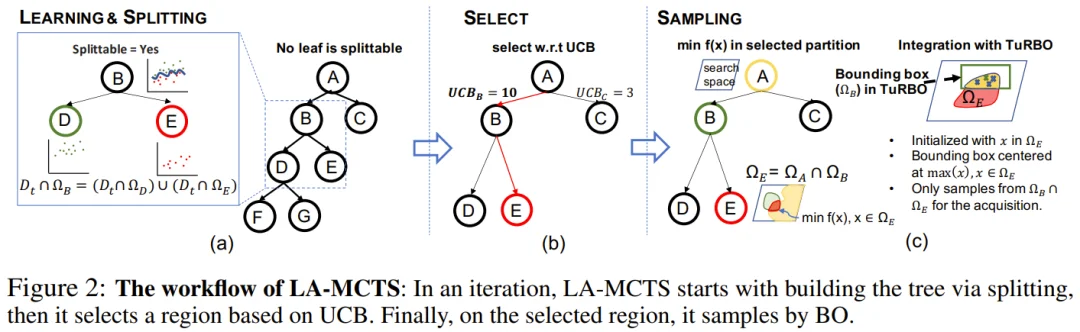
Él toma como ejemplo la búsqueda de arquitecturas neuronales. Los humanos saben que la profundidad de la red es crucial, pero la IA no lo sabe. Si la IA comienza buscando detalles como el tamaño de los núcleos de convolución de la primera capa, el rendimiento de todas las ramas es más o menos el mismo, y la función de valor no proporciona señales útiles. Solo es posible profundizar capa por capa, lo que hace que el espacio de búsqueda explote exponencialmente; «en ese caso, no importa qué algoritmo uses». Por otro lado, si se puede reorganizar el espacio de acción para que la IA «se dé cuenta» de que la profundidad es importante, se creará una clara diferencia entre las redes profundas y las superficiales, y se podrá ver la dirección correcta después de solo unas pocas implementaciones. Basándose en esto, el equipo propuso...Búsqueda por árbol de Monte Carlo en espacio oculto (LA-MCTS)El concepto central es encontrar automáticamente el espacio de acciones que permite la mayor distinción entre los subespacios de búsqueda.
Coconut: «Nunca uso el lenguaje cuando pienso».
El presentador conjunto mencionó la participación de Tagawa Takahiro. Coconut El artículo propone que los modelos razonen en un espacio continuo de potenciales en lugar de en un espacio de tokens. Tian Yuan Dong explica que esta idea surgió de su propia observación: «Cuando pienso, nunca uso el lenguaje. Puedo sentir claramente que utilizo otra parte del cerebro para pensar, y luego tengo que traducir esas ideas al lenguaje para poder comunicarme fluidamente con otros».
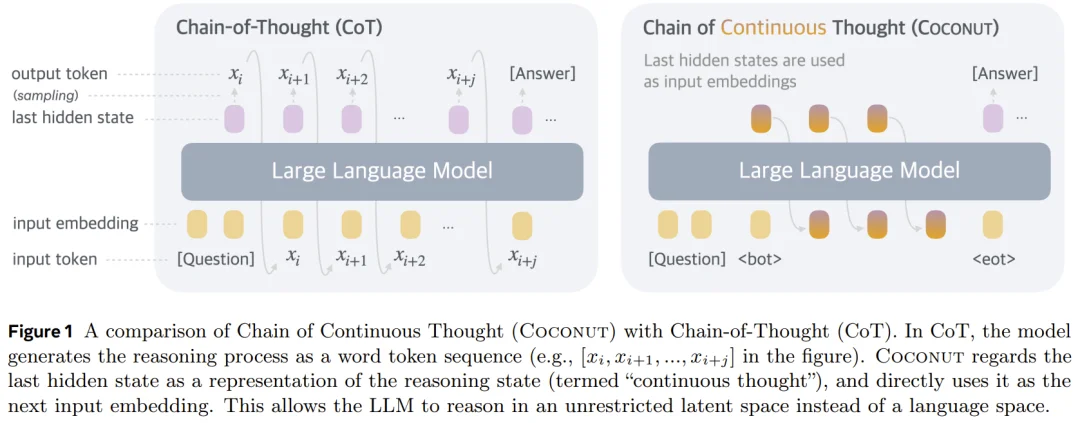
Partiendo de esta intuición, el equipo realizó deducciones teóricas y descubrió que la representación potencial podría ser una superposición de varias ideas. Utilizar esta representación podría proporcionar una ventaja significativa en problemas como el recorrido de grafos; «quizás no de tipo exponencial, pero al menos cierta ventaja».
¿Entonces, por qué los modelos de vanguardia aún no han adoptado cadenas de pensamiento continuas? Tanaka Masaaki ha dado dos razones.
- DatosGran parte del proceso de pensamiento humano se ha registrado en forma de lenguaje, pero no existe tal información en el espacio subconsciente.
- La representación potencial podría ser altamente personalizada.“Cada persona utiliza, en mayor o menor medida, sus propias formas de representación interna”, y la eficiencia de aprendizaje de los grandes modelos es mucho menor que la de los humanos, por lo que primero se debe recurrir al lenguaje como sustituto.
Ravid Shwartz-Ziv preguntó si esto es similar a los problemas de regularización que enfrentan los métodos de auto-supervisión como JEPA. Tanaka Masaaki estuvo de acuerdo y llevó el análisis un paso más allá: el descenso de gradiente podría estar atrapado en una especie de «óptimo local a nivel meta», y hay representaciones muy buenas que quizás no puedan ser aprendidas con los paradigmas de entrenamiento actuales. «Actualmente, no sabemos dónde están los límites».
En su opinión, esto es precisamente lo que...Estudio de la explicabilidadEl significado de esto es «igual que la diferencia entre la alquimia y la química». Solo que los modelos actuales son demasiado potentes, y todos están enfocados en los resultados; no hay suficientes personas ni tiempo dispuestos a dedicarse a este campo.
Después de escribir el último artículo en colaboración con GPT-5
Hablando de la transformación en la era de los grandes modelos, Tanaka Masaaki cree que el análisis de la dinámica del entrenamiento de redes neuronales que ha estado realizando desde 2018 se puede aplicar también a los grandes modelos, y que no ha habido una ruptura en los métodos utilizados. El verdadero impacto se ha producido a nivel empírico: los investigadores siguen proponiendo hipótesis, realizando experimentos y llegando a conclusiones, un proceso que no difiere esencialmente del de hace cien o doscientos años; sin embargo,A medida que el modelo se vuelve más fuerte, uno mismo es capaz de generar ideas.«Los investigadores podrían verse obligados a pensar a un nivel más general, en lugar de dedicar su tiempo a formular hipótesis específicas».
Al mismo tiempo,El estatus de la capacidad de ingeniería ha aumentado significativamente.En la era de los grandes modelos, mucho del buen trabajo implica «la mitad investigación y la mitad ingeniería». Sin embargo, con la aparición de los agentes de programación basados en IA, la situación ha cambiado: los investigadores con experiencia pueden hacer que estos agentes implementen rápidamente las ideas y identifiquen los problemas clave, «de repente adquieren superpoderes y pueden explorar cosas realmente profundas».
El punto de inflexión fue su último artículo en Meta, del cual fue el único autor. Este artículo investigaba las redes neuronales. grokking El fenómeno se refiere a que la red primero aprende de memoria y, después de un cierto período de entrenamiento, de repente adquiere la capacidad de generalizar.
Durante todo el proceso,Él trata a GPT-5 como un colaborador.Hazle preguntas, dale «tareas» para que demuestre teoremas, verifique si los teoremas son correctos y realicen brainstorming juntos.
El resultado esLa eficiencia ha aumentado aproximadamente de 6 a 10 veces.「Y eso es aún una estimación conservadora, porque en ese momento todavía estaba escribiendo el código yo mismo». Hoy en día, el código y la implementación también pueden ser entregados a potentes agentes inteligentes, lo que hará que el proceso sea aún más rápido.
Así surgió la frase con la que comenzamos. Tian Yuan Dong admite que los investigadores generalmente no quieren ser cofundadores en pequeñas empresas, ya que tienen que preocuparse por muchas cosas además de la investigación. «Pero creo que ahora estamos ante un cambio de fase; si no hago nada, podría no importar en el futuro».
El coanfitrión respondió medio en broma, diciendo que su forma de lidiar con la situación fue aprender a trabajar con las manos, pero lamentablemente «no soy bueno para eso».
El AI todavía no puede pensar en una buena solución.
Sin embargo, Tagawa Masaaki no cree que los humanos ya puedan retirarse.No creo que los modelos actuales puedan generar resultados de buena calidad sin ninguna intervención humana.Incluso en ese artículo escrito en colaboración con GPT-5, la idea general fue proporcionada por él, y no se dejó que el modelo la pensara por sí mismo.
Los humanos todavía tienen que ser responsables de:
- IniciarDecidir qué problemas merecen ser abordados
- Verificación¿Es confiable la solución propuesta por la IA?
Ravid Shwartz-Ziv mencionó que muchos trabajos recientes que involucran a agentes inteligentes realizando entrenamiento posterior y competiendo en Kaggle han revelado problemas como un espacio de ideas limitado y una tendencia a sobreajustarse a los indicadores (指标). Tian Yuan Dong cree que esto es, en cierta medida, temporal: los modelos son requeridos para manejar detalles pero carecen de contexto; si se les proporciona más información de fondo, podrían generar ideas más interesantes que simplemente ajustar los parámetros de optimización.
Pero también reconoce que agregar contexto es solo una «solución temporal». Los modelos actuales son buenos para tareas repetitivas, ya que los datos de Internet están llenos de este tipo de contenido;Si realmente queremos que el modelo salga de los límites establecidos, necesitamos una nueva arquitectura.“Para que pueda capturar nuevos señales rápidamente con muy poca información, necesitamos un cambio significativo en nuestro enfoque. Debemos pasar de un trabajo rutinario y repetitivo al siguiente nivel.”
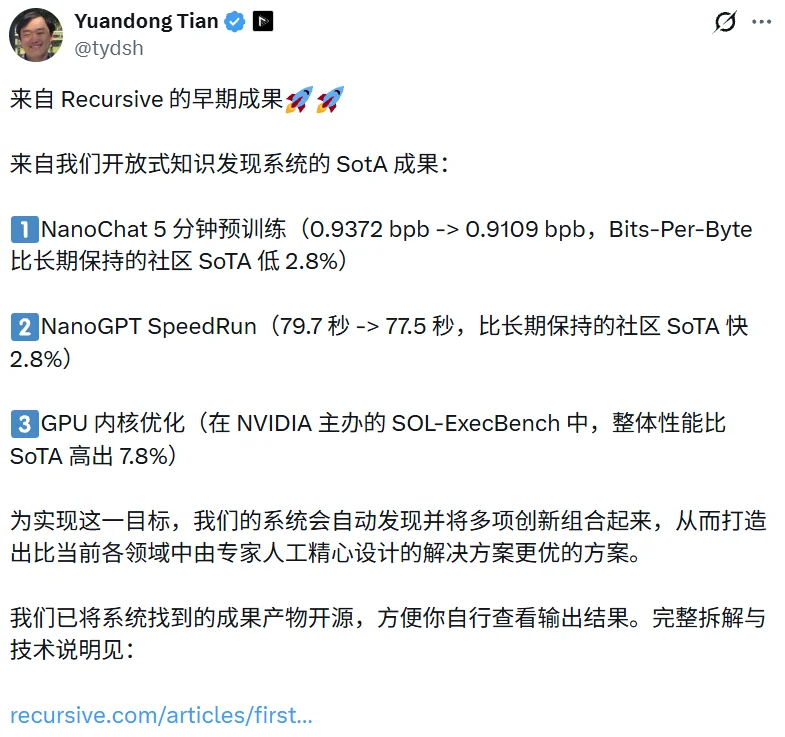
En el ciclo de investigación que consiste en «proponer ideas, escribir código, realizar experimentos y analizar los resultados», él cree queLo más difícil de automatizar son las ideas.Cuando se le preguntó sobre el logro de Recursive en el NanoGPT Speedrun, que consistió en reducir el tiempo de entrenamiento de 79.7 segundos a 77.5 segundos, si se trataba de un verdadero descubrimiento o simplemente de una búsqueda eficiente de técnicas ya existentes, la respuesta de Tadaoka Mifune fue «ambas cosas». Por ejemplo, la práctica de incorporar información de bigramas en el proceso de atención se puede encontrar en ideas similares en trabajos como DeepSeek, Gemma 3, y en los artículos de STEM en los que participó en Meta. Sin embargo, cómo utilizar diferentes tablas de inserción en diferentes capas y combinar estas ideas de manera creativa representa un nuevo enfoque.
¿Por qué las nuevas arquitecturas siempre «fallan» cuando se escalen?
Muchas empresas han propuesto arquitecturas alternativas al Transformer que han demostrado buen rendimiento en experimentos a pequeña escala, pero nunca han logrado ser escaladas a modelos de gran tamaño. La explicación de Tagaki Takahide es...Inducción de sesgoCuando el volumen de datos es pequeño, no hay suficiente información, por lo que es necesario introducir suposiciones estructurales adicionales, lo que naturalmente mejora los resultados; sin embargo, cuando el volumen de datos aumenta, lo mejor es dejar que el modelo encuentre las reglas por sí mismo. Citó el ejemplo de ViT: con datos del orden de ImageNet, ViT no es tan efectivo como las redes convolucionales, pero cuando el volumen de datos alcanza los cientos de millones, los Transformers superan en rendimiento.
Entonces, ¿cómo se debe verificar la nueva arquitectura?
Tian Yuan Dong cree que, por supuesto, es así.Comenzar a pequeña escalaPero lo clave es entender qué realmente está sucediendo dentro de la red; «necesitamos saber que existe alguna perspectiva que pueda ser aplicada a escalas más grandes, para tener confianza». De lo contrario, si simplemente seguimos ciegamente las leyes de escala, nunca podremos demostrar que lo que funciona a pequeña escala también funciona a gran escala. «El único resultado sería que las compañías con más capacidad de cálculo ganen».
El objetivo a más largo plazo en su mente esEncontrar una eficiencia de aprendizaje comparable a la de los humanosEl cerebro humano solo necesita una potencia de consumo de entre veinte y treinta vatios y muy poca información para comprender las cosas en un corto período de tiempo. En el campo de los robots, hoy en día se enfatiza la necesidad de grandes cantidades de datos, pero él considera que esto es solo un requisito del paradigma actual. “Mira a animales como gatos y perros; no necesitan tanta información, y sus procesadores son bastante simples, sin embargo, pueden sobrevivir en un mundo complejo. Eso debe significar que existen algoritmos nuevos”.Y el aprendizaje automático reforzado y la auto-mejora podrían ser el camino más rápido para llegar allí.
¿Restringir el auto-mejoramiento? «Los límites son demasiado vagos».
Al final del programa, el presentador abordó un tema de actualidad en el campo de la seguridad de la IA: algunas personas abogan por restringir los modelos más recientes y proponen la coordinación de la industria en relación con el autoperfeccionamiento recursivo.
La respuesta de Tanaka Miki fue muy directa: «Para ser honesto, creo que es muy difícil evitar que la gente haga esto». En su opinión, las fronteras son bastante difusas: cuando discutes nuevas ideas con un agente de programación y lo haces iterar, en cierto sentido estás mejorando; cuando colaboras con otros para escribir un artículo, también estás mejorando. Además, con los modelos open source que son cada vez más potentes, ¿se considera que usarlos en la investigación también es una forma de mejorar? ¿Y cómo deberíamos regular esto?
Él expresó claramente que...Los resultados de la investigación recursiva serán publicados como código abierto.Anteriormente, los artículos del blog de la empresa habían hecho disponible el código fuente completo del kernel y los planes de entrenamiento, permitiendo que el público los examinara y los utilizara como base para continuar el desarrollo. Sin embargo, él está más preocupado por otra situación: «Lo peor es que un pequeño grupo de élites controle los modelos más potentes del mundo y luego obligue a todos los demás a pagar precios exorbitantes por su uso».
Él es bastante optimista en cuanto a si los modelos open source podrán alcanzar a los modelos cerrados (propiedad de empresas).Él toma a Kimi como ejemplo y cree que ya es bastante útil, aunque el proceso de pensamiento puede ser un poco más largo. En su opinión, los agentes de programación no necesitan que un “AI Newton” o un “AI Einstein” venga a escribir el código por ellos; basta con que el modelo supere cierto umbral de calidad.
Los laboratorios de vanguardia ya han cruzado los límites, y los modelos abiertos (open source) también están haciendo lo mismo. «Una vez que lo hagan, serán comercializados, y todos usarán el modelo que prefieran».
Han pasado catorce años desde la discusión en Smith Hall sobre si AlexNet fue un mero «azar». El aprendizaje profundo, que fue cuestionado en aquel entonces, ahora ha comenzado a escribir sus propios artículos, a modificar código y a romper récords. Tanaka Masaaki ha decidido estar en la vanguardia de esta tendencia. En sus palabras, la verdadera pregunta que queda es: «¿Cómo podemos utilizar todos estos modelos para lograr cosas mejores y más significativas?»
El artículo proviene de "Machine Heart", escrito por "Panda".
Enlace del artículo:https://www.airai.cc/es/ai-news/60/
有用吗?