Vom Gedächtnis zur Selbstentwicklung: Ein entscheidender Schritt für Agenten auf dem Weg zur RSI
In letzter Zeit geben führende globale AI-Labore ein deutliches Signal ab:Künstliche Intelligenz entwickelt sich von der Unterstützung beim Erledigen von Aufgaben für Menschen hin zu einer aktiven Beteiligung an der eigenen Entwicklung und Verbesserung.
Im September kündigte OpenAI an, dass es das vorläufige Ziel der „automatisierten AI-Forschungspraktikanten“ erreicht hat, und plant, bis März 2028 echte „automatisierte AI-Forscher“ zu schaffen. Jakub Pachocki, der Chefwissenschaftler von OpenAI, veröffentlichte in derselben Zeit einen langen Artikel, in dem er die Entwicklungsperspektiven der rekursiven Selbstverbesserung (Recursive Self-Improvement, RSI) erörterte. Am 21. September stellte OpenAI die automatisierten AI-Forscher sowie die kontinuierliche Verbesserung der AI-Forschungs- und Entwicklungsfähigkeiten als wichtige strategische Richtungen für die nächste Phase vor.
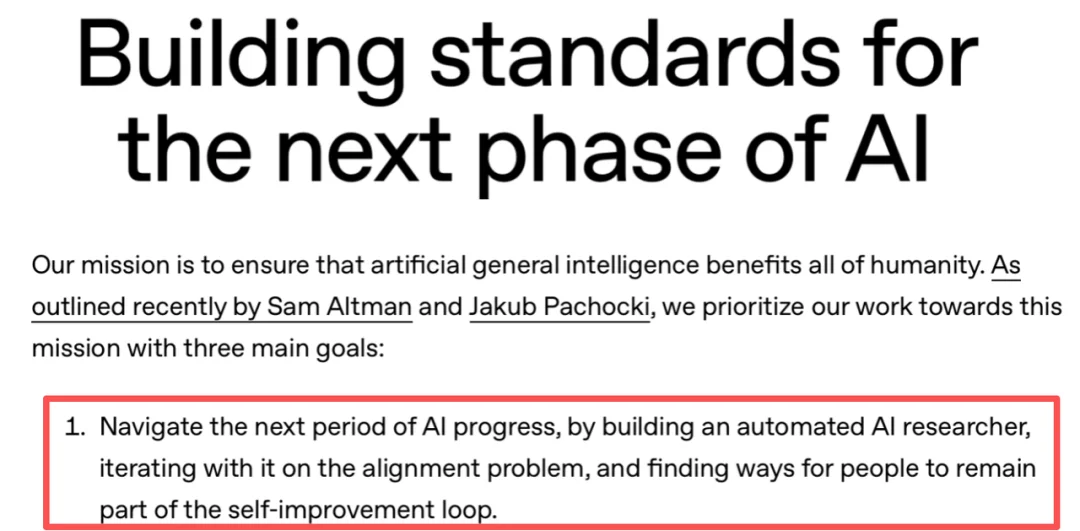
OpenAI veröffentlichte am 21. September 2026 eine offizielle Strategieerklärung, in der die Automatisierung von AI-Forschern sowie das rekursive Selbstverbessern als wichtige Ziele für die nächste Phase genannt werden.
Auf der anderen Seite hat auch Anthropic eine Gruppe von interessanten Daten veröffentlicht: Bis zum August dieses Jahres hat Claude bereits in etwa... 26 Prozent der internen AI-Forschungs- und Entwicklungsarbeiten übernehmen eine führende Rolle.Immer mehr Forschungs- und Entwicklungsarbeiten, die ursprünglich von Wissenschaftlern durchgeführt wurden, werden nun von KI unter menschlicher Aufsicht ausgeführt.
Von OpenAI zu Anthropic: RSI entwickelt sich von einer fernen technischen Vorstellung zu einem Kernthema in den Forschungs- und Entwicklungsprogrammen weltweit führender Labore. Künstliche Intelligenz (KI) ist nicht mehr nur ein Werkzeug zur Lösung externer Probleme, sondern beginnt auch, an der Entwicklung ihrer eigenen Fähigkeiten mitzuwirken.
Aber der entscheidende Schlüssel auf diesem ständig fortschreitenden Weg liegt darin:
Wie kann KI die früheren Erkundungen und Fehlschläge tatsächlich zu der Grundlage für den nächsten Fortschritt machen, anstatt jedes Mal bei der Bewältigung einer neuen Aufgabe von vorne anzufangen?
Erinnerung ist die Schlüsselbasis, die es dem Agenten ermöglicht, sich kontinuierlich selbst zu verbessern. Jeder Erkundungsvorgang hinterlässt nicht nur die Ergebnisse der jeweiligen Aufgabe, sondern auch Erfahrungen, die von nachfolgenden Aufgaben übernommen und wiederverwendet werden können. Dadurch besteht die Möglichkeit, die Fähigkeiten des Agents über die Grenzen einer einzelnen Aufgabe hinaus zu verbessern und durch kontinuierliche Akkumulation stetig weiterzuentwickeln.
01 | Von der Erfahrungssammlung zur kontinuierlichen Evolution:
Wie Erinnerung den RSI unterstützt
Um sicherzustellen, dass der Agent seine Fähigkeiten während der kontinuierlichen Ausführung ständig verbessert, ist es entscheidend, dass Erfahrungen über einzelne Aufgaben hinausgetragen werden:Effektive Methoden, die aus früheren Erkundungen hervorgegangen sind, werden in neuen Aufgaben genau angewendet, und anhand der Ausführungsergebnisse werden sie kontinuierlich korrigiert und optimiert. Darin übernehmen die Speicherung und Wiederherstellung von Informationen zwei miteinander verbundene Schlüsselprozesse.
Um Erinnerungen schreiben zu können, muss man aus komplexen Ausführungspfaden effektive Methoden, Fehlschlussfolgerungen sowie deren Anwendungsbedingungen identifizieren, damit vergangene Aufgaben tatsächlich wiederverwendbare Erfahrungen hinterlassen. Bei der Abrufung von Erinnerungen ist es hingegen notwendig, auf Basis der Anforderungen neuer Aufgaben die entsprechenden historischen Methoden und Schlüsselbelege genau zu finden, um Erfolgsvergesslichkeiten und Fehlübertragungen zu vermeiden.
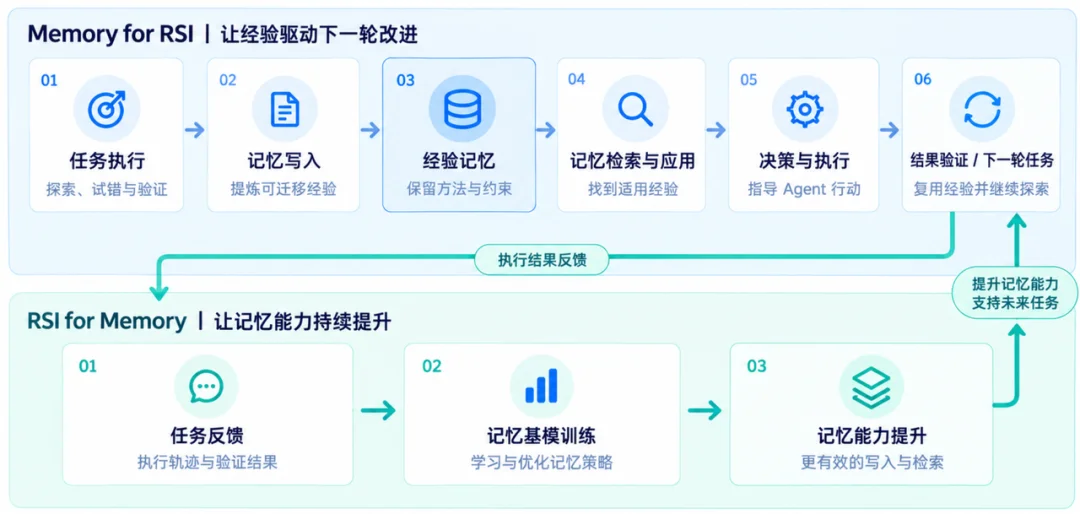
Weiterhin können die Rückmeldungen zur Aufgabe auch den tatsächlichen Wert der Erfahrung überprüfen. Durch die kontinuierliche Aktualisierung des Inhalts des Gedächtnisses und die Anwendung effektiver Rückmeldungen beim Training des Grundmodells des Gedächtnisses wird die Fähigkeit des Gedächtnisses selbst verbessert, was zu einem Prozess führt, in dem sich die Erfahrungssammlung und die Verbesserung des Agents gegenseitig fördern.
02 | Das Lernen und die Evolution der Erinnerung:
Lassen Sie den Agent durch seine Erfahrungen kontinuierlich stärker werden.
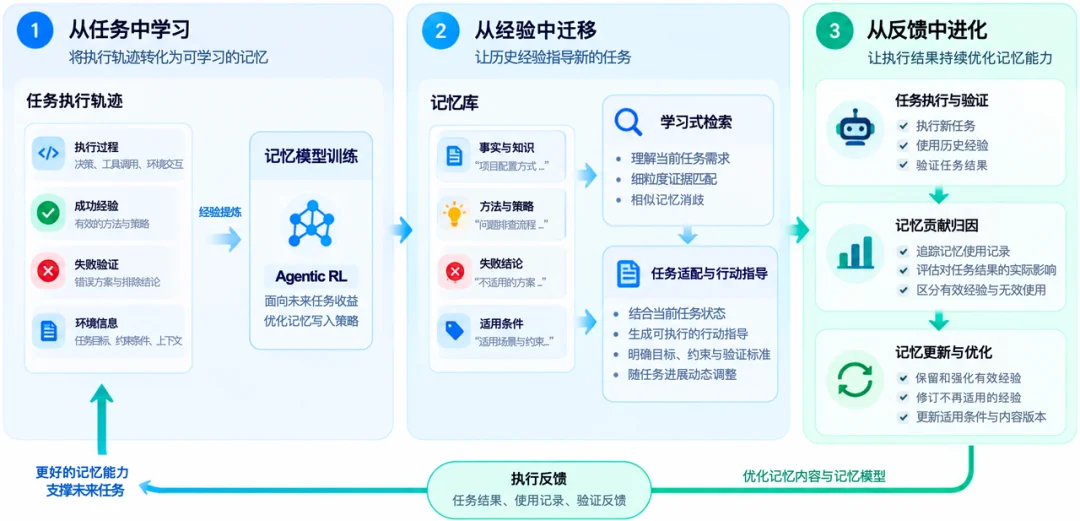
Aufgrund der Erfahrungssammlung in Agent RSI, der Notwendigkeit der Aufgabenübergreifenden Wiederverwendung und der kontinuierlichen Verbesserung, hat MemoraX ein System entwickelt, das auf diesen Prinzipien basiert.Erlerntes Wissen anwenden, Erfahrungen übertragen und durch Feedback optimierenEin auf kognitiven Fähigkeiten basierendes Gedächtnissystem, das durch die Erstellung hochwertiger Gedächtnisdaten, die dynamische Organisation des Gedächtnisses sowie die Optimierung auf Grundlage von tatsächlichen Aufgabenergebnissen funktioniert. Es trainiert kontinuierlich das Grundmodell des Gedächtnisses, damit der Agent aus historischen Erfahrungen lernen und seine Entscheidungsfindung sowie Ausführung ständig verbessern kann.
Lernen aus der Aufgabe: Erfahrungssammlung als optimierbare Modellfähigkeit nutzen
Während der Ausführung der Agent-Aufgaben entstehen kontinuierlich neue Erkenntnisse durch die Überprüfung der Ergebnisse und die Anpassung der Strategien.Erfolgreiche Entscheidungen bieten für nachfolgende Aufgaben wiederholbar anwendbare Methoden, während überprüfte Fehlschlussfolgerungen dem Agenten helfen, ungültige Optionen auszuschließen und das Wiederholen von Fehlversuchen zu reduzieren.Aber der Wert der Erfahrung zeigt sich oft erst in späteren Aufgaben. Die genaue Zusammenfassung der Vergangenheit bedeutet nicht unbedingt, dass sie auch in der Zukunft effektiv unterstützen kann. Daher erfordert der Prozess des Lernens aus Erfahrungen nicht nur die Identifizierung von Erfahrungen, die bewahrt werden sollten, sondern auch die Aufbewahrung der Beweise dafür, der Rahmenbedingungen und der Anwendungsbedingungen, um zu vermeiden, dass Erfahrungen übersehen oder fälschlich verwendet werden. Dies ist weit mehr als eine einfache Zusammenfassung oder Komprimierung von Informationen.
Angesichts dieser Herausforderung hat MemoraX... Erinnern Sie sich in Strategien, die für zukünftige Aufgabenerträge ausgerichtet sind, und bauen Sie kontinuierlich ein umfassendes System auf, das Umgebungskonstruktion, Datenerfassung, Samplekonstruktion und skalierbares Agenten-RL-Training umfasst.In einer interaktiven und verifizierbaren Aufgabenumgebung werden Ausführungstrajektorien, Nutzungshistorien sowie Validierungsfeedback gesammelt, um Trainingsbeispiele für Entscheidungsprozesse und die anschließende Nutzungseffektivität zu erstellen. Anschließend werden Belohnungssignale anhand der Qualität der Erledigung der nachfolgenden Aufgaben, der Ausführungseffizienz sowie der Anzahl der Wiederholungsversuche entwickelt, um die Strategie der Speicherung dieser Informationen zu optimieren. Dieser Prozess erweitert das Optimierungsziel des Modells von der Genauigkeit der Informationsauswahl auf weitere Aspekte.Die tatsächliche Auswirkung der Erinnerung auf die Qualität nachfolgender Aufgaben, die Ausführungseffizienz und das Wiederholen von FehlversuchenLernen ist besonders vorteilhaft für die Entwicklung von Strategien zur Speicherung von Informationen für zukünftige Aufgaben.
Aus Erfahrung lernen: Lassen Sie historische Erfahrungen neue Aufgaben leiten
Erfahrungen können gespeichert werden, was jedoch nicht bedeutet, dass sie in neuen Aufgaben wirksam sind. Angesichts unterschiedlicher Aufgabenziele, Umweltbedingungen und Ausführungsphasen muss der Agent die entsprechenden historischen Methoden genau erkennen, um Störungen durch irrelevante Informationen und Fehlübertragungen von Erfahrungen zu vermeiden.
Dafür wird MemoraXDecoupling memory content from access structureDie Zugriffspunkte im Gedächtnis und die damit verbundenen Beziehungen werden dynamisch an die aktuellen Aufgaben angepasst, damit dieselben historischen Informationen unterschiedlichen Anforderungen entsprechen können.
Auf der Ebene der Suche geht es weiter…Durch das Training des Modells wird die Verbindung zwischen den Anforderungen der aktuellen Aufgabe und historischen Schlüsselbelegen erlernt.Kombinieren Sie die Identifizierung von detaillierten Beweisen mit der Unterscheidung ähnlicher Erinnerungen, um die Fähigkeit zur Lokalisierung wichtiger Erfahrungen zu verbessern und zwischen „thematisch relevant“ und „Beweise korrekt“ zu unterscheiden.
Im Abschnitt der praktischen Anwendung kombiniert MemoraX den aktuellen Zustand der Aufgabe mit dem Fortschritt der Ausführung.Die historisch angesammelten allgemeinen Erfahrungen in konkrete Handlungsanweisungen umwandeln, die klare Ziele, operative Einschränkungen und Überprüfungsstandards aufweisenUnd passt sich dynamisch den verschiedenen Phasen der Aufgabe an, damit historische Erfahrungen tatsächlich in die Entscheidungsfindung und Ausführung des Agents einfließen können.
Evolution aus den Rückmeldungen: Die Ausführungsergebnisse tragen zur kontinuierlichen Verbesserung der Gedächtnisleistung bei
Im kontinuierlichen Iterieren des RSI sind historische Erfahrungen nicht immer wirksam. Neue Aufgaben können entweder bestehende Methoden bestätigen oder ihre Grenzen aufzeigen.Wie man die echte Wertigkeit von Erfahrungen anhand der Ausführungsfeedback beurteilt und darauf basierend das Gedächtnis kontinuierlich optimiert, ist ein wichtiger Bestandteil der kontinuierlichen Selbstverbesserung.
Die zentrale Herausforderung dabei ist Memory Credit AssignmentLangezeitige Aufgaben können auf mehrere historische Erfahrungen zurückgreifen, aber welche davon tatsächlich die Entscheidungen des Agenten beeinflusst haben und welche nur gelesen wurden, ohne eine Wirkung zu zeigen, bleibt eine Frage, die gelöst werden muss. Selbst wenn die Aufgabe letztendlich erfolgreich ist, ist es immer noch schwierig, den tatsächlichen Beitrag der verschiedenen Erinnerungen zu beurteilen.
Angesichts dieser Herausforderung wird MemoraXAssoziation zwischen den Memory-Versionen, den tatsächlichen Nutzungsdaten und den Feedback-Meldungen zur Ausführung der Aufgaben herstellenEs wird überprüft, ob die historischen Erfahrungen tatsächlich in die Aktionen des Agenten eingeflossen sind, sowie wie sich die Aufgaben nach deren Anwendung und die Ergebnisse der Überprüfung entwickelt haben. Auf dieser Grundlage werden die vorhandenen Erinnerungen kontinuierlich bewertet und weiterentwickelt.Effektive Erfahrungen sollten erhalten und verstärkt werden, und auf Basis neuer Aufgabenfeedback sollte unanwendbare Erfahrungen rechtzeitig korrigiert werden.
Diese echten Rückmeldungen tragen ebenfalls dazu bei…Kontinuierliches Training von Basismodellen des GedächtnissesEs wurden eine Datenbasis sowie Optimierungssignale bereitgestellt, die die Verbesserung des Gedächtnisses von einer Aktualisierung auf inhaltlicher Ebene weiter ausdehnen, bis hin zum Lernen der Erfahrungswerte und Gedächtnisstrategien durch das Gedächtnismodell.
03 | Von der Erfahrungssammlung zur Fähigkeitssteigerung:
Praktische Anwendung des RSI in verschiedenen Szenarien bei MemoraX
Für Agent RSI ist es nicht nur wichtig, wie gut die Ergebnisse einer einzelnen Mission sind, sondern vielmehr...Kann historische Erfahrung kontinuierlich angesammelt und korrigiert werden, um im Laufe nachfolgender Aufgaben weiterhin Wert zu schaffen?
Im Rahmen dieses Prozesses wurden die Fähigkeiten zur kontinuierlichen Iteration von Erfahrungen, zur Übertragung von Fähigkeiten zwischen verschiedenen Aufgaben sowie zur Optimierung durch Feedback in drei Kategorien von Aufgaben überprüft: langfristige, komplexe Programmierung, Finanzanalyse und komplexe mathematische Schlussfolgerungen. Zudem wurde untersucht, wie das Gedächtnis die Qualität und Effizienz des Agents bei langfristigen Aufgaben verbessert.
(1) Langfristige, komplexe Programmierung: Von der iterativen Anwendung von Erfahrungen zur Steigerung der Fähigkeiten in komplexen Projekten
Lange, komplexe Coding-Experimente werden in Bereichen wie Kommunikation, Finanzen und Logistik durchgeführt. In 5 major industries and 13 industrial-grade system development projects, a total of 78 development runs were conducted, with a combined development time of over 300 hours, with the longest single run exceeding 12 hours. As a result, the adoption rate of the MemoraX memory enhancement solution increased by more than 20%, and the cumulative Token consumption of the main Coding Agent was reduced by more than 20%.
Vom Erwerb von Erfahrungen zur rekursiven Verbesserung: Der Weg der Selbstiteration des Gedächtnisses
Um das Problem zu lösen, dass traditionelle statische Speichermethoden es schwierig machen, während der Ausführung von Aufgaben kontinuierlich Erfahrungen anzusammeln und zu optimieren, hat das MemoraX-Team vorgeschlagen...Memory Model–Driven RSI (MMD-RSI) MethodeDurch die Kollaboration zwischen einem selbst entwickelten Gedächtnismodell und dem Agent-System übernimmt das spezielle Gedächtnismodell die Aufgabe, aus den Ausführungspfaden der Agenten sowie den Online-Einschätzungen programmatische Erinnerungen zu extrahieren und zu aktualisieren. Das Agent-System wendet diese Erinnerungen anschließend auf tatsächliche Aufgaben an, wodurch ein geschlossener Kreislauf aus Erfahrungsauswertung, Aufgabenanwendung, Effektüberprüfung und Gedächtnisaktualisierung entsteht. Dadurch können effektive Erfahrungen kontinuierlich angesammelt, optimiert und für zukünftige Aufgaben genutzt werden. In den Trainingsbeispielen, die aus langfristigen Coding-Aufgaben bestehen,Nach mehreren Runden der Optimierung der Gedächtnisiteration hat sich die Qualität des programmierbaren Gedächtnisses um mehr als 10% verbessert.
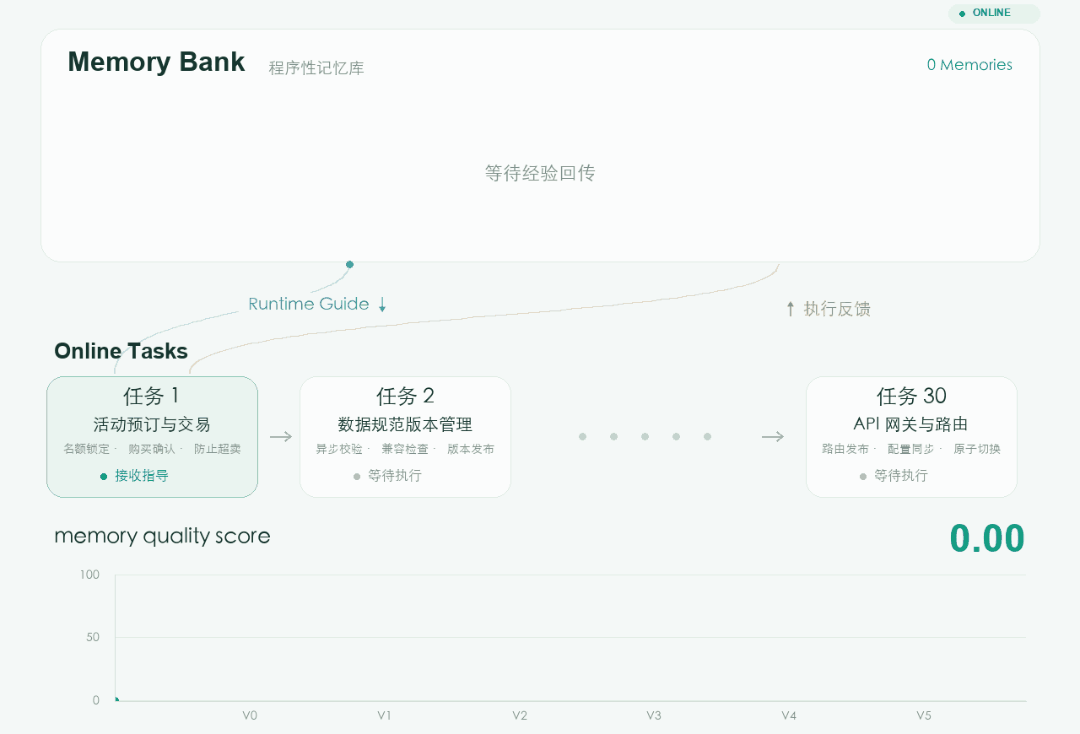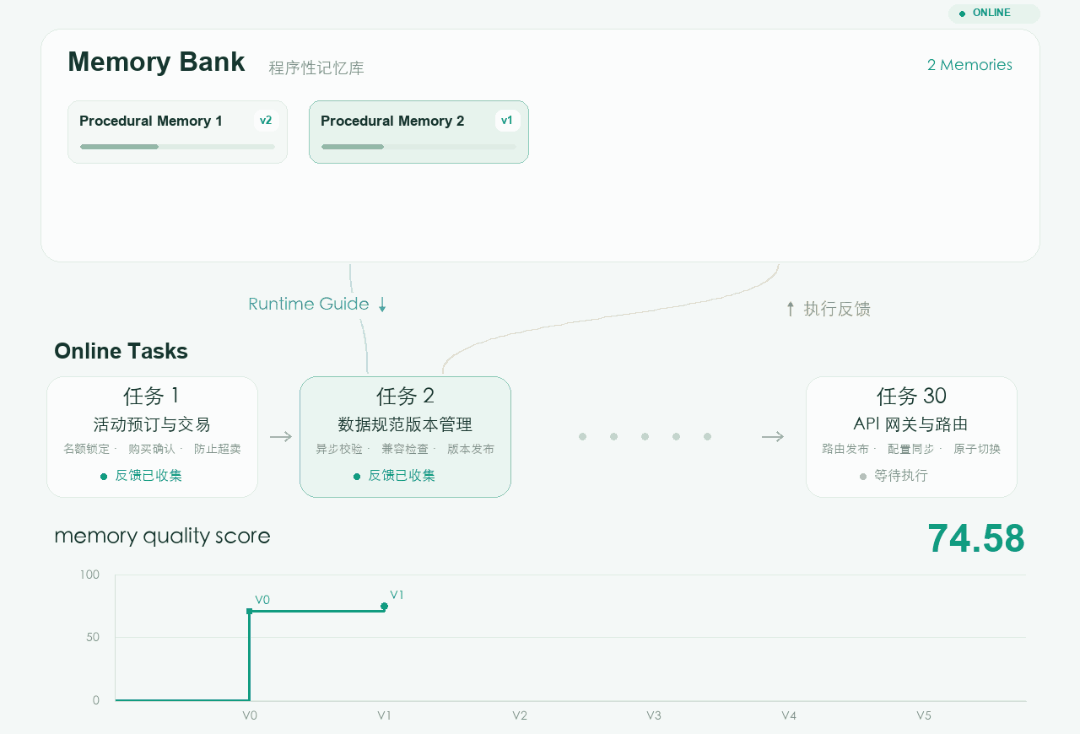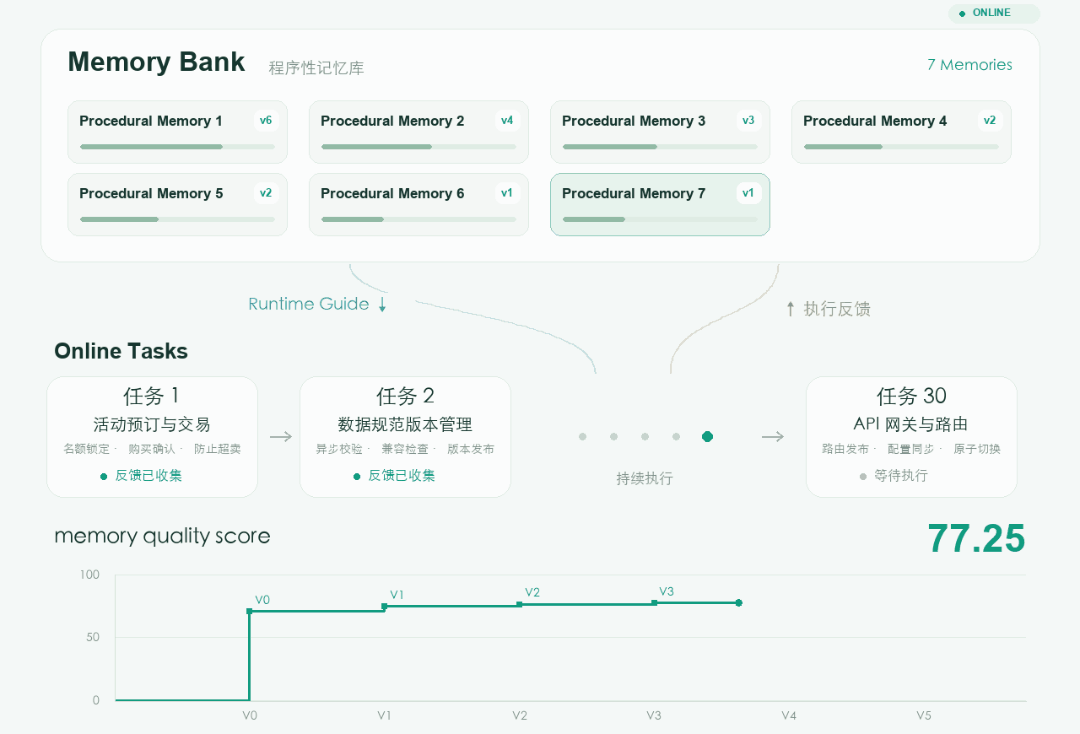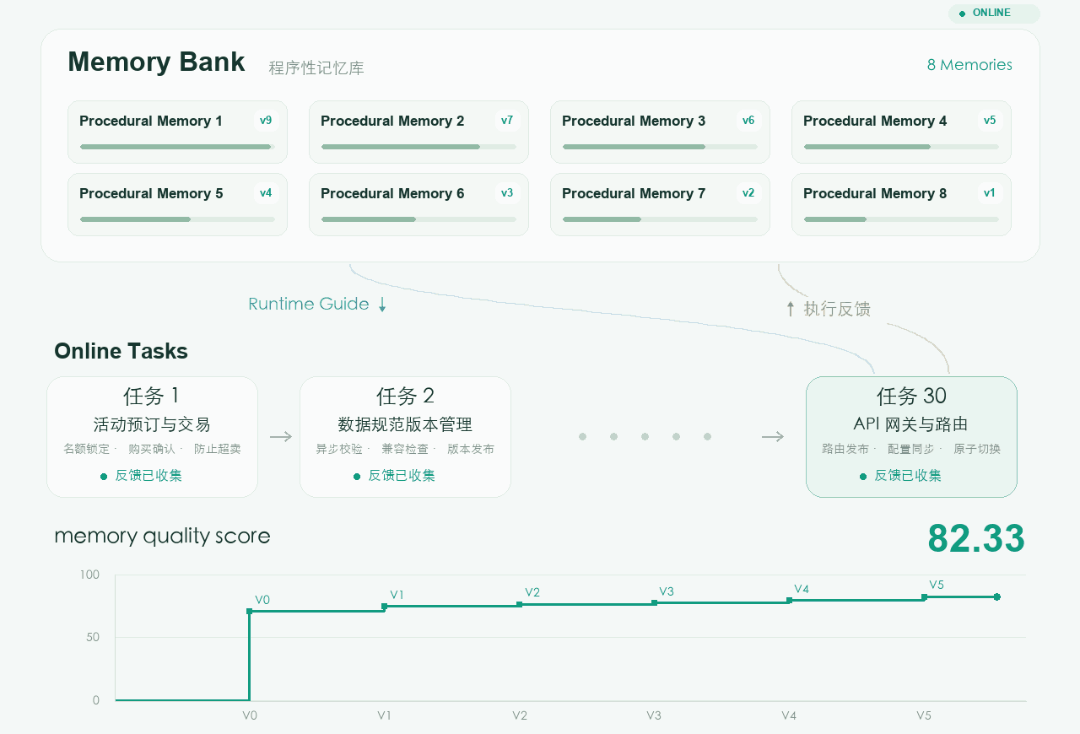
Mit der Erfahrung aus wiederholten Iterationen stelle ich mich der Herausforderung der Entwicklung eines komplexen Projekts mit einer Dauer von 335 Stunden.
Wie viel Nutzen kann die angesammelte Erfahrung bei der Bewältigung neuer technischer Herausforderungen leisten, wenn sie sich von den ursprünglichen Lernaufgaben entfernt hat?
Dafür wird die bereits angesammelte Erfahrung auf komplexe neue Entwicklungsprojekte angewendet.Bei 13 komplexen Softwareentwicklungsprojekten wurden insgesamt 78 Entwicklungsvorgänge durchgeführt, mit einer Gesamtentwicklungszeit von über 335 Stunden. Die längste einzelne Entwicklungsdauer betrug mehr als 12 Stunden.Diese Aufgaben gehen weit über einfache Codeanpassungen hinaus und stellen echte ingenieurtechnische Herausforderungen dar, die komplexe Geschäftslogiken, modulübergreifende Abhängigkeiten sowie umfangreiche Tests beinhalten.
Letztendlich stieg die Durchsatzrate um mehr als 20%, während die gesamte Token-Nutzung des Coding Agents um mehr als 20% reduziert wurde.
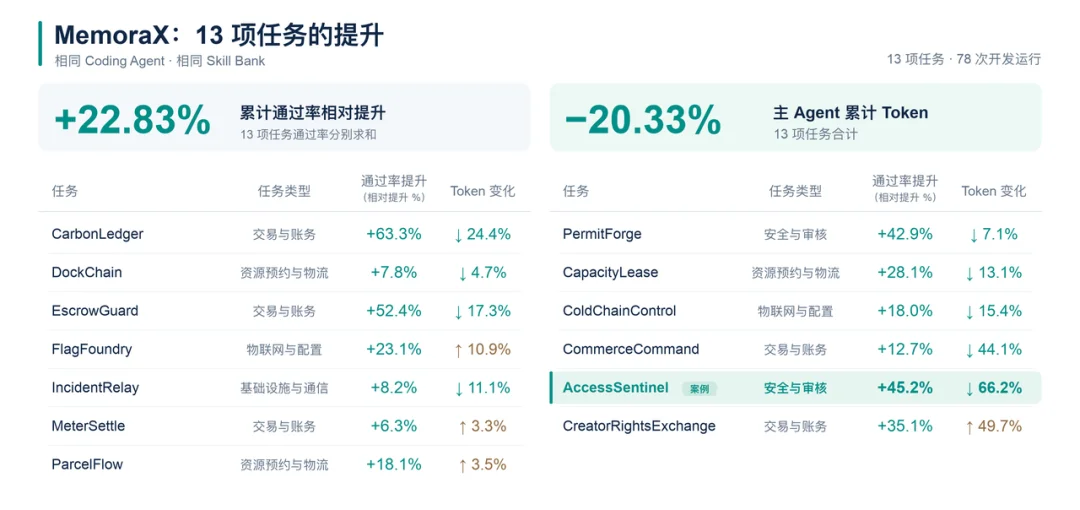
Unter diesen Fällen ist AccessSentinel ein repräsentatives Beispiel für eine besonders schwierige Herausforderung. Der Agent muss ein umfassendes, unternehmensweites Berechtigungssystem entwickeln und sicherstellen, dass...Strenge Sicherheitsvorgaben。
Mit der Hilfe des Gedächtnismodells,Historische Erfahrungen dienen nicht mehr nur als statische Informationsquellen, sondern können sich mit dem Verändern des Zustands der Aufgabe kontinuierlich an der Ausführung und Überprüfung des Agents beteiligen.Von der 43. Minute nach dem Start der Entwicklung bis zu 2 Stunden und 30 Minuten später werden die Erinnerungen an verschiedene Schlüsselpunkte aufgezeichnet.Aktiv anbietenZielgerichtete Anleitung:
- Wenn die Geräteberechtigungen entzogen werden,Es soll nicht nur verhindert werden, dass das Gerät erneut eingeloggt wird, sondern auch sichergestellt werden, dass bereits eingeloggte Konten nicht weiterhin auf das System zugreifen können.
- Wenn die Sicherheitsrichtlinie auf eine ältere Version zurückgesetzt wird,Sowohl die historischen Aufzeichnungen müssen erhalten bleiben als auch verhindert werden, dass bereits entzogene Berechtigungen versehentlich wiederhergestellt werden.
- Beim Batch-Verarbeiten von Anträgen,Zuerst müssen alle Anträge auf ihre Erfüllung der Anforderungen überprüft werden. Erst wenn alle Anträge genehmigt sind, kann die Maßnahme einheitlich umgesetzt werden, um zu vermeiden, dass einige erfolgreich und andere fehlschlagen.
Während des Tests,Die durchschnittliche Erfolgsrate bei den drei Ausführungen hat sich um mehr als 45% verbessert, während der gesamte Tokenverbrauch des Haupt-Coding-Agenten um mehr als 66% reduziert hat.
(2) Komplexe Finanzanalyse: Von der Sammlung von Beweisen bis zur unabhängigen, kontinuierlichen Verbesserung
Finanzforschung erfordert die Zusammenstellung vollständiger und zuverlässiger Analysen aus einer großen Menge an verstreuten Materialien. Neben der Suche nach relevanten Daten muss der Agent auch in komplexen Kontexten die betreffenden Akteure, Zeiträume und statistischen Methoden genau verstehen, Zusammenhänge zwischen verschiedenen Beweisen herstellen und vermeiden, dass fehlende Informationen oder verwirrende Definitionen die endgültigen Schlussfolgerungen beeinflussen.
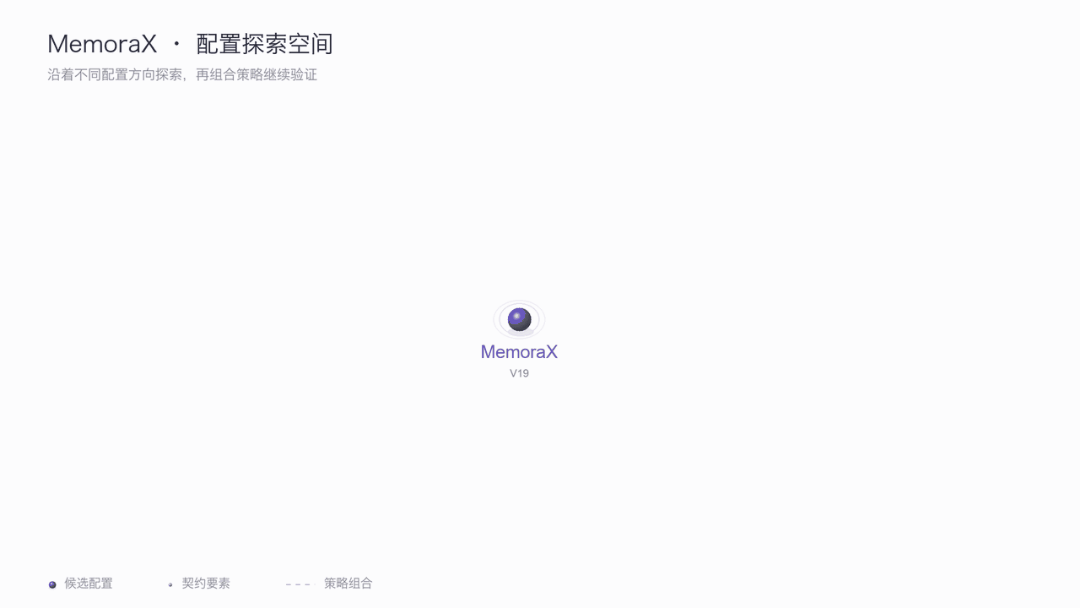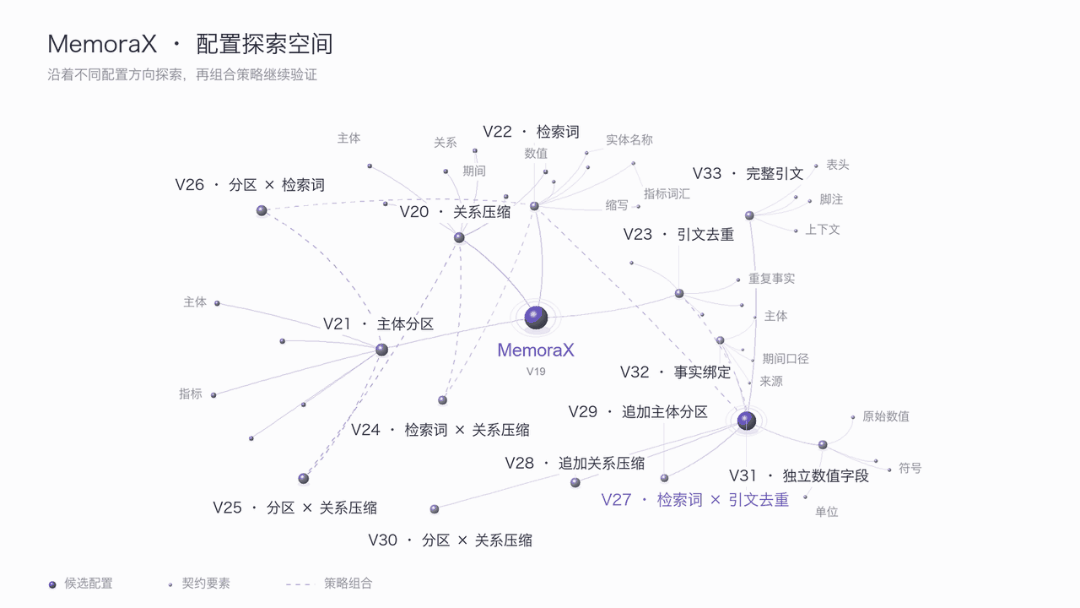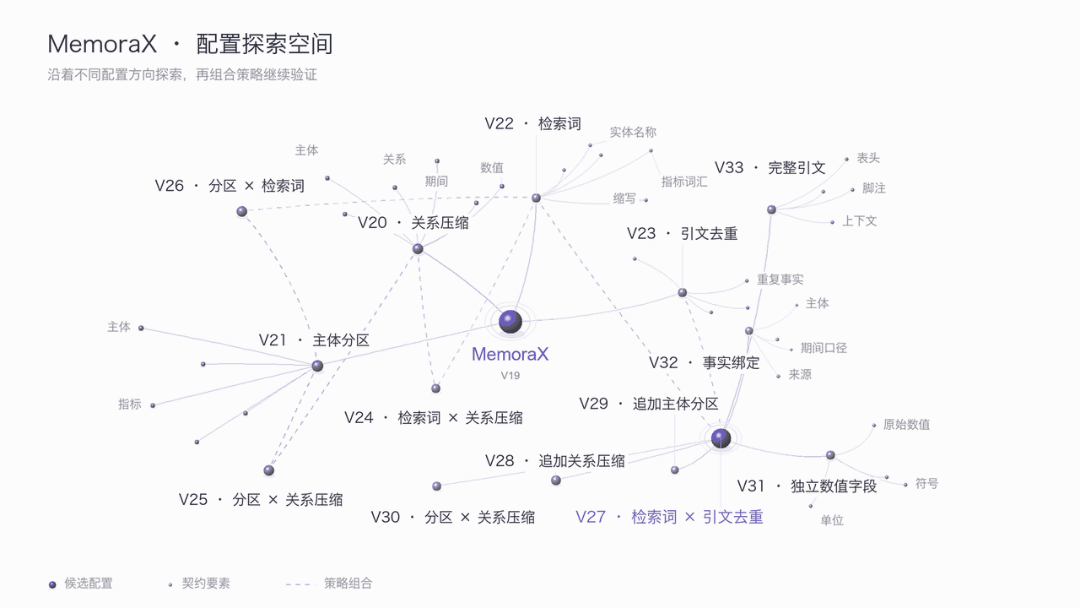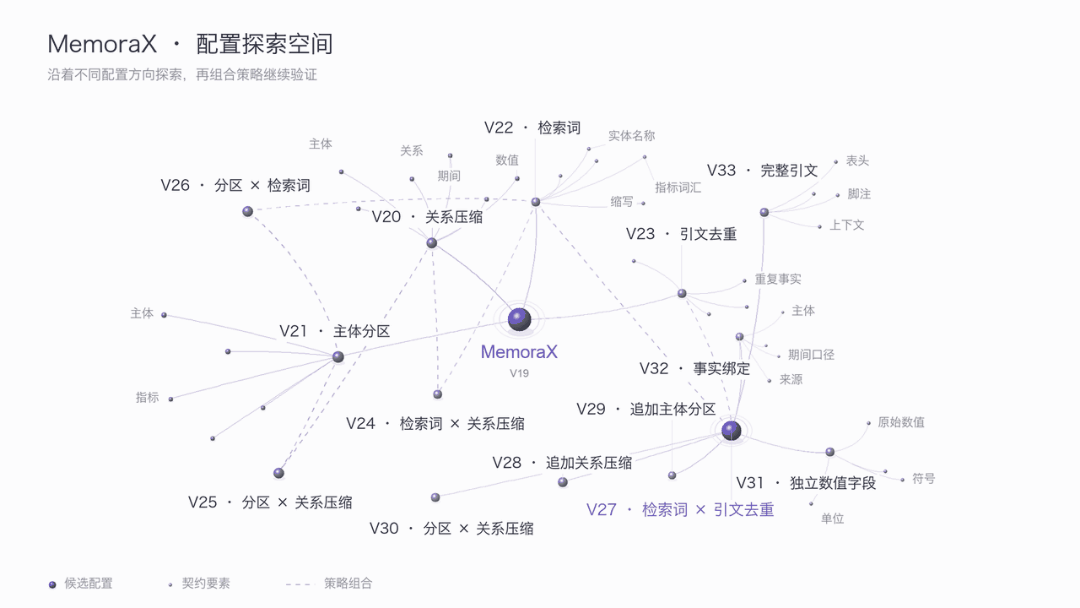
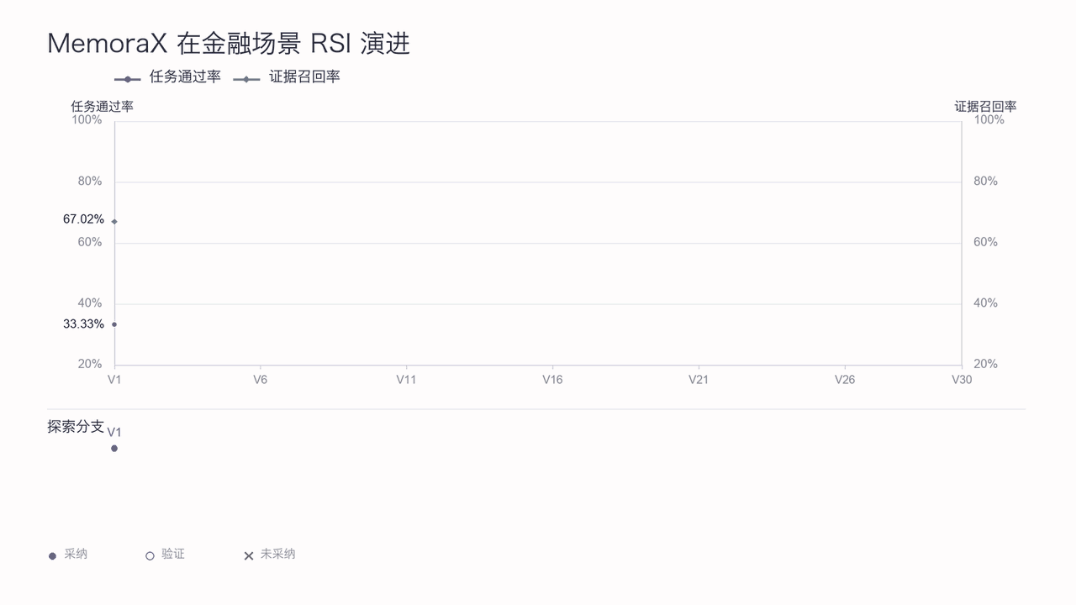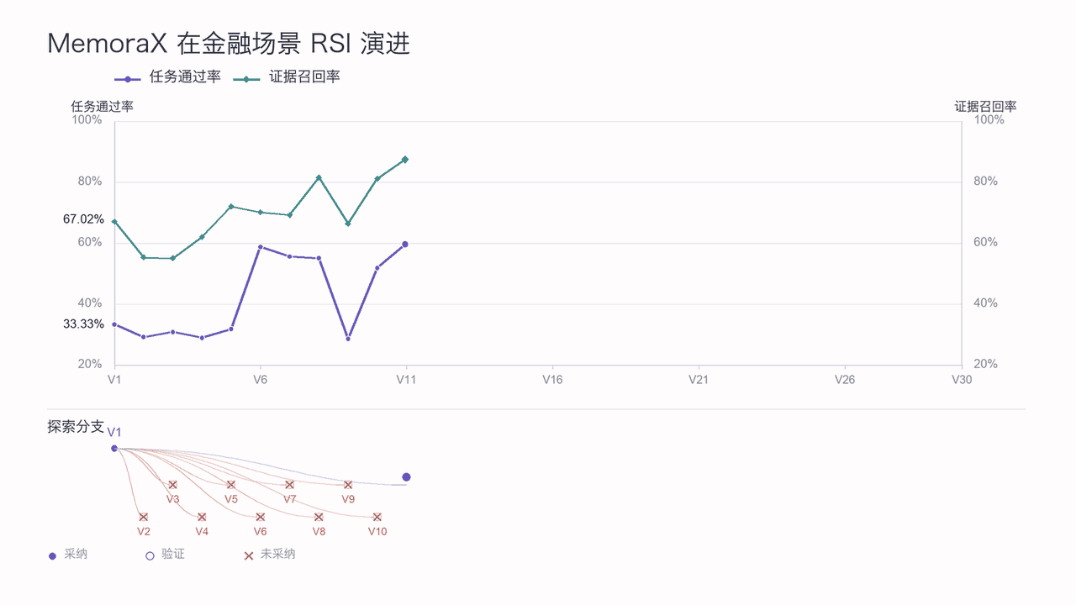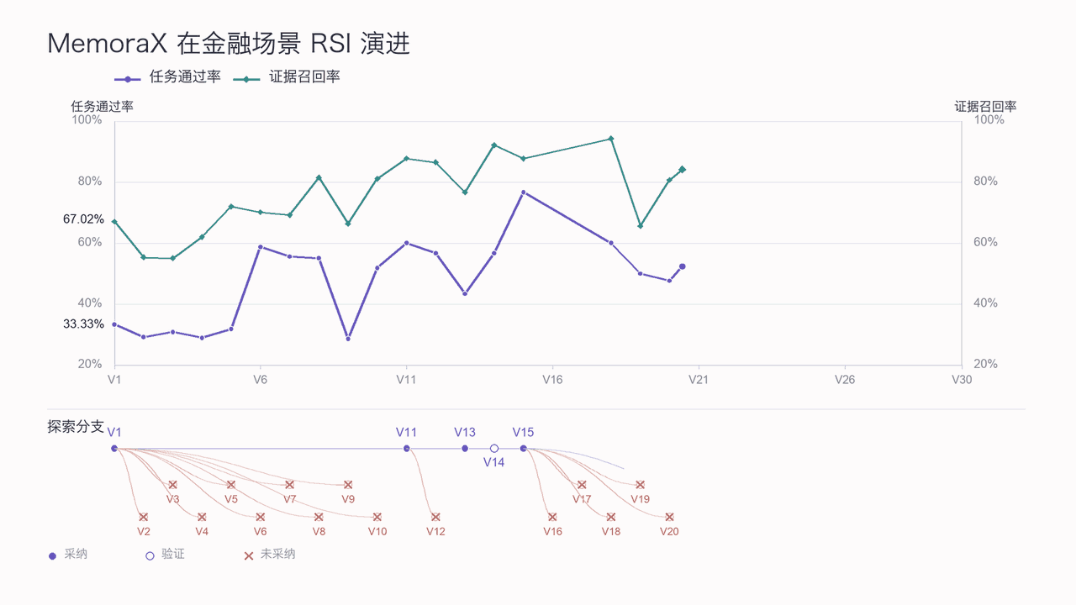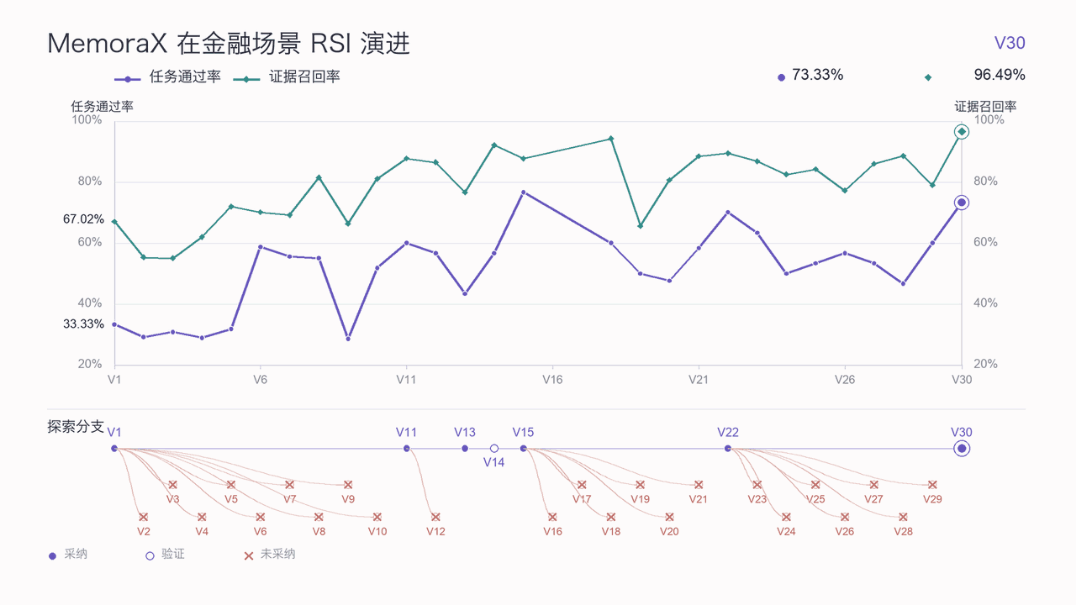
MemoraX konzentriert sich auf zwei miteinander verbundene Probleme:Wie kann man Beweise so nutzen, dass sie eine vollständige Antwort stützen, und wie kann man die Fragen aus der Antwort nutzen, um die Speicherung und Suche nach Beweisen weiter zu verbessern?Dafür führt MemoraX Experimente unter Verwendung des autoritativen Finanzbenchmarks FinRank durch, der reale Finanzberichte von 22 amerikanischen Unternehmen aus den Branchen Pharmazie, Öl und Gas sowie Automobilwesen umfasst und eine große Menge an komplexen Finanzdaten aus verschiedenen Unternehmen und Zeiträumen abdeckt. Um diese Aufgaben zu bewältigen, optimiert MemoraX kontinuierlich die Organisation und den Abruf von Informationen mithilfe von Feedback aus den durchgeführten Aufgaben, wodurch ein iterativer Kreislauf von „Ausführung – Feedback – Verbesserung der Speicherung – erneute Ausführung“ entsteht. Mehr als 30 koordinierte Iterationen zwischen dem Gedächtnismodell und dem Finanzanalysesystem, am EndeDie Rückrufrate der Beweiskette liegt nahe bei 100%, was eine Steigerung der Genauigkeit um 20% im Vergleich zu den CodeX-Aufgaben bedeutet und die Kosten um fast 98% senkt.
Vom Finden der Daten bis zur Organisation von Beweisen, die eine fundierte Entscheidung ermöglichen
Als Beispiel für eine Finanzanalyseaufgabe in einem großen Herstellungsunternehmen sind die relevanten Beweismittel über verschiedene Materialien aus derselben Branche verteilt, die dreijährige Finanzberichte, Angaben von Zulieferern und Risikobeschreibungen enthalten. Allein anhand von Schlüsselwörtern oder semantischer Ähnlichkeit ist es leicht, Inhalte zu finden, die thematisch relevant sind, aber nicht zum Zielunternehmen oder zum Berichtszeitraum gehören; wenn nur Zusammenfassungen behalten werden, können wertvolle Informationen wie die Wertangaben und die Bedingungen für das Bestehen von Risiken verloren gehen.
Dafür wandelt MemoraX zunächst die Kontextmaterialien in strukturierte Erinnerungen um und passt die Organisation der Erinnerungen iterativ anhand der Antwortfeedback an, um eine Lösung für Finanzfragen zu entwickeln, die sowohl...Präzise Zahlenwerte, ausgerichtete Darstellung und nachvollziehbare HerkunftDie Ausgabe des Merkmodells der Erinnerung wird verwendet; bei der Suche werden diese Beweise erneut in Bezug auf das aktuelle Problem herangezogen, um den aktuellen Bestand, die Beschaffungsstruktur und die potenziellen Risiken zusammenzubewerten. Diese Organisationsmethode berücksichtigt die Anforderungen von Finanzaufgaben.Genaue Zahlenwerte, konsistente Angaben und nachvollziehbare QuellenDie Anforderungen der Kunden.
Die Genauigkeit der Abschlussaufgaben von MemoraX hat im Vergleich zu Codex verbessert.Fast 20%Darüber hinaus beträgt die Kosten dieses Plans auf Basis der tatsächlichen API-NutzungIm Vergleich zum Codex-Referenzplan wurden die Kosten um fast 98% reduziert. Gleichzeitig wurde eine höhere Durchfallrate erreicht.
Vom Feedback auf die Antworten bis zur Strategieiteration: Verbessern wir das Gedächtnis – „Wie speichert man etwas und wie findet man es wieder?“
MemoraX untersucht auf Grundlage von Feedback zu den Aufgaben kontinuierlich neue Methoden zur Auswahl und Organisation von Informationen im Gedächtnis in Bezug auf fehlende Beweise, verwechselte Zusammenhänge und redundante Verweise, und sammelt diese Erkenntnisse während der Trainingsaufgaben an.Interaktionsbeispiele, die die Entscheidungsfindung bezüglich der Schreibweise, den gespeicherten Inhalt und die anschließenden Nutzungsergebnisse verbinden,Zur Optimierung von Memoriemodellen wird das trainierte Modell in eine neue Aufgabe eingesetzt. Die Ausführungsfeedbacks dieses Modells werden weiterhin genutzt, um die Schreibstrategie und die nachfolgende Trainingsprozesse zu verbessern, wodurch eine sich gegenseitig verstärkende RSI-Schleife (RSI: Recurrent Self-Improvement) entsteht. In diesem Prozess entwickelt sich das Modell schrittweise weiter.Adaptation to the Memory Representation Characteristics of Financial ScenariosKritische Werte sollten mit den entsprechenden Anwendungsbedingungen verknüpft und gespeichert werden, um unterschiedliche Akteure, Berichtsperioden und Quellen voneinander zu unterscheiden. Zudem sollte eine Korrelation zwischen den Fakten und den entsprechenden Beweisen im Originaltext hergestellt werden. Nach 36-Wiederholungen des RSI-Iterationsverfahrens,MemoraX Die Beweisrückrufrate erreichte 96,49%, und die Genauigkeit der Aufgabe stieg von 33,33% auf 73,33%.
Für Forscher, die langfristig Finanzberichte und Ankündigungen verfolgen müssen, kann das aus derselben Materialgruppe aufgebaute Wissen verschiedenen Fragen dienen und die anfänglichen Investitionen verteilen; die Rückmeldungen aus späteren Analysen können wiederum dazu beitragen, den Inhalt des Wissens und die Strategien seiner Anwendung zu korrigieren.Machen Sie die Antworten vollständiger, die Nutzung wirtschaftlicher und ermöglichen Sie eine kontinuierliche Akkumulation von Erfahrungen,Sie bilden gemeinsam den praktischen Wert von MemoraX bei komplexen Finanzaufgaben.
(3) Komplexe mathematische Schlussfolgerungen: Von der Erfahrungsberichterstattung zur selbstiterativen Anpassung der Lösungsstrategie
In hochgradig schwierigen mathematischen Denkexperimenten hat MemoraX seine Fähigkeit weiter erforscht, historische Erfahrungen und Validierungsfeedback zu nutzen, um Agenten dabei zu unterstützen, ihre Schlussfolgerungen kontinuierlich anzupassen und ihre Lösungsstrategien zu optimieren, wenn es um komplexe Probleme geht. Bei kombinierten Optimierungsproblemen auf IMO-Niveau (International Mathematical Olympiad) gelang es dem Agenten, nach etwa... 4 Stunden an kontinuierlicher Lösungsarbeit, mehr als 600 Modellaufrufe,Schließlich wurde die überprüfte Version gefunden. Die optimale Lösung für 21 Rechtecke: Im Vergleich zum OpenAI Codex-Plan wurde die Lösungszeit um 13 % und die Kosten um 98 % reduziert.
Vom Beweis des Fehls zur optimalen Lösung: Durch kontinuierliche Verbesserung des Schlussfolgerungsvermögens auf Basis von Feedback
Matilda 16×16 ist meiner Meinung nach eine hochgradig schwierige Aufgabe der kombinatorischen Optimierung: Es gilt, mit möglichst wenigen Rechtecken 240 Felder in einem 16×16-Grid zu bedecken, wobei in jeder Zeile und jeder Spalte genau ein Feld leer bleiben muss. Allein die Anzahl der leeren Felder ist bereits sehr groß. 20,9 Billionen mögliche AnordnungenDie Schwierigkeit liegt nicht nur darin, eine machbare Lösung zu finden, sondern auch darin, zu beweisen, dass es keine Lösung mit noch weniger Rechtecken gibt.
Angesichts dieser Herausforderung arbeiteten die Agenten kontinuierlich zusammen bei der Konstruktion von Suchalgorithmen, formalen Beweisen, genauen Modellierungen und unabhängigen Audits. Das System fand zunächst 27 und 23 Kandidatkonstruktionen, jedoch wurden die Argumente für die globale Optimallage der 23 Konstruktionen von einer unabhängigen Überprüfung abgelehnt.
MemoraX ist in der Lage, frühere Vorschläge, Denkprozesse und Validierungsfeedback kontinuierlich zu sammeln. Die Gedächtnismuster extrahieren effektive Verbesserungserfahrungen aus erfolgreichen Verläufen und wandeln Misserfolge in Referenzen für anschließende Anpassungen der Lösungsstrategien um:
- Erinnerung und Fehlerkorrektur: Von falschen Schlussfolgerungen zur Korrektur der Erinnerung. Die unabhängige Überprüfung wies 23 Fehler in den Nachweisen für die optimale Lösung auf, was dazu führte, dass der Agent seine bisherigen Schlussfolgerungen überdenken musste. Die Erkenntnis, dass eine „durchführbare Lösung nicht notwendigerweise die optimale Lösung ist“, wurde genutzt, um das „Gedächtnis“ des Systems zu korrigieren, um zukünftige Schlussfolgerungen von denselben Fehlern zu vermeiden.
- Strategische Selbstoptimierung: Von der Aktualisierung aus dem Gedächtnis zur Verbesserung der Methoden. Auf der Grundlage der zuvor aus dem Gedächtnismodell abgeleiteten Kandidatlösungen und der Validierungsfeedbacks wurde der Agent angeleitet, seine Modellierungsmethode anzupassen, um leere Stellen und Rechteckgrenzenbedingungen in die Lösungs Suche einzubeziehen. Dadurch wurden nacheinander 22 und 21 bessere Lösungen gefunden.
- Erinnerung iteriert erneut: Von der Ergebnisüberprüfung zur kontinuierlichen Optimierung. Der Agent findet durch schrittweise Überprüfungen und den Einsatz von Hilfstools eine präzise Lösung, bestätigt schließlich die Optimallage der Antwort und gibt die neuen Überprüfungsergebnisse an das Gedächtnismodell zurück, um die Lösungsstruktur zu verbessern und als Referenz für ähnliche Probleme zu dienen.
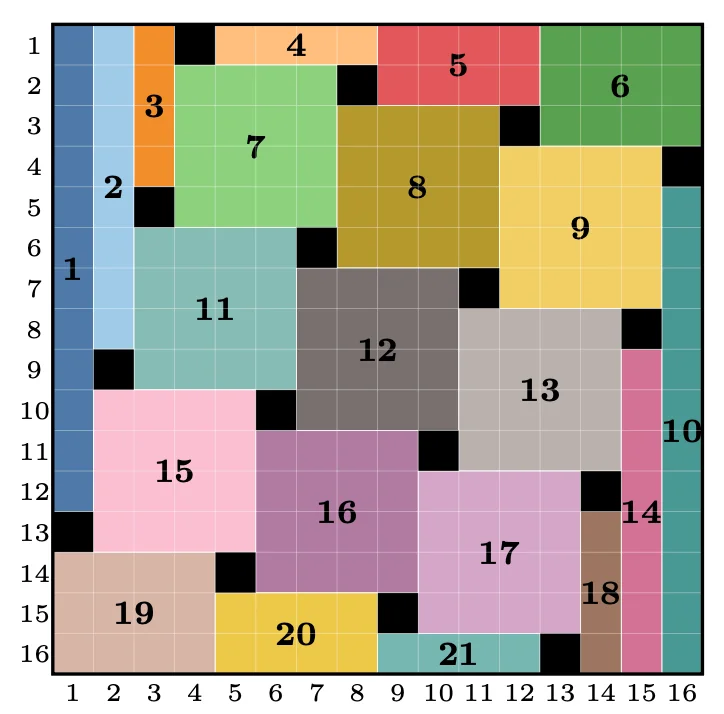
Die optimale Anordnung von 21 Rechtecken für das Matilda-16×16-Problem. Schwarze Quadrate sind leere Stellen, unterschiedlich farbige Bereiche stellen die Fliesen der Rechtecke dar.
Dies zeigt die kontinuierliche Iterationsfähigkeit des Agents bei komplexen mathematischen Aufgaben:Historische Erfahrungen sind nicht mehr nur statische Aufzeichnungen von Schlussfolgerungen, sondern können in Kombination mit neuen Überprüfungsergebnissen kontinuierlich zur Anpassung der nachfolgenden Lösungsstrategien beitragen.
Von der Erinnerung ausgehend – auf dem Weg zu einem kontinuierlich weiterentwickelnden Agenten
MemoraX AI wurde von Hao Jianye gegründet, dem ehemaligen Leiter des Huawei Decision and Reasoning Lab, des Large Model Algorithms Lab und des führenden Experten auf dem Gebiet der intelligenten Entscheidungsfindung. Das Unternehmen konzentriert sich auf die Entwicklung der nächsten Generation von lernfähigen, evolutorischen Agent-Memory-Modellen.
Das von unserem Team selbst entwickelte Gedächtnismodell, das auf der Agentic RL-Technologie basiert, hat den ersten Platz auf einer weltweit angesehenen Liste von Gedächtnisleistungen belegt und wurde von Medien wie der MIT Technology Review sowie anderen in- und ausländischen Publikationen ausführlich berichtet und beachtet. Unsere Lösung für das Gedächtnis wird in führenden Unternehmen aus den Bereichen Programmierung, Medizin, Finanzen, Sicherheit und Smart Home weit verbreitet eingesetzt und ist strategischer Partner von Huawei Cloud/Tencent Cloud.
Heute arbeitet das Team weiter an der Weiterentwicklung des RSI, das auf Memorienbasismodellen basiert, um die Agenten dazu zu befähigen, von der Akkumulation und Wiederverwendung von Erfahrungen zu einem kontinuierlichen Lernen und Selbstentwicklungssprozess überzugehen und somit ihre führende Position im Bereich der KI-Memorien weiter zu festigen. Gleichzeitig wird die Umsetzung in verschiedenen Szenarien beschleunigt, um die Standardisierung der Entwicklung und die skalierte Kommerzialisierung von Memorienmodulen für B2B- und B2C-Produkte voranzutreiben.
Abschlusswort
Der Schlüssel zu Agent RSI liegt nicht nur darin, dass KI in einer einzelnen Aufgabe besser abschneidet, sondern vielmehr darin,Jede Ausführung soll die Grundlage für die nächste Verbesserung der Fähigkeiten sein.Erfolgreiche Methoden, Erfahrungen aus Fehlern sowie Anwendungsbedingungen sammeln sich durch langfristiges Erinnern an und werden in neuen Aufgaben in wiederholbar anwendbare Handlungsanweisungen umgewandelt; die neuen Ergebnisse der Umsetzung tragen wiederum dazu bei, die Erfahrungen zu aktualisieren, die Strategien des Erinnerns zu optimieren und das Grundmodell des Gedächtnisses kontinuierlich weiterzuentwickeln.
Was MemoraX derzeit erforscht, ist…Ein wechselseitig fördernder Entwicklungsprozess zwischen Gedächtnis und der Selbstverbesserung des AgentenEinerseits ermöglicht es der Erinnerung, eine kontinuierliche Erfahrungsbasis für den Agent RSI zu schaffen, die über verschiedene Aufgaben hinweg übertragen werden kann; andererseits fördert die Ausführung in den tatsächlichen Aufgaben sowie die daraus resultierenden Rückmeldungen das Lernen und die Weiterentwicklung der Erinnerung selbst.
Wenn jede Aufgabe Erfahrungen hinterlässt und jede Rückmeldung zur Verbesserung beiträgt, ist die Steigerung der Fähigkeiten des Agents nicht mehr auf eine einzelne Ausführung beschränkt, sondern es entsteht die Möglichkeit, zu einem kontinuierlich wachsenden und sich selbst entwickelnden Prozess zu werden.
Der Artikel stammt von „Machine Heart“, verfasst von „Machine Heart“.
Artikellink:https://www.airai.cc/de/ai-news/54/
有用吗?