From Memory to Self-Evolution: A Critical Step for Agent's Journey towards RSI
ในช่วงเวลาที่ผ่านมา ห้องปฏิบัติการด้าน AI ชั้นนำทั่วโลกกำลังปล่อยสัญญาณออกมาอย่างต่อเนื่อง:AI กำลังเปลี่ยนจากการช่วยเหลือมนุษย์ในการทำงาน ไปสู่การมีส่วนร่วมในการพัฒนาและปรับปรุงตัวเอง
ในเดือนกันยายน ออปเนียอาย (OpenAI) ได้ประกาศว่าพวกเขาได้บรรลุเป้าหมายระยะแรกในการสร้าง “นักศึกษาฝึกงานด้าน AI อัตโนมัติ” และมีแผนที่จะสร้าง “นักวิจัย AI อัตโนมัติ” ที่แท้จริงภายในเดือนมีนาคม 2028 ซายมุน ปาโชคี (Jakub Pachocki) หัวหน้านักวิทยาศาสตร์ของออปเนียอาย ได้เขียนบทความยาวเกี่ยวกับแนวโน้มการพัฒนาของเทคโนโลยีการปรับปรุงตนเองแบบเรียกซ้ำ (Recursive Self-Improvement หรือ RSI) ในช่วงเวลาเดียวกัน วันที่ 21 กันยายน ออปเนียอายได้กำหนดให้การพัฒนานักวิจัย AI อัตโนมัติและความสามารถในการวิจัยและพัฒนา AI อย่างต่อเนื่องเป็นทิศทางยุทธศาสตร์สำคัญในขั้นตอนต่อไป
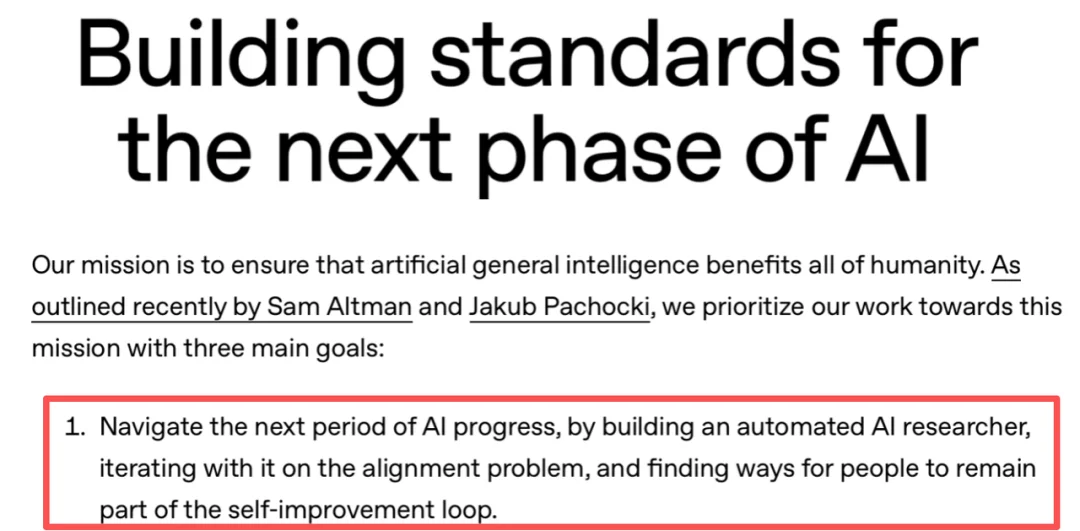
OpenAI ได้เผยแพร่แถลงการณ์ทางกลยุทธ์อย่างเป็นทางการเมื่อวันที่ 21 กันยายน 2026 โดยระบุว่าการพัฒนานักวิจัย AI อัตโนมัติและระบบที่สามารถปรับปรุงตนเองได้อย่างเป็นวัฏจักรเป็นเป้าหมายสำคัญในขั้นตอนต่อไป
อีกด้านหนึ่ง, Anthropic ก็ได้เปิดเผยข้อมูลที่น่าสนใจ: จนถึงเดือนสิงหาคมปีนี้, Claude ได้ทำงานไปแล้วประมาณ 26% ของงานวิจัยและพัฒนา AI ภายในมีบทบาทเป็นผู้นำ,มีงานวิจัยและพัฒนาที่เดิมทีทำโดยนักวิจัยมากขึ้นเรื่อยๆ ที่เริ่มถูกส่งต่อให้ AI ดำเนินการภายใต้การกำกับดูแลของมนุษย์
จาก OpenAI ไปสู่ Anthropic ตัวชี้วัด RSI กำลังเปลี่ยนจากแนวคิดทางเทคโนโลยีที่ยังอยู่ในขั้นเริ่มต้น มาเป็นหัวข้อหลักในการวิจัยและพัฒนาของห้องปฏิบัติการชั้นนำทั่วโลก AI ไม่ได้เป็นเพียงเครื่องมือสำหรับแก้ปัญหาภายนอกเท่านั้น แต่ยังเริ่มมีส่วนร่วมในการพัฒนาความสามารถของตัวเองอีกด้วย
แต่กุญแจสำคัญที่สุดในเส้นทางการพัฒนานี้คือ:
AI จะสามารถนำประสบการณ์จากการสำรวจและการทดลองในอดีตมาใช้เป็นพื้นฐานสำหรับการก้าวหน้าครั้งต่อไปได้อย่างไร ไม่ใช่ต้องเริ่มต้นใหม่ทุกครั้งที่เผชิญกับงานใหม่?
ความจำเป็นเป็นรากฐานสำคัญที่ทำให้ Agent สามารถพัฒนาตัวเองได้อย่างต่อเนื่อง มันทำให้ทุกครั้งที่มีการสำรวจ ไม่เพียงแต่จะได้ผลลัพธ์ของงานเท่านั้น แต่ยังได้ประสบการณ์ที่สามารถนำไปใช้ซ้ำและสืบทอดในงานต่อไปได้ ซึ่งช่วยให้ความสามารถของ Agent มีโอกาสพัฒนาข้ามขีดจำกัดของงานแต่ละครั้ง และพัฒนาอย่างต่อเนื่องจากการสะสมประสบการณ์
01 | จากการสะสมประสบการณ์ไปสู่การพัฒนาอย่างต่อเนื่อง:
ความจำมีบทบาทอย่างไรในการสนับสนุน RSI
หากต้องการให้ Agent มีความสามารถที่ดีขึ้นอย่างต่อเนื่องในการทำงาน สิ่งสำคัญคือต้องให้ประสบการณ์สามารถข้ามขีดจำกัดของงานแต่ละครั้งได้:นำวิธีการที่มีประสิทธิภาพจากการสำรวจในอดีตมาใช้ในงานใหม่ และปรับปรุงและพัฒนาตามผลลัพธ์ที่ได้รับ ในนั้น การเขียนและการค้นคืนข้อมูลในความจำมีบทบาทสำคัญที่เชื่อมโยงกัน
การเขียนข้อมูลลงในความทรงจำจำเป็นต้องมีการระบุวิธีการที่มีประสิทธิภาพ ข้อสรุปเกี่ยวกับความล้มเหลว และเงื่อนไขที่เหมาะสมจากเส้นทางการดำเนินการที่ซับซ้อน เพื่อให้งานในอดีตสามารถสร้างประสบการณ์ที่สามารถนำกลับมาใช้ซ้ำได้จริงๆ ในขณะที่การค้นคืนข้อมูลจากความทรงจำจำเป็นต้องหาวิธีการและหลักฐานสำคัญที่เกี่ยวข้องจากประวัติศาสตร์ได้อย่างแม่นยำตามความต้องการของงานใหม่ เพื่อหลีกเลี่ยงการละเลยประสบการณ์และการนำข้อมูลที่ผิดไปใช้
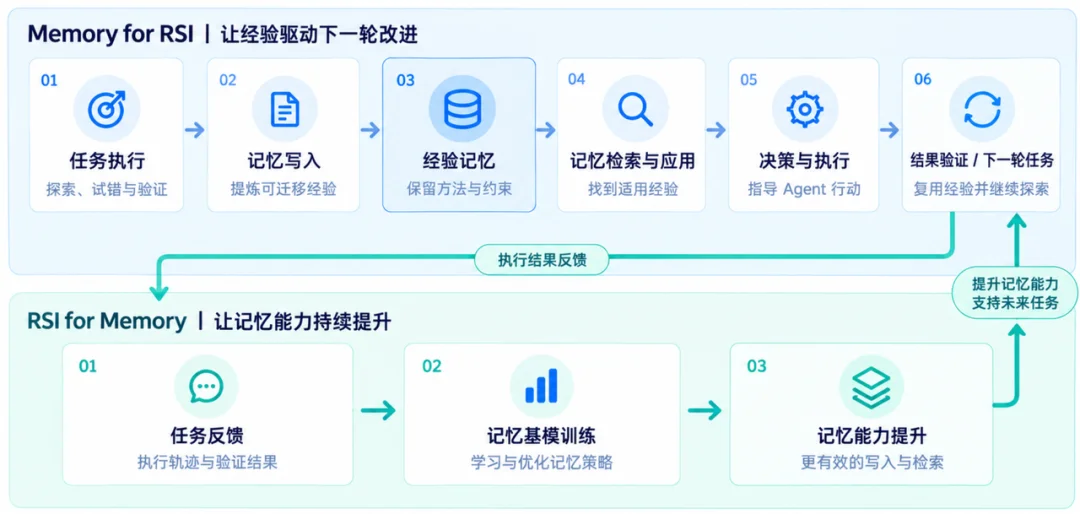
นอกจากนี้ การให้ข้อเสนอแนะจากงานยังสามารถตรวจสอบคุณค่าจริงของประสบการณ์ได้อีกด้วย โดยการอัปเดตเนื้อหาในความทรงจำอย่างต่อเนื่อง และนำข้อเสนอแนะที่มีประสิทธิภาพไปใช้ในการฝึกโมเดลพื้นฐานของความทรงจำ เพื่อส่งเสริมการพัฒนาความสามารถของความทรงจำเอง และสร้างกระบวนการที่ประสบการณ์สะสมและการปรับปรุงของ Agent ส่งเสริมซึ่งกันและกัน
02 |การเรียนรู้และวิวัฒนาการของความทรงจำ:
ให้ Agent ได้รับการพัฒนาอย่างต่อเนื่องจากประสบการณ์ที่มี
เพื่อตอบสนองความต้องการในการสะสมประสบการณ์ การนำความรู้ไปใช้ซ้ำระหว่างงานที่แตกต่างกัน และการปรับปรุงอย่างต่อเนื่องใน Agent RSI MemoraX จึงได้สร้างระบบขึ้นมาการเรียนรู้จากประสบการณ์ การถ่ายโอนความรู้จากประสบการณ์ และการปรับปรุงโดยใช้ข้อเสนอแนะระบบความสามารถในการจดจำที่มีหัวใจสำคัญคือการสร้างข้อมูลการจดจำคุณภาพสูง การจัดระเบียบการจดจำแบบไดนามิก และการปรับปรุงโดยอิงจากข้อเสนอแนะจากงานจริง ซึ่งช่วยในการฝึกฝนโมเดลพื้นฐานของการจดจำอย่างต่อเนื่อง ทำให้ Agent สามารถเรียนรู้และปรับปรุงการตัดสินใจและการดำเนินการจากประสบการณ์ในอดีตได้
เรียนรู้จากงาน: ให้ประสบการณ์ที่สะสมมากลายเป็นความสามารถของแบบจำลองที่สามารถปรับปรุงได้
ในระหว่างการดำเนินงานของเอเจนต์ การตรวจสอบผลลัพธ์และการปรับเปลี่ยนกลยุทธ์จะนำไปสู่ประสบการณ์ใหม่ๆ อย่างต่อเนื่องการตัดสินใจที่ประสบความสำเร็จจะให้วิธีการที่สามารถนำไปใช้ซ้ำได้สำหรับงานต่อไป ในขณะที่ข้อสรุปจากความล้มเหลวที่ได้รับการตรวจสอบจะช่วยให้เอเจนต์สามารถกำจัดแผนการที่ไม่มีประสิทธิภาพและลดการทดลองผิดพลาดซ้ำๆอย่างไรก็ตาม คุณค่าของประสบการณ์มักจะปรากฏในงานต่อไปเท่านั้น การสรุปอดีตอย่างแม่นยำไม่ได้หมายความว่าจะสามารถสนับสนุนอนาคตได้อย่างมีประสิทธิภาพ ดังนั้น กระบวนการเรียนรู้จากความทรงจำจึงต้องไม่เพียงแต่ระบุประสบการณ์ที่ควรจะถูกเก็บรักษาไว้เท่านั้น แต่ยังต้องเก็บรักษาข้อมูลการตรวจสอบ ข้อจำกัดของสภาพแวดล้อม และเงื่อนไขการใช้งานไว้ด้วย เพื่อหลีกเลี่ยงไม่ให้ประสบการณ์ถูกละเลยหรือนำไปใช้ผิดวัตถุประสงค์ ซึ่งไม่ใช่เรื่องง่ายที่จะทำได้ด้วยการสรุปและการบีบอัดข้อมูลเท่านั้น
เพื่อรับมือกับความท้าทายนี้ MemoraX การเขียนความทรงจำเข้าไปในกลยุทธ์ที่สามารถเรียนรู้ได้ซึ่งถูกออกแบบมาเพื่อผลตอบแทนในอนาคต และสร้างระบบที่สมบูรณ์ซึ่งครอบคลุมการสร้างสภาพแวดล้อม การเก็บรวบรวมข้อมูล การสร้างตัวอย่าง และการฝึกการเรียนรู้ด้วยเอเจนต์ (Agentic RL) ในระดับขนาดใหญ่อย่างต่อเนื่องในสภาพแวดล้อมงานที่สามารถโต้ตอบและตรวจสอบได้ จะมีการเก็บรวบรวมเส้นทางการดำเนินการ บันทึกการใช้งาน และข้อเสนอแนะการตรวจสอบ เพื่อสร้างตัวอย่างข้อมูลสำหรับการตัดสินใจในการเขียนข้อมูลเข้าไปในความทรงจำและผลลัพธ์การใช้งานที่ตามมา จากนั้นจะนำข้อมูลเหล่านี้มาผสมผสานกับคุณภาพการทำงานของงานถัดไป ประสิทธิภาพการดำเนินการ และสถานการณ์การทดลองซ้ำๆ เพื่อออกแบบสัญญาณการให้รางวัล เพื่อปรับปรุงกลยุทธ์การเขียนข้อมูลเข้าไปในความทรงจำ กระบวนการนี้ทำให้เป้าหมายการปรับปรุงของโมเดลขยายจากความแม่นยำในการสกัดข้อมูลไปสู่สิ่งอื่นๆ อีกด้วยผลกระทบที่แท้จริงของความจำต่อคุณภาพของงานที่ตามมา ประสิทธิภาพในการดำเนินการ และการทดลองผิดพลาดซ้ำๆการเรียนรู้จะช่วยให้สามารถพัฒนากลยุทธ์การจดจำและการเขียนสำหรับงานในอนาคตได้ดียิ่งขึ้น
การถ่ายโอนจากประสบการณ์: ให้ประสบการณ์ในอดีตเป็นแนวทางในการทำงานภารกิจใหม่
ประสบการณ์ที่สามารถถูกเก็บรักษาไว้นั้น ไม่ได้หมายความว่ามันจะสามารถนำไปใช้ได้ผลในงานใหม่ๆ ในการเผชิญกับเป้าหมายของงานที่แตกต่างกัน ข้อจำกัดของสภาพแวดล้อม และขั้นตอนการดำเนินการที่แตกต่างกัน Agent จำเป็นต้องระบุวิธีการที่เคยใช้ในอดีตที่เหมาะสมอย่างแม่นยำ และหลีกเลี่ยงไม่ให้ข้อมูลที่ไม่เกี่ยวข้องรบกวน รวมถึงการนำประสบการณ์ไปใช้ผิดพลาด
เพื่อวัตถุประสงค์นี้ MemoraX จะการแยกความจำออกจากโครงสร้างการเข้าถึง,ปรับเปลี่ยนจุดเข้าถึงความทรงจำและความสัมพันธ์ที่เกี่ยวข้องตามงานที่กำลังดำเนินอยู่อย่างไดนามิก เพื่อให้ข้อมูลทางประวัติศาสตร์เดียวกันสามารถตอบสนองความต้องการการใช้งานที่แตกต่างกันได้
ในระดับการค้นหา ยังมีการพัฒนาเพิ่มเติมอีกการเรียนรู้ความสัมพันธ์ระหว่างความต้องการของงานปัจจุบันกับหลักฐานสำคัญในอดีตผ่านการฝึกโมเดลการรวมหลักฐานระดับละเอียดเล็กน้อยเข้ากับการแยกแยะความคล้ายคลึงของความทรงจำ เพื่อเพิ่มความสามารถในการระบุประสบการณ์สำคัญ และแยกแยะระหว่าง “เนื้อหาที่เกี่ยวข้องกับหัวข้อ” กับ “หลักฐานที่ถูกต้อง”
ในขั้นตอนการใช้งานจริง MemoraX จะผสมผสานสถานะของงานปัจจุบันและความคืบหน้าในการดำเนินการเข้าด้วยกันการแปลงประสบการณ์ทั่วไปที่สะสมมาตลอดประวัติศาสตร์ให้กลายเป็นคำแนะนำการดำเนินการที่มีเป้าหมายที่ชัดเจน ข้อจำกัดในการดำเนินการ และมาตรฐานการตรวจสอบและปรับเปลี่ยนได้อย่างตามขั้นตอนของงาน เพื่อให้ประสบการณ์ในอดีตสามารถมีส่วนร่วมอย่างแท้จริงในการตัดสินใจและการดำเนินการของ Agent
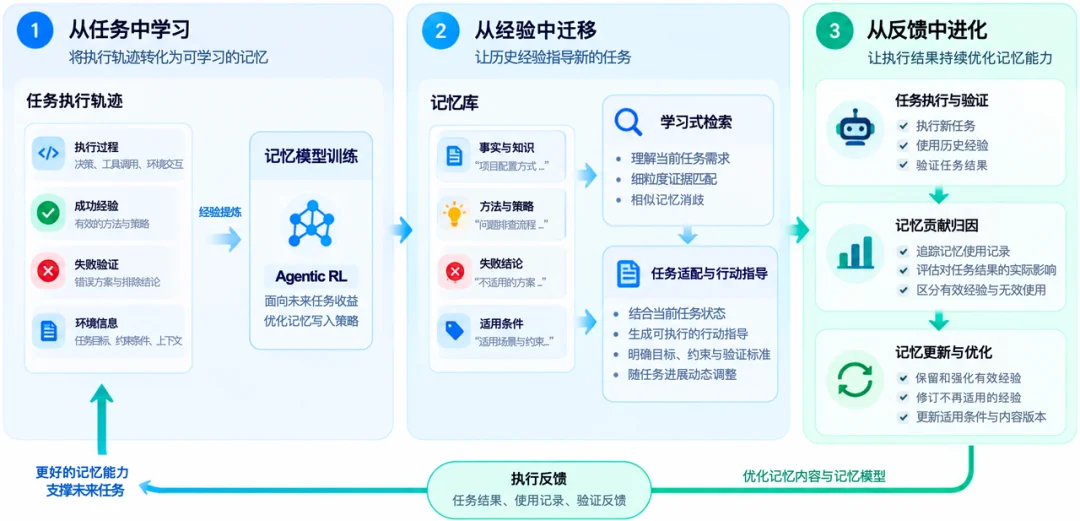
พัฒนาจากข้อเสนอแนะ: ทำให้ผลลัพธ์การดำเนินการช่วยเพิ่มประสิทธิภาพความสามารถในการจดจำอย่างต่อเนื่อง
ในการปรับปรุง RSI อย่างต่อเนื่อง ประสบการณ์ในอดีตไม่ได้มีประสิทธิภาพเสมอไป งานใหม่ๆ อาจทั้งยืนยันวิธีการที่มีอยู่หรืออาจเผยให้เห็นข้อจำกัดของมันวิธีการใช้ข้อมูลที่ได้จากการปฏิบัติเพื่อประเมินคุณค่าที่แท้จริงของประสบการณ์ และนำข้อมูลนั้นมาปรับปรุงความจำอย่างต่อเนื่อง ถือเป็นส่วนสำคัญในการพัฒนาตนเองอย่างต่อเนื่อง
ความท้าทายหลักในเรื่องนี้คือ Memory Credit Assignmentภารกิจระยะไกลอาจเรียกใช้ประสบการณ์ในอดีตหลายครั้ง แต่ประสบการณ์ใดบ้างที่มีผลจริงต่อการตัดสินใจของเอเจนต์ และประสบการณ์ใดบ้างที่เพียงแค่ถูกอ่านเท่านั้นโดยไม่ได้ส่งผลอะไร? แม้ว่าภารกิจจะสำเร็จในที่สุด การตัดสินใจว่าความทรงจำแต่ละอย่างมีส่วนร่วมอย่างไรจริงๆ ก็ยังคงเป็นปัญหาที่ต้องแก้ไข
เพื่อรับมือกับความท้าทายนี้ MemoraX จะการสร้างความเชื่อมโยงระหว่างเวอร์ชันของความทรงจำ, บันทึกการใช้งานจริง และข้อเสนอแนะเกี่ยวกับการดำเนินการงานเพื่อติดตามว่าประสบการณ์ในอดีตมีส่วนเกี่ยวข้องกับการดำเนินการของ Agent อย่างแท้จริงหรือไม่ รวมถึงประสิทธิภาพของงานและผลลัพธ์การตรวจสอบหลังจากการใช้งาน บนพื้นฐานนี้ จึงควรมีการประเมินและปรับปรุงความจำที่มีอยู่อย่างต่อเนื่องให้ประสบการณ์ที่มีประโยชน์ได้รับการเก็บรักษาและเสริมสร้างความแข็งแกร่ง และตามความคิดเห็นจากงานใหม่ๆ ให้มีการปรับปรุงประสบการณ์ที่ไม่เหมาะสมให้ทันท่วงที
ข้อเสนอแนะจริงเหล่านี้ก็มีประโยชน์เช่นกันการฝึกอบรมแบบต่อเนื่องของโมเดลพื้นฐานด้านความจำได้มีการจัดเตรียมพื้นฐานข้อมูลและสัญญาณที่เหมาะสม ทำให้การปรับปรุงความจำสามารถขยายจากการอัปเดตในระดับเนื้อหา ไปสู่การเรียนรู้ของโมเดลความจำเกี่ยวกับคุณค่าของประสบการณ์และกลยุทธ์การจดจำได้มากยิ่งขึ้น
03 จากการสะสมประสบการณ์ไปสู่การพัฒนาความสามารถ:
การประยุกต์ใช้ RSI ในหลากหลายสถานการณ์ของ MemoraX
สำหรับ Agent RSI สิ่งที่ควรให้ความสนใจมากกว่าคือผลลัพธ์ของภารกิจแต่ละครั้งนั้นดีเพียงใด แต่เป็นว่าประสบการณ์ในอดีตสามารถถูกสะสมและปรับปรุงอย่างต่อเนื่องได้หรือไม่ และสามารถสร้างคุณค่าได้ต่อไปในงานที่ตามมา
ในกระบวนการนี้ ได้มีการตรวจสอบความสามารถในการปรับปรุงประสิทธิภาพอย่างต่อเนื่องจากประสบการณ์ การถ่ายโอนความรู้ระหว่างงานที่แตกต่างกัน และการปรับแต่งโดยใช้ข้อมูลป้อนกลับ ในสามประเภทของงาน ได้แก่ การเขียนโค้ดที่ซับซ้อนในระยะยาว การวิเคราะห์ทางการเงิน และการใช้เหตุผลทางคณิตศาสตร์ที่ซับซ้อน นอกจากนี้ยังได้มีการตรวจสอบว่าความจำมีบทบาทอย่างไรในการส่งเสริมคุณภาพและประสิทธิภาพของเอเจนต์ (Agent) ในการทำงานที่มีระยะเวลานาน
(1)การเขียนโค้ดที่ซับซ้อนในระยะไกล: จากการปรับปรุงทีละขั้นตอนจากประสบการณ์ไปสู่การพัฒนาความสามารถในการออกแบบโปรเจ็กต์ที่ซับซ้อน
การทดลองเขียนโปรแกรมที่ซับซ้อนในระยะไกลนั้นใช้ในด้านการสื่อสาร การเงิน การขนส่ง และอื่นๆ ใน 5 อุตสาหกรรมใหญ่ และ 13 โครงการพัฒนาระบบระดับอุตสาหกรรม มีการดำเนินการพัฒนาและทดสอบรวมทั้งหมด 78 ครั้ง โดยมีระยะเวลาการพัฒนาทั้งหมดมากกว่า 300 ชั่วโมง โดยครั้งที่ยาวนานที่สุดมีระยะเวลามากกว่า 12 ชั่วโมง สุดท้ายแล้ว วิธีการเสริมสร้างความจำ MemoraX ช่วยเพิ่มอัตราการผ่านการทดสอบได้มากกว่า 20% ในขณะที่การใช้ Token โดยรวมของ Agent หลักในการเขียนโค้ดลดลงมากกว่า 20%
จากการสะสมประสบการณ์ไปสู่การปรับปรุงแบบเรียกซ้ำ: การพัฒนาตนเองของความจำ
เพื่อแก้ไขปัญหาที่ว่าความจำแบบสถิติแบบดั้งเดิมไม่สามารถสะสมและปรับปรุงประสบการณ์ได้อย่างต่อเนื่องระหว่างการดำเนินงาน ทีม MemoraX ได้เสนอวิธีการ RSI ที่ขับเคลื่อนด้วยโมเดลความจำ (Memory Model-Driven RSI)โดยการทำงานร่วมกันระหว่างโมเดลความจำที่พัฒนาขึ้นเองกับระบบ Agent โมเดลความจำที่เฉพาะทางจะทำหน้าที่คัดกรองและอัปเดตความจำเชิงโปรแกรมจากเส้นทางการดำเนินการของ Agent และข้อมูลตอบกลับแบบเรียลไทม์ ในขณะที่ระบบ Agent จะนำความจำนั้นไปประยุกต์ใช้ในงานจริง สร้างกลไกการวนซ้ำที่ประกอบด้วยการสังเคราะห์ประสบการณ์ การประยุกต์ใช้งาน การตรวจสอบผลลัพธ์ และการอัปเดตความจำ ซึ่งช่วยให้ประสบการณ์ที่มีประสิทธิภาพสามารถสะสม ปรับปรุง และนำไปใช้เป็นแนวทางสำหรับงานต่อไปได้อย่างต่อเนื่อง ในกรณีศึกษาการฝึกที่ประกอบด้วยงานเขียนโค้ดระยะยาวหลังจากการปรับปรุงวงจรการทำงานของความจำเชิงโปรแกรมหลายรอบ คุณภาพของความจำเชิงโปรแกรมได้รับการเพิ่มขึ้นมากกว่า 10%
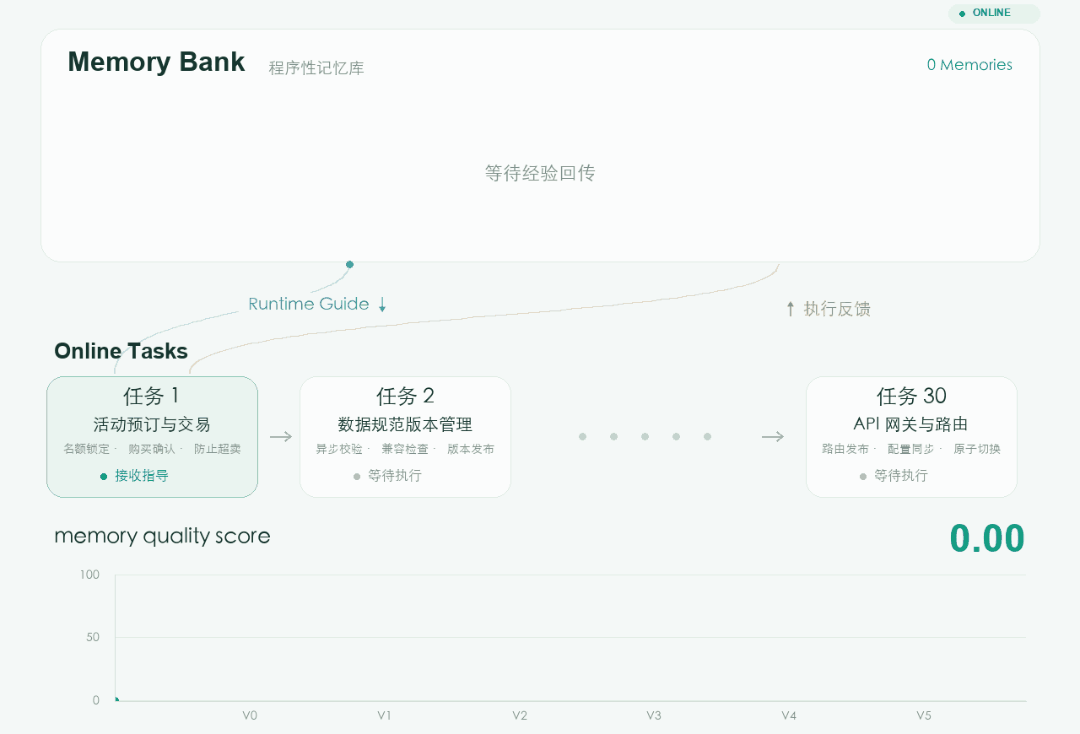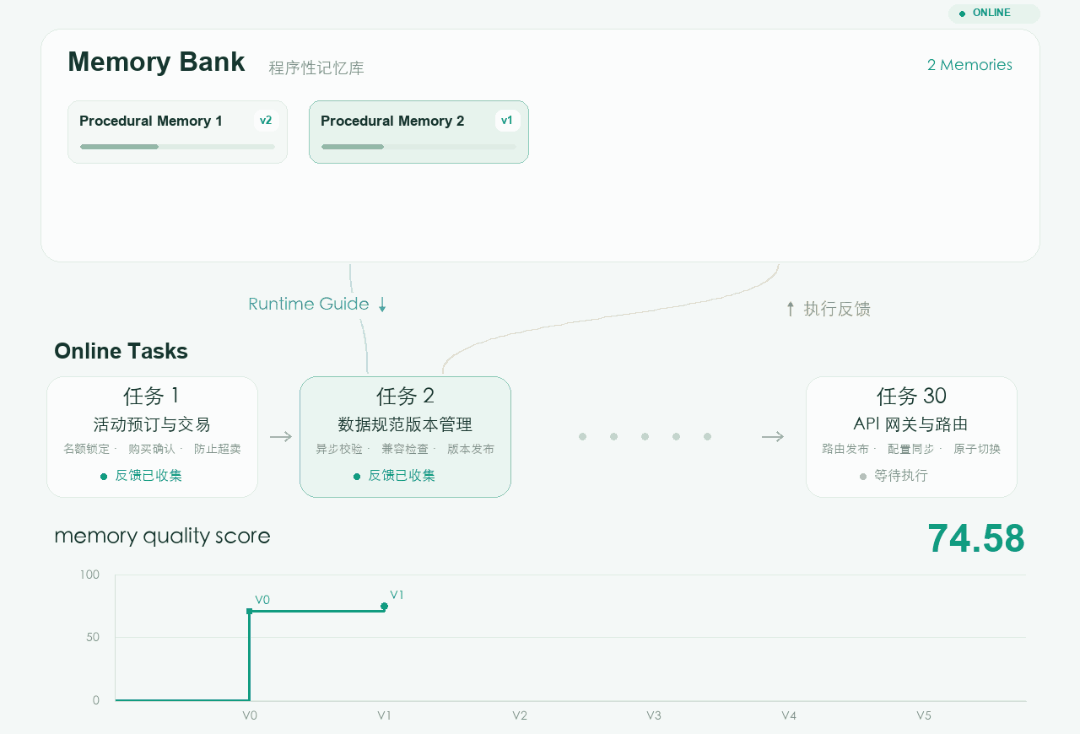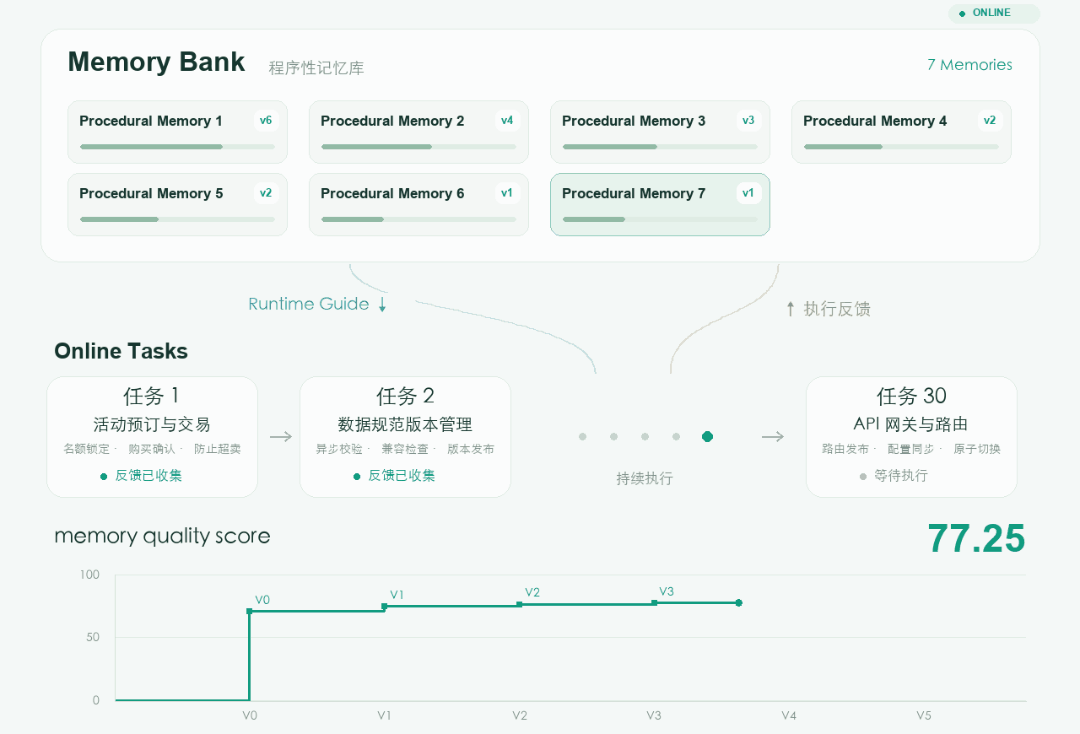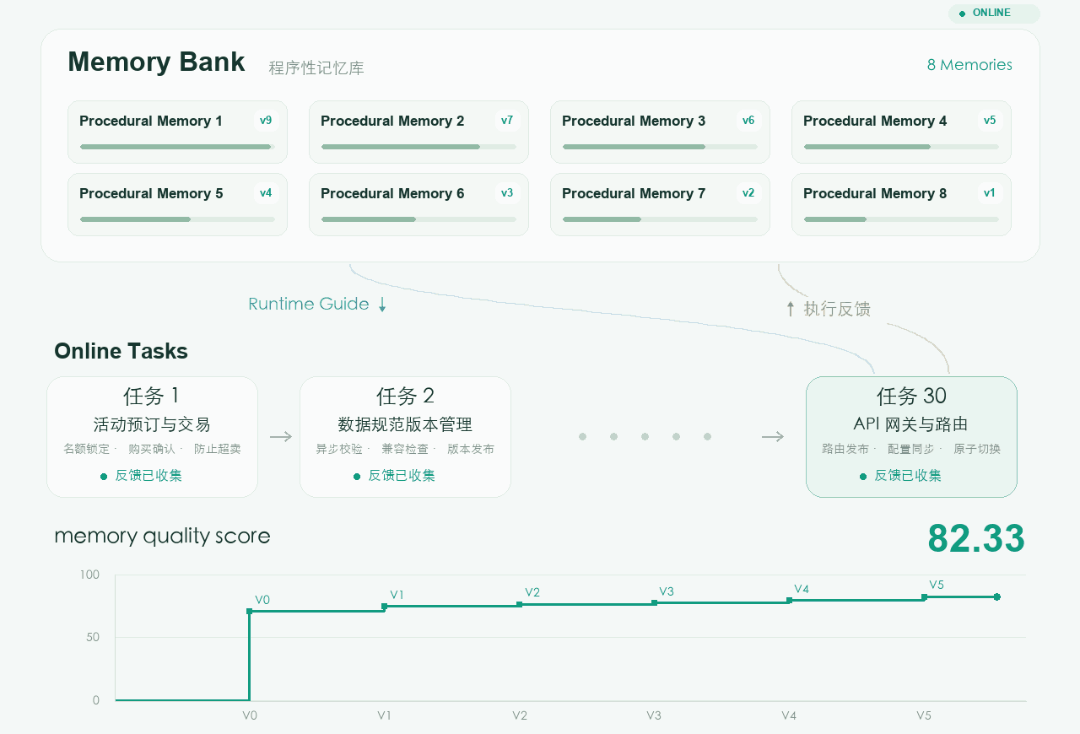
ด้วยประสบการณ์จากการทำซ้ำแล้วซ้ำเล่า มาเผชิญกับความท้าทายในการพัฒนาโปรเจ็กต์วิศวกรรมที่ซับซ้อนซึ่งใช้เวลาถึง 335 ชั่วโมง
เมื่อประสบการณ์ที่สะสมมาแยกออกจากภารกิจการเรียนรู้เดิม จะยังสามารถมีประโยชน์ได้มากแค่ไหนเมื่อต้องเผชิญกับความท้าทายใหม่ๆ ในโครงการ?
เพื่อวัตถุประสงค์นี้ จะนำประสบการณ์ที่สะสมมาใช้ในการพัฒนาโปรเจ็กต์ที่ซับซ้อนใหม่ๆในการดำเนินงานวิศวกรรมซอฟต์แวร์ที่ซับซ้อนจำนวน 13 โครงการ มีการทำการพัฒนาและทดสอบซอฟต์แวร์ทั้งหมด 78 ครั้ง โดยมีระยะเวลาการพัฒนาทั้งหมดมากกว่า 335 ชั่วโมง โดยครั้งที่ยาวนานที่สุดหนึ่งครั้งใช้เวลามากกว่า 12 ชั่วโมงงานเหล่านี้ไม่ใช่เพียงแค่การแก้ไขโค้ดอย่างง่ายๆ แต่เป็นความท้าทายทางวิศวกรรมจริงที่เกี่ยวข้องกับตรรกะทางธุรกิจที่ซับซ้อน การพึ่งพาระหว่างโมดูลต่างๆ และการทดสอบจำนวนมาก
ในที่สุด อัตราการผ่านการตรวจสอบเพิ่มขึ้นมากกว่า 20% ในขณะที่การใช้ Token โดยรวมของ Coding Agent ลดลงมากกว่า 20% ด้วย
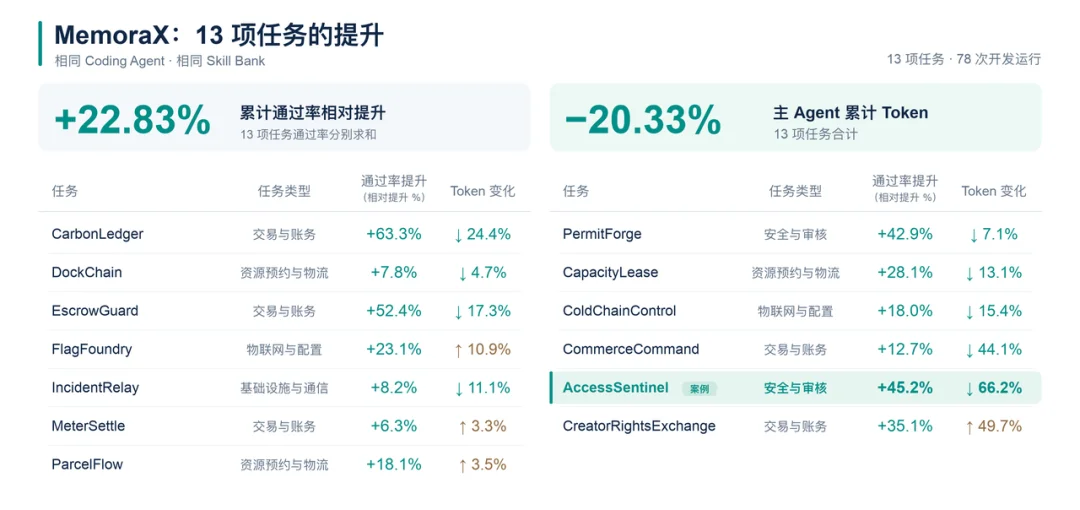
ในนั้น AccessSentinel เป็นกรณีที่มีความซับซ้อนสูงและเป็นตัวอย่างที่น่าสนใจ ตัวแทน (Agent) จำเป็นต้องสร้างระบบควบคุมสิทธิ์ระดับองค์กรที่สมบูรณ์ และต้องรับประกันว่าข้อจำกัดด้านความปลอดภัยที่เข้มงวด。
ด้วยความช่วยเหลือจากโมเดลความจำประสบการณ์ทางประวัติศาสตร์ไม่ได้จำกัดอยู่แค่เป็นเพียงข้อมูลอ้างอิงที่ไม่เคลื่อนไหวอีกต่อไป แต่สามารถมีส่วนร่วมอย่างต่อเนื่องในการดำเนินการและการตรวจสอบของ Agent ตามการเปลี่ยนแปลงของสถานะงานได้ตั้งแต่นาทีที่ 43 หลังจากเริ่มการพัฒนาไปจนถึงเวลา 2 ชั่วโมง 30 นาที ความทรงจำถูกบันทึกไว้ในจุดสำคัญต่างๆเสนอข้อมูลโดยตนเองการแนะนำเฉพาะเจาะจง:
- เมื่อสิทธิ์การเข้าถึงอุปกรณ์ถูกยกเลิก,ไม่เพียงแต่ต้องห้ามไม่ให้อุปกรณ์ล็อกอินเข้าสู่ระบบอีกครั้งเท่านั้น แต่ยังต้องรับประกันด้วยว่าบัญชีที่ล็อกอินเข้าสู่ระบบไปก่อนหน้านี้จะไม่สามารถเข้าถึงระบบได้อีกต่อไป
- เมื่อคุณกู้คืนนโยบายความปลอดภัยเวอร์ชันเก่าเราต้องการรักษาบันทึกทางประวัติศาสตร์ไว้ ในขณะเดียวกันก็ต้องป้องกันไม่ให้สิทธิ์ที่ถูกยกเลิกแล้วกลับมาใช้งานโดยไม่คาดคิด
- เมื่อทำการประมวลผลคำขอแบบหมู่,ตรวจสอบก่อนว่าคำขอทั้งหมดเป็นไปตามข้อกำหนดหรือไม่ การดำเนินการจะสามารถทำได้พร้อมกันก็ต่อเมื่อทุกคำขอผ่านการตรวจสอบ เพื่อหลีกเลี่ยงสถานการณ์ที่บางคำขอสำเร็จและบางคำขอล้มเหลว
ในระหว่างการทดสอบอัตราการผ่านการทดสอบเฉลี่ยจากการทำงานสามครั้งเพิ่มขึ้นถึงมากกว่า 45% ในขณะที่การใช้ Token โดย Coding Agent หลักลดลงถึงมากกว่า 66%
(2)การวิเคราะห์ทางการเงินที่ซับซ้อน: ตั้งแต่การสะสมหลักฐานไปจนถึงการปรับปรุงอย่างต่อเนื่องและอิสระ
การวิจัยทางการเงินจำเป็นต้องสร้างการวิเคราะห์และข้อสรุปที่สมบูรณ์และน่าเชื่อถือจากข้อมูลจำนวนมากที่กระจัดกระจายกัน นอกเหนือจากการค้นหาข้อมูลที่เกี่ยวข้องแล้ว อีเจนต์ยังต้องเข้าใจอย่างถูกต้องเกี่ยวกับตัวแปรต่างๆ เช่น ผู้เกี่ยวข้อง ช่วงเวลา และวิธีการสำรวจสถิติ ในบริบทที่ซับซ้อน รวมทั้งสร้างความเชื่อมโยงระหว่างหลักฐานต่างๆ เพื่อหลีกเลี่ยงผลกระทบต่อข้อสรุปสุดท้ายที่อาจเกิดจากการขาดข้อมูลหรือความสับสนในวิธีการวัด
MemoraX ให้ความสำคัญกับปัญหาสองประการที่เกี่ยวข้องกัน:วิธีที่จะทำให้หลักฐานสนับสนุนคำตอบที่สมบูรณ์ และวิธีการใช้คำถามที่อยู่ในคำตอบนั้นเพื่อปรับปรุงวิธีการจัดเก็บและค้นคืนหลักฐานเพื่อวัตถุประสงค์นี้ MemoraX ได้ทำการทดลองโดยอิงจากมาตรฐานอ้างอิงที่เชื่อถือได้ในวงการการเงินซึ่งเรียกว่า FinRank ซึ่งครอบคลุมงบการเงินจริงของบริษัทที่จดทะเบียนในตลาดหุ้นสหรัฐอเมริกาจำนวน 22 แห่งในอุตสาหกรรมต่างๆ เช่น การผลิตยา น้ำมันและก๊าซ และยานยนต์ โดยมีข้อมูลทางการเงินที่ซับซ้อนจากหลายบริษัทและหลายช่วงเวลา MemoraX ใช้ข้อมูลป้อนกลับจากการทำงานเพื่อปรับปรุงการจัดระเบียบความจำและการค้นหาอย่างต่อเนื่อง สร้างวงจรปฏิบัติการแบบ RSI ที่ประกอบด้วย “การดำเนินการ — การป้อนกลับ — การปรับปรุงความจำ — การดำเนินการซ้ำ” การทำงานร่วมกันแบบซ้ำๆ ระหว่างโมเดลความจำและระบบวิเคราะห์ทางการเงินมากกว่า 30 ครั้ง,สุดท้ายอัตราการเรียกคืนของห่วงโซ่หลักฐานใกล้เคียงกับ 100% ซึ่งเมื่อเทียบกับงาน CodeX แล้ว อัตราความแม่นยำในการทำงานเพิ่มขึ้น 20% และต้นทุนลดลงเกือบ 98%
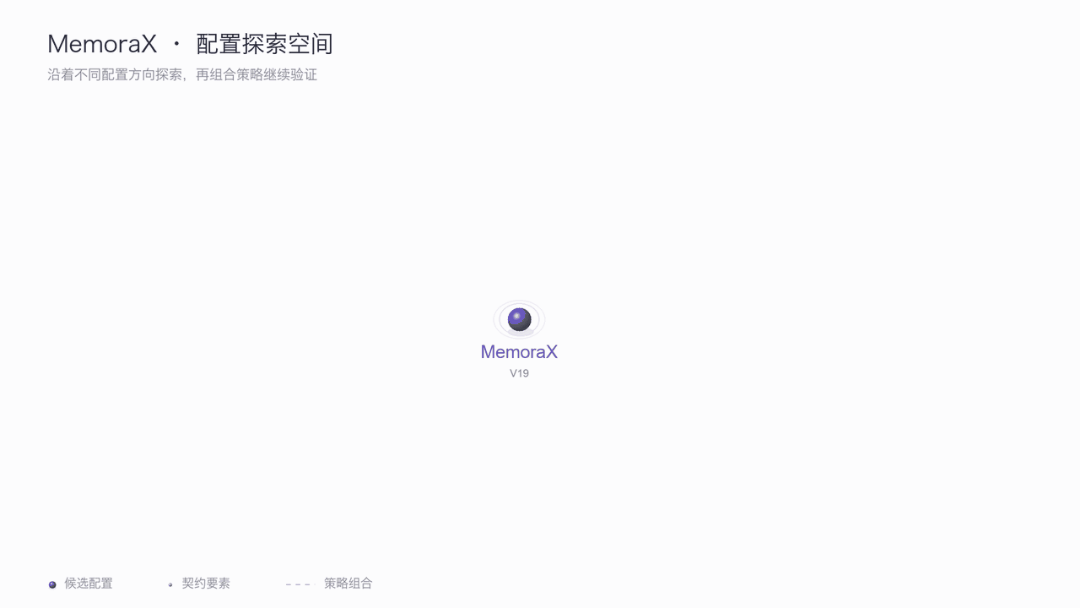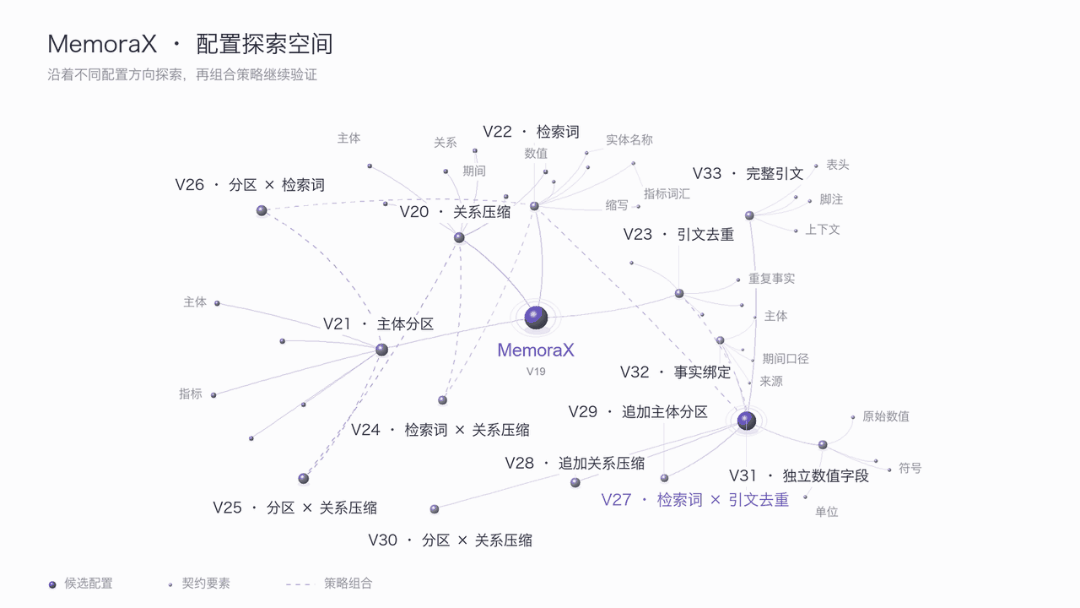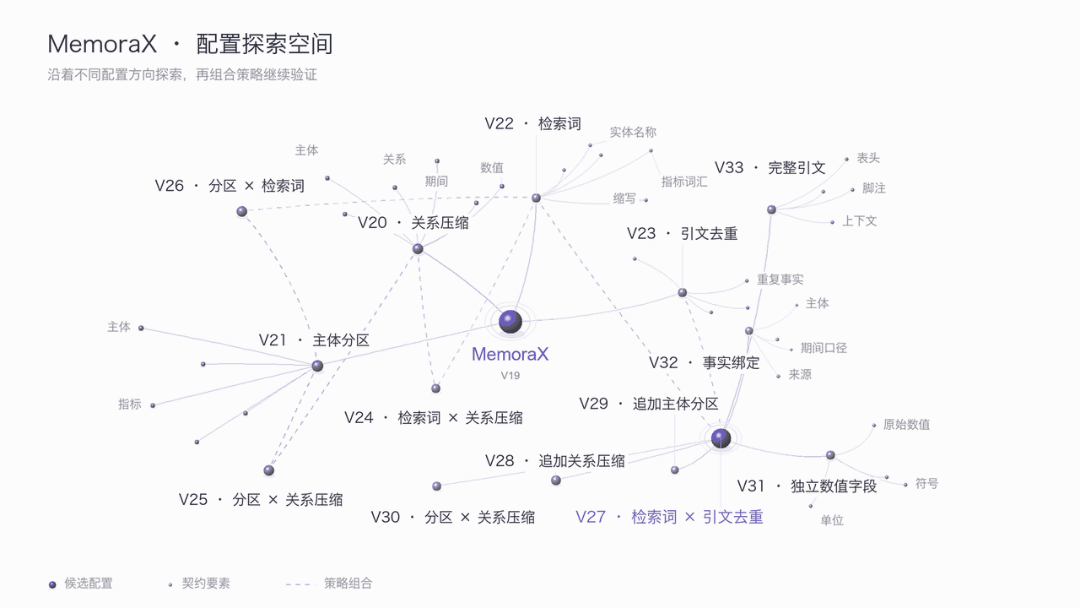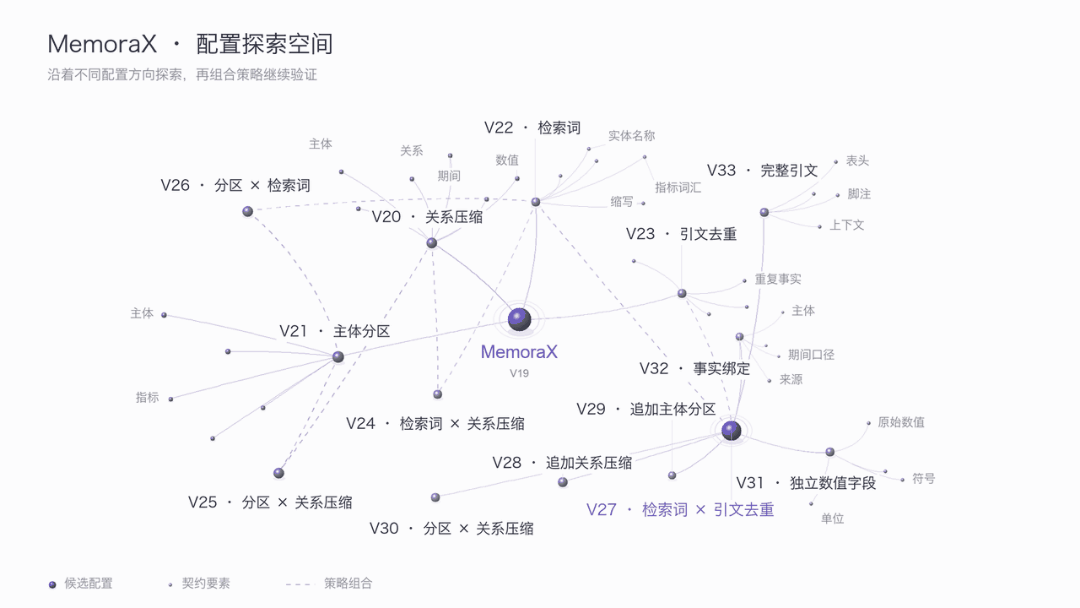
จากการค้นหาข้อมูล ไปจนถึงการจัดเตรียมหลักฐานที่สามารถสนับสนุนการตัดสินใจได้
ตัวอย่างเช่น ในงานวิเคราะห์ทางการเงินของบริษัทผลิตขนาดใหญ่ หลักฐานที่เกี่ยวข้องกับงานนั้นกระจัดกระจายอยู่ในเอกสารจำนวนมากที่เกี่ยวข้องกับอุตสาหกรรมเดียวกัน ซึ่งรวมถึงงบการเงินติดต่อกันสามปี ข้อมูลที่เปิดเผยโดยผู้จัดหา และคำอธิบายความเสี่ยง การค้นหาเนื้อหาที่เกี่ยวข้องกับหัวข้อโดยใช้เพียงคำสำคัญหรือความคล้ายคลึงทางความหมายนั้นสามารถทำได้ง่าย แต่เนื้อหาเหล่านั้นอาจไม่เกี่ยวข้องกับบริษัทหรือช่วงเวลาที่รายงาน การเก็บเฉพาะสรุปอาจทำให้พลาดข้อมูลเช่น หน่วยวัดตัวเลขและเงื่อนไขที่ความเสี่ยงนั้นเกิดขึ้น
สำหรับเรื่องนี้ MemoraX จะเริ่มต้นด้วยการแปลงข้อมูลบริบทเป็นความทรงจำที่มีโครงสร้างก่อน จากนั้นจะปรับเปลี่ยนวิธีการจัดระเบียบความทรงจำอย่างต่อเนื่องตามข้อเสนอแนะจากการตอบกลับ โดยมุ่งเน้นไปที่สถานการณ์การถาม-ตอบทางการเงิน และค่อยๆ พัฒนาให้สามารถรองรับได้อย่างครอบคลุมความแม่นยำของตัวเลข, การจัดรูปแบบของข้อมูลที่สอดคล้องกัน, และการตรวจสอบย้อนกลับไปยังแหล่งที่มาการแสดงออกของโมเดลความจำ; เมื่อทำการค้นหา จะนำหลักฐานเหล่านี้มาเชื่อมโยงกับปัญหาปัจจุบัน และวิเคราะห์สถานะสินค้าคงคลัง โครงสร้างการจัดซื้อ และความเสี่ยงที่อาจเกิดขึ้นร่วมกัน วิธีการจัดระเบียบนี้คำนึงถึงความต้องการของงานทางการเงินตัวเลขที่แม่นยำ มาตรฐานที่สอดคล้องกัน และแหล่งที่มาที่สามารถตรวจสอบได้ตามความต้องการของ
อัตราความแม่นยำในการทำงานของ MemoraX สำหรับภารกิจสุดท้ายเพิ่มขึ้นเมื่อเทียบกับ Codexประมาณ 20%นอกจากนี้ ตามการคำนวณต้นทุนจากการใช้งาน API จริง แผนนี้มีต้นทุนเมื่อเทียบกับแผนการควบคุม Codex แล้ว มีการลดค่าใช้จ่ายลงเกือบ 98% พร้อมทั้งยังสามารถเพิ่มอัตราการผ่านการตรวจสอบได้อย่างมีนัยสำคัญ
จากการรับฟังความคิดเห็นจากผู้ตอบกลับไปจนถึงการปรับปรุงกลยุทธ์: การพัฒนาความจำ “วิธีการเก็บรักษา วิธีการค้นหากลับมา”
MemoraX ได้ศึกษาวิธีการเลือกและจัดระเบียบข้อมูลที่เกี่ยวข้องกับความทรงจำอย่างต่อเนื่อง โดยอิงจากข้อเสนอแนะจากการทำงาน โดยเฉพาะในเรื่องของหลักฐานที่ขาดหาย ความสับสนในความสัมพันธ์ระหว่างข้อมูล และการอ้างอิงที่ซ้ำซ้อน และยังคงสะสมประสบการณ์เหล่านี้ไปเรื่อยๆ ในระหว่างการฝึกฝนตัวอย่างการปฏิสัมพันธ์ระหว่างการตัดสินใจในการเขียนข้อมูลที่เกี่ยวข้อง การจดจำเนื้อหา และผลลัพธ์จากการใช้งานในภายหลังใช้สำหรับการปรับปรุงโมเดลการจดจำ หลังจากการฝึกอบรมแล้ว โมเดลนั้นจะเข้าร่วมในรอบการทำงานใหม่ และข้อมูลที่ได้จากการดำเนินการจะถูกนำกลับมาใช้เพื่อปรับปรุงกลยุทธ์การเขียนและการฝึกอบรมต่อไป สร้างวัฏจักร RSI ที่โมเดลและการปฏิสัมพันธ์กับงานส่งเสริมซึ่งกันและกัน ในกระบวนการนี้ โมเดลจะค่อยๆ พัฒนาขึ้นAdaptation to the Memory Representation Characteristics of Financial Scenariosจัดเก็บค่าสำคัญเชิงตัวเลขเข้ากับเงื่อนไขที่เกี่ยวข้อง แยกแยะระหว่างผู้มีส่วนเกี่ยวข้องที่แตกต่างกัน ช่วงเวลาการรายงาน และแหล่งที่มา และสร้างความสัมพันธ์ระหว่างข้อเท็จจริงกับหลักฐานจากเอกสารต้นฉบับ 36 รอบของการวนซ้ำ RSI,MemoraX อัตราการเรียกคืนหลักฐาน (Evidence Recall Rate) อยู่ที่ 96.49% และอัตราความแม่นยำของงาน (Task Accuracy) เพิ่มขึ้นจาก 33.33% เป็น 73.33%
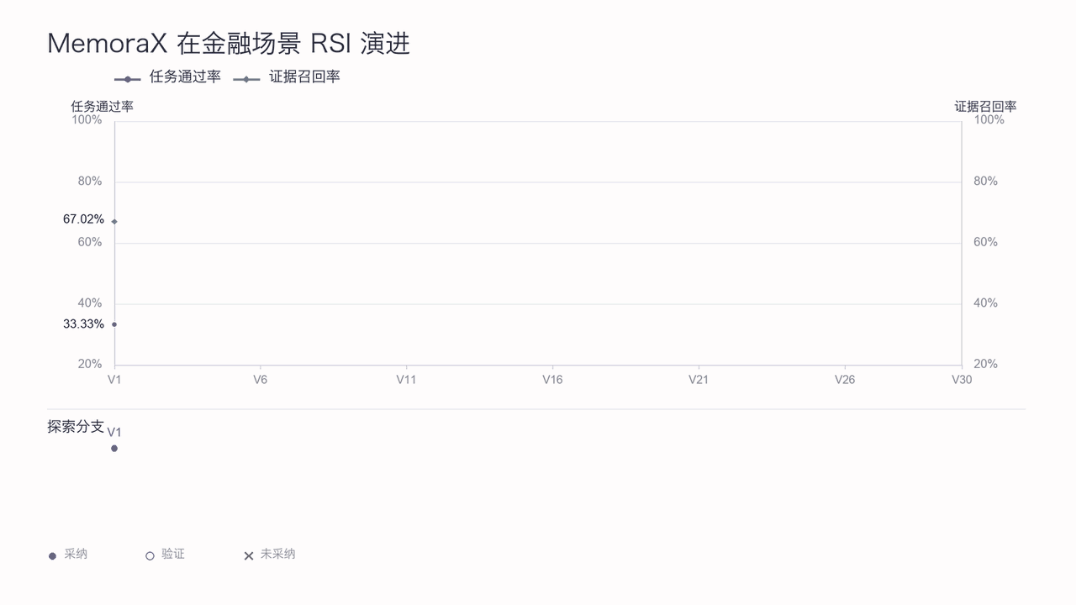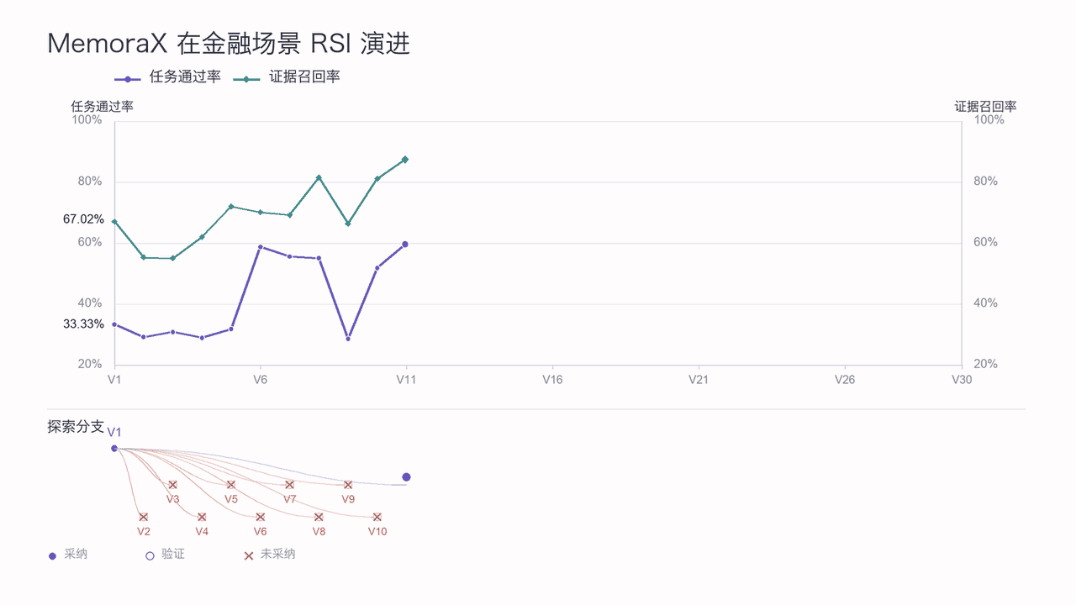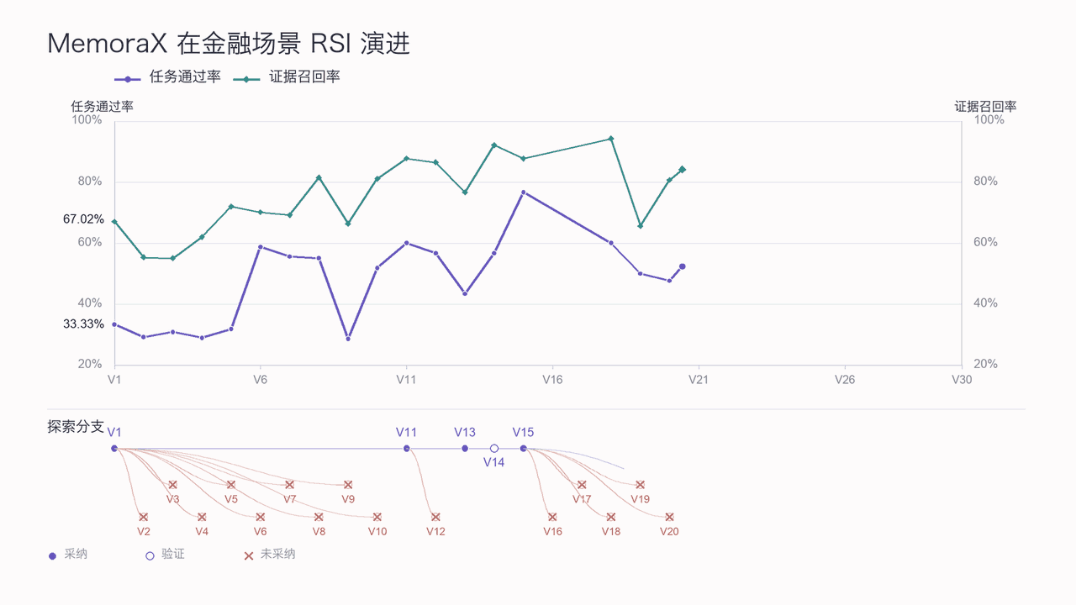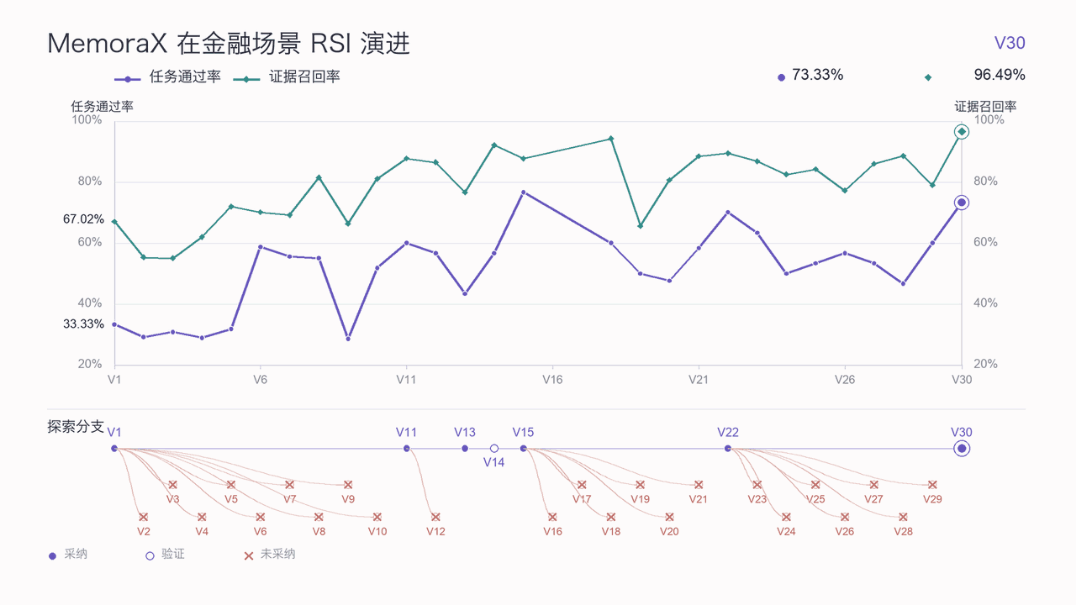
สำหรับนักวิจัยที่ต้องติดตามรายงานทางการเงินและประกาศต่าง ๆ ในระยะยาว ความทรงจำที่สร้างขึ้นจากชุดข้อมูลเดียวกันสามารถนำมาใช้ในการแก้ปัญหาที่แตกต่างกันได้ ซึ่งช่วยลดค่าใช้จ่ายในช่วงแรก และข้อมูลที่ได้รับจากการวิเคราะห์ในภายหลังสามารถนำมาปรับปรุงเนื้อหาความทรงจำและกลยุทธ์การใช้งานต่อไปได้อีกด้วยทำให้คำตอบสมบูรณ์ยิ่งขึ้น ทำให้การใช้งานมีความคุ้มค่ามากขึ้น และทำให้ประสบการณ์สามารถสะสมต่อเนื่องไปได้ร่วมกันสร้างคุณค่าในการปฏิบัติงานของ MemoraX ในงานทางการเงินที่ซับซ้อน
(3)การอนุมานทางคณิตศาสตร์ที่ซับซ้อน: จากข้อมูลป้อนกลับจากประสบการณ์ไปสู่กลยุทธ์การแก้ปัญหาแบบอัตโนมัติ
ในการทดลองการอนุมานทางคณิตศาสตร์ที่มีความยากสูง MemoraX ได้สำรวจเพิ่มเติมถึงการใช้ประสบการณ์ในอดีตและข้อมูลป้อนกลับจากการตรวจสอบเพื่อสนับสนุน Agent ในการปรับปรุงการอนุมานและเพิ่มประสิทธิภาพกลยุทธ์การแก้ปัญหาอย่างต่อเนื่องในปัญหาที่ซับซ้อน ในโจทย์การปรับแต่งที่มีความยากในระดับ IMO (International Mathematical Olympiad) Agent สามารถทำได้ดีหลังจากการฝึกฝนประมาณ การแก้ปัญหาต่อเนื่องเป็นเวลา 4 ชั่วโมง มีการเรียกใช้โมเดลมากกว่า 600 ครั้งในที่สุดก็พบสิ่งที่ได้รับการยืนยันแล้ว 21 โซลูชันสี่เหลี่ยมผืนผ้าที่ดีที่สุด โดยเมื่อเทียบกับโปรแกรม OpenAI Codex ช่วยลดเวลาในการแก้ปัญหาได้ 13% และลดต้นทุนได้ 98%
จากหลักฐานความล้มเหลวสู่ทางออกที่ดีที่สุด: การปรับปรุงการอนุมานอย่างต่อเนื่องจากข้อเสนอแนะ
Matilda 16×16 เป็นปัญหาการออกแบบที่มีความซับซ้อนระดับ IMO: ต้องใช้สี่เหลี่ยมผืนผ้าจำนวนน้อยที่สุดเท่าที่จะเป็นไปได้เพื่อครอบคลุมทั้งหมด 240 ช่องในกรอบ 16×16 โดยที่แต่ละแถวและแต่ละคอลัมน์จะต้องมีช่องว่างเหลืออยู่เพียงช่องเดียว แค่ตำแหน่งของช่องว่างเหล่านั้นก็มีความซับซ้อนมากแล้ว 20.9 ล้านล้านรูปแบบการจัดเรียงที่เป็นไปได้ปัญหาไม่ได้อยู่เพียงแค่การหาวิธีแก้ที่เป็นไปได้เท่านั้น แต่ยังรวมถึงการพิสูจน์ด้วยว่าไม่มีวิธีอื่นที่สามารถใช้รูปสี่เหลี่ยมจัตุรัสน้อยลงได้
ในการเผชิญกับความท้าทายนี้ ตัวแทน (Agent) ได้ทำงานร่วมกันอย่างต่อเนื่องในด้านการสร้างโครงสร้างการค้นหา (construction search), การพิสูจน์รูปแบบ (formal proof), การสร้างแบบจำลองที่แม่นยำ (precise modeling), และการตรวจสอบอย่างอิสระ (independent audit) ระบบได้ค้นพบตัวเลือกโครงสร้างที่เป็นไปได้จำนวน 27 และ 23 ชิ้นในตอนแรก แต่การอธิบายถึงความเหมาะสมที่สุดของโครงสร้างที่ 23 ชิ้นนั้นถูกปฏิเสธโดยการตรวจสอบอย่างอิสระ
MemoraX สามารถสะสมโซลูชันที่เคยนำเสนอมาก่อนหน้านี้ กระบวนการอนุมาน และข้อเสนอแนะจากการตรวจสอบได้อย่างต่อเนื่อง โมเดลความจำจะดึงเอาประสบการณ์การปรับปรุงที่มีประสิทธิภาพจากเส้นทางที่ประสบความสำเร็จ และเปลี่ยนประสบการณ์ที่ล้มเหลวให้กลายเป็นข้อมูลอ้างอิงสำหรับการปรับเปลี่ยนกลยุทธ์การแก้ปัญหาในครั้งต่อไป:
- การแก้ไขข้อผิดพลาดจากความทรงจำ: จากข้อสรุปที่ผิดพลาดไปสู่การแก้ไขความทรงจำ การตรวจสอบอิสระได้ปฏิเสธหลักฐานความเหมาะสมที่ผิดพลาดใน 23 กรณี ซึ่งผลักดันให้ Agent ต้องทบทวนข้อสรุปเดิมอีกครั้ง และนำข้อมูลการตรวจสอบที่ว่า “ทางออกที่เป็นไปได้ไม่จำเป็นต้องเป็นทางออกที่ดีที่สุด” มาใช้ในการปรับปรุงความจำ เพื่อหลีกเลี่ยงไม่ให้การอนุมานในขั้นตอนต่อไปทำผิดพลาดซ้ำเดิม
- Strategic self-optimization: From memory updates to method improvements. Based on the previous candidate solutions refined from the memory-based model and the validation feedback, the Agent was guided to adjust its modeling method to incorporate the constraints of empty spaces and rectangular boundaries into the solution search process. As a result, 22 and 21 better solutions were found respectively.
- การทบทวนความจำอีกครั้ง: จากการตรวจสอบผลลัพธ์ไปสู่การปรับปรุงอย่างต่อเนื่อง เอเจนต์ดำเนินการตรวจสอบอย่างละเอียดและใช้เครื่องมือในการเรียกใช้เพื่อหาคำตอบที่แม่นยำ จนสามารถยืนยันความเหมาะสมที่สุดของคำตอบได้ และนำผลการตรวจสอบใหม่ไปปรับปรุงโมเดลความจำเพื่อสร้างความจำการแก้ปัญหาที่ดีขึ้น ซึ่งจะเป็นข้อมูลอ้างอิงสำหรับปัญหาที่คล้ายกันในอนาคต
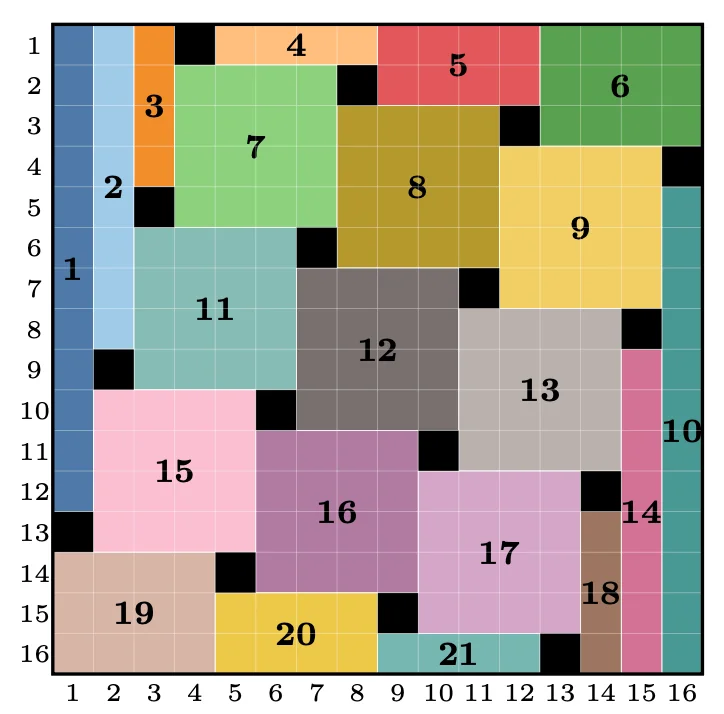
วิธีการวางกระเบื้องสี่เหลี่ยมที่ดีที่สุดสำหรับปัญหา Matilda 16×16 โดยมี 21 ชิ้น ช่องสี่เหลี่ยมดำเป็นพื้นที่ว่าง และพื้นที่สีต่างๆ คือกระเบื้องสี่เหลี่ยม
นี่แสดงให้เห็นถึงความสามารถในการปรับปรุงตัวอย่างต่อเนื่องของ Agent ในงานคณิตศาสตร์ที่ซับซ้อน:ประสบการณ์ทางประวัติศาสตร์ไม่ได้เป็นเพียงการบันทึกการอนุมานแบบสถิตอีกต่อไป แต่สามารถนำมาใช้ร่วมกับข้อมูลการตรวจสอบใหม่ๆ เพื่อปรับเปลี่ยนกลยุทธ์การแก้ปัญหาในขั้นตอนต่อไปได้อย่างต่อเนื่อง
เริ่มต้นจากความทรงจำ สู่ Agent ที่พัฒนาอย่างต่อเนื่อง
MemoraX AI ถูกก่อตั้งโดย ฮาว เจียนเย่ (Hao Jianye) อดีตหัวหน้าห้องปฏิบัติการการตัดสินใจและการอนุมานของ Huawei, หัวหน้าห้องปฏิบัติการอัลกอริทึมโมเดลขนาดใหญ่, และผู้เชี่ยวชาญชั้นนำด้านการตัดสินใจอัจฉริยะ โดยมุ่งเน้นไปที่โมเดลความจำของ Agent รุ่นต่อไปที่สามารถเรียนรู้และพัฒนาได้
โมเดลความจำที่พัฒนาขึ้นโดยทีมงานเอง ซึ่งอิงตามเทคโนโลยี Agentic RL ได้คว้ารางวัลชนะเลิศในรายชื่อโมเดลความจำที่มีอิทธิพลที่สุดในระดับโลก และได้รับการรายงานและความสนใจอย่างกว้างขวางจากสื่อต่างๆ ทั้งในและต่างประเทศ เช่น MIT Technology Review โซลูชันด้านความจำของทีมงานได้รับการนำไปใช้งานอย่างแพร่หลายในบริษัทชั้นนำในอุตสาหกรรมต่างๆ เช่น การเขียนโปรแกรม การแพทย์ การเงิน ความปลอดภัย และสมาร์ทโฮม และยังเป็นพันธมิตรทางกลยุทธ์ของ Huawei Cloud และ Tencent Cloud อีกด้วย
ในปัจจุบัน ทีมงานกำลังพัฒนา RSI ที่อิงตามโมเดลความจำ (memory-based model) ให้ลึกซึ้งยิ่งขึ้น เพื่อให้ Agent สามารถเรียนรู้จากประสบการณ์ที่สะสมและนำมาใช้ซ้ำได้ และพัฒนาตนเองอย่างต่อเนื่อง ซึ่งจะช่วยเสริมสร้างความได้เปรียบในด้านความจำของ AI ให้แข็งแกร่งยิ่งขึ้น นอกจากนี้ ยังเร่งการนำไปใช้ในสถานการณ์ต่างๆ และส่งเสริมการพัฒนาโมดูลความจำให้เป็นมาตรฐานและการพัฒนาเชิงพาณิชย์ในวงกว้างสำหรับผลิตภัณฑ์ทั้งสำหรับฝั่ง B2B และ B2C
คำปิดท้าย
สิ่งสำคัญของ Agent RSI ไม่ใช่เพียงแค่ทำให้ AI ทำงานได้ดีขึ้นในแต่ละภารกิจเท่านั้น แต่ยังเกี่ยวข้องกับให้ทุกครั้งที่ดำเนินการเป็นพื้นฐานสำหรับการพัฒนาความสามารถในครั้งต่อไปวิธีการที่ประสบความสำเร็จ ประสบการณ์จากความล้มเหลว และเงื่อนไขที่เหมาะสม ถูกสะสมผ่านความทรงจำระยะยาว และถูกแปลงเป็นคำแนะนำการดำเนินการที่สามารถนำกลับมาใช้ซ้ำในงานใหม่ๆ ผลลัพธ์การดำเนินการใหม่ๆ นั้นก็ช่วยขับเคลื่อนการอัปเดตประสบการณ์ การปรับปรุงกลยุทธ์การจดจำ และการเรียนรู้อย่างต่อเนื่องของโมเดลพื้นฐานการจดจำ
MemoraX กำลังสำรวจอยู่ในเรื่องของเส้นทางการพัฒนาแบบสองทิศทางที่เสริมสร้างซึ่งกันและกันระหว่างความทรงจำและการปรับปรุงตนเองของเอเจนต์ในทางหนึ่ง การให้ความทรงจำเป็นฐานสำหรับการสะสมประสบการณ์อย่างต่อเนื่องและการถ่ายโอนประสบการณ์ระหว่างงานที่แตกต่างกันสำหรับ Agent RSI; ในทางอื่น การดำเนินการและการตอบสนองในงานจริงจะช่วยในการเรียนรู้และพัฒนาของความทรงจำเองอย่างต่อเนื่อง
เมื่อทุกครั้งที่ทำภารกิจสามารถนำไปสู่การเรียนรู้ และทุกครั้งที่ได้รับข้อเสนอแนะสามารถช่วยในการปรับปรุง ความสามารถของ Agent ก็จะไม่จำกัดอยู่เพียงแค่การดำเนินการครั้งเดียว แต่จะมีโอกาสที่จะพัฒนาอย่างต่อเนื่องและเปลี่ยนแปลงไปในทางที่ดี
บทความนี้มาจาก "Machine Heart" โดยผู้เขียน "Machine Heart"
有用吗?