Từ trí nhớ đến sự tự tiến hóa: Bước ngoặt quan trọng của Agent trên con đường trở thành RSI
Gần đây, các phòng thí nghiệm AI hàng đầu trên thế giới đang liên tục phát đi một thông điệp chung:AI đang từ việc hỗ trợ con người hoàn thành nhiệm vụ, chuyển sang tham gia vào quá trình nghiên cứu và phát triển, cũng như cải thiện bản thân.
Tháng 9, OpenAI thông báo đã đạt được mục tiêu trung gian trong việc tạo ra “sinh viên thực tập nghiên cứu AI tự động hóa” và dự định sẽ xây dựng những “nhà nghiên cứu AI tự động hóa” thực thụ trước tháng 3 năm 2028. Giám đốc khoa học của OpenAI, Jakub Pachocki, cũng đã đăng một bài viết dài thảo luận về triển vọng phát triển của công nghệ Tự cải thiện Tái quy (Recursive Self-Improvement – RSI). Ngày 21 tháng 9, OpenAI tiếp tục xác định việc phát triển các nhà nghiên cứu AI tự động hóa và nâng cao khả năng nghiên cứu và phát triển AI một cách liên tục là hướng chiến lược quan trọng cho giai đoạn tiếp theo.
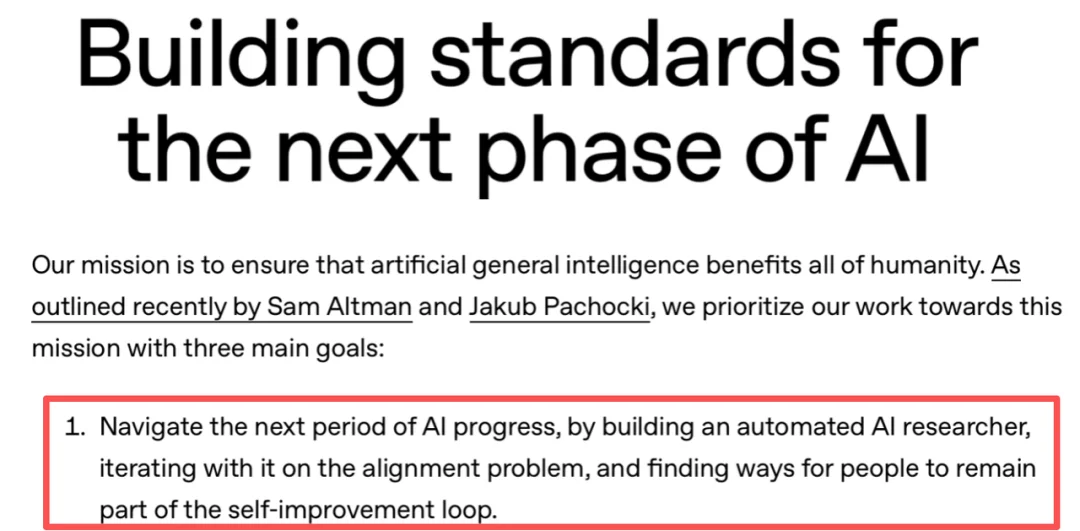
OpenAI đã công bố tuyên bố chiến lược chính thức vào ngày 21 tháng 9 năm 2026, trong đó xác định việc nghiên cứu các nhà nghiên cứu AI tự động hóa và khả năng tự cải thiện theo cách tuần hoàn là những mục tiêu quan trọng cho giai đoạn tiếp theo.
Mặt khác, Anthropic cũng đã công bố một bộ dữ liệu đáng chú ý: tính đến tháng 8 năm nay, Claude đã hoạt động được khoảng... 26% trong công việc nghiên cứu và phát triển trí tuệ nhân tạo nội bộ đóng vai trò chủ đạo.Càng ngày càng nhiều nhiệm vụ nghiên cứu và phát triển vốn trước đây do các nhà nghiên cứu thực hiện, đang được giao cho AI thực hiện dưới sự giám sát của con người.
Từ OpenAI đến Anthropic, RSI đang chuyển từ một ý tưởng công nghệ xa xôi thành một phần trọng tâm của các chương trình nghiên cứu và phát triển tại các phòng thí nghiệm hàng đầu trên thế giới. AI không chỉ còn là công cụ để giải quyết các vấn đề bên ngoài nữa, mà còn bắt đầu tham gia vào việc thúc đẩy sự phát triển của chính năng lực của mình.
Nhưng yếu tố then chốt nhất trên con đường tiến hóa không ngừng này là:
Làm thế nào AI có thể biến những khám phá và sai lầm trong quá khứ thành nền tảng thực sự cho sự tiến bộ lần sau, thay vì phải bắt đầu từ đầu mỗi khi đối mặt với một nhiệm vụ mới?
Trí nhớ là nền tảng then chốt giúp Agent liên tục tự cải thiện bản thân. Nó không chỉ để lại kết quả của mỗi lần khám phá, mà còn để lại những kinh nghiệm có thể được các nhiệm vụ tiếp theo kế thừa và sử dụng lại, tạo cơ hội cho khả năng của Agent được nâng cao vượt ra ngoài phạm vi của một nhiệm vụ đơn lẻ, và liên tục tiến hóa thông qua sự tích lũy không ngừng.
01 | Từ việc tích lũy kinh nghiệm đến sự tiến hóa liên tục:
Trí nhớ làm thế nào hỗ trợ RSI (Relative Strength Index)
Để Agent liên tục cải thiện khả năng trong quá trình thực hiện nhiệm vụ, chìa khóa nằm ở việc chia sẻ và áp dụng kinh nghiệm từ các nhiệm vụ trước cho các nhiệm vụ sau:Từ những khám phá trong quá khứ, rút ra những phương pháp hiệu quả, áp dụng chúng một cách chính xác trong các nhiệm vụ mới, và liên tục điều chỉnh, tối ưu hóa dựa trên kết quả thực hiện. Trong đó, việc ghi nhớ và truy xuất dữ liệu đóng vai trò quan trọng trong hai khâu liên kết với nhau.
Việc ghi nhớ yêu cầu phải xác định các phương pháp hiệu quả, kết luận thất bại và điều kiện áp dụng từ quá trình thực hiện phức tạp, để những nhiệm vụ trong quá khứ thực sự để lại những kinh nghiệm có thể tái sử dụng; trong khi việc truy xuất thông tin từ ký ức lại cần tìm ra chính xác các phương pháp lịch sử và bằng chứng quan trọng phù hợp với yêu cầu của nhiệm vụ mới, nhằm tránh bỏ sót kinh nghiệm và áp dụng sai lầm.
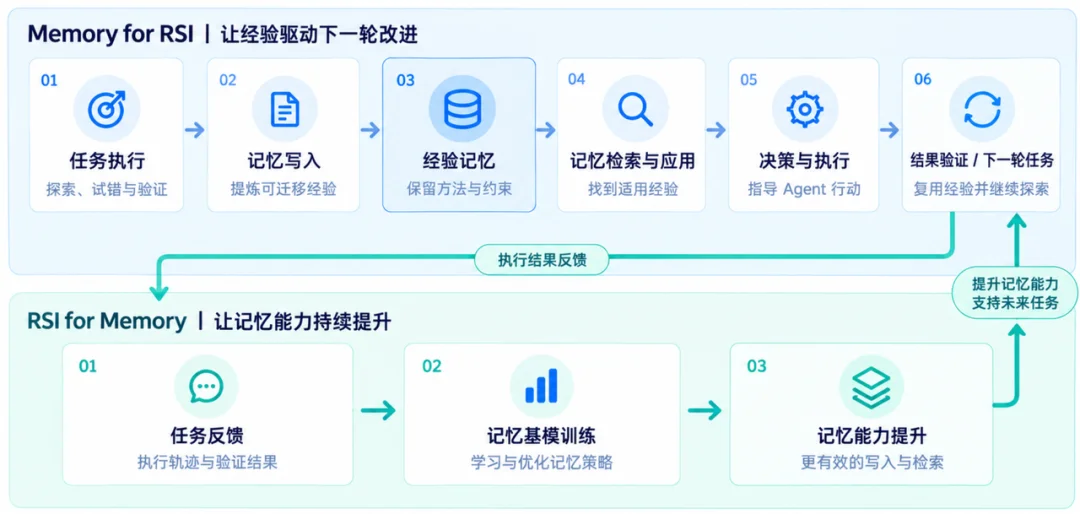
Tiến xa hơn nữa, phản hồi từ nhiệm vụ cũng có thể được sử dụng để kiểm tra giá trị thực tế của kinh nghiệm. Bằng cách cập nhật liên tục nội dung trí nhớ và áp dụng những phản hồi hiệu quả vào việc huấn luyện các mô hình cơ sở về trí nhớ, chúng ta có thể thúc đẩy sự cải thiện khả năng ghi nhớ, tạo ra một quá trình trong đó sự tích lũy kinh nghiệm và việc cải thiện của Agent hỗ trợ lẫn nhau.
02 | Học tập và tiến hóa của trí nhớ:
Hãy để Agent liên tục trở nên mạnh mẽ hơn từ kinh nghiệm.
Dựa trên nhu cầu tích lũy kinh nghiệm, tái sử dụng giữa các nhiệm vụ và liên tục cải thiện trong Agent RSI, MemoraX đã xây dựng...Học hỏi từ kinh nghiệm, chuyển giao kiến thức từ kinh nghiệm và tối ưu hóa thông qua phản hồiMột hệ thống khả năng ghi nhớ dựa trên trí nhớ làm trung tâm, thông qua việc xây dựng dữ liệu ghi nhớ chất lượng cao, tổ chức ghi nhớ một cách linh hoạt và tối ưu hóa dựa trên phản hồi từ các nhiệm vụ thực tế, liên tục huấn luyện mô hình cơ bản của trí nhớ, giúp Agent liên tục học hỏi và cải thiện quá trình ra quyết định cũng như thực hiện từ kinh nghiệm trong quá khứ.
Học hỏi từ nhiệm vụ: Biến quá trình tích lũy kinh nghiệm thành khả năng của mô hình có thể được tối ưu hóa
Trong quá trình thực hiện nhiệm vụ, việc xác minh kết quả và điều chỉnh chiến lược sẽ liên tục tạo ra những kinh nghiệm mới.Những quyết định thành công cung cấp những phương pháp có thể tái sử dụng cho các nhiệm vụ tiếp theo, trong khi những kết luận thất bại đã được kiểm chứng giúp Agent loại bỏ các giải pháp không hiệu quả và giảm bớt việc thử nghiệm sai lầm lặp đi lặp lại.Nhưng giá trị của kinh nghiệm thường chỉ được thể hiện trong các nhiệm vụ sau này; việc tổng kết chính xác quá khứ không có nghĩa là có thể hỗ trợ tốt cho tương lai. Do đó, quá trình học hỏi từ kinh nghiệm không chỉ đòi hỏi phải nhận diện những kinh nghiệm đáng được giữ lại, mà còn cần lưu trữ cả cơ sở để xác minh chúng, các ràng buộc về môi trường và điều kiện áp dụng, nhằm tránh việc kinh nghiệm bị bỏ qua hoặc sử dụng sai cách. Điều này không thể được giải quyết đơn giản chỉ bằng cách tóm tắt hoặc nén thông tin.
Để đối mặt với thách thức này, MemoraX... Viết lại những ký ức thành các chiến lược có thể học hỏi, nhằm hướng tới lợi ích của nhiệm vụ trong tương lai, và liên tục xây dựng một hệ thống hoàn chỉnh bao gồm xây dựng môi trường, thu thập dữ liệu, tạo mẫu và đào tạo RL (Reinforcement Learning) quy mô lớn một cách tự chủ.Trong môi trường nhiệm vụ tương tác và có thể được xác minh, thu thập dữ liệu về quá trình thực hiện, lịch sử sử dụng và phản hồi xác thực, từ đó xây dựng các mẫu dữ liệu để huấn luyện liên quan đến quyết định ghi nhớ và hiệu quả sử dụng sau này; sau đó kết hợp với chất lượng hoàn thành nhiệm vụ tiếp theo, hiệu suất thực hiện và tình hình thử nghiệm lặp đi lặp lại để thiết kế tín hiệu phần thưởng, nhằm tối ưu hóa chiến lược ghi nhớ. Quá trình này giúp mục tiêu tối ưu hóa của mô hình không chỉ dừng lại ở độ chính xác trong việc trích xuất thông tin, mà còn được mở rộng hơn nữa.Ảnh hưởng thực tế của trí nhớ đối với chất lượng các nhiệm vụ tiếp theo, hiệu suất thực hiện và việc lặp lại các bước thử nghiệm sai lầmHọc hỏi càng giúp ích cho việc xây dựng các chiến lược ghi nhớ để thực hiện các nhiệm vụ trong tương lai.
Di chuyển kiến thức từ kinh nghiệm: Hãy để những kinh nghiệm trong quá khứ hướng dẫn các nhiệm vụ mới
Kinh nghiệm có thể được lưu trữ, nhưng điều đó không có nghĩa là nó có thể được áp dụng hiệu quả trong các nhiệm vụ mới. Trước những mục tiêu nhiệm vụ khác nhau, các ràng buộc môi trường và các giai đoạn thực hiện khác nhau, Agent cần phải xác định chính xác những phương pháp đã được áp dụng trước đó là phù hợp, để tránh sự can thiệp của thông tin không liên quan và việc chuyển giao kinh nghiệm một cách sai lầm.
Để đạt được điều này, MemoraX sẽViệc tách rời nội dung trí nhớ khỏi cấu trúc truy cậpDựa trên nhiệm vụ hiện tại, điều chỉnh động các điểm truy cập vào bộ nhớ và mối liên hệ liên quan, để thông tin lịch sử giống nhau có thể phù hợp với các nhu cầu sử dụng khác nhau.
Trong khía cạnh tìm kiếm, hãy tiến thêm một bước nữa…Học hỏi mối quan hệ tương ứng giữa yêu cầu của nhiệm vụ hiện tại và bằng chứng quan trọng trong quá khứ thông qua việc huấn luyện mô hìnhKết hợp việc nhận diện dựa trên bằng chứng có độ chi tiết cao với việc loại bỏ sự nhầm lẫn trong trí nhớ tương tự, để nâng cao khả năng xác định các kinh nghiệm quan trọng, phân biệt giữa “liên quan đến chủ đề” và “bằng chứng chính xác”.
Trong giai đoạn sử dụng thực tế, MemoraX kết hợp tình trạng nhiệm vụ hiện tại với tiến độ thực hiện,Chuyển đổi những kinh nghiệm tổng quát được tích lũy qua thời gian thành hướng dẫn hành động có mục tiêu rõ ràng, các ràng buộc về thao tác và các tiêu chuẩn xác thực cụ thể.Và điều chỉnh một cách linh hoạt theo các giai đoạn của nhiệm vụ, để kinh nghiệm lịch sử thực sự được tích hợp vào quá trình ra quyết định và thực hiện của Agent.
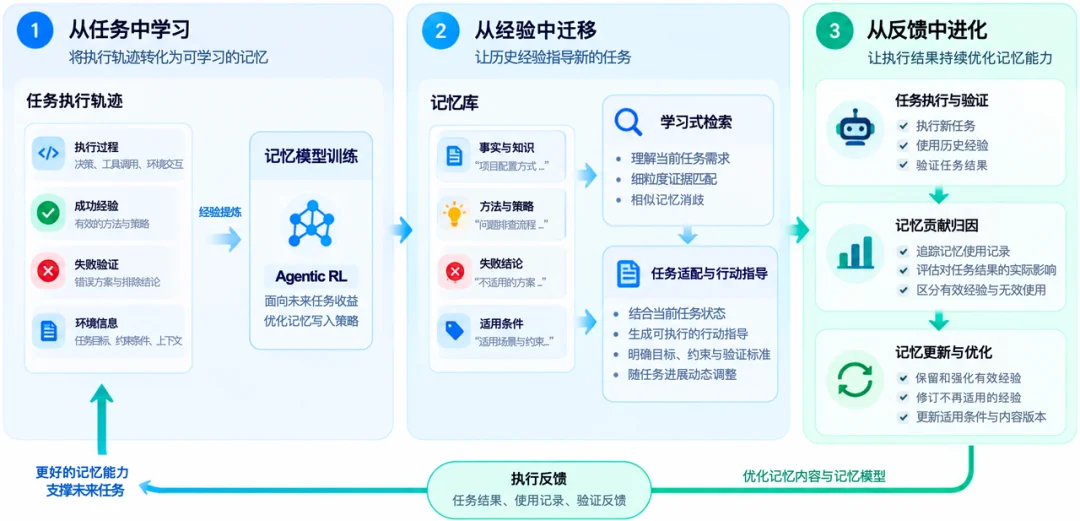
Tiến hóa từ phản hồi: Giúp kết quả thực hiện liên tục cải thiện khả năng ghi nhớ
Trong quá trình liên tục cải tiến của RSI (Relative Strength Index), kinh nghiệm lịch sử không phải lúc nào cũng có hiệu quả. Những nhiệm vụ mới có thể không chỉ xác nhận tính hiệu quả của các phương pháp hiện có mà còn làm lộ ra những hạn chế của chúng.Làm thế nào để sử dụng phản hồi từ việc thực hiện để đánh giá giá trị thực sự của kinh nghiệm và từ đó liên tục tối ưu hóa trí nhớ là một khâu quan trọng trong việc tự cải thiện bản thân một cách liên tục.
Thách thức cốt lõi trong đó là Phân bổ Công lao Về Trí nhớ (Memory Credit Assignment)Các nhiệm vụ có phạm vi dài có thể sử dụng nhiều kinh nghiệm lịch sử khác nhau, nhưng những kinh nghiệm nào thực sự ảnh hưởng đến quyết định của Agent, và những kinh nghiệm nào chỉ được đọc mà không phát huy tác động? Ngay cả khi nhiệm vụ cuối cùng thành công, việc xác định đóng góp thực tế của từng ký ức vẫn là một vấn đề cần giải quyết.
Để đối mặt với thách thức này, MemoraX sẽKết nối các phiên bản trí nhớ, hồ sơ sử dụng thực tế với phản hồi về việc thực hiện nhiệm vụThe text describes the process of tracking whether historical experiences have actually influenced the actions of an Agent, as well as the performance of tasks and the results of verifications after their use. Based on this information, the system continuously evaluates and iterates on the existing memories.Hãy giữ gìn và củng cố những kinh nghiệm hữu ích, đồng thời sửa đổi những kinh nghiệm không còn phù hợp theo phản hồi từ các nhiệm vụ mới.
Những phản hồi thực tế này cũng góp phần...Đào tạo liên tục cho mô hình cơ sở trí nhớCung cấp nền tảng dữ liệu và tín hiệu tối ưu hóa, giúp cải thiện trí nhớ không chỉ thông qua việc cập nhật ở cấp độ nội dung, mà còn mở rộng hơn nữa đến khả năng học hỏi của mô hình trí nhớ về giá trị kinh nghiệm và chiến lược ghi nhớ.
03 | Từ việc tích lũy kinh nghiệm đến việc nâng cao năng lực:
Thực hành sử dụng RSI trong nhiều tình huống với MemoraX
Đối với Agent RSI, điều đáng quan tâm hơn không chỉ là kết quả của một nhiệm vụ cụ thể, mà là...Liệu kinh nghiệm lịch sử có thể được tích lũy, sửa đổi liên tục và tiếp tục tạo ra giá trị trong các nhiệm vụ sau này hay không.
Trong quá trình này, đã được kiểm chứng rằng khả năng lặp lại kinh nghiệm một cách liên tục, khả năng di chuyển kiến thức giữa các nhiệm vụ khác nhau và khả năng tối ưu hóa thông qua phản hồi là rất quan trọng trong ba loại nhiệm vụ phức tạp: lập trình dài hạn, phân tích tài chính và suy luận toán học phức tạp. Đồng thời, cũng đã được làm rõ hơn cách trí nhớ thúc đẩy sự cải thiện về chất lượng và hiệu quả của Agent trong các nhiệm vụ có thời gian thực hiện dài.
(1)Lập trình phức tạp ở quy mô lớn: Từ việc lặp lại dựa trên kinh nghiệm đến việc nâng cao khả năng thực hiện các dự án phức tạp
Các thí nghiệm lập trình phức tạp với quy mô dài được áp dụng trong lĩnh vực truyền thông, tài chính, logistics, v.v. Trong 5 ngành lớn và 13 nhiệm vụ phát triển hệ thống cấp công nghiệp, tổng cộng đã thực hiện 78 lần chạy thử nghiệm phát triển, với tổng thời gian phát triển vượt quá 300 giờ, trong đó mỗi lần chạy thử nghiệm dài nhất kéo dài hơn 12 giờ. Kết quả, tỷ lệ thành công của giải pháp tăng cường trí nhớ MemoraX tăng hơn 20%, đồng thời tổng lượng Token tiêu thụ bởi Agent lập trình chính giảm đi hơn 20%.
Từ việc tích lũy kinh nghiệm đến việc cải thiện theo nguyên lý đệ quy: Con đường tự động hoàn thiện của trí nhớ
Để giải quyết vấn đề khó khăn trong việc tích lũy và tối ưu hóa kinh nghiệm liên tục trong quá trình thực hiện nhiệm vụ đối với bộ nhớ tĩnh truyền thống, nhóm MemoraX đã đề xuấtPhương pháp RSI (Recursive Self-Improvement) dựa trên Mô hình Bộ nhớ (Memory Model-Driven RSI)Bằng cách kết hợp mô hình trí nhớ tự phát triển với hệ thống Agent, mô hình trí nhớ chuyên dụng có trách nhiệm chiết xuất và cập nhật trí nhớ thủ tục từ quá trình thực hiện của Agent và phản hồi trực tuyến. Hệ thống Agent sau đó áp dụng trí nhớ đó vào các nhiệm vụ thực tế, tạo thành một cơ chế lặp vòng khép kín bao gồm việc rút ra kinh nghiệm, áp dụng vào nhiệm vụ, xác minh hiệu quả và cập nhật trí nhớ. Nhờ đó, những kinh nghiệm hữu ích có thể được tích lũy, tối ưu hóa và hướng dẫn cho các nhiệm vụ tiếp theo. Trong các trường hợp huấn luyện được tạo thành từ các nhiệm vụ lập trình dài hạn,Qua nhiều vòng cải thiện và tối ưu hóa về khả năng ghi nhớ, chất lượng của trí nhớ chương trình đã được nâng cao hơn 10%.
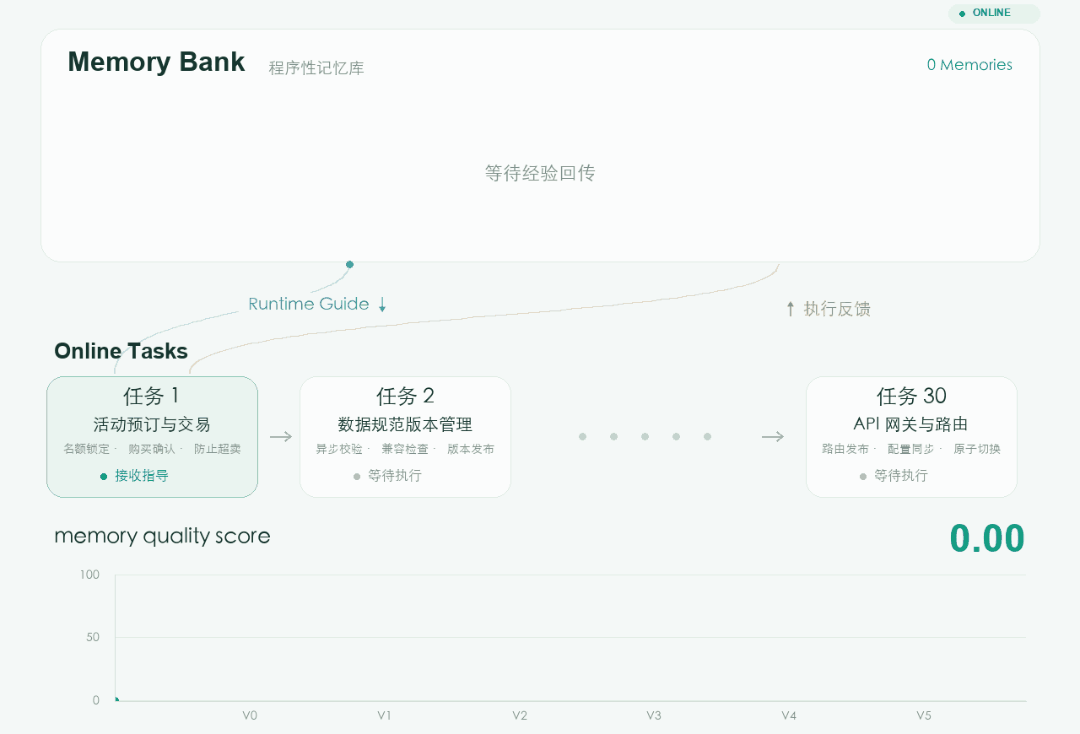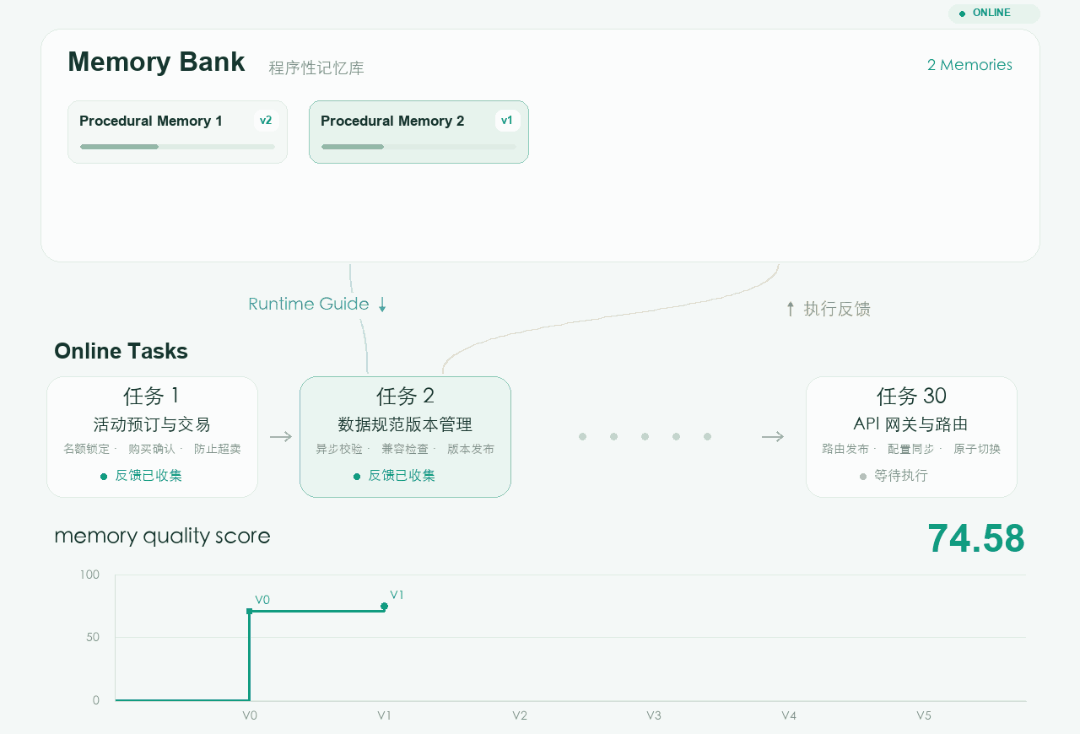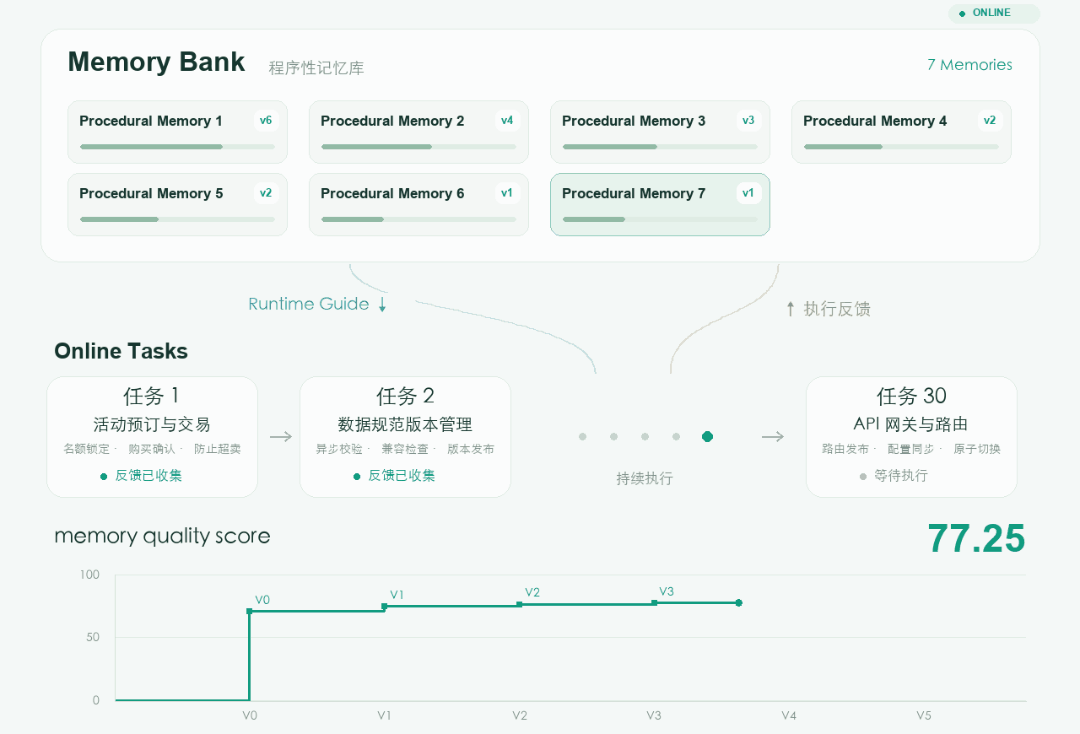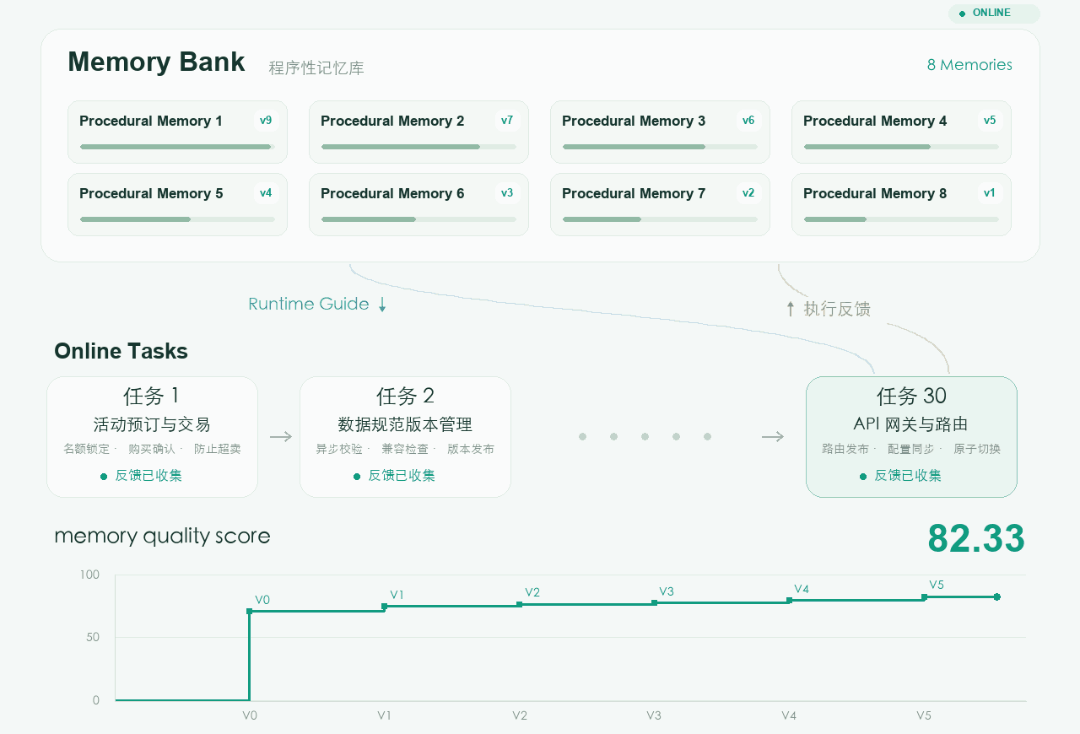
Với kinh nghiệm từ những lần lặp lại và cải tiến liên tục, chúng tôi đối mặt với thách thức phát triển dự án công nghệ phức tạp kéo dài 335 giờ.
Khi những kinh nghiệm đã tích lũy được tách rời khỏi nhiệm vụ học tập ban đầu, liệu chúng vẫn có thể phát huy tác dụng lớn đến mức nào khi đối mặt với những thách thức mới trong công việc kỹ thuật?
Để làm được điều này, chúng ta sẽ áp dụng những kinh nghiệm đã tích lũy được vào các dự án phát triển kỹ thuật phức tạp mới.Trong 13 nhiệm vụ kỹ thuật phần mềm phức tạp, đã có tổng cộng 78 lần thực hiện quá trình phát triển và chạy thử nghiệm, với tổng thời gian phát triển vượt quá 335 giờ, trong đó mỗi lần chạy thử nghiệm dài nhất kéo dài hơn 12 giờ.Những nhiệm vụ này không chỉ đơn thuần là việc sửa đổi mã nguồn, mà còn liên quan đến logic kinh doanh phức tạp, sự phụ thuộc giữa các mô-đun và hàng loạt bài kiểm thử – đó thực sự là những thách thức trong công nghệ.
Cuối cùng, tỷ lệ thành công tăng lên hơn 20%, đồng thời tổng lượng Token tiêu thụ bởi Coding Agent giảm đi hơn 20%.
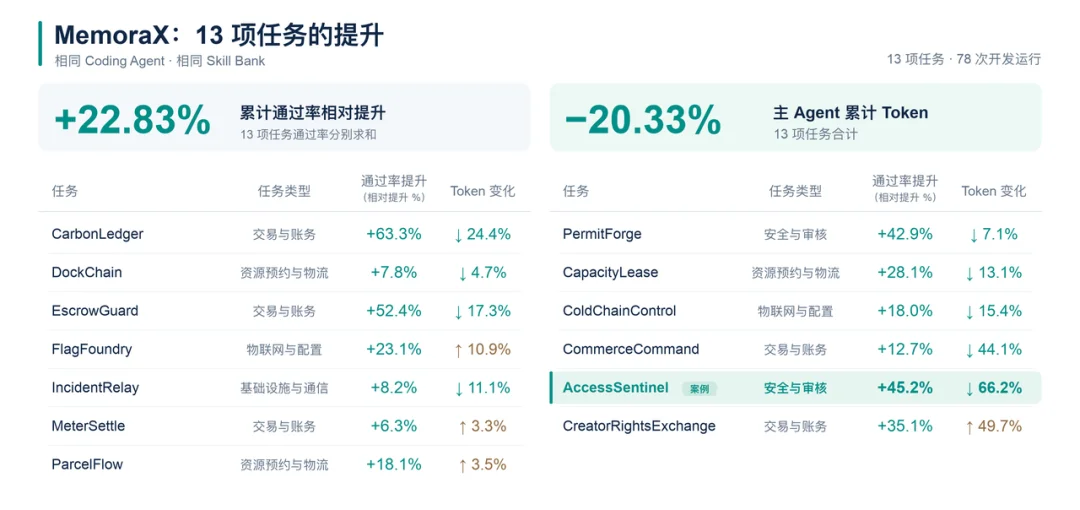
Trong đó, AccessSentinel là một trường hợp đại diện có độ khó cao. Agent cần xây dựng một hệ thống kiểm soát quyền truy cập cấp doanh nghiệp hoàn chỉnh và đảm bảo rằng...Các ràng buộc an ninh nghiêm ngặt。
Với sự hỗ trợ của mô hình trí nhớ,Kinh nghiệm lịch sử không còn chỉ là tài liệu tham khảo thông tin tĩnh nữa, mà có thể tham gia liên tục vào quá trình thực hiện và xác minh của Agent theo sự thay đổi của trạng thái nhiệm vụ.Từ phút thứ 43 sau khi bắt đầu quá trình phát triển cho đến 2 giờ 30 phút sau, trí nhớ được ghi nhận tại các điểm mốc quan trọng khác nhauTự nguyện cung cấpHướng dẫn cụ thể:
- Khi quyền truy cập thiết bị bị hủy bỏ,Không chỉ cần cấm thiết bị đăng nhập lại, mà còn phải đảm bảo rằng các tài khoản đã đăng nhập trước đó không thể tiếp tục truy cập vào hệ thống.
- Khi khôi phục phiên bản cũ của chính sách bảo mật,Vừa cần giữ lại hồ sơ lịch sử, vừa phải ngăn chặn việc các quyền đã bị hủy bỏ được khôi phục một cách không mong muốn.
- Khi xử lý các đơn đăng ký theo lô,Trước hết, hãy kiểm tra xem tất cả các đơn đăng ký có đáp ứng đầy đủ yêu cầu hay không. Chỉ khi tất cả đều được chấp thuận thì mới có thể thực hiện chung một lần, nhằm tránh tình trạng một số đơn thành công trong khi một số khác thất bại.
Trong quá trình thử nghiệm,Tỷ lệ thông qua trung bình sau ba lần chạy tăng lên hơn 45%, trong khi tổng lượng Token tiêu thụ bởi Agent Lập trình chính giảm đi hơn 66%.
(2) Phân tích tài chính phức tạp: Từ việc tích lũy bằng chứng đến việc cải thiện tự chủ và liên tục
Nghiên cứu tài chính đòi hỏi phải tổng hợp từ một lượng lớn tài liệu phân tán để đưa ra những phán đoán phân tích đầy đủ và đáng tin cậy. Ngoài việc tìm kiếm dữ liệu liên quan, Agent còn cần hiểu chính xác về đối tượng, thời gian và phương pháp thống kê trong bối cảnh phức tạp, thiết lập mối liên hệ giữa các bằng chứng khác nhau, nhằm tránh ảnh hưởng đến kết luận cuối cùng do thiếu thông tin hoặc sự nhầm lẫn về phương pháp tính toán.
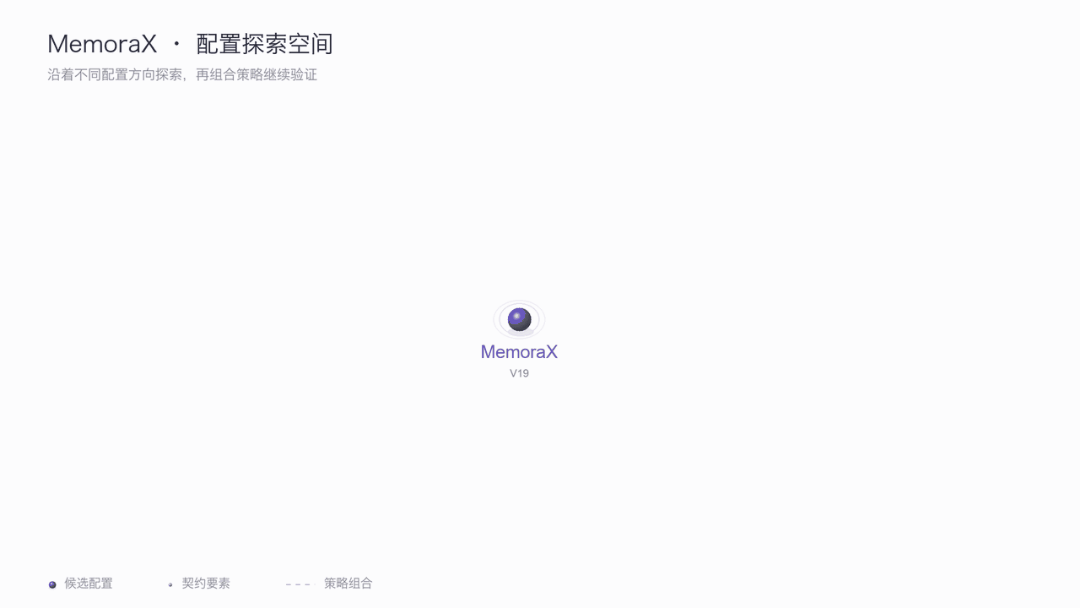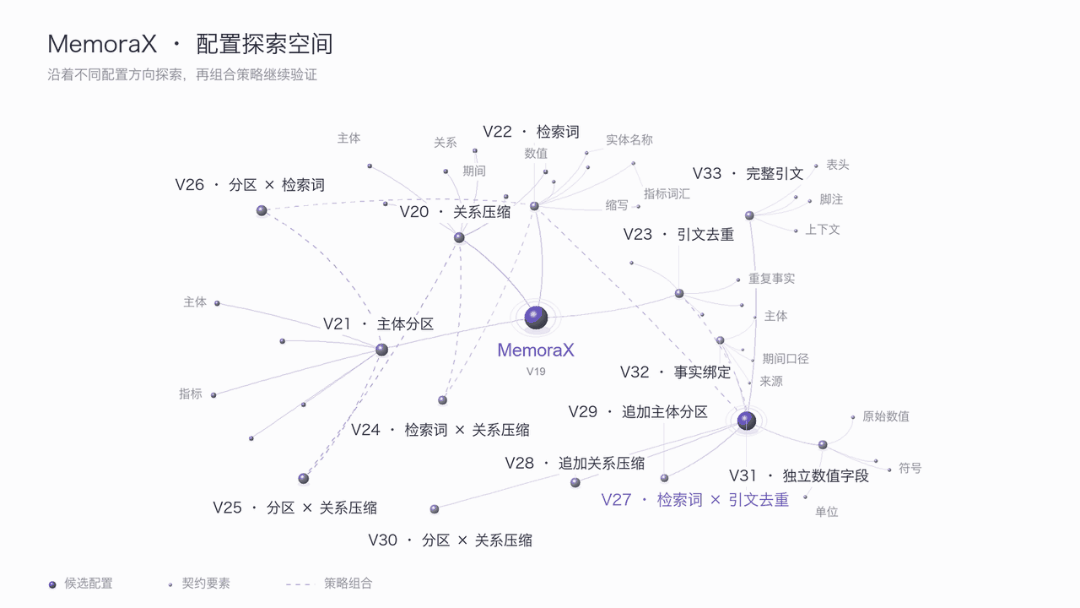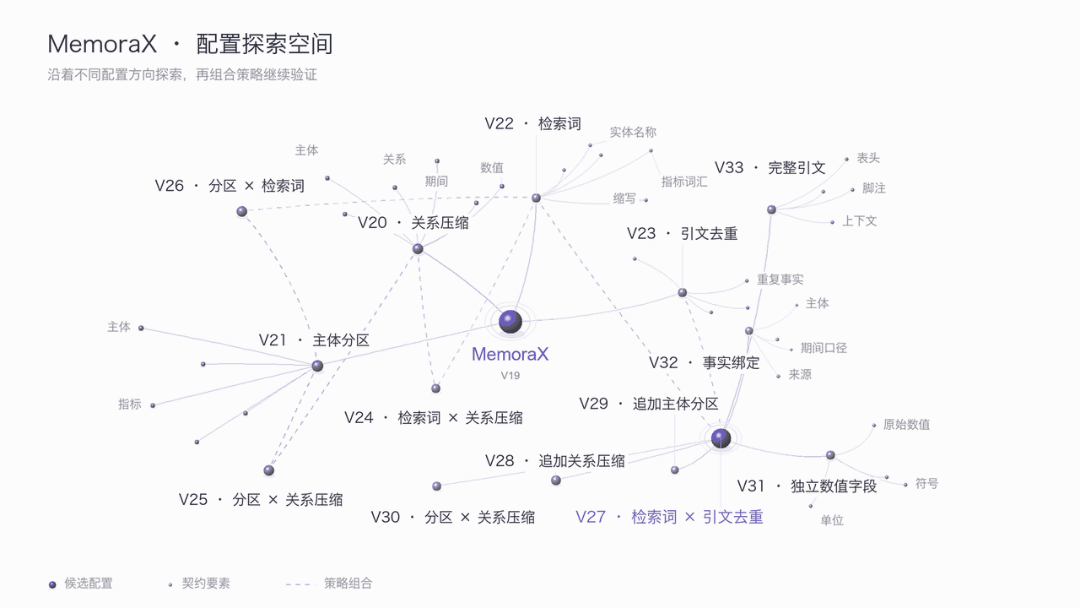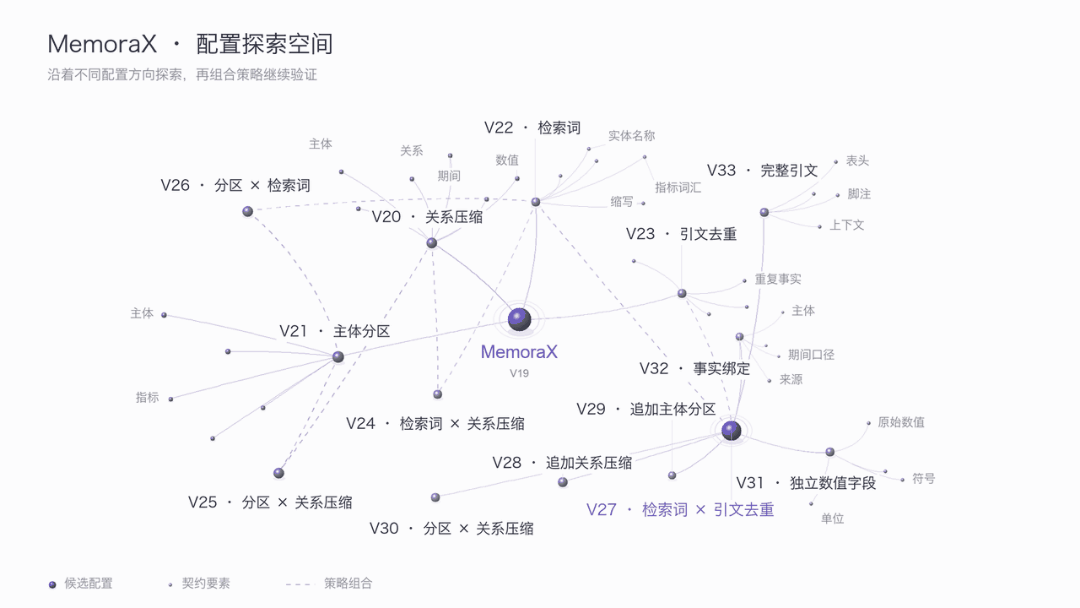
MemoraX quan tâm đến hai vấn đề liên quan mật thiết với nhau:Làm thế nào để bằng chứng hỗ trợ cho một câu trả lời đầy đủ, và làm thế nào để sử dụng những câu hỏi trong câu trả lời đó để cải thiện cách lưu trữ và truy xuất bằng chứng một cách tốt hơn.Để đạt được điều này, MemoraX đã tiến hành các thí nghiệm dựa trên tiêu chuẩn FinRank uy tín trong lĩnh vực tài chính, tiêu chuẩn này bao gồm báo cáo tài chính thực tế của 22 công ty niêm yết Mỹ trong các ngành dược phẩm, dầu khí và ô tô, cung cấp một lượng lớn dữ liệu tài chính phức tạp xuyên công ty và xuyên chu kỳ. Xung quanh những nhiệm vụ này, MemoraX sử dụng phản hồi từ các nhiệm vụ để liên tục tối ưu hóa cấu trúc bộ nhớ và khả năng truy xuất thông tin, tạo thành một vòng lặp tuần hoàn RSI gồm các bước “thực hiện – phản hồi – cải thiện bộ nhớ – thực hiện lại”. Hơn 30 lần lặp lại phối hợp giữa mô hình trí nhớ và hệ thống phân tích tài chính,cuối cùngTỷ lệ thu hồi chuỗi bằng chứng gần 100%, so với nhiệm vụ CodeX, tỷ lệ hoàn thành chính xác tăng lên 20% và chi phí giảm gần 98%.
Từ việc tìm kiếm dữ liệu đến việc tổ chức các bằng chứng có thể hỗ trợ việc đưa ra phán đoán
Lấy nhiệm vụ phân tích tài chính của một doanh nghiệp sản xuất lớn làm ví dụ, các bằng chứng liên quan đến nhiệm vụ này được phân tán trong một lượng lớn tài liệu ngành tương tự bao gồm báo cáo tài chính ba năm liên tiếp, thông tin từ nhà cung cấp và mô tả rủi ro. Chỉ dựa vào từ khóa hoặc mức độ tương đồng ngữ nghĩa, rất dễ tìm thấy nội dung liên quan đến chủ đề nhưng không thuộc về doanh nghiệp mục tiêu hoặc khoảng thời gian báo cáo; nếu chỉ giữ lại phần tóm tắt, có thể bỏ sót thông tin về đơn vị đo lường số liệu và các điều kiện để xác định rủi ro.
Để đối phó với điều này, MemoraX trước tiên chuyển đổi các tài liệu ngữ cảnh thành trí nhớ có cấu trúc, sau đó điều chỉnh cách tổ chức trí nhớ dựa trên phản hồi từ người trả lời. Quá trình này được lặp đi lặp lại, nhằm phù hợp hơn với các tình huống trả lời câu hỏi trong lĩnh vực tài chính, từng bước hình thành một hệ thống có khả năng xử lý các câu hỏi một cách hiệu quả.Số liệu chính xác, độ rộng kênh phù hợp và nguồn gốc có thể truy ngược đượcĐại diện đầu ra của mô hình trí nhớ; khi truy xuất thông tin, lại liên kết và sử dụng những bằng chứng này dựa trên vấn đề hiện tại, để phân tích tình hình tồn kho, cấu trúc mua sắm và các rủi ro tiềm ẩn. Cách tổ chức này đáp ứng được yêu cầu của các nhiệm vụ tài chính.Dữ liệu chính xác về số lượng, thông tin được cung cấp một cách nhất quán theo một tiêu chuẩn nhất định, và nguồn gốc của dữ liệu có thể được truy ngược được.Yêu cầu của [[MG SEG_E2CCACF77F23_SOURCE]].
Tỷ lệ hoàn thành nhiệm vụ cuối cùng của MemoraX cao hơn đáng kể so với Codex.Gần 20%Ngoài ra, dựa trên thống kê lượng API thực tế được sử dụng, chi phí của giải pháp nàySo với giải pháp đối chứng Codex, mức giảm chi phí lên đến gần 98%, đồng thời giúp đạt được tỷ lệ thông qua cao hơn và giảm đáng kể chi phí gọi dịch vụ.
Từ phản hồi của người trả lời đến việc lặp lại chiến lược: Cải thiện trí nhớ “Làm thế nào để lưu trữ, làm thế nào để tìm lại”
MemoraX dựa trên phản hồi từ các nhiệm vụ, liên tục tìm kiếm những cách lựa chọn và tổ chức thông tin trong trí nhớ nhằm khắc phục tình trạng thiếu sót bằng chứng, nhầm lẫn mối quan hệ và sự trùng lặp trong các liên kết, đồng thời không ngừng tích lũy kinh nghiệm trong các nhiệm vụ huấn luyện.Các mẫu tương tác giữa quyết định ghi liên quan, nội dung được ghi nhớ và hiệu quả sử dụng sau này,Dùng để tối ưu hóa mô hình trí nhớ. Sau khi được huấn luyện, mô hình đó tham gia vào một vòng công việc mới, và phản hồi từ việc thực hiện sẽ tiếp tục được sử dụng để cải thiện chiến lược ghi dữ liệu và quá trình huấn luyện tiếp theo, tạo thành một vòng lặp RSI (Response-System Interaction) trong đó sự tương tác giữa các nhiệm vụ và việc tối ưu hóa mô hình được thúc đẩy lẫn nhau. Trong quá trình này, mô hình dần dần phát triển và hoàn thiện.Đặc tính biểu diễn trí nhớ phù hợp với các scénari tài chínhLưu trữ các giá trị số liệu quan trọng kèm theo các điều kiện áp dụng tương ứng, phân biệt giữa các đối tượng, kỳ báo cáo và nguồn gốc khác nhau, và thiết lập mối liên hệ giữa các sự thật và bằng chứng trong văn bản gốc. Sau đó... 36 vòng RSI lặp lại (36 rounds of RSI iteration),MemoraX Tỷ lệ thu hồi bằng chứng đạt 96.49%, và độ chính xác của nhiệm vụ tăng từ 33.33% lên 73.33%.
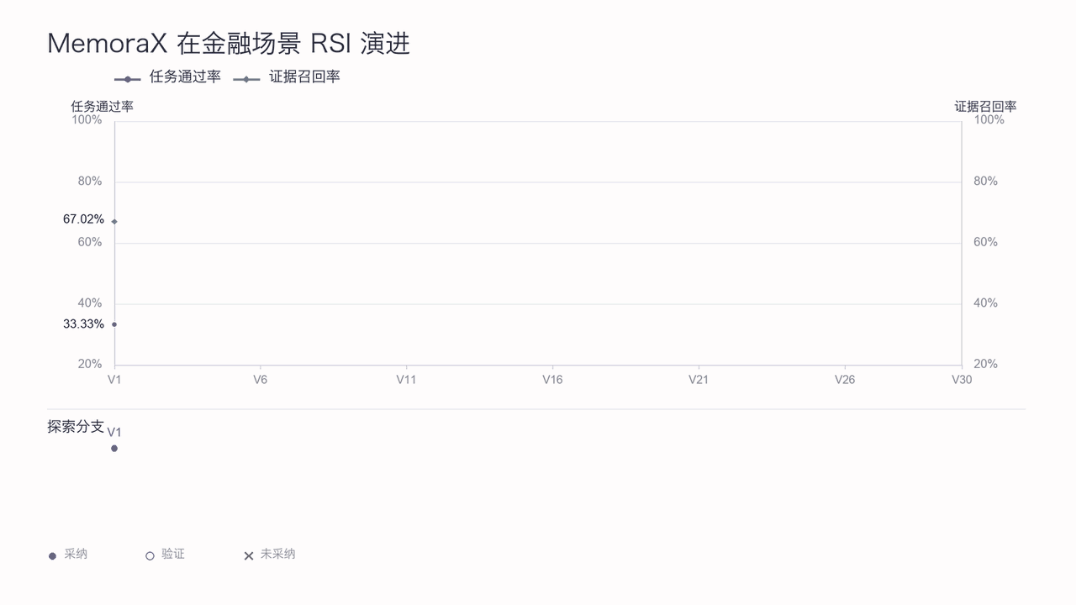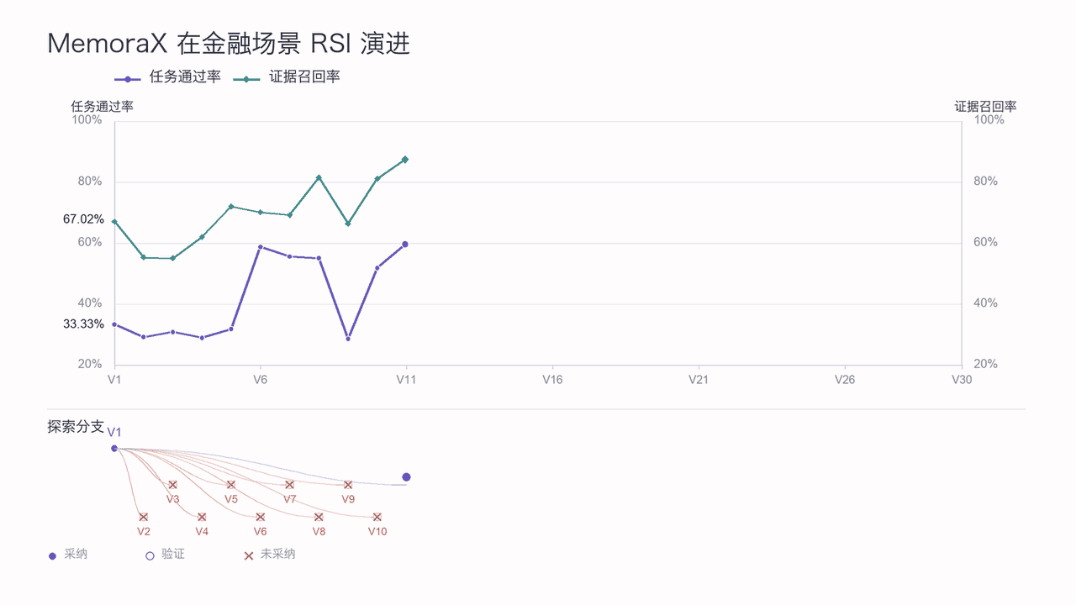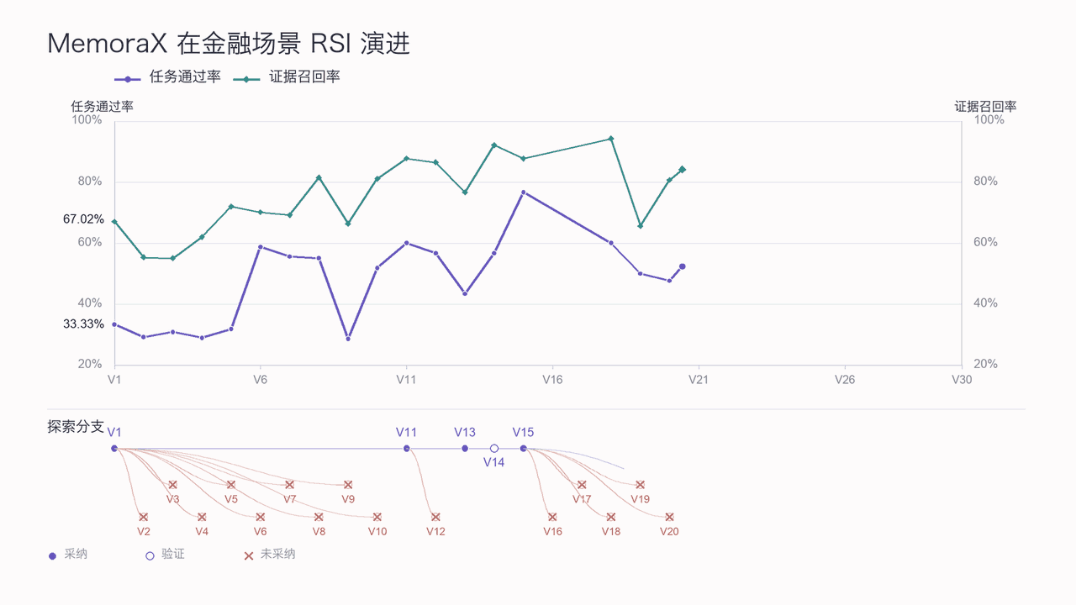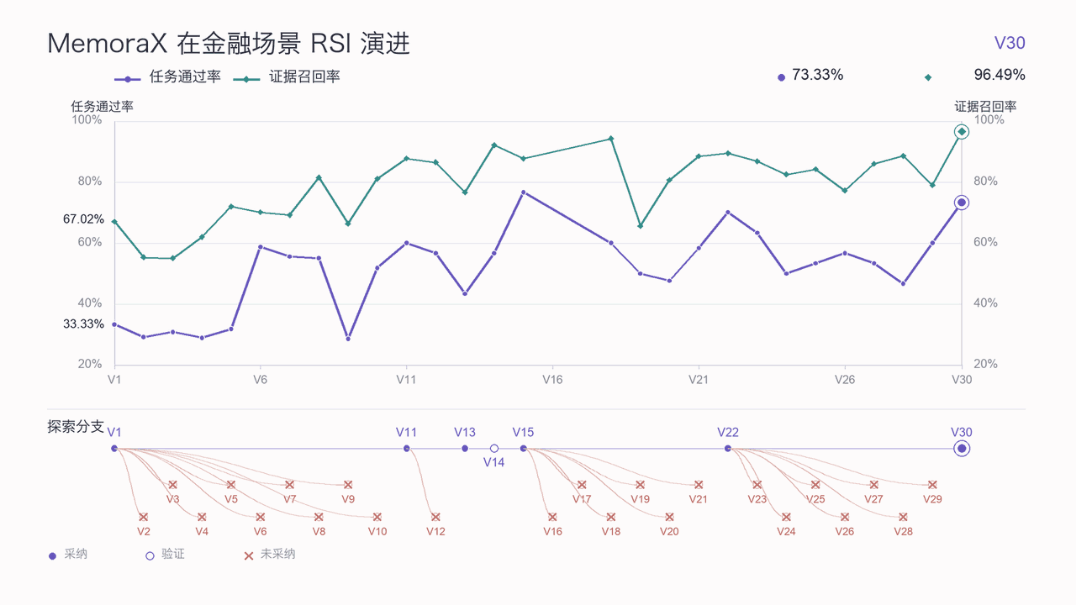
Đối với những nhà nghiên cứu cần theo dõi lâu dài các báo cáo tài chính và thông báo, những thông tin được ghi nhớ từ cùng một loạt tài liệu có thể được sử dụng để giải quyết các vấn đề khác nhau, giúp giảm bớt chi phí đầu tư ban đầu; phản hồi từ các phân tích sau này lại có thể tiếp tục giúp điều chỉnh nội dung thông tin được ghi nhớ và chiến lược sử dụng chúng.Hãy làm cho câu trả lời trở nên hoàn chỉnh hơn, việc sử dụng trở nên tiết kiệm hơn, và cho phép kinh nghiệm được tích lũy liên tục,Điều này cùng nhau tạo nên giá trị thực tiễn của MemoraX trong các nhiệm vụ tài chính phức tạp.
(3) Luận giải toán học phức tạp: Từ phản hồi thực tế đến việc tự động cập nhật chiến lược giải quyết vấn đề
Trong các thí nghiệm suy luận toán học có độ khó cao, MemoraX đã tiếp tục nghiên cứu cách sử dụng kinh nghiệm lịch sử và phản hồi xác thực để hỗ trợ Agent liên tục điều chỉnh quá trình suy luận và tối ưu hóa chiến lược giải quyết trong những vấn đề phức tạp. Trong những bài toán tối ưu hóa tổ hợp có độ khó tương đương IMO (International Mathematical Olympiad), Agent đã thể hiện khả năng này sau khoảng thời gian... Giải quyết liên tục trong 4 giờ, gọi mô hình hơn 600 lần,Cuối cùng đã tìm thấy phiên bản đã được xác thực. Giải pháp tối ưu cho 21 khối hình chữ nhật. So với giải pháp OpenAI Codex, thời gian giải quyết được giảm 13% và chi phí giảm 98%.
Từ bằng chứng thất bại đến giải pháp tối ưu: liên tục cải thiện khả năng suy luận thông qua phản hồi
Matilda 16×16 là một bài toán tối ưu hóa tổ hợp có độ khó cao theo quan điểm của tôi: yêu cầu sử dụng càng ít hình chữ nhật càng tốt để phủ toàn bộ 240 ô trong một mạng lưới 16×16, đồng thời đảm bảo rằng mỗi hàng và mỗi cột đều còn lại một ô trống. Chỉ riêng các vị trí trống đã chiếm một diện tích khá lớn. 20,9 tỷ tỷ khả năng sắp xếp khác nhauKhó khăn không chỉ nằm ở việc tìm ra một giải pháp khả thi, mà còn ở việc chứng minh rằng không tồn tại giải pháp nào sử dụng ít hình chữ nhật hơn.
Đối mặt với thách thức này, các Agent đã liên tục hợp tác trong việc xây dựng các cấu trúc tìm kiếm, chứng minh hình thức, mô hình hóa chính xác và kiểm toán độc lập. Hệ thống ban đầu đã tìm thấy 27 và 23 cấu trúc ứng cử, nhưng lập luận về tính tối ưu toàn cục của 23 cấu trúc đó đã bị bác bỏ bởi cuộc kiểm toán độc lập.
MemoraX có thể liên tục tích lũy các giải pháp được đề xuất trước đó, quá trình suy luận và phản hồi xác thực. Các mô hình trí nhớ trích xuất những kinh nghiệm cải thiện hiệu quả từ những hành trình thành công, đồng thời chuyển đổi những kinh nghiệm thất bại thành tài liệu tham khảo để điều chỉnh chiến lược giải quyết vấn đề trong các lần tiếp theo:
- Khả năng tự sửa lỗi trong trí nhớ: Từ những kết luận sai lầm đến việc sửa chữa lại trí nhớ. Độc lập kiểm toán đã bác bỏ 23 bằng chứng về tính tối ưu sai lầm, thúc đẩy Agent xem xét lại các kết luận hiện có, và sử dụng phản hồi xác minh rằng “giải pháp khả thi không đồng nghĩa với giải pháp tối ưu” để sửa đổi trí nhớ, nhằm tránh việc suy luận lặp lại cùng một sai lầm trong tương lai.
- Tự động tối ưu hóa chiến lược: Từ việc cập nhật dữ liệu trong bộ nhớ đến việc cải thiện các phương pháp thực hiện. Dựa trên các phương án được đề xuất trước đó được rút ra từ mô hình dựa trên trí nhớ và phản hồi từ việc xác thực, hướng dẫn Agent điều chỉnh phương pháp mô hình hóa, đồng bộ hóa các ràng buộc về vị trí trống và đường viền hình chữ nhật vào quá trình tìm kiếm giải pháp. Kết quả, đã tìm thấy 22 và 21 phương án tốt hơn lần lượt.
- Trí nhớ được tái lặp lại: Từ việc xác thực kết quả đến việc liên tục tối ưu hóa. Đại lý thông qua việc kiểm tra từng bước và sử dụng các công cụ gọi để tìm ra lời giải chính xác, cuối cùng xác nhận tính tối ưu của câu trả lời, sau đó phản hồi kết quả xác thực mới vào mô hình bộ nhớ để hoàn thiện quá trình xây dựng ký ức giải pháp, nhằm cung cấp thông tin tham khảo cho các vấn đề tương tự trong tương lai.
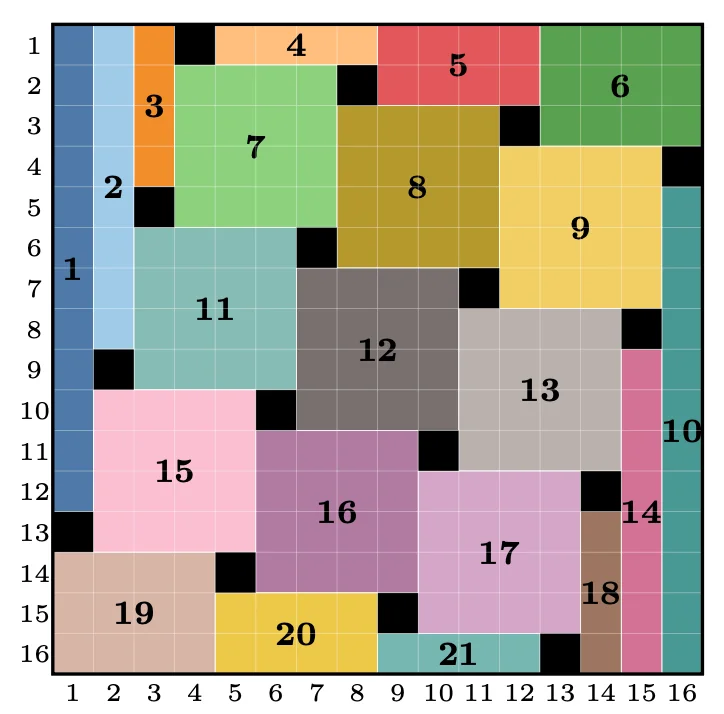
Cách bố trí tối ưu cho 21 khối hình chữ nhật trên bàn cờ Matilda kích thước 16×16. Các ô đen là những khoảng trống, các khu vực có màu sắc khác nhau là những viên gạch hình chữ nhật.
Điều này thể hiện khả năng lặp lại liên tục của Agent trong các nhiệm vụ toán học phức tạp:Kinh nghiệm lịch sử không còn chỉ là những ghi chép suy luận tĩnh lặng nữa, mà là công cụ có thể kết hợp với phản hồi xác thực mới để liên tục tham gia vào việc điều chỉnh các chiến lược giải quyết vấn đề sau này.
Bắt đầu từ ký ức, hướng tới sự tiến hóa không ngừng của Agent
MemoraX AI (忆纪元) được thành lập bởi Hào Kiến Nghiệp, cựu giám đốc Phòng Thí nghiệm Quyết định và Lập luận của Huawei, giám đốc Phòng Thí nghiệm Algo Mô hình Lớn, và chuyên gia hàng đầu về quyết định thông minh. Dự án này tập trung vào việc phát triển thế hệ tiếp theo của các mô hình trí nhớ Agent có khả năng học hỏi và tiến hóa.
Mô hình trí nhớ do đội ngũ tự phát triển, dựa trên công nghệ Agentic RL, đã giành chức vô địch trên các bảng xếp hạng trí nhớ uy tín toàn cầu và nhận được sự đưa tin rộng rãi cũng như sự quan tâm từ nhiều phương tiện truyền thông trong và ngoài nước, bao gồm MIT Technology Review. Giải pháp trí nhớ của đội ngũ được áp dụng rộng rãi tại các doanh nghiệp hàng đầu trong các lĩnh vực lập trình, y tế, tài chính, an ninh, nhà thông minh, và là đối tác chiến lược của Huawei Cloud/Tencent Cloud.
Hiện nay, đội ngũ đang tiếp tục nghiên cứu sâu hơn về RSI dựa trên các mô hình trí nhớ, giúp Agent không chỉ tích lũy và tái sử dụng kinh nghiệm mà còn học hỏi liên tục và tự phát triển, từ đó củng cố vị thế dẫn đầu trong lĩnh vực trí nhớ AI. Đồng thời, họ đang tăng tốc việc triển khai ứng dụng trong nhiều scénario khác nhau, thúc đẩy việc tiêu chuẩn hóa nghiên cứu và phát triển các mô-đun trí nhớ cho các sản phẩm dành cho ngành công nghiệp B (Business) và người tiêu dùng cá nhân (Consumer C), cũng như thúc đẩy quá trình thương mại hóa trên quy mô lớn.
Lời kết
Yếu tố then chốt của Agent RSI không chỉ nằm ở việc giúp AI hoạt động tốt hơn trong một nhiệm vụ cụ thể, mà còn ở...Hãy biến mỗi lần thực hiện thành nền tảng cho sự cải thiện năng lực lần tiếp theo.Các phương pháp thành công, kinh nghiệm thất bại và các điều kiện áp dụng được tích lũy thông qua trí nhớ lâu dài, và được chuyển hóa thành hướng dẫn hành động có thể tái sử dụng trong các nhiệm vụ mới; kết quả thực hiện mới lại tiếp tục thúc đẩy việc cập nhật kinh nghiệm, tối ưu hóa chiến lược ghi nhớ và quá trình học hỏi liên tục của mô hình cơ sở trí nhớ.
MemoraX đang khám phá...Con đường tiến hóa hai chiều trong đó trí nhớ và khả năng tự cải thiện của Agent thúc đẩy lẫn nhauMột mặt, giúp trí nhớ cung cấp một nền tảng kinh nghiệm được tích lũy liên tục và có thể chuyển giao giữa các nhiệm vụ cho Agent RSI; mặt khác, quá trình thực hiện và phản hồi trong các nhiệm vụ thực tế liên tục góp phần vào việc học hỏi và phát triển của chính trí nhớ.
Mỗi khi một nhiệm vụ hoàn thành đều mang lại kinh nghiệm, và mỗi phản hồi đều thúc đẩy sự cải thiện, khả năng của Agent không còn bị giới hạn ở việc thực hiện một lần duy nhất, mà có cơ hội trở thành một quá trình tích lũy liên tục và tự phát triển.
Bài viết này đến từ "Machine Heart", tác giả là "Machine Heart".
Liên kết bài viết:https://www.airai.cc/vi/ai-news/54/
有用吗?