De la memoria a la autoevolución: Un paso clave para que el Agente avance hacia RSI
Recientemente, los principales laboratorios de IA a nivel mundial han estado difundiendo intensivamente un mensaje:La IA está pasando de ayudar a las personas a completar tareas a participar en su propio desarrollo y mejora.
En septiembre, OpenAI anunció que había alcanzado los objetivos preliminares de crear "estudiantes de investigación en IA automatizados" y planea desarrollar verdaderos "investigadores en IA automatizados" para marzo de 2028. Jakub Pachocki, el científico jefe de OpenAI, publicó un artículo extenso en el mismo período, en el que discutió las perspectivas de desarrollo del auto-mejoramiento recursivo (Recursive Self-Improvement, RSI). El 21 de septiembre, OpenAI avanzó aún más al considerar a los investigadores en IA automatizados y la capacidad de mejora continua del desarrollo de IA como direcciones estratégicas clave para la siguiente etapa.
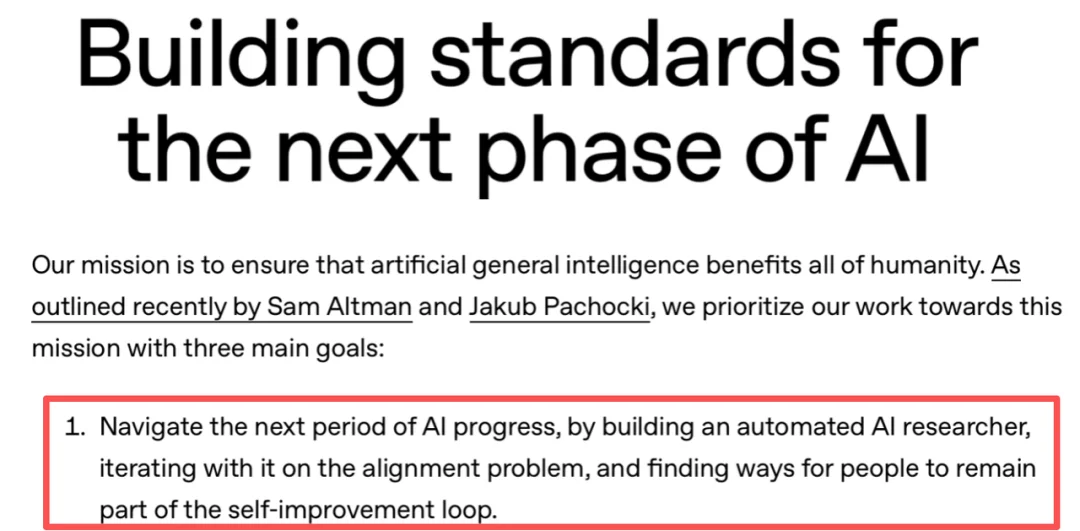
OpenAI publicó un comunicado estratégico oficial el 21 de septiembre de 2026, en el que señaló que la investigación en investigadores de IA automatizados y el auto-mejoramiento recursivo son objetivos importantes para la próxima etapa de su desarrollo.
Por otro lado, Anthropic también publicó un conjunto de datos que llama la atención: hasta agosto de este año, Claude ya ha logrado... El 26% del trabajo de investigación y desarrollo interno en IA desempeña un papel principal.Cada vez más tareas de investigación y desarrollo que antes eran realizadas por investigadores, ahora están siendo llevadas a cabo por la IA bajo la supervisión humana.
Desde OpenAI hasta Anthropic, el RSI está pasando de ser una idea tecnológica lejana a formar parte del programa de investigación y desarrollo central de los laboratorios más destacados del mundo. El AI ya no es solo una herramienta para resolver problemas externos, sino que también comienza a participar en el desarrollo de sus propias capacidades.
Pero la clave más importante de este camino de evolución constante es:
¿cómo puede el AI convertir los exploraciones y errores del pasado en la base para el próximo avance, en lugar de tener que empezar de cero cada vez que se enfrenta a una nueva tarea?
La memoria es la base fundamental que permite que los agentes se mejoren continuamente por sí mismos. Deja que cada exploración no solo deje como resultado la tarea completada, sino también experiencias que puedan ser heredadas y reutilizadas por tareas posteriores, lo que permite que la capacidad del Agente mejore y tenga la oportunidad de evolucionar más allá de una sola tarea, a través de una acumulación continua.
01 | De la acumulación de experiencias a la evolución continua:
Cómo el recuerdo respalda al RSI
Para que el Agente mejore continuamente en su ejecución, la clave es que la experiencia pueda trascender una sola tarea:Consolidar métodos efectivos de exploraciones pasadas, utilizarlos con precisión en nuevas tareas y ajustarlos y optimizarlos constantemente según los resultados de la ejecución. En este proceso, la escritura y recuperación de la memoria desempeñan un papel clave en la conexión entre estos dos aspectos.
Para escribir en la memoria, es necesario identificar métodos efectivos, conclusiones de fracaso y sus condiciones de aplicación a partir de trayectorias de ejecución complejas, de modo que las tareas pasadas dejen realmente experiencias reutilizables; por otro lado, la recuperación de la memoria requiere encontrar con precisión los métodos históricos y pruebas clave que sean adecuados para las necesidades de las nuevas tareas, para evitar la omisión de experiencias y la transferencia incorrecta de conocimientos.
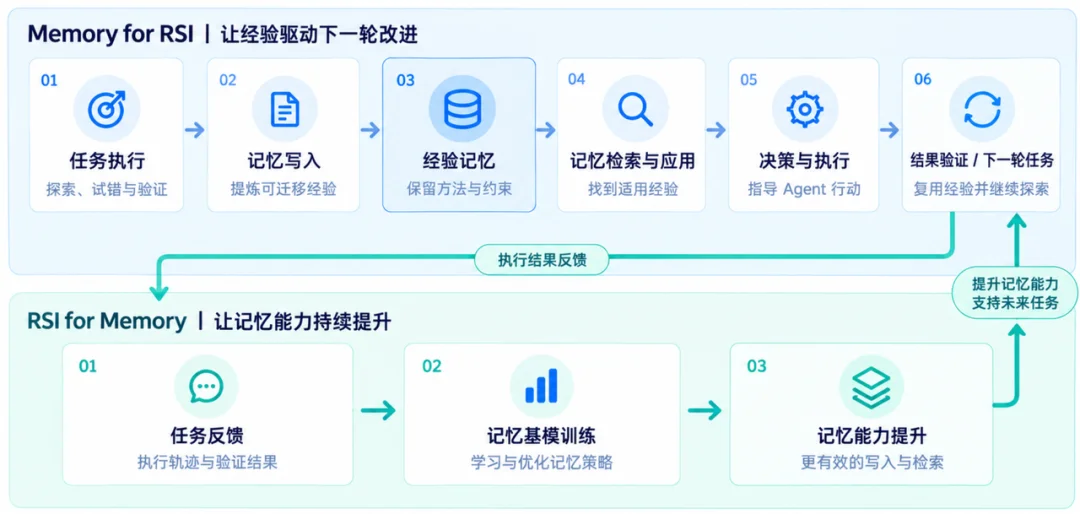
Además, la retroalimentación de las tareas también puede verificar el valor real de la experiencia. Al actualizar continuamente el contenido de la memoria y utilizar la retroalimentación efectiva en el entrenamiento del modelo base de memoria, se promueve el mejoramiento de la capacidad de la propia memoria, creando un proceso en el que la acumulación de experiencia y la mejora del Agente se fortalecen mutuamente.
02 | Aprendizaje y evolución de la memoria:
Haz que el Agente se fortalezca continuamente a partir de su experiencia.
Basado en las necesidades de acumulación de experiencia, reutilización entre tareas y mejora continua en el Agente RSI, MemoraX ha construido un sistema que...Aprendizaje basado en la experiencia, transferencia de conocimientos adquiridos y optimización a través de la retroalimentaciónUn sistema de capacidad de memoria centrado en el agente, que a través de la construcción de datos de memoria de alta calidad, la organización dinámica de la memoria y la optimización basada en la retroalimentación de tareas reales, entrena continuamente el modelo básico de memoria, permitiendo que el agente aprenda y mejore constantemente sus decisiones y ejecuciones a partir de la experiencia histórica.
Aprender de las tareas: hacer que la acumulación de experiencia se convierta en una capacidad del modelo que pueda ser optimizada
Durante el proceso de ejecución de las tareas del Agente, la verificación de los resultados y el ajuste de las estrategias generan continuamente nueva experiencia.Las decisiones exitosas proporcionan métodos reutilizables para tareas futuras, mientras que las conclusiones de fracasos verificadas ayudan al Agente a descartar soluciones ineficaces y reducir la necesidad de intentos fallidos repetidos.No obstante, el valor de la experiencia a menudo se manifiesta solo en tareas posteriores. Resumir con precisión el pasado no implica necesariamente poder apoyar con eficacia el futuro. Por lo tanto, el proceso de aprendizaje basado en la memoria no solo requiere identificar la experiencia que merece ser conservada, sino también guardar las pruebas de su validez, las restricciones del entorno y las condiciones de aplicación, para evitar que la experiencia se pierda o se utilice de manera incorrecta. Esto es mucho más complejo de lo que una simple resumen o compresión de la información podría resolver.
Frente a este desafío, MemoraX escribe la memoria en estrategias aprendibles diseñadas para obtener beneficios en tareas futuras, construyendo continuamente un sistema completo que abarca la construcción del entorno, la recolección de datos, la creación de muestras y el entrenamiento de RL (Reinforcement Learning) a escala.En un entorno de tareas interactivo y verificable, se recopilan las trayectorias de ejecución, los registros de uso de la memoria y los comentarios de verificación para construir muestras de entrenamiento relacionadas con la toma de decisiones y los efectos posteriores del uso. Luego, se diseñan señales de recompensa basadas en la calidad de completación de las tareas posteriores, la eficiencia de ejecución y las situaciones de prueba y error repetidas, con el fin de optimizar la estrategia de escritura en la memoria. Este proceso extiende los objetivos de optimización del modelo de la precisión en la extracción de información a otros aspectos.El impacto real de la memoria en la calidad de las tareas posteriores, la eficiencia de ejecución y el proceso de prueba y error repetidoAprender es más beneficioso para desarrollar estrategias de almacenamiento de memoria que sean útiles en tareas futuras.
Migrar de la experiencia: Dejar que la experiencia histórica guíe nuevas tareas
La experiencia puede ser conservada, pero eso no significa que pueda ser aplicada efectivamente en nuevas tareas. Ante objetivos de tarea diferentes, restricciones ambientales y etapas de ejecución variadas, el Agente necesita identificar con precisión los métodos históricos que son relevantes, evitando la interferencia de información irrelevante y la transferencia incorrecta de conocimientos.
Para ello, MemoraX va aDesacoplar el contenido de la memoria de la estructura de accesoAjustar dinámicamente los puntos de acceso a la memoria y las relaciones asociadas según la tarea actual, para que la misma información histórica pueda adaptarse a diferentes necesidades de uso.
En el nivel de búsqueda, avancemos aún más.A través del entrenamiento del modelo, se aprende la relación de correspondencia entre las necesidades del tarea actual y las pruebas clave históricas.Mejora la capacidad de localización de experiencias clave mediante la combinación de la identificación de evidencia de gran detalle y la disipación de ambigüedades en recuerdos similares, distinguiendo entre lo que es 'relacionado con el tema' y lo que es 'la evidencia correcta'.
Durante la fase de uso práctico, MemoraX integra el estado actual de la tarea y el progreso de su ejecución,Transformar la experiencia general acumulada a lo largo de la historia en guías de acción con objetivos claros, restricciones operativas y estándares de verificaciónY se ajusta dinámicamente según las fases del proyecto, permitiendo que la experiencia histórica participe realmente en la toma de decisiones y la ejecución del Agente.
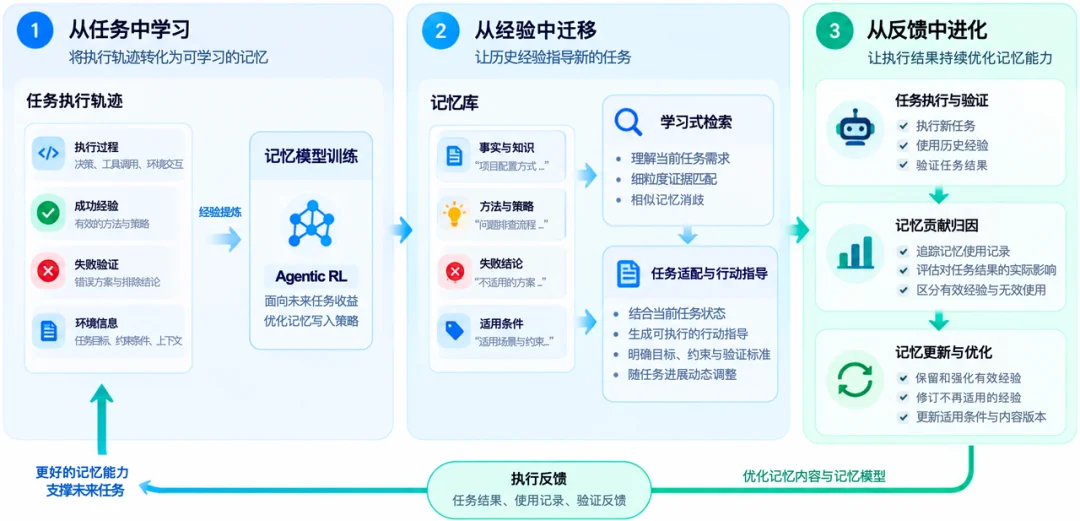
Evolución a partir de la retroalimentación: Mejorar continuamente los resultados de la ejecución para mejorar la capacidad de memoria
En la iteración continua del RSI, la experiencia histórica no siempre es efectiva. Las nuevas tareas pueden verificar los métodos existentes o revelar sus limitaciones.Cómo utilizar la retroalimentación de la ejecución para determinar el verdadero valor de la experiencia y, en base a ello, mejorar continuamente la memoria, es un aspecto importante para el autoperfeccionamiento constante.
El desafío central es Asignación de crédito de memoria (Memory Credit Assignment)Las tareas a largo plazo pueden recurrir a múltiples experiencias históricas, pero ¿cuáles realmente influyen en la toma de decisiones del Agente y cuáles simplemente se leen sin tener efecto? Incluso si la tarea final tiene éxito, determinar la contribución real de cada memoria sigue siendo un problema que debe resolverse.
En torno a este desafío, MemoraX va aEstablecer una asociación entre las versiones de la memoria, los registros de uso real y los comentarios de ejecución de las tareas¿El seguimiento de la experiencia histórica realmente ha influido en las acciones del Agente, y cómo se ha comportado la tarea después de su uso en comparación con los resultados de verificación? Sobre esta base, se continúa evaluando e iterando la memoria existente.Permitir que la experiencia válida se conserve y se fortalezca, y según los nuevos comentarios de las tareas, corregir a tiempo aquella experiencia que ya no es aplicable.
Estos comentarios reales también son de gran ayuda paraEntrenamiento continuo del modelo de base de memoriaSe proporcionó una base de datos y señales de optimización que permitieron que las mejoras en la memoria se extendieran no solo a las actualizaciones a nivel de contenido, sino también al aprendizaje de los modelos de memoria sobre el valor de la experiencia y las estrategias de memorización.
03 | De la acumulación de experiencia al aumento de la capacidad:
Prácticas de RSI en múltiples escenarios con MemoraX
Para el Agente RSI, lo que realmente importa no es solo cuán buenos son los resultados de una tarea en particular, sino...¿Puede la experiencia histórica acumularse y corregirse continuamente, y seguir generando valor en tareas futuras?
Durante este proceso, se verificó la capacidad de iteración continua de la experiencia, la transferencia de conocimientos entre tareas y la optimización mediante retroalimentación en tres tipos de tareas complejas: programación a largo plazo, análisis financiero y razonamiento matemático. Además, se demostró cómo la memoria contribuye al aumento de la calidad y la eficiencia del Agente en tareas de larga duración.
(1) Programación compleja a largo plazo: desde la iteración basada en la experiencia hasta el mejoramiento de las capacidades de ingeniería
Experimentos de programación compleja a larga distancia se utilizan en áreas como comunicaciones, finanzas y logística. En 5 grandes industrias y 13 tareas de desarrollo de sistemas a nivel industrial, se realizaron un total de 78 ejecuciones de desarrollo, con una duración total de más de 300 horas, y la duración máxima de cada ejecución superó las 12 horas. Como resultado, la tasa de éxito del plan de mejora de la memoria MemoraX aumentó en más del 20%, al mismo tiempo que el consumo total de tokens por parte del agente de codificación principal disminuyó en más del 20%.
Desde la acumulación de experiencia hasta la mejora recursiva: el camino de la autoiteración de la memoria
Frente al problema de que la memoria estática tradicional dificulta la acumulación y optimización continua de experiencia durante la ejecución de tareas, el equipo MemoraX ha propuestoMétodo RSI (Recursivo de Auto Mejora) Impulsado por el Modelo de MemoriaMediante la colaboración entre un modelo de memoria desarrollado internamente y el sistema de Agentes, el modelo de memoria especializado se encarga de extraer y actualizar la memoria procedural a partir de las trayectorias de ejecución de los Agentes y de las respuestas en línea. A su vez, el sistema de Agentes aplica esta memoria en tareas reales, creando un ciclo iterativo que incluye la extracción de experiencias, la aplicación de estas experiencias en las tareas, la verificación de los resultados y la actualización de la memoria. Esto permite que las experiencias efectivas se acumulen y se optimicen continuamente, guiando así las tareas futuras. En los casos de entrenamiento que consisten en tareas de programación a largo plazo,Tras varias rondas de optimización de la iteración de la memoria procedural, la calidad de la memoria procedural ha mejorado en más del 10%.
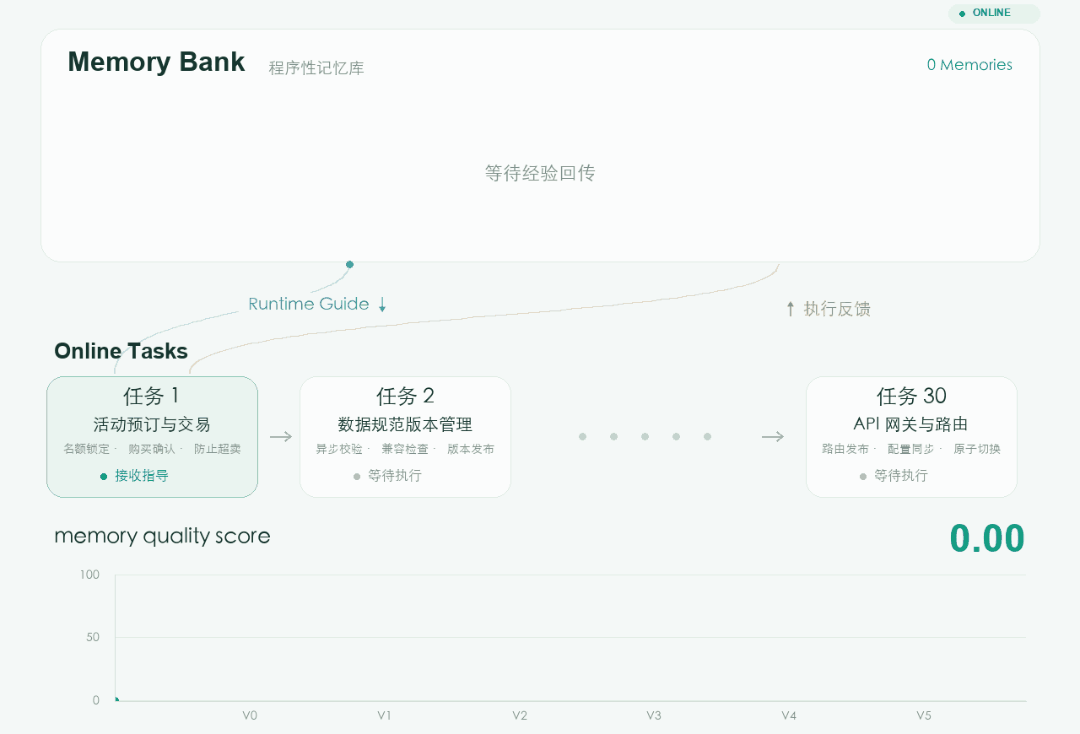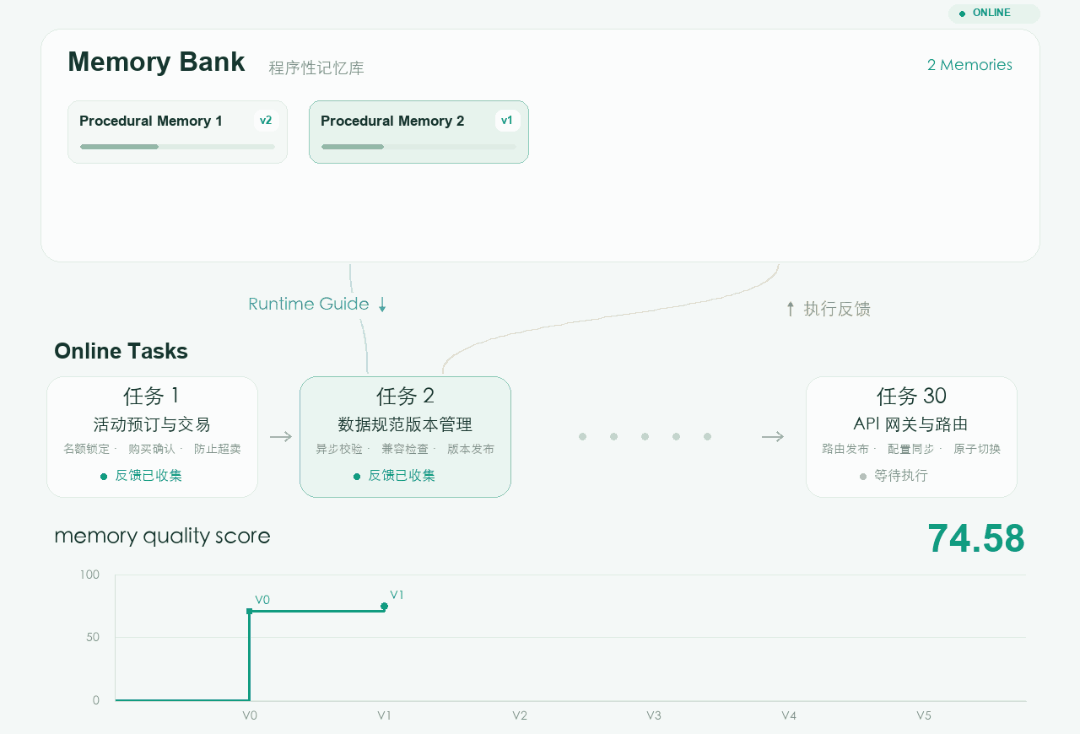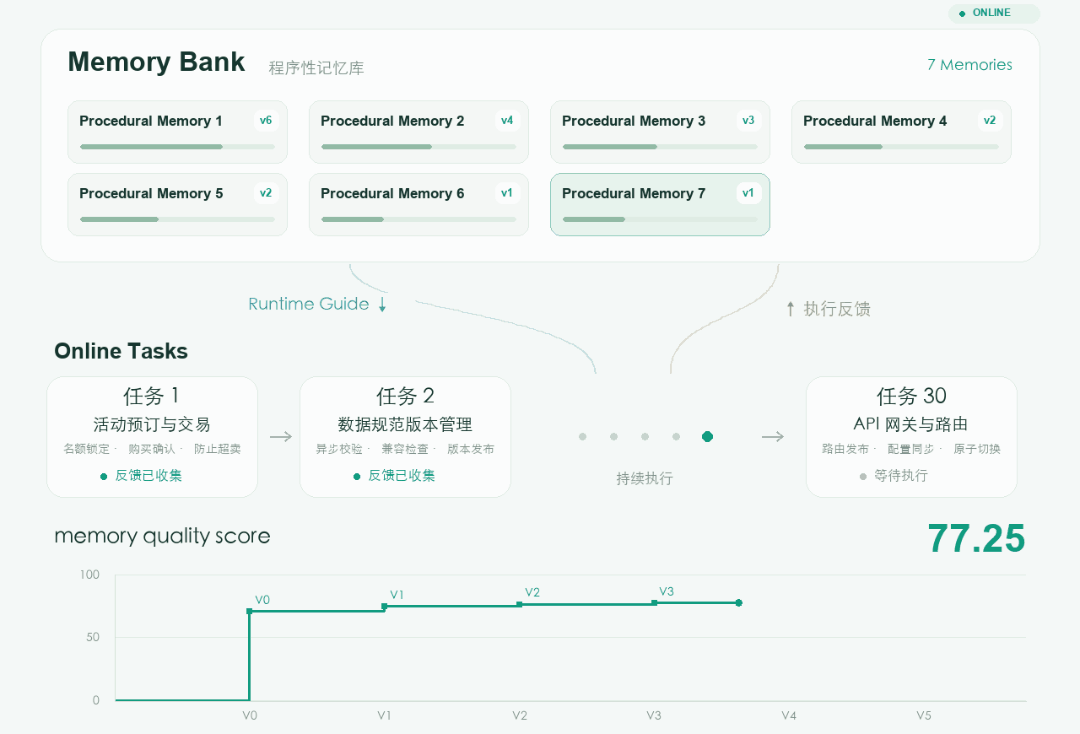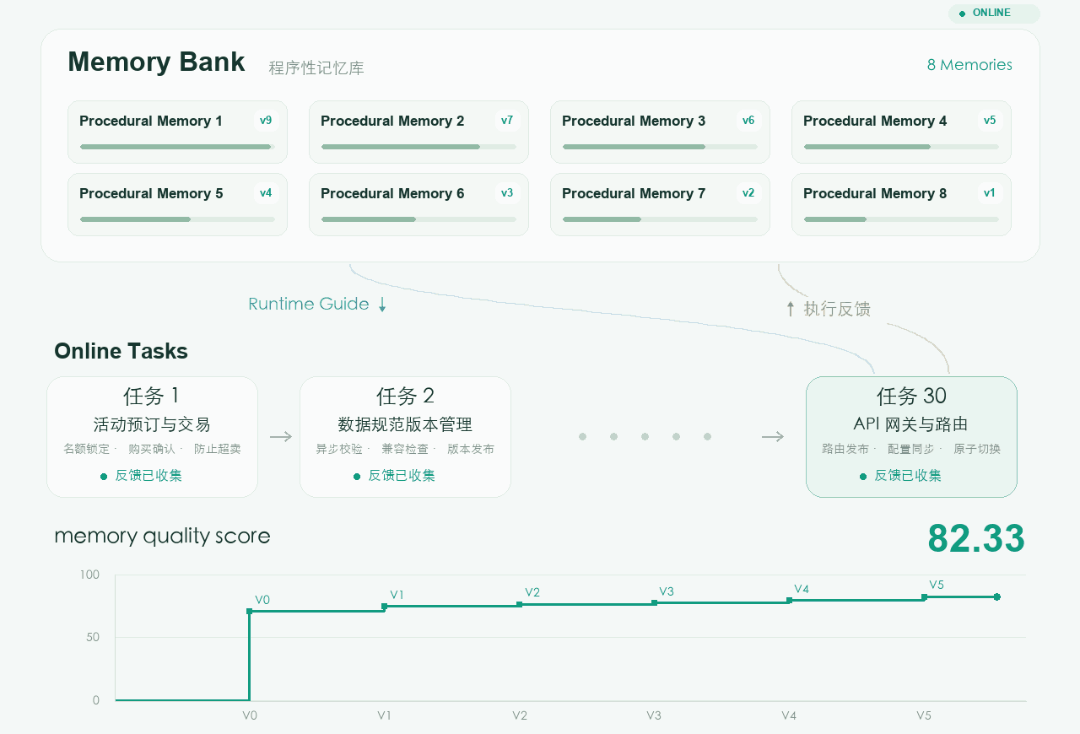
Con la experiencia adquirida a través de iteraciones repetidas, afrontamos el desafío del desarrollo de un proyecto complejo que dura 335 horas.
¿Cuánto puede ser útil la experiencia acumulada cuando se aleja de las tareas de aprendizaje originales y se enfrenta a nuevos desafíos de ingeniería?
Para ello, se utilizará la experiencia acumulada en tareas de desarrollo de proyectos complejos completamente nuevos.En 13 tareas complejas de ingeniería de software, se realizaron un total de 78 ejecuciones de desarrollo, con una duración total de más de 335 horas, y la ejecución más larga individual superó las 12 horas.Estas tareas son mucho más que simples modificaciones de código; involucran desafíos reales de ingeniería que incluyen lógica de negocio compleja, dependencias entre módulos y una gran cantidad de pruebas.
Finalmente, la tasa de éxito aumentó en más del 20%, al mismo tiempo que el consumo total de tokens por parte del Coding Agent disminuyó en más del 20%.
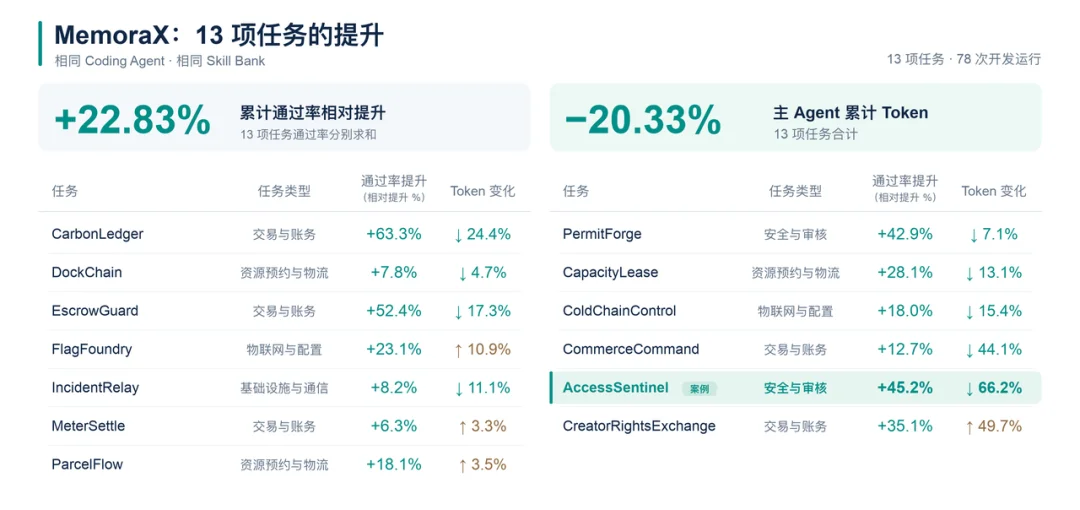
Entre ellos, AccessSentinel es un caso representativo de alta complejidad. El Agente necesita construir un sistema completo de control de permisos a nivel empresarial y asegurar que...Estrictas restricciones de seguridad。
Con la ayuda del modelo de memoria,La experiencia histórica ya no se limita a ser una referencia de información estática, sino que puede participar continuamente en la ejecución y verificación del Agente a medida que cambia el estado de la tarea.Desde el minuto 43 después del inicio del desarrollo hasta las 2 horas y 30 minutos, los recuerdos en diferentes puntos clave...Ofrecer de manera proactivaGuía dirigida:
- Cuando se revocan los permisos del dispositivo,No solo se debe prohibir que los dispositivos se conecten de nuevo, sino también asegurarse de que las cuentas que ya se han conectado no puedan continuar accediendo al sistema.
- Cuando se restaura una versión anterior de la política de seguridad,Es necesario mantener los registros históricos y, al mismo tiempo, evitar que los permisos que ya han sido cancelados se restablezcan de manera accidental.
- Al procesar solicitudes en masa,Primero, se deben verificar si todas las solicitudes cumplen con los requisitos. Solo cuando todas hayan sido aprobadas se podrá proceder de manera unificada, para evitar situaciones en las que algunas tengan éxito y otras no.
Durante las pruebas,La tasa promedio de aprobación en los tres ejecutivos aumentó en más del 45%, mientras que el consumo acumulado de tokens por parte del agente de codificación principal disminuyó en más del 66%.
(2) Análisis financiero complejo: desde la acumulación de evidencia hasta la mejora continua y autónoma
La investigación financiera requiere formar juicios analíticos completos y fiables a partir de una gran cantidad de materiales dispersos. Además de encontrar los datos relevantes, el Agente también necesita comprender con precisión los sujetos, los tiempos y los métodos estadísticos en un contexto complejo, establecer conexiones entre las diferentes pruebas y evitar que la omisión de información o la confusión de métodos afecten las conclusiones finales.
MemoraX se centra en dos problemas que están interconectados:Cómo hacer que las pruebas respalden una respuesta completa, y cómo utilizar las preguntas contenidas en la respuesta para mejorar a su vez los métodos de conservación y búsqueda de las pruebas.Para ello, MemoraX lleva a cabo experimentos basados en el estándar de referencia autoritario del sector financiero, FinRank, que abarca los informes financieros reales de 22 empresas estadounidenses cotizadas en bolsa de los sectores farmacéutico, petrolero y automotriz, incluyendo una gran cantidad de datos financieros complejos a nivel interempresarial e interciclo. En torno a estas tareas, MemoraX utiliza la retroalimentación de las mismas para optimizar continuamente la organización y la recuperación de la memoria, formando un ciclo iterativo de "ejecución — retroalimentación — mejora de la memoria — reejecución". Más de 30 iteraciones colaborativas entre modelos de memoria y sistemas de análisis financieroFinalmente,La tasa de recuperación de la cadena de pruebas es cercana al 100%, lo que representa un aumento del 20% en la precisión de completación de las tareas CodeX y una reducción de costos de casi el 98%.
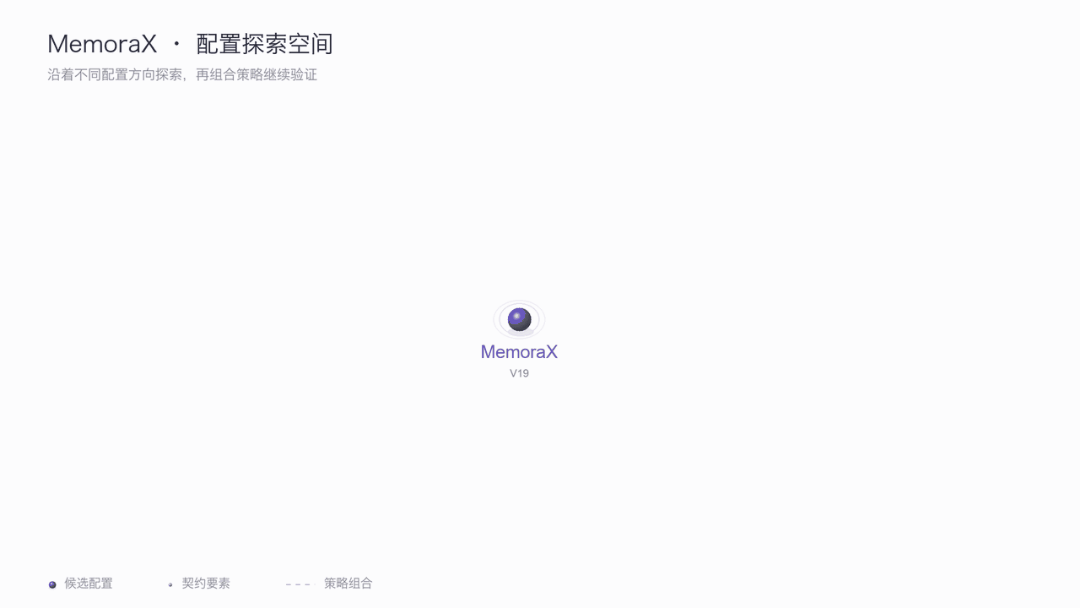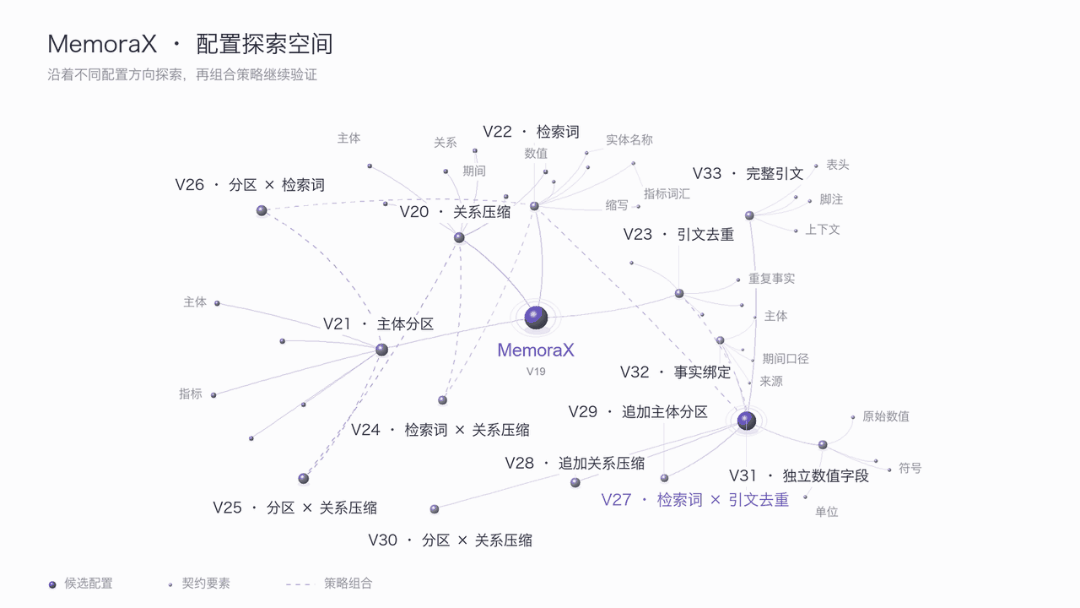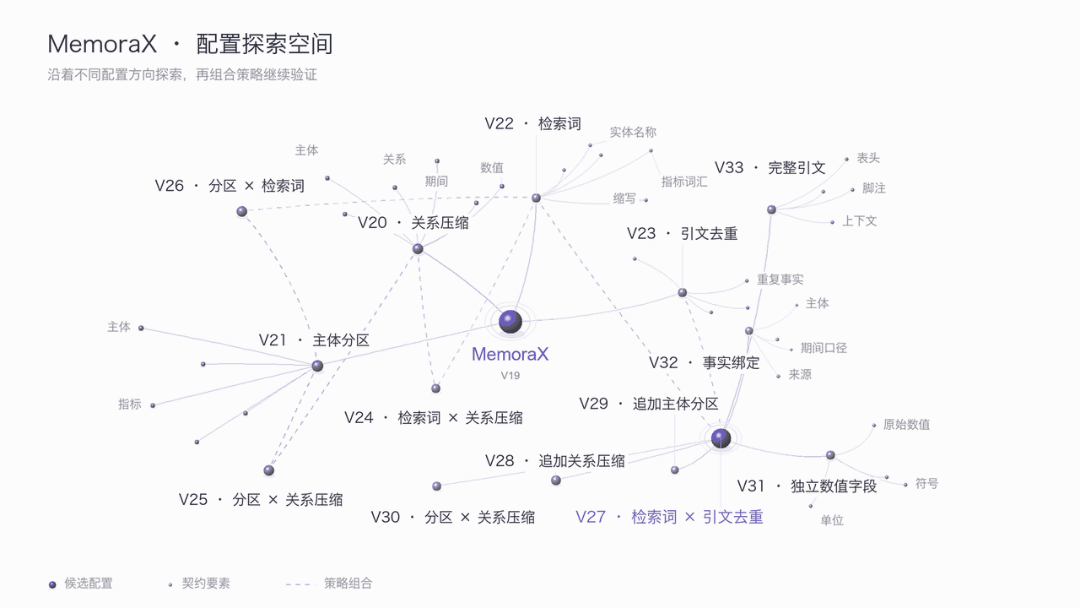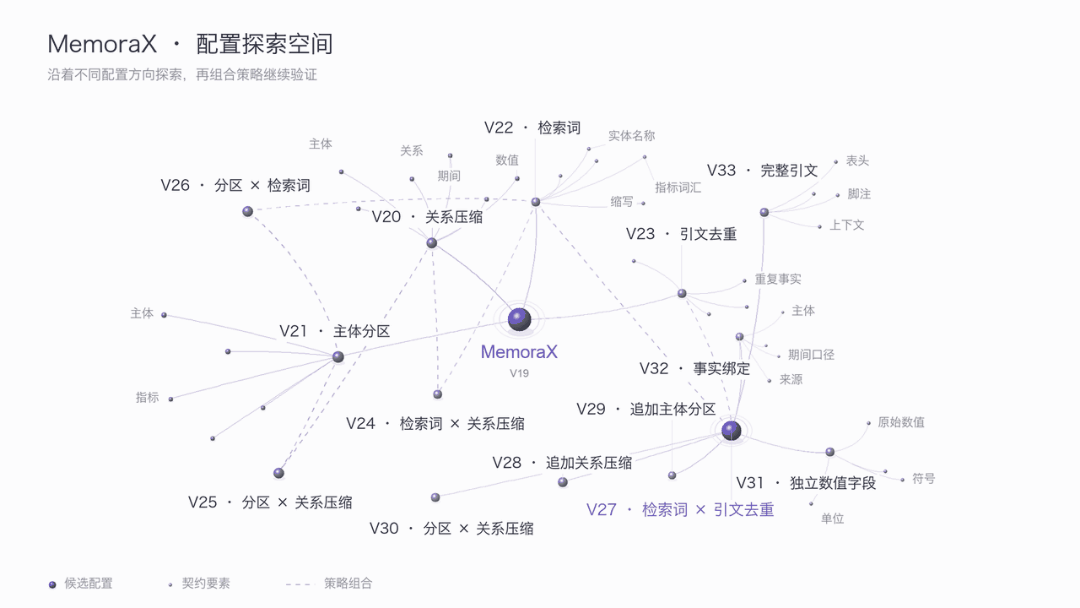
Desde encontrar los datos hasta organizar pruebas que puedan apoyar una decisión
Tomando como ejemplo una tarea de análisis financiero de una gran empresa manufacturera, las pruebas relacionadas con la tarea están dispersas en una gran cantidad de materiales del mismo sector que incluyen estados financieros de tres años consecutivos, revelaciones de proveedores y descripciones de riesgos. Es fácil encontrar contenido relacionado con el tema, pero que no pertenece a la empresa objetivo ni al período del informe, solo utilizando palabras clave o similitud semántica; sin embargo, si se conservan solo los resúmenes, es posible perder detalles sobre las unidades de medida numéricas y las condiciones en las que se establecen los riesgos.
Para ello, MemoraX primero convierte el material contextual en memoria estructurada y, basándose en las respuestas obtenidas, ajusta iterativamente la organización de dicha memoria. Esto se hace con el fin de adaptarla a escenarios de preguntas y respuestas financieras, logrando así un enfoque que tenga en cuenta ambos aspectos.Precisión numérica, alineación de datos y rastreabilidad de la fuenteRepresentación de la salida del modelo de memoria; durante la búsqueda, se relacionan y se llaman a estos evidencias en torno a la pregunta actual, analizando la situación actual de los inventarios, la estructura de las compras y los riesgos potenciales. Este método de organización tiene en cuenta las necesidades de las tareas financieras.Precisión numérica, coherencia en los métodos utilizados y rastreabilidad de las fuentesRequisitos de [[MG SEG_E502CA36BF27_SOURCE]].
La tasa de precisión en la finalización de tareas de MemoraX ha mejorado en comparación con el grupo de control de Codex.Cerca del 20%Además, según los datos de uso del API reales, el costo de este plan es...En comparación con el plan de referencia de Codex, se ha reducido en casi un 98%, lo que no solo ha permitido obtener una tasa de aprobación más alta, sino que también ha disminuido significativamente los costos de llamada.
Desde la retroalimentación de las respuestas hasta la iteración de la estrategia: Mejorando la memoria “Cómo guardar, cómo recuperar”
MemoraX, basándose en la retroalimentación de las tareas, continúa explorando formas de seleccionar y organizar la información de la memoria en relación con la omisión de pruebas, la confusión de relaciones y la redundancia de referencias, y acumula conocimientos de manera constante en las tareas de entrenamiento.Ejemplos de interacción que relacionan la toma de decisiones de escritura, el contenido memorizado y los efectos de uso posteriores,Se utiliza para optimizar los modelos de memoria. Después de ser entrenados, los modelos participan en una nueva ronda de tareas, y las respuestas de su ejecución se utilizan continuamente para mejorar las estrategias de escritura y el entrenamiento posterior, formando un ciclo de RSI en el que la interacción entre tareas y la optimización del modelo se promueven mutuamente. En este proceso, los modelos comienzan a emergir gradualmente.Características de representación de la memoria adaptadas a escenarios financierosAsociar los valores clave con las condiciones aplicables para su almacenamiento, diferenciar entre distintos sujetos, períodos de informe y fuentes, y establecer una correspondencia entre los hechos y las pruebas originales. Después de Iteración del RSI de 36 rondas,MemoraX La tasa de recuperación de evidencia alcanzó el 96.49%, y la precisión de la tarea aumentó del 33.33% al 73.33%.
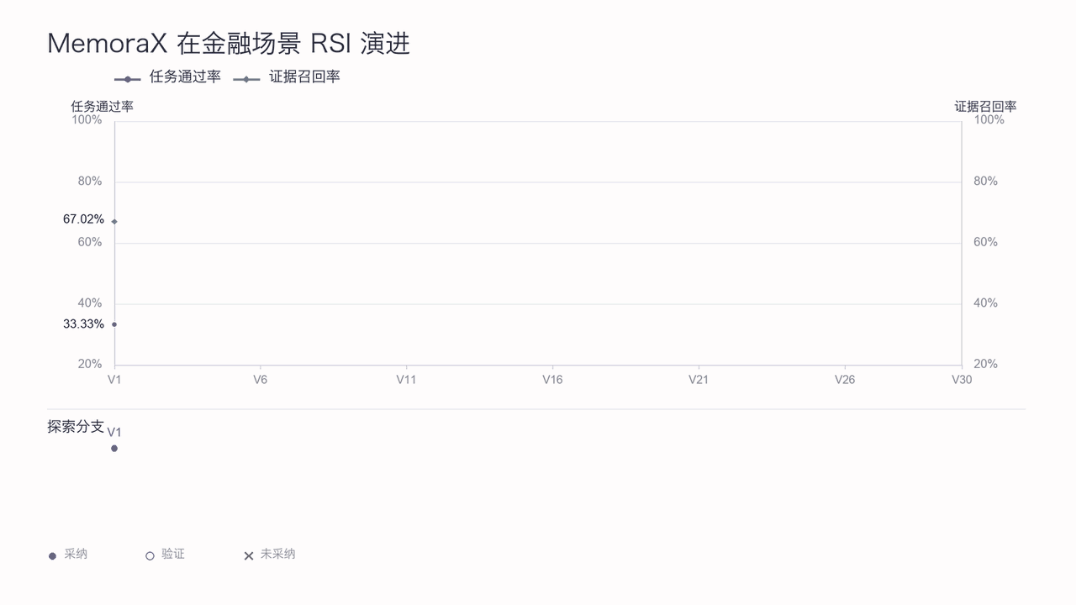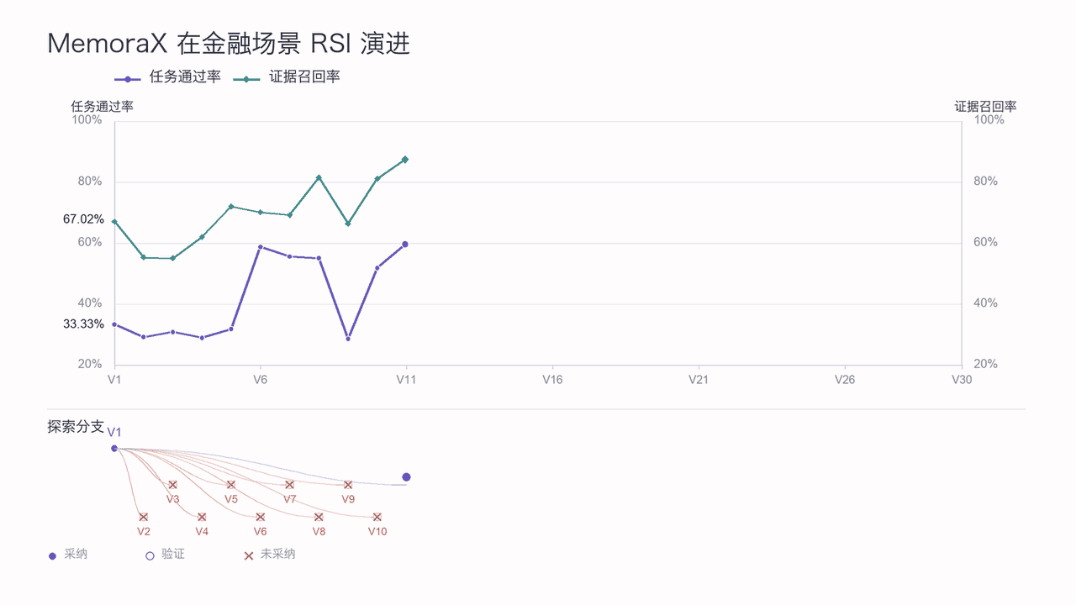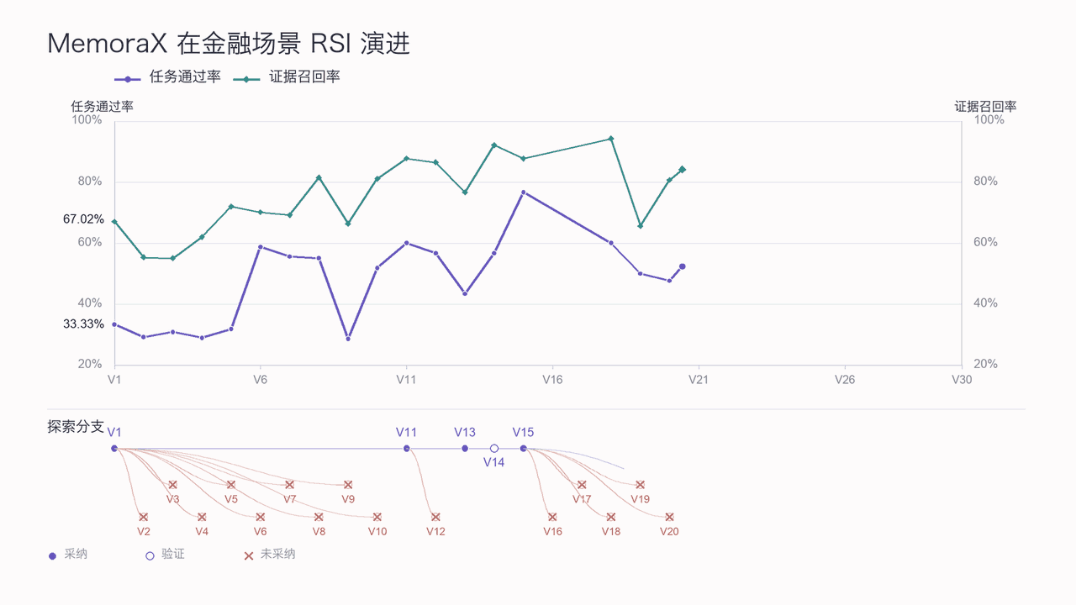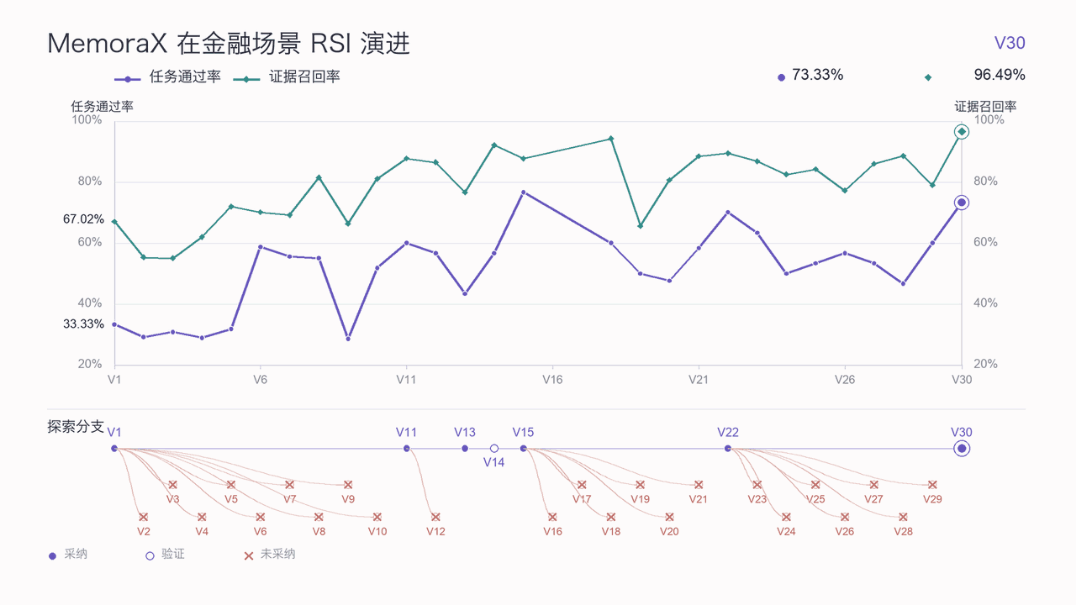
Para los investigadores que necesitan seguir de cerca los informes financieros y anuncios a largo plazo, el conocimiento acumulado a partir del mismo conjunto de materiales puede ser utilizado para abordar diferentes problemas, lo que dispersa la inversión inicial; además, los comentarios obtenidos en los análisis posteriores pueden ayudar a ajustar el contenido de ese conocimiento y las estrategias de uso.Haga que las respuestas sean más completas, que el uso sea más económico y que la experiencia pueda acumularse de manera continua,Juntos constituyen el valor práctico de MemoraX en tareas financieras complejas.
(3) Razonamiento matemático complejo: desde la retroalimentación empírica hasta la iteración automática de estrategias de resolución
En experimentos de razonamiento matemático de alta dificultad, MemoraX exploró aún más la utilización de la experiencia histórica y la retroalimentación de verificación para apoyar al Agente en la corrección continua de su razonamiento y la optimización de sus estrategias de resolución en problemas complejos. En problemas de optimización combinada del nivel IMO (Olimpiada Internacional de Matemáticas), el Agente logró... 4 horas de solución continua, más de 600 llamadas al modelo,Finalmente se encontró lo que ha sido verificado. La solución óptima para 21 rectángulos. En comparación con el plan OpenAI Codex, el tiempo de resolución se ha reducido un 13% y el costo, un 98%.
De la prueba del fracaso a la solución óptima: mejorar continuamente el razonamiento a través de la retroalimentación
Matilda 16×16 es un problema de optimización combinada de alto nivel según mi opinión: se requiere usar la menor cantidad posible de rectángulos para cubrir los 240 cuadrados de una red de 16×16, asegurando que cada fila y cada columna tenga exactamente un espacio vacío. Solo los lugares donde hay espacios vacíos ya representan una complejidad considerable. 20.9 billones de posibles combinacionesLa dificultad no solo radica en encontrar una solución viable, sino también en demostrar que no existe otra opción que utilice menos rectángulos.
Frente a este desafío, el Agente ha colaborado continuamente en la construcción de búsquedas, pruebas formales, modelado preciso y auditorías independientes. El sistema encontró inicialmente 27 y 23 candidatos para la construcción, pero la argumentación sobre la optimidad global de los 23 candidatos fue rechazada por la auditoría independiente.
MemoraX es capaz de acumular de manera continua las soluciones propuestas previamente, los procesos de razonamiento y los comentarios de verificación. Los patrones de memoria extraen experiencias de mejora efectivas de los caminos exitosos y convierten las experiencias de fracaso en referencias para ajustar las estrategias de resolución en futuros intentos:
- Corrección de errores en la memoria: desde conclusiones erróneas hasta la corrección de los recuerdos. La auditoría independiente rechazó 23 pruebas de optimidad incorrectas, lo que llevó al Agente a reconsiderar sus conclusiones previas. Además, la información de verificación de que "una solución factible no es necesariamente la mejor solución" se utilizó para corregir sus registros, con el objetivo de evitar que los razonamientos futuros repitieran los mismos errores.
- Optimización automática de estrategias: de actualizaciones basadas en la memoria a mejoras en los métodos. Basándose en los candidatos previos extraídos del modelo de memoria y las respuestas de verificación, se guía al Agente para ajustar el método de modelado, incorporando de manera unificada las restricciones de posiciones vacías y bordes de rectángulos en la búsqueda de soluciones. Se encontraron sucesivamente 22 y 21 soluciones mejores.
- Iteración de la memoria: desde la verificación de los resultados hasta la optimización continua. El agente realiza una resolución precisa mediante un examen gradual y la llamada a herramientas, confirmando finalmente la optimidad de la respuesta. Luego, comparte los nuevos resultados de verificación con el modelo de memoria para mejorar la construcción de la memoria de resolución, lo que proporciona una referencia para problemas similares en el futuro.
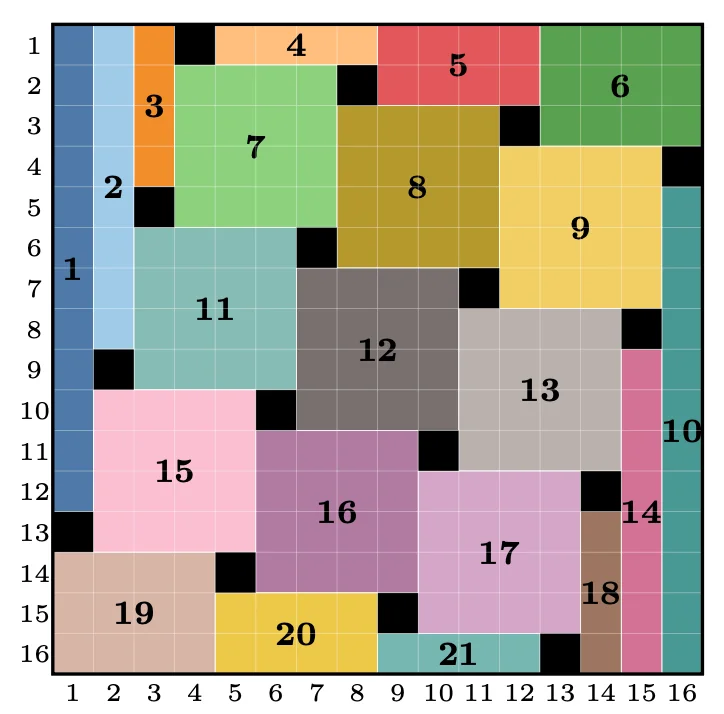
Optimización del empacamiento de 21 rectángulos en el problema Matilda de 16×16. Los cuadrados negros están vacíos, y las áreas de diferentes colores representan azulejos rectangulares.
Esto demuestra la capacidad de iteración continua del Agente en tareas matemáticas complejas:La experiencia histórica ya no es solo un registro de razonamiento estático, sino que puede combinarse con nuevos comentarios de verificación para participar continuamente en el ajuste de las estrategias de resolución posteriores.
Partiendo de la memoria, hacia un Agente en constante evolución
MemoraX AI (忆纪元) fue fundada por Hao Jianye, ex director del Laboratorio de Decisión e Inferencia de Huawei, ex director del Laboratorio de Algoritmos de Grandes Modelos y experto principal en la dirección de la toma de decisiones inteligentes. Se centra en el desarrollo de modelos de memoria de agentes de próxima generación que son capaces de aprender y evolucionar.
El modelo de memoria desarrollado de forma independiente por el equipo, basado en la tecnología de RL Agente (Agenetic Reinforcement Learning), ganó el campeonato en las listas de memoria más prestigiosas a nivel mundial y ha sido ampliamente reportado y destacado por medios nacionales e internacionales como el MIT Technology Review. La solución de memoria del equipo se ha implementado en empresas líderes de sectores como programación, medicina, finanzas, seguridad y hogares inteligentes, y es socio estratégico de Huawei Cloud/Tencent Cloud.
Actualmente, el equipo está profundizando aún más en el RSI basado en modelos de memoria, permitiendo que los Agentes pasen de acumular y reutilizar experiencia a aprender de manera continua y evolucionar por sí mismos, fortaleciendo así su liderazgo en el campo de la memoria artificial. Al mismo tiempo, se está acelerando la implementación en múltiples escenarios y se está promoviendo el desarrollo estandarizado y la comercialización a gran escala de módulos de memoria para productos dirigidos a la industria B y al consumidor final (C).
Conclusión
La clave del Agente RSI no es solo hacer que la IA se desempeñe mejor en una sola tarea, sino también en...Que cada ejecución sea la base para el siguiente aumento de capacidad.Los métodos exitosos, las experiencias de fracaso y las condiciones de aplicación se acumulan a través de la memoria a largo plazo y se transforman en guías de acción reutilizables en nuevas tareas; los nuevos resultados de ejecución, a su vez, impulsan la actualización de la experiencia, la optimización de las estrategias de memoria y el aprendizaje continuo del modelo base de memoria.
Lo que MemoraX está explorando es...Una trayectoria evolutiva bidireccional en la que la memoria y la auto-mejora del Agente se promueven mutuamentePor un lado, permitir que la memoria proporcione una base de experiencia continua y transferible entre tareas para el Agente RSI; por otro lado, asegurar que la ejecución y los comentarios en las tareas reales alimenten continuamente el aprendizaje y la evolución de la propia memoria.
Cuando cada tarea deja su experiencia detrás de sí y cada comentario de retroalimentación impulsa la mejora, la capacidad del Agente ya no se limita a una ejecución única, sino que tiene la oportunidad de convertirse en un proceso de acumulación continua y evolución autónoma.
El artículo proviene de "Machine Heart", escrito por "Machine Heart".
Enlace del artículo:https://www.airai.cc/es/ai-news/54/
有用吗?