От памяти к самоэволюции: Ключевой шаг агента на пути к RSI
В последнее время ведущие мировые лаборатории по исследованиям в области искусственного интеллекта активно распространяют определенный сигнал:ИИ переходит от помощи людям в выполнении задач к участию в собственном развитии и улучшении.
В сентябре OpenAI объявила, что достигла этапного цели по созданию «автоматизированных стажеров в области исследований в области искусственного интеллекта» и планирует к марту 2028 года создать настоящих «автоматизированных исследователей в области искусственного интеллекта». Главный научный сотрудник OpenAI Якуб Пахочки в тот же период опубликовал длинную статью, в которой обсуждалсь перспектива развития технологии рекуррентного самосовершенствования (Recursive Self-Improvement, RSI). 21 сентября OpenAI дополнительно определила автоматизированных исследователей в области искусственного интеллекта и способность к непрерывному совершенствованию технологий исследований в этой области как важные стратегические направления следующего этапа развития.
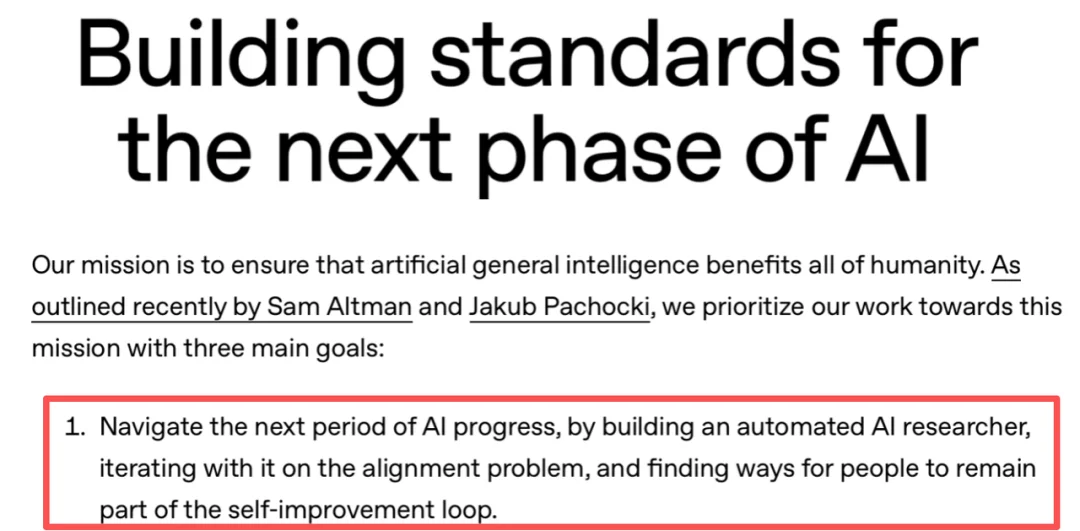
OpenAI опубликовал официальное заявление о стратегии 21 сентября 2026 года, в котором автоматизация исследований в области искусственного интеллекта и рекуррентное самосовершенствование были названы важными целями на следующем этапе развития.
С другой стороны, компания Anthropic также опубликовала группу привлекающих внимание данных: по состоянию на август этого года модель Claude уже обработала около 26% от внутренних работ по исследованиям и разработкам в области искусственного интеллекта выполняются под руководством ведущих специалистов.Все больше и больше исследовательских задач, которые ранее выполнялись учеными, теперь передаются ИИ для выполнения под их наблюдением.
От OpenAI к Anthropic — RSI переходит от далеких технических идей к ключевым направлениям исследований и разработок в ведущих мировых лабораториях. ИИ уже не просто инструмент для решения внешних проблем; он также начинает участвовать в развитии собственных возможностей.
Но самый важный ключ к этому пути непрерывного развития заключается в следующем:
Как искусственный интеллект может превратить прошлые исследования и ошибки в основу для следующего прогресса, а не заставлять каждый раз начинать с нуля при решении новых задач?
Память является ключевой основой, которая позволяет Агенту постоянно совершенствоваться. Оно позволяет каждому исследованию оставлять не только результаты выполнения задачи, но и опыт, который может быть использован и перенесен на последующие задачи, тем самым предоставляя возможность для улучшения способностей Агента. Это позволяет Агенту развиваться не только в рамках отдельных задач, но и постоянно совершенствоваться благодаря накоплению знаний и навыков на протяжении времени.
01 От накопления опыта к постоянному развитию:
Как память поддерживает RSI
Чтобы Агент мог постоянно улучшать свои способности в процессе непрерывного выполнения задач, ключевым моментом является возможность передачи опыта, накопленного в ходе выполнения отдельных задач, на последующие этапы работы:Извлекая эффективные методы из прошлых исследований, точно применять их в новых задачах, а также постоянно корректировать и улучшать их на основе результатов выполнения. В нем процессы записи информации в память и ее извлечения выполняют две взаимосвязанные ключевые функции.
Для записи информации в память необходимо выявлять эффективные подходы, выводы о неудачах и условия их применения из сложных процессов выполнения задач, чтобы прошлый опыт действительно мог быть использован в будущем; для поиска информации в памяти же требуется на основе новых задач точно найти подходящие исторические методы и ключевые доказательства, чтобы избежать упущений в знаниях и неправильного применения опыта.
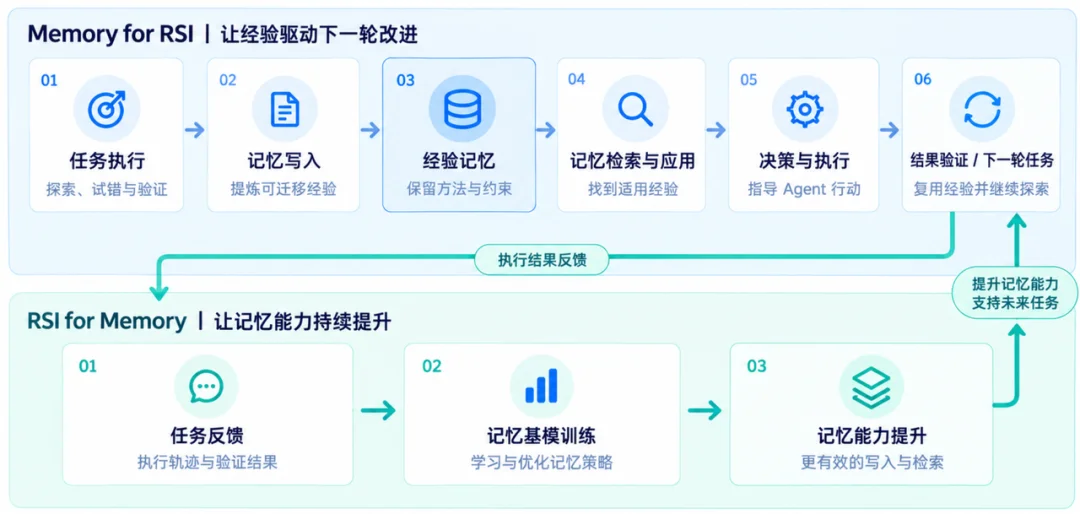
Далее, обратная связь от задачи также может использоваться для проверки реальной ценности накопленного опыта. Путем постоянного обновления содержимого памяти и применения эффективной обратной связи в обучение базовых моделей памяти можно способствовать улучшению самой способности памяти, создавая процесс взаимного содействия между накоплением опыта и улучшением агента.
02 |Обучение и эволюция памяти:
Пусть Агент постоянно совершенствуется благодаря своему опыту.
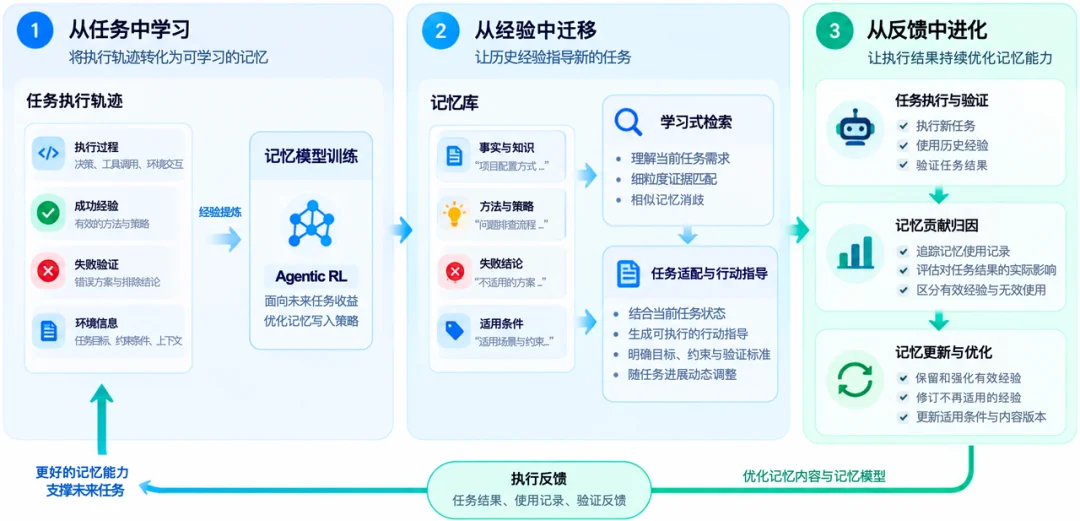
В связи с потребностями в накоплении опыта, межзадачном использовании и постоянном совершенствовании в рамках Agent RSI, компания MemoraX создала систему, основанную наОпытное обучение, миграция знаний и оптимизация на основе обратной связиСистема памяти, основанная на этом принципе, позволяет постоянно тренировать базовые модели памяти за счет создания качественных данных для запоминания, динамической организации информации и оптимизации на основе обратной связи от реальных задач. Это позволяет Агенту постоянно учиться на опыте прошлого, улучшая свои способности принятия решений и выполнения действий.
Извлечение уроков из задач: превращение накопленного опыта в способность модели к оптимизации
В процессе выполнения задач агентом постоянно появляется новый опыт, который используется для проверки результатов и корректировки стратегий.Успешные решения предоставляют методы, которые можно использовать в последующих задачах, а проверенные выводы о неудачах помогают агенту исключать неэффективные варианты и сокращать количество повторных попыток.Однако ценность опыта часто проявляется только в последующих задачах. Точное описание прошлого не гарантирует эффективной поддержки в будущем. Поэтому процесс обучения на основе воспоминаний требует не только выявления опыта, заслуживающего сохранения, но и сохранения доказательств его достоверности, условий, в которых он был получен, и сфер его применения. Это предотвращает упущение или неправильное использование этого опыта, и это гораздо сложнее, чем простое извлечение и сжатие информации.
Для решения этой проблемы компания MemoraX... Записывайте знания в модели, которые представляют собой обучаемые стратегии, ориентированные на получение выгоды в будущем, и постоянно развивайте полноценную систему, охватывающую создание среды, сбор данных, составление образцов и масштабированное обучение агентного роботизма (Agentic RL).В интерактивной и проверяемой среде задач сбираются данные о траекториях выполнения, записях использования ресурсов и обратной связи о проверке, на основе которых создаются обучающие примеры для принятия решений и оценки последующих результатов использования. Затем, учитывая качество выполнения последующих задач, эффективность выполнения и количество повторных попыток, разрабатываются сигналы поощрения для оптимизации стратегии записи информации в память. Этот процесс позволяет расширить цели оптимизации модели с точности извлечения информации на более широкие аспекты.Реальное влияние памяти на качество последующих задач, эффективность выполнения и возможность повторных попыток и ошибокУчеба способствует развитию стратегий запоминания, которые будут полезны для выполнения будущих задач.
Миграция знаний из опыта прошлого: позволяйте историческому опыту направлять выполнение новых задач
Опыт может быть сохранен, но это не означает, что он сможет быть использован при выполнении новых задач. Перед лицом различных целей задач, ограничений окружающей среды и этапов выполнения, Агент должен точно определять подходящие исторические методы, чтобы избежать вмешательства ненужной информации и ошибочного переноса знаний из прошлого.
Для этого MemoraX будетРазделение содержимого памяти и структуры доступаВ соответствии с текущими задачами динамически настраиваются точки доступа к информации в памяти и связи между элементами данных, чтобы одна и та же историческая информация могла соответствовать различным потребностям пользователей.
На уровне поиска дальнейшие шаги…С помощью обучения модели учитываются соответствия между требованиями текущей задачи и ключевыми доказательствами из прошлого.С использованием детализированных методов идентификации доказательств и разрешения неоднозначностей в схожих воспоминаниях повышается способность к определению ключевого опыта, а также удается различать «тематически релевантные» данные от «правильных доказательств».
На этапе практического использования MemoraX учитывает текущее состояние задачи и прогресс ее выполнения.Преобразуйте накопленный за время опыт в практические рекомендации действий, которые имеют четкие цели, операционные ограничения и критерии проверки.И адаптироваться в соответствии с этапами выполнения задачи, чтобы исторический опыт действительно мог влиять на принятие решений и выполнение действий агентом.
Эволюция на основе обратной связи: постоянное улучшение способности памяти благодаря результатам выполнения
В процессе непрерывного обновления индекса RSI исторический опыт не всегда оказывается эффективным. Новые задачи могут как подтвердить существующие методы, так и выявить их ограничения.Как использовать обратную связь от выполнения задач для оценки реальной ценности полученного опыта и на основе этого постоянно совершенствовать свои знания и навыки, является важным аспектом непрерывного самосовершенствования.
Основная проблема здесь заключается в том, что... Ассигнование кредитов за использование памяти (Memory Credit Assignment)Для выполнения долгосрочных задач могут использоваться множество исторических данных, но какие из них действительно влияют на принятие решений агентом, а какие просто считываются, но не оказывают никакого эффекта? Даже если в итоге задача выполнена успешно, определение реального вклада различных «воспоминаний» остается нерешенной проблемой.
В связи с этой проблемой MemoraX будетСвязь между версиями памяти, записями о фактическом использовании и отзывами об выполнении задачОтслеживается, участвовали ли исторические данные реально в действиях агента, а также как проявлялась эффективность выполнения задач и результаты проверки после их использования. На этой основе продолжается оценка и итерация существующих «воспоминаний» (моделей поведения агента).Необходимо сохранять и укреплять полезный опыт, а также своевременно корректировать методы, которые больше не соответствуют новым задачам и требованиям.
Эти реальные отзывы также способствуют...Непрерывное обучение базовых моделей памятиБыли предоставлены основы для работы с данными и сигналы для оптимизации, что позволило улучшению памяти расшириться от обновлений на уровне содержимого до обучения модели памяти ценности опыта и стратегиям запоминания.
03 От накопления опыта к повышению квалификации:
Практика использования индекса RSI в различных сценариях с помощью MemoraX
Для агента RSI более важно не то, насколько хороши результаты отдельной миссии, аМожно ли накапливать и корректировать исторический опыт, чтобы он продолжал приносить пользу в последующих задачах?
В ходе этого процесса были проверены способности к непрерывному обновлению знаний на основе опыта, межзадачному переносу знаний и оптимизации благодаря обратной связи в трех категориях задач: сложном программировании на длительные сроки, финансовом анализе и сложных математических рассуждениях. Кроме того, было дополнительно установлено, как память способствует повышению качества и эффективности работы агента при выполнении задач на длительные сроки.
(1)Долгосрочное сложное программирование: от итеративного накопления опыта к повышению уровня компетенций в области сложных инженерных проектов
Длительные сложные эксперименты по программированию применяются в таких областях, как связь, финансы, логистика и других. В рамках 5 крупных отраслей и 13 задач по разработке промышленных систем было проведено в общей сложности 78 разработочных сеансов, общая продолжительность которых превысила 300 часов; максимальная продолжительность одного сеанса составила более 12 часов. В результате реализации решения по улучшению памяти MemoraX процент успешной работы системы увеличился более чем на 20%, при этом совокупное потребление токенов основным программным агентом (Coding Agent) сократилось более чем на 20%.
От накопления опыта к рекуррентному улучшению: путь самоитерации памяти
В связи с тем, что традиционная статическая память не позволяет накапливать и оптимизировать опыт в процессе выполнения задач, команда MemoraX предложилаМетод RSI, основанный на модели памяти (Memory Model–Driven RSI)С помощью собственной модели памяти, совместно работающей с системой Агентов, специальная модель памяти отвечает за извлечение и обновление процедурной памяти из данных о выполнении задач Агентами и онлайн-обратной связи. Система Агентов затем применяет эту память в реальных задачах, создавая замкнутый цикл итераций, включающий извлечение опыта, применение в задачах, проверку результатов и обновление памяти. Это позволяет эффективному опыту накапливаться, совершенствоваться и направлять последующие задачи. В примерах тренировок, состоящих из длительных программных задач,После нескольких раундов оптимизации процесса запоминания, качество программного запоминания улучшилось более чем на 10%.
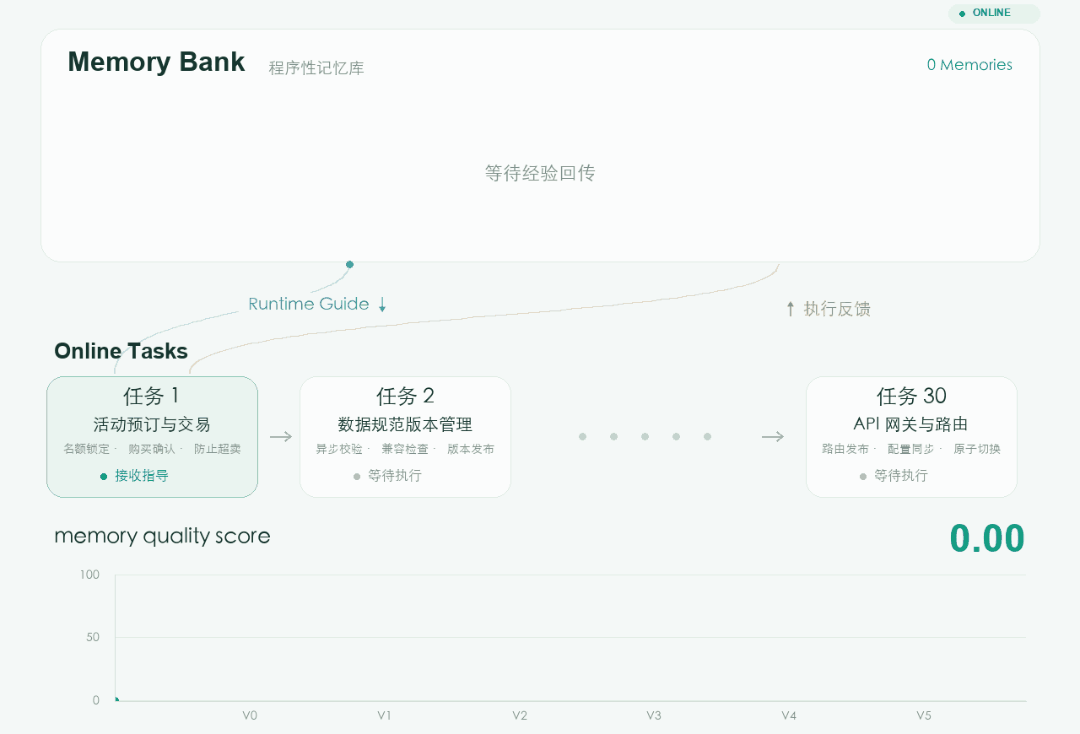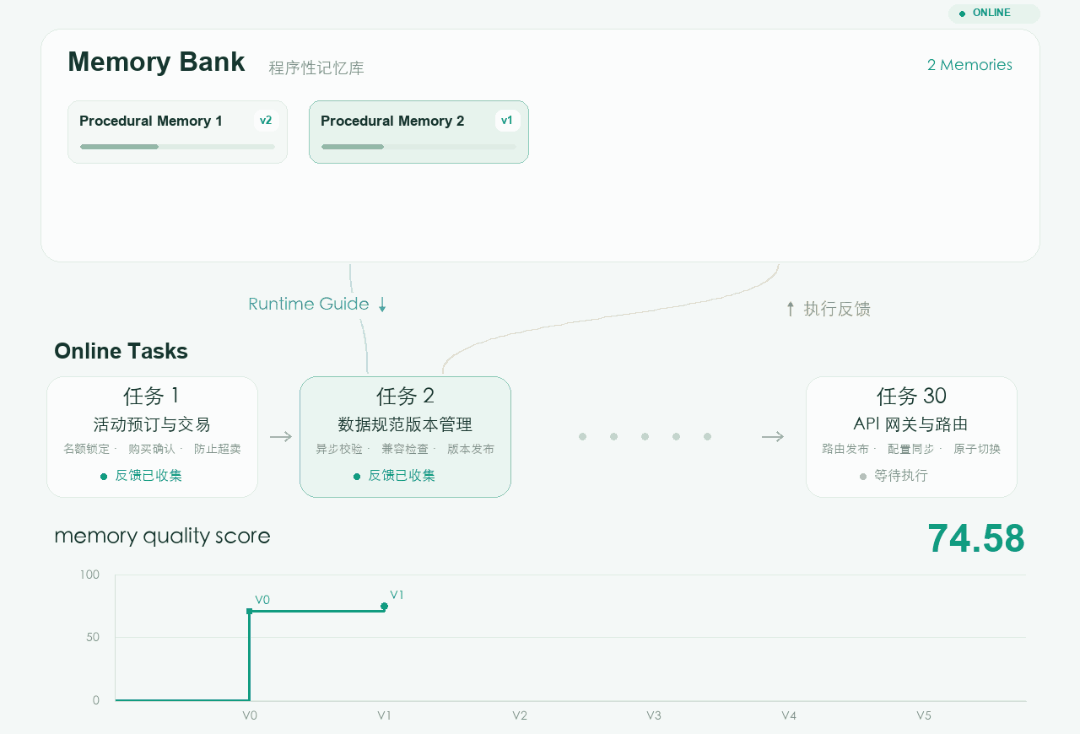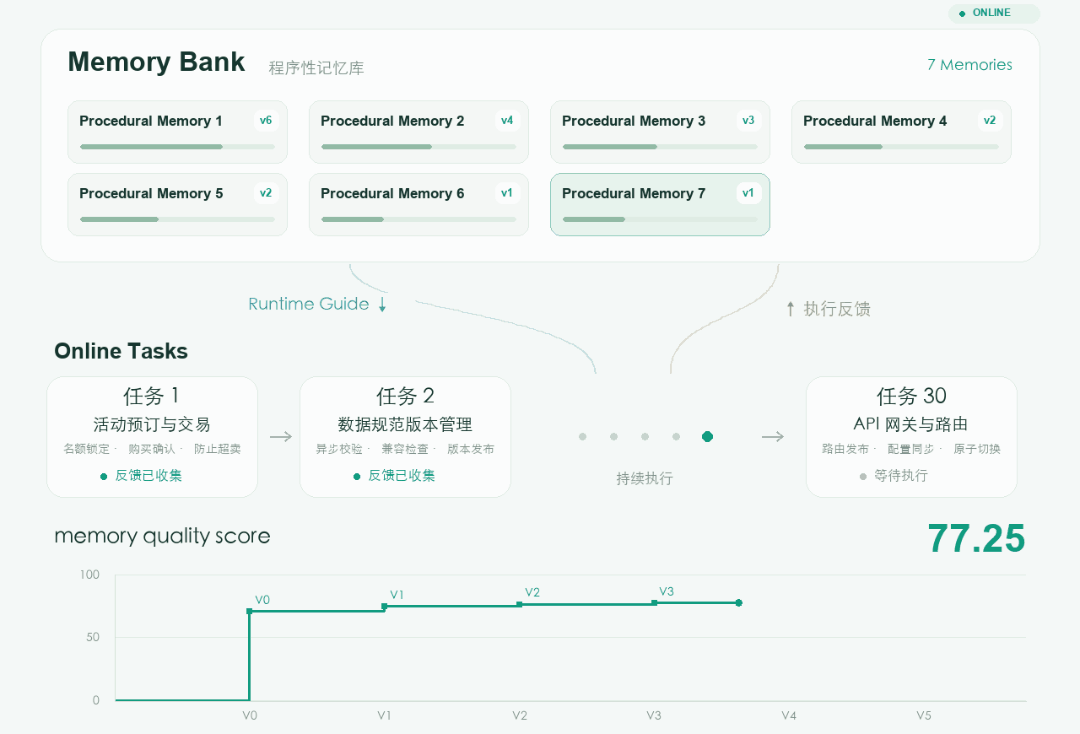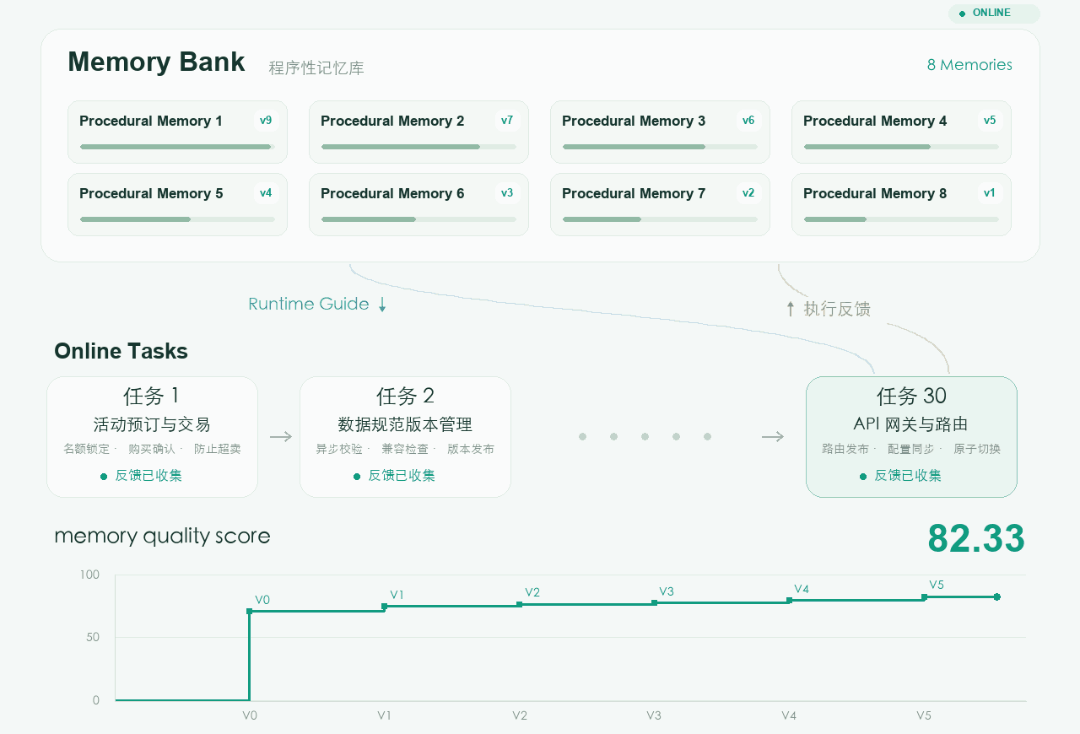
С опытом, полученным в результате многократных итераций, мы беремся за разработку сложного проекта с объемом работы в 335 часов.
Какую роль может сыграть накопленный опыт, когда он отделяется от первоначальных задач обучения и сталкивается с новыми инженерными вызовами?
Для этого используется накопленный опыт при решении совершенно новых, сложных задач по разработке проектов.В ходе выполнения 13 сложных задач по инженерии программного обеспечения было проведено 78 различных этапов разработки, общая продолжительность которых превысила 335 часов; самый длительный из этих этапов занял более 12 часов.Эти задачи гораздо сложнее простых изменений в коде; они включают в себя решение сложных бизнес-логик, учет взаимозависимостей между модулями и проведение множества тестов, что представляет собой настоящие инженерные вызовы.
В итоге, процент успешного выполнения увеличился более чем на 20%, в то же время совокупное потребление токенов Coding Agent сократилось более чем на 20%.
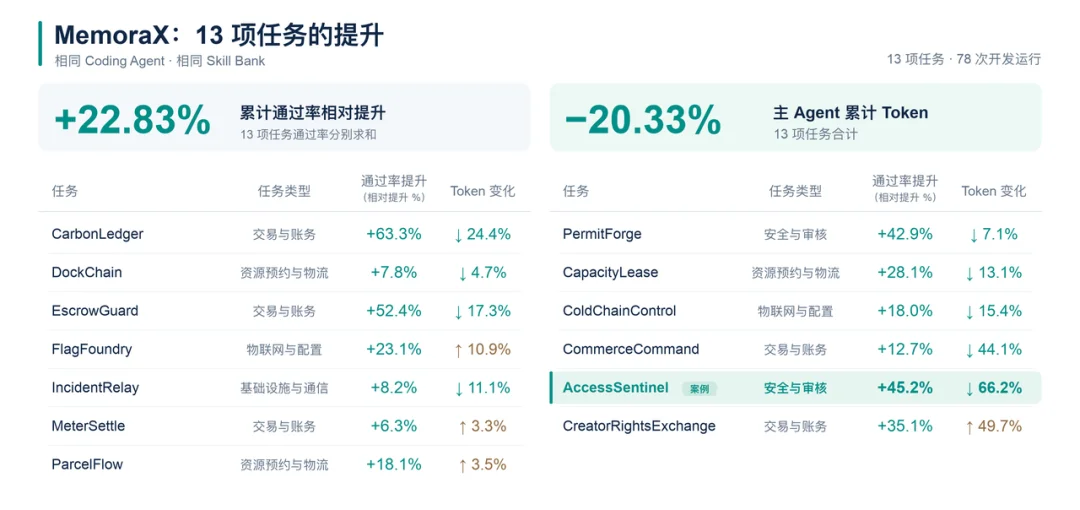
В частности, AccessSentinel является типичным сложным случаем. Агенту необходимо создать полноценную систему управления правами на уровне предприятия и обеспечить её надежное функционирование.Строгие требования к безопасности。
С помощью модели памяти,Исторический опыт больше не ограничивается статическими справочными данными; он может постоянно участвовать в выполнении и проверке действий агента в зависимости от изменений в состоянии задачи.От 43-й минуты после начала разработки до 2 часов 30 минут память сохранялась на различных ключевых этапах.Активное предложениеЦеленаправленное руководство:
- Когда права на использование устройства отзываются,Необходимо не только запретить устройствам вновь входить в систему, но и обеспечить, чтобы учетные записи, которые уже были вошли в систему ранее, не могли продолжать получать доступ к ней.
- При восстановлении старой версии политики безопасности,Необходимо сохранять исторические записи, а также предотвратить случайное восстановление уже отмененных прав.
- При массовой обработке заявок,Сначала необходимо проверить, соответствуют ли все заявки требованиям. Только после того, как все заявки будут одобрены, можно приступить к единому выполнению, чтобы избежать ситуации, когда некоторые из них увенчаются успехом, а другие — неудачей.
Во время тестирования,Средний процент успешного выполнения за три запуска увеличился примерно на 45%, в то время как общее потребление токенов основным кодирующим агентом сократилось более чем на 66%.
(2)Сложный финансовый анализ: от накопления доказательств до самостоятельного непрерывного совершенствования
Финансовые исследования требуют формирования полных и надежных аналитических выводов на основе большого количества разрозненных материалов. Помимо поиска соответствующих данных, агент также должен точно понимать субъекты, временные рамки и статистические критерии в сложном контексте, устанавливать связи между различными доказательствами и избегать влияния упущений информации или путаницы в критериях на окончательные выводы.
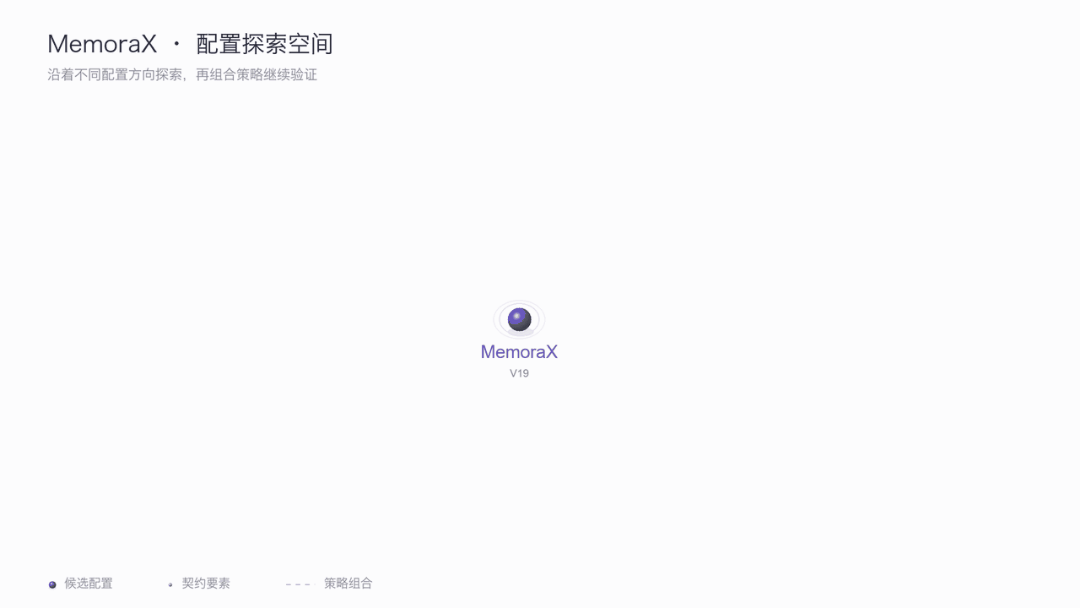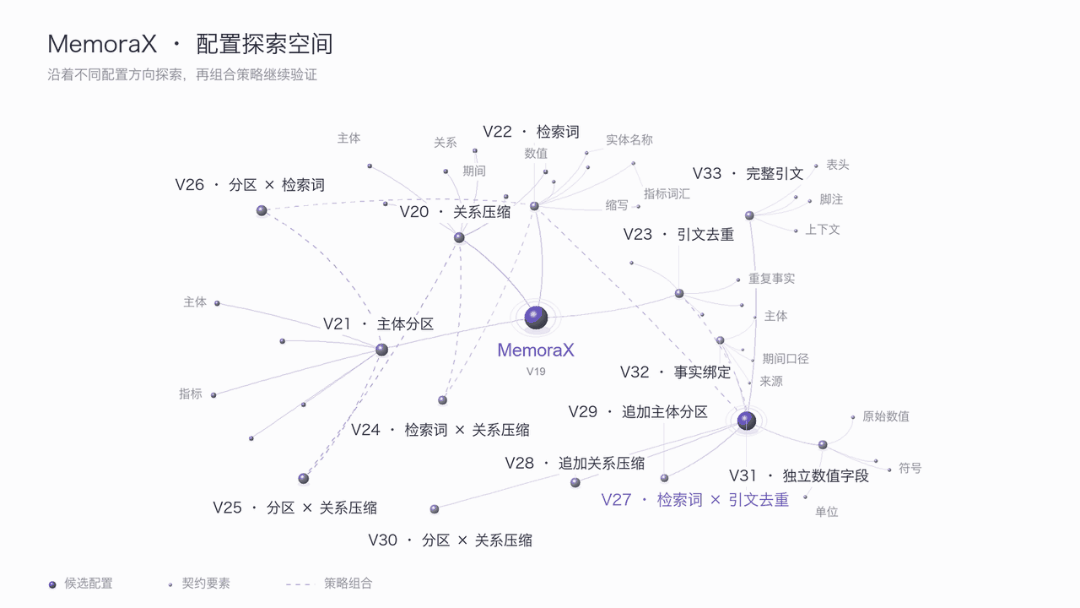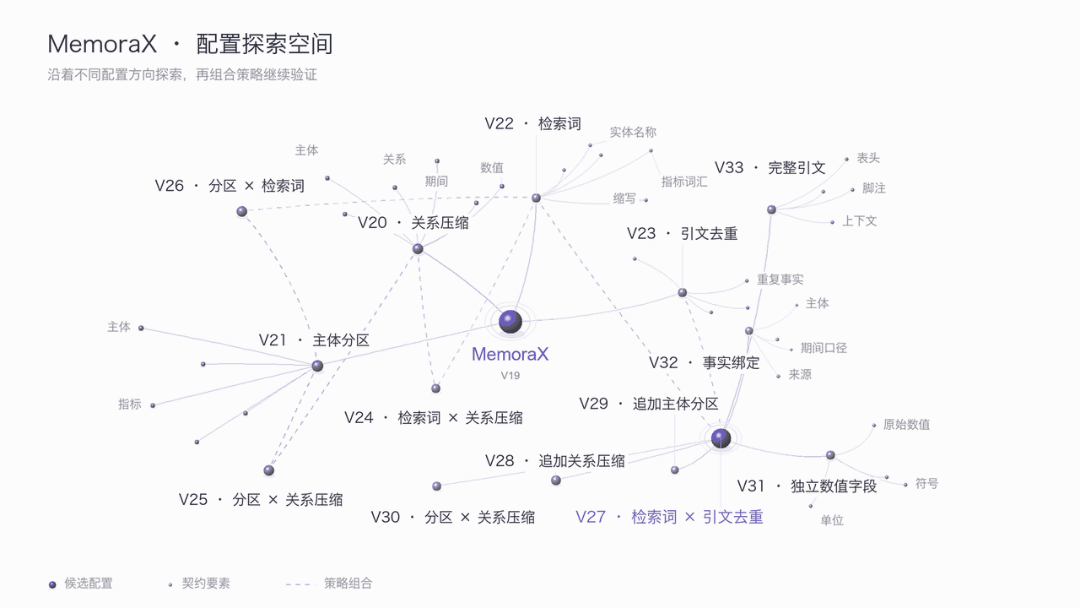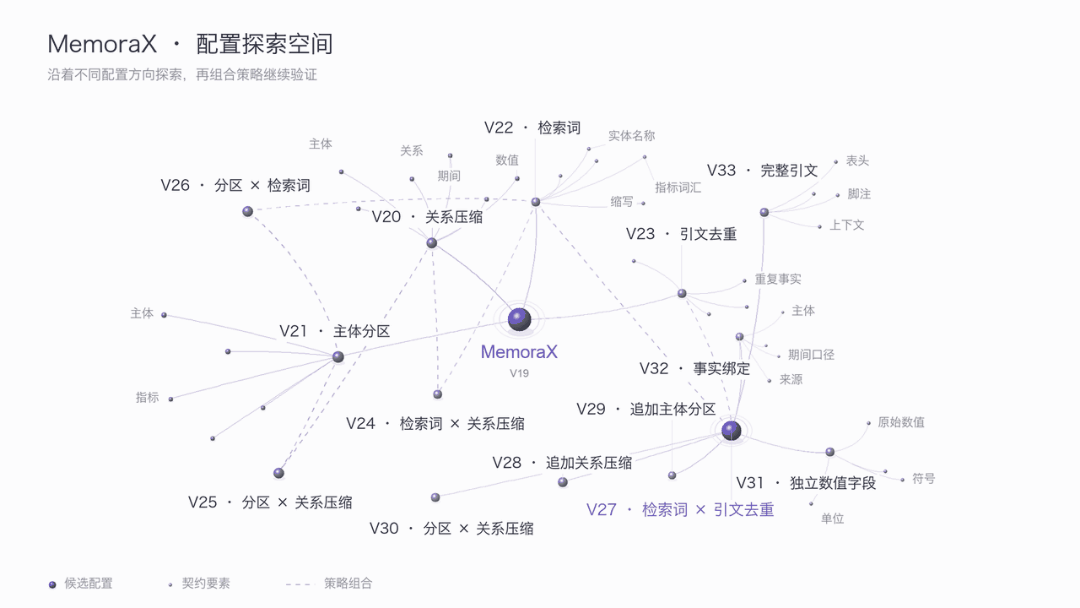
Компания MemoraX сосредотачивается на двух взаимосвязанных проблемах:Как сделать так, чтобы доказательства поддерживали полное и точное ответ на вопрос, а также как использовать вопросы, содержащиеся в ответе, для улучшения способов сохранения и поиска доказательств.Для этого MemoraX проводит эксперименты на основе авторитетного финансового бенчмарка FinRank, который охватывает реальные финансовые отчеты 22 публичных компаний из США в таких отраслях, как фармацевтика, нефть и газ, а также автомобилестроение, включая большое количество сложных финансовых данных, пересекающих различные компании и периоды. В рамках этих задач MemoraX использует обратную связь от выполненных операций для постоянной оптимизации организации памяти и процессов поиска, формируя цикл итераций типа «выполнение — обратная связь — улучшение памяти — повторное выполнение». Более 30 совместных итераций моделей памяти и систем финансового анализаКонечно, здесь нет текста для перевода между маркерами «SOURCE» и «END». Пожалуйста, предоставьте текст, который нужно перевести с китайского на русский язык, и я выполню задание.Уровень возврата доказательств по цепочке почти достиг 100%, что на 20% выше, чем у задач CodeX, при этом затраты снизились почти на 98%.
От поиска данных до сбора доказательств, способствующих принятию решений
В качестве примера можно рассмотреть задачу по финансовому анализу крупного производственного предприятия. Доказательства, связанные с этой задачей, распределены среди большого количества материалов из аналогичных отраслей, включающих финансовые отчеты за три последовательных года, информацию, предоставленную поставщиками, и описания рисков. Используя только ключевые слова или сходство семантики, легко найти материалы, связанные с темой, но не относящиеся к конкретному предприятию или отчетному периоду; однако при сохранении только резюме могут быть упущены данные о единицах измерения числовых показателей и условиях возникновения рисков.
Для этого MemoraX сначала преобразует контекстуальные материалы в структурированную память, а затем на основе обратной связи от пользователей постепенно корректирует способ организации этой памяти. В результате формируется система, подходящая для финансовых вопросов и ответов, которая учитывает различные аспекты.Точность числовых значений, согласование параметров и отслеживаемость источникаВыражение результатов работы модели памяти; при поиске данные снова связываются с текущей проблемой, и информация о текущем состоянии запасов, структуре закупок и потенциальных рисках анализируется вместе. Такой подход учитывает требования финансовых задач.Точные числовые значения, согласованные методологии и отслеживаемые источники информацииТребования.
Показатель точности выполнения окончательной задачи MemoraX улучшился по сравнению с Codex.Почти 20%Кроме того, согласно статистике фактического использования API, стоимость данного решения...По сравнению с контрольным вариантом Codex, затраты на выполнение снижены почти на 98%, что позволило достичь более высокого уровня одобрения при одновременном значительном сокращении расходов на вызовы.
От обратной связи к итерации стратегии: улучшение памяти через понимание того, как сохранять информацию и как ее восстановить
MemoraX, исходя из обратной связи от пользователей, постоянно исследует способы выбора и организации информации в памяти в случаях упущения доказательств, путаницы в отношениях между элементами данных и избыточности ссылок, а также накапливает знания в процессе выполнения тренировочных задач.Примеры взаимодействия между процессами принятия решений, запоминания информации и последующим использованием результатов,Используется для оптимизации моделей памяти. После обучения модель снова применяется к новому кругу задач, а полученные от нее отзывы используются для улучшения стратегии записи данных и дальнейшего обучения, создавая цикл взаимодействия между задачами и оптимизацией модели (цикл RSI). В ходе этого процесса модель постепенно совершенствуется.Особенности представления информации в памяти, адаптированные к финансовым сценариямСохраняйте ключевые числовые значения в связи с применимыми условиями, различайте разных субъектов, отчетные периоды и источники, а также устанавливайте соответствие между фактами и доказательствами из оригинального текста. После Итерация RSI на 36 периодов,MemoraX Доля вызова доказательств достигла 96,49%, а точность выполнения задачи увеличилась с 33,33% до 73,33%.
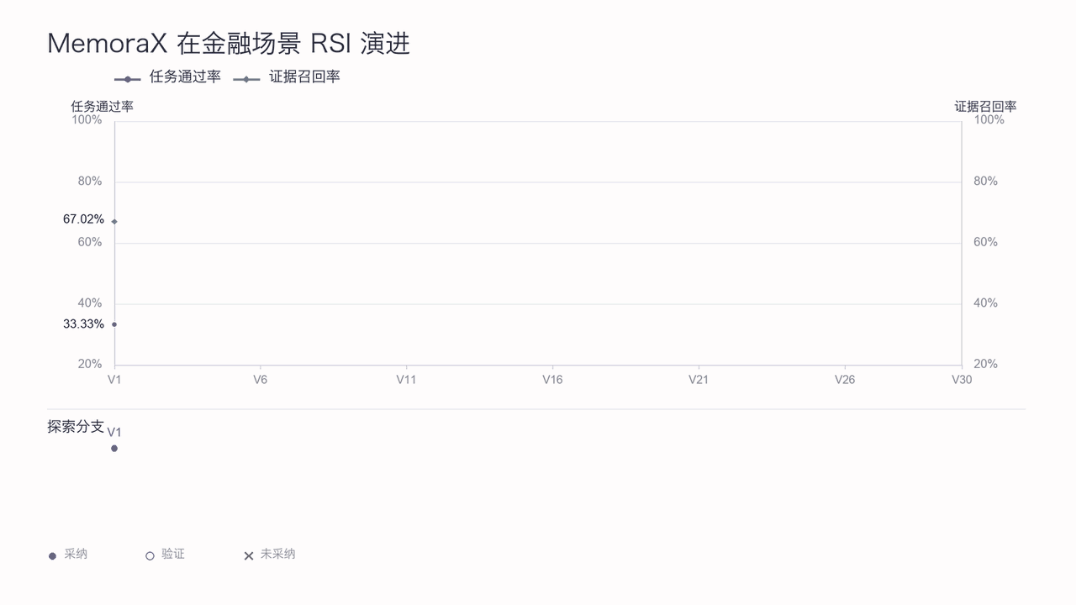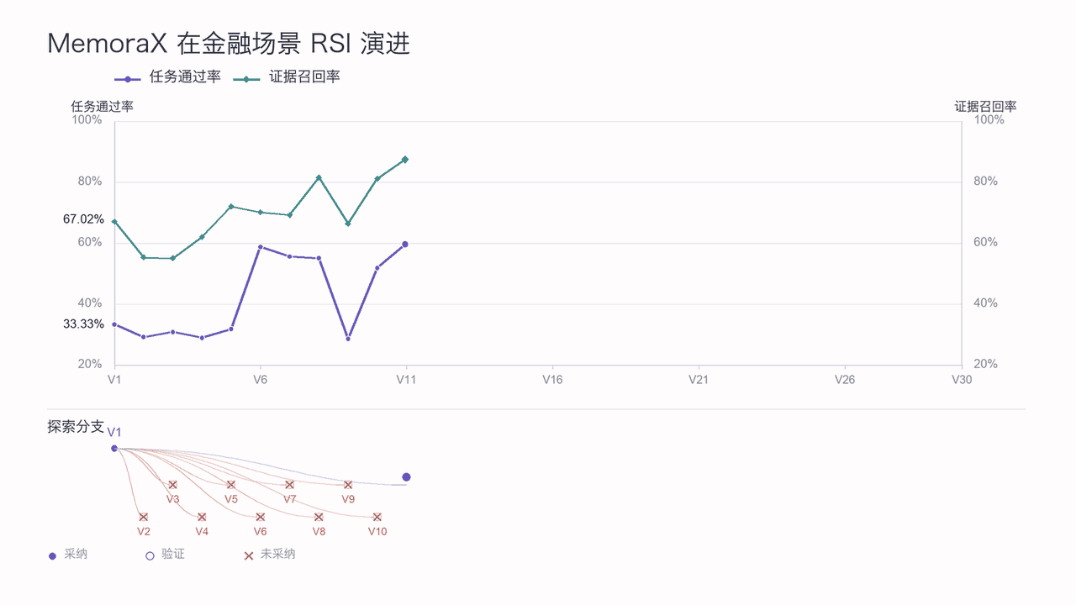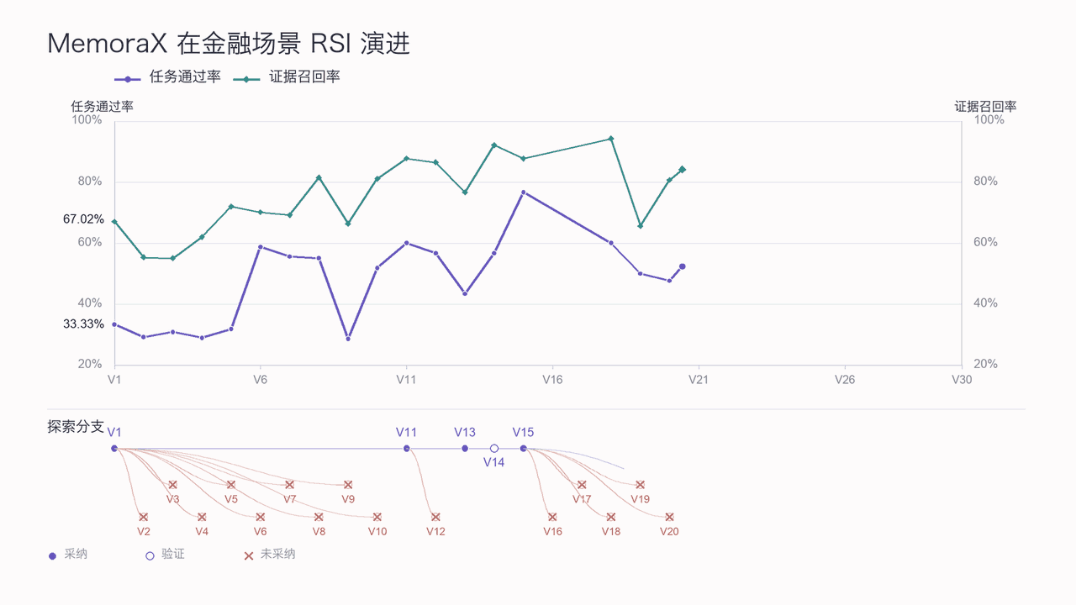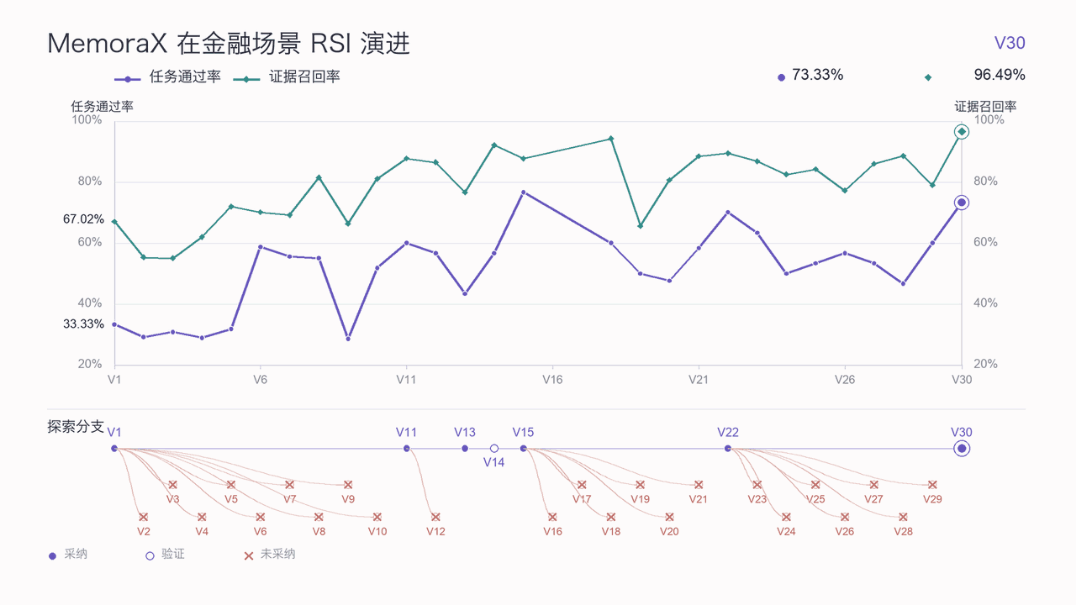
Для исследователей, которым необходимо долгосрочно отслеживать финансовые отчеты и объявления, знания, сформированные на основе одной и той же информации, могут быть использованы для решения различных задач, что позволяет снизить первоначальные затраты. Обратная связь, полученная в ходе последующего анализа, также способствует дальнейшему улучшению содержания этих знаний и стратегий их применения.Сделайте ответ более полным, сделайте использование более экономичным и позвольте опыту накапливаться постоянно,Это вместе образует практическую ценность MemoraX в выполнении сложных финансовых задач.
(3) Сложные математические рассуждения: от обратной связи на основе опыта к самоитеративным стратегиям решения задач
В экспериментах по математическому рассуждению высокой сложности MemoraX дополнительно исследовал возможности использования исторического опыта и обратной связи для поддержки агента в постоянном корректировании его рассуждений и оптимизации стратегий решения сложных задач. В задачах комбинированной оптимизации уровня IMO (Международной математической олимпиады) агент смог преодолеть значительные трудности после... 4 часа непрерывных вычислений, более 600 вызовов модели,Наконец было найдено проверенное решение. Оптимальное решение для 21 прямоугольника. По сравнению с решением OpenAI Codex, время решения сокращено на 13%, а затраты — на 98%.
От доказательств неудачи к оптимальному решению: постоянное совершенствование интеллектуальных процессов на основе обратной связи
Matilda 16×16, на мой взгляд, является задачей сложного уровня комбинаторной оптимизации: необходимо использовать как можно меньшее количество прямоугольников для покрытия 240 клеток в 16×16 сетке, при этом в каждом ряду и каждом столбце должно оставаться по одной пустой клетке. Само количество пустых клеток уже составляет примерно... 20,9 триллиона возможных комбинацийСложность заключается не только в поиске выполнимого решения, но и в доказательстве того, что не существует другого способа решения, который бы использовал меньше прямоугольников.
В ответ на этот вызов Агенты продолжали сотрудничать в области построения поисковых алгоритмов, формальных доказательств, точного моделирования и независимого аудита. Изначально система нашла 27 и 23 кандидатских решения, однако аргументация в пользу глобальной оптимальности для 23 из них была отклонена независимым аудитором.
MemoraX способен непрерывно накапливать предыдущие варианты решений, процессы их анализа и полученные отзывы о проверке. База знаний извлекает эффективный опыт из успешных сценариев и преобразует неудачи в рекомендации для последующей корректировки стратегий решения проблем:
- Механизм самокоррекции памяти: от неверных выводов к исправлению ошибок в памяти. Независимая аудитория отклонила 23 доказательства неправильной оптимальности, что побудило Агента пересмотреть сделанные выводы. Кроме того, результаты проверки, показывающие, что «приемлемое решение не равно оптимальному решению», были использованы для корректировки его «памяти» (системы хранения информации), чтобы предотвратить повторение тех же ошибок в последующих расчетах.
- Автоподстройка стратегий: от обновления на основе данных из памяти к улучшению методов реализации. На основе предыдущих предложений, разработанных с использованием моделей памяти, и обратной связи от проверки, агент был направлен на корректировку метода моделирования. Были объединены критерии определения пустых мест и ограничения по границам прямоугольников в процессе поиска решений, в результате чего были найдены более оптимальные варианты размером 22 и 21 блока соответственно.
- Повторное итерирование памяти: от проверки результатов к постоянному улучшению. Агент использует постепенную проверку и вызов инструментов для точного решения проблемы, в конечном итоге подтверждает оптимальность найденного ответа и возвращает новые результаты проверки в модель памяти для улучшения построения информации о решениях, что служит основой для решения подобных задач в будущем.
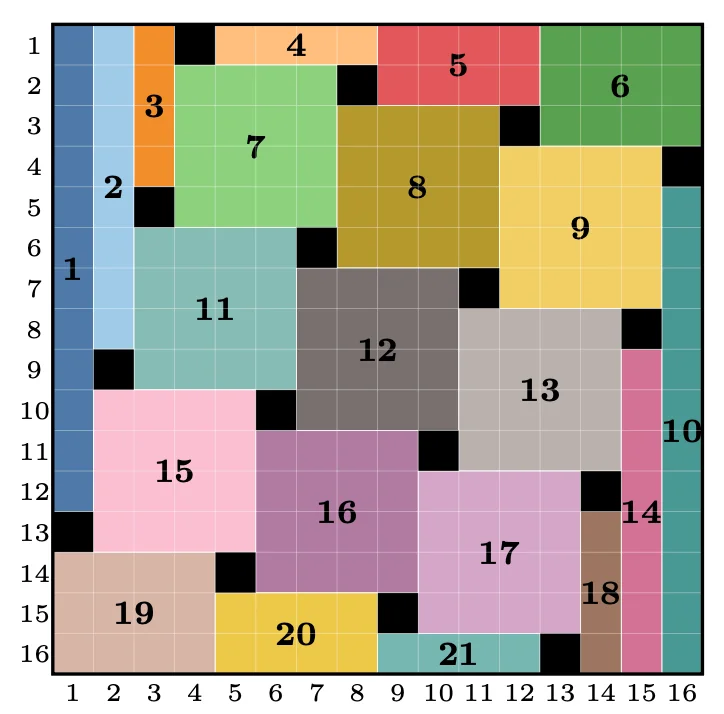
Оптимальное расположение 21 прямоугольника для задачи Matilda 16×16. Черные квадраты представляют собой пустые места, а различные по цвету области — прямоугольные плитки.
Это демонстрирует способность Агента к непрерывному итерированию при выполнении сложных математических задач:Исторический опыт больше не является просто статическим записью умозаключений; он может быть использован в сочетании с новыми данными о проверке для постоянной корректировки последующих стратегий решения проблем.
От начала памяти к постоянному развитию Агента
MemoraX AI (Империя Памяти) была основана Хао Цзянье, бывшим директором лаборатории принятия решений и рассуждений Huawei, директором лаборатории алгоритмов больших моделей и ведущим экспертом в области интеллектуального принятия решений. Она сосредоточена на создании следующего поколения обучаемых и эволюционирующих моделей памяти агентов.
Команда самостоятельно разработала модель памяти на основе технологии агентного робастного обучения (Agenetic Reinforcement Learning, Agentic RL), которая заняла первое место в мировом рейтинге моделей памяти и получила широкое освещение в таких известных СМИ, как MIT Technology Review, а также в других отечественных и зарубежных изданиях. Решения команды по обработке информации, связанные с памятью, нашли широкое применение в ведущих компаниях таких отраслей, как программирование, медицина, финансы, безопасность и умный дом. Команда является стратегическим партнером Huawei Cloud и Tencent Cloud.
Сегодня команда дальше углубляется в исследования алгоритма RSI, основанного на моделях памяти, позволяя агентам не только накапливать и повторно использовать опыт, но и осуществлять непрерывное обучение и самоусовершенствование, тем самым укрепляя свои лидирующие позиции в области искусственного интеллекта и памяти. В то же время ускоряется внедрение этого алгоритма в различных сценариях, а также продвигается стандартизация разработки модулей памяти для продуктов, предназначенных для бизнес- (B-) и потребительского (C-) сегментов рынка, с целью их массовой коммерциализации.
Заключение
Ключевым моментом агента RSI является не только то, чтобы AI демонстрировал лучшие результаты в одной конкретной задаче, но и то, чтобы...Пусть каждое выполнение становится основой для повышения ваших способностей на следующем этапе.Методы успеха, опыт неудач и условия их применимости накапливаются благодаря долгосрочной памяти и превращаются во вновь используемые руководства к действию при выполнении новых задач; новые результаты выполнения, в свою очередь, способствуют обновлению опыта, оптимизации стратегий запоминания и непрерывному обучению основных моделей памяти.
MemoraX исследует следующее:Пути взаимного развития между памятью и самосовершенствованием АгентаС одной стороны, память обеспечивает Агенту RSI постоянную базу опыта для накопления знаний и их переноса между различными задачами; с другой стороны, выполнение реальных задач и получаемые обратные связи способствуют обучению и эволюции самой памяти.
Когда каждое задание приносит опыт, а каждый отзыв способствует улучшениям, способности Агента уже не ограничиваются однократным выполнением, а открывается возможность для непрерывного накопления знаний и саморазвития.
Статья взята из "Машина сердца", автор "Машина сердца".
Ссылка на статью:https://www.airai.cc/ru/ai-news/54/
有用吗?