從記憶到自進化:Agent 走向 RSI 的關鍵一步
近期,全球頂尖 AI 實驗室正在密集釋放一個信號:AI 正在從幫助人類完成任務,走向參與自身的研發與改進。
9 月,OpenAI 宣佈已經實現「自動化 AI 研究實習生」的階段性目標,並計劃在 2028 年 3 月前打造真正的「自動化 AI 研究員」。OpenAI 首席科學家 Jakub Pachocki 同期發表長文,討論了遞歸自我改進(Recursive Self-Improvement,RSI)的發展前景。9 月 21 日,OpenAI 又進一步將自動化 AI 研究員以及持續改進 AI 研發能力,列為下一階段的重要戰略方向。
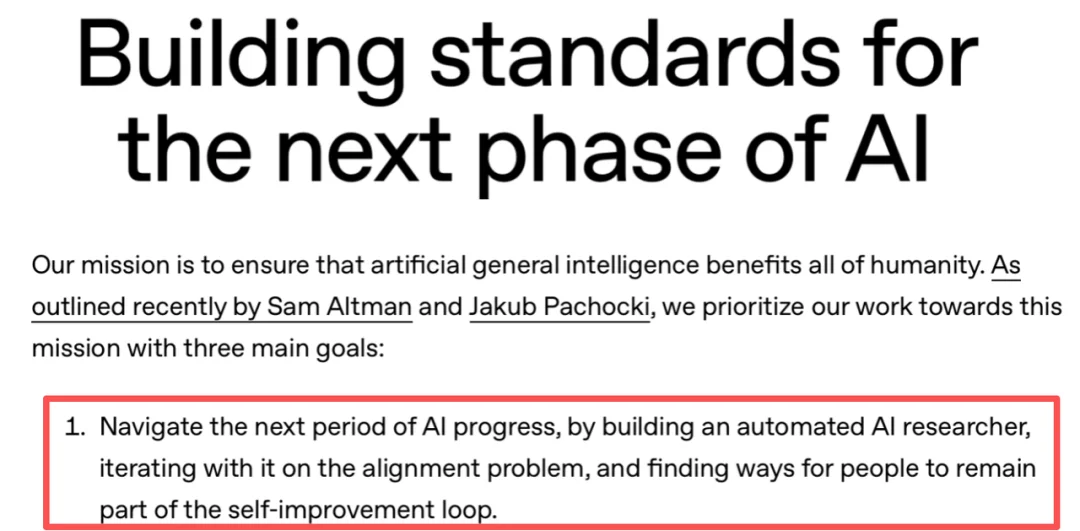
OpenAI 於 2026 年 9 月 21 日發佈官方戰略聲明,將自動化 AI 研究員和遞歸自我改進列為下一階段的重要目標
另一邊,Anthropic 也公佈了一組引人關注的數據:截至今年 8 月,Claude 已經在約 26% 的內部 AI 研發工作中承擔主導角色,越來越多原本由研究人員完成的研發任務,開始交由 AI 在人類監督下執行。
從 OpenAI 到 Anthropic,RSI 正從遙遠的技術設想,進入全球頂尖實驗室的核心研發議程。 AI 不再只是解決外部問題的工具,也開始參與推動自身能力的發展。
但這條持續進化的道路,最核心的關鍵在於:
AI 如何讓過去的探索與試錯真正成為下一次進步的基礎,而不是每次面對新任務都從頭開始?
記憶是支撐 Agent 持續自我改進的關鍵基礎。 它讓每一次探索留下的不只是任務結果,還有能夠被後續任務繼承和復用的經驗,使 Agent 的能力提升有機會跨越單次任務,在持續積累中不斷進化。
01 |從經驗積累到持續進化:
記憶如何支撐 RSI
要讓 Agent 在持續執行中不斷提升能力,關鍵是讓經驗能夠跨越單次任務:從過去的探索中沈澱有效方法,在新的任務中準確調用,並根據執行結果不斷修正和優化。 其中,記憶寫入與檢索承擔著兩個相互銜接的關鍵環節。
記憶寫入需要從複雜執行軌跡中識別有效方法、失敗結論及其適用條件,讓過去的任務真正留下可復用的經驗;記憶檢索則需要根據新的任務需求,準確找到適用的歷史方法與關鍵證據,避免經驗遺漏和錯誤遷移。
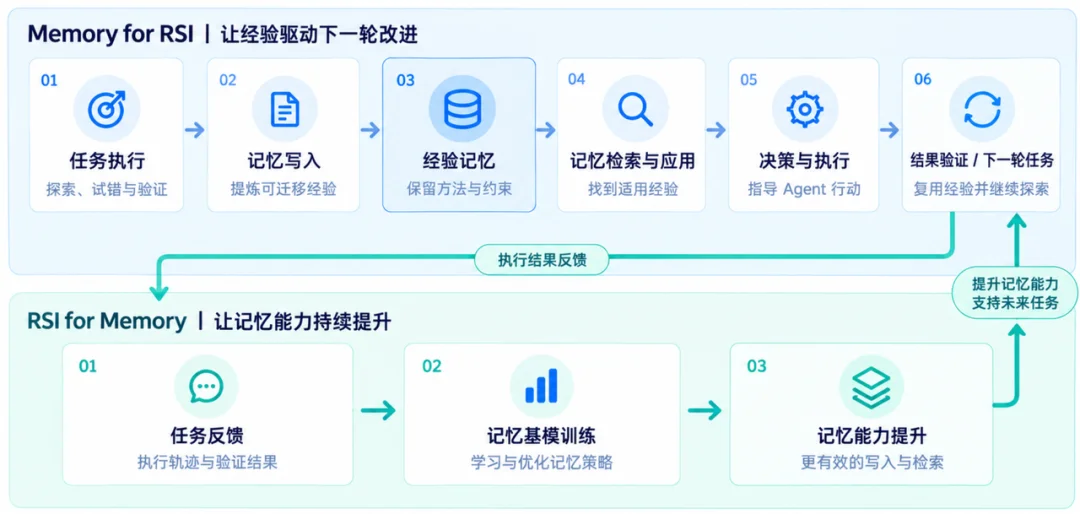
更進一步,任務反饋還能夠反過來檢驗經驗的實際價值。通過持續更新記憶內容,並將有效反饋用於記憶基礎模型訓練,推動記憶自身的能力提升,形成經驗積累與 Agent 改進相互促進的過程。
02 |記憶的學習與進化:
讓 Agent 從經驗中持續變強
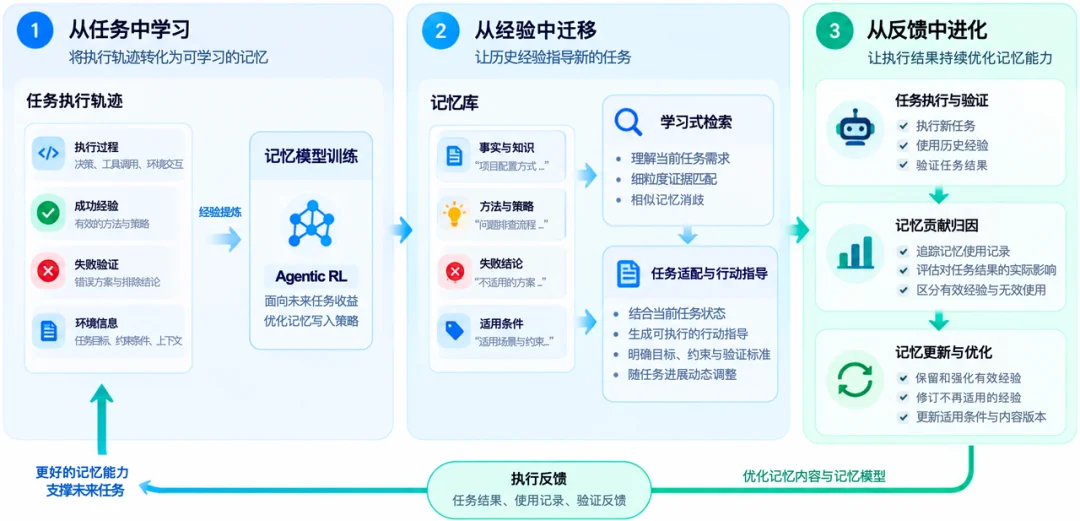
圍繞 Agent RSI 中經驗積累、跨任務復用與持續改進的需求,MemoraX 構建了以經驗學習、經驗遷移和反饋優化為核心的記憶能力體系,通過高質量記憶數據構造、動態記憶組織與基於真實任務反饋的優化,持續訓練記憶基礎模型,讓 Agent 從歷史經驗中不斷學習改進決策與執行。
從任務中學習:讓經驗積累成為可優化的模型能力
Agent 任務執行的過程中結果驗證與策略調整會源源不斷產生新的經驗。成功的決策為後續任務提供可復用的方法,經過驗證的失敗結論則幫助 Agent 排除無效方案、減少重復試錯。但經驗的價值往往要在後續任務中才能體現,準確概括過去,並不意味著能夠有效支持未來。因此,記憶學習的過程不僅需要識別值得保留的經驗,還要保存其驗證依據、環境約束與適用條件,避免經驗被遺漏或誤用,遠非簡單的信息摘要與壓縮能夠解決。
針對這一挑戰,MemoraX 將記憶寫入建模為面向未來任務收益的可學習策略,持續建設覆蓋環境構建、數據採集、樣本構造與規模化 Agentic RL 訓練的完整體系。在可交互、可驗證的任務環境中,採集執行軌跡、記憶使用記錄與驗證反饋,構造關聯寫入決策及後續使用效果的訓練樣本;再結合後續任務的完成質量、執行效率與重復試錯情況設計獎勵信號,優化記憶寫入策略。這一過程使模型的優化目標從信息提煉的準確性,進一步延伸到記憶對後續任務質量、執行效率與重復試錯的實際影響,學習更有利於未來任務的記憶寫入策略。
從經驗中遷移:讓歷史經驗指導新的任務
經驗能夠被保存,並不意味著它能在新任務中發揮作用。面對不同的任務目標、環境約束與執行階段,Agent 需要準確識別適用的歷史方法,避免無關信息乾擾和經驗的錯誤遷移。
為此,MemoraX 將記憶內容與訪問結構解耦,根據當前任務動態調整記憶訪問入口和關聯關係,讓相同的歷史信息能夠適應不同的使用需求。
在檢索層面,進一步通過模型訓練學習當前任務需求與歷史關鍵證據之間的匹配關係,結合細粒度證據識別與相似記憶消歧,提高關鍵經驗的定位能力,區分 「主題相關」 與 「證據正確」。
在經驗使用環節,MemoraX 結合當前任務狀態與執行進展,將歷史積累的通用經驗轉化為具有明確目標、操作約束和驗證標準的行動指導,並隨任務階段動態調整,讓歷史經驗真正參與 Agent 的決策與執行。
從反饋中進化:讓執行結果持續優化記憶能力
在 RSI 的持續迭代中,歷史經驗並非始終有效。新的任務既可能驗證已有方法,也可能暴露其局限。如何利用執行反饋判斷經驗的真實價值,並據此不斷優化記憶,是持續自我改進的重要環節。
其中的核心挑戰是 Memory Credit Assignment(記憶貢獻歸因):長程任務可能調用多條歷史經驗,但哪些真正影響了 Agent 的決策,哪些只是被讀取卻未發揮作用?即使最終任務成功,如何判斷不同記憶的實際貢獻,仍然是一個需要解決的問題。
圍繞這一挑戰,MemoraX 將記憶版本、實際使用記錄與任務執行反饋建立關聯,追蹤歷史經驗是否真正參與了 Agent 的行動,以及使用後的任務表現與驗證結果。在此基礎上,持續評估並迭代已有記憶,讓有效經驗得到保留和強化,並根據新的任務反饋,及時修正不再適用的經驗。
這些真實反饋也為記憶基礎模型的持續訓練提供了數據基礎和優化信號,使記憶的改進從內容層面的更新,進一步延伸到記憶模型對經驗價值與記憶策略的學習。
03 |從經驗積累到能力提升:
MemoraX 的多場景 RSI 實踐
對於 Agent RSI,更值得關注的不只是某一次任務取得了多好的結果,而是歷史經驗能否被不斷積累、修正,並在後續任務中持續產生價值。
圍繞這一過程,在長程複雜 Coding 、金融分析、複雜數學推理三類任務中,分別驗證了經驗的持續迭代、跨任務遷移與反饋優化能力,同時進一步驗證了記憶如何推動 Agent 在長程任務中的質量與效率提升。
(1)長程複雜 Coding:從經驗迭代到複雜工程能力提升
長程複雜 Coding 實驗在通信、金融、物流等 5 大行業,13 項工業級系統開發任務中,累計進行了 78 次開發運行,總開發時長超過 300 小時,單次最長超過 12 小時。最終,MemoraX 記憶增強方案通過率提升 20%+,同時主 Coding Agent 的累計 Token 消耗合計減少 20%+。
從經驗積累到遞歸改進:記憶的自我迭代之路
針對傳統靜態記憶難以在任務執行中持續積累和優化經驗的問題,MemoraX 團隊提出了Memory Model–Driven RSI(記憶模型驅動的遞歸自我改進)方法:通過自研記憶模型與 Agent 系統協同,由專用記憶模型負責從 Agent 執行軌跡與在線反饋中提煉、更新程序性記憶,並由 Agent 系統將記憶應用於實際任務,形成經驗提煉、任務應用、效果驗證與記憶更新的閉環迭代機制,使有效經驗能夠不斷積累、優化並指導後續任務。在長程 Coding 任務構成的訓練用例中,經過多輪記憶迭代優化,程序性記憶的質量提升超過 10%。
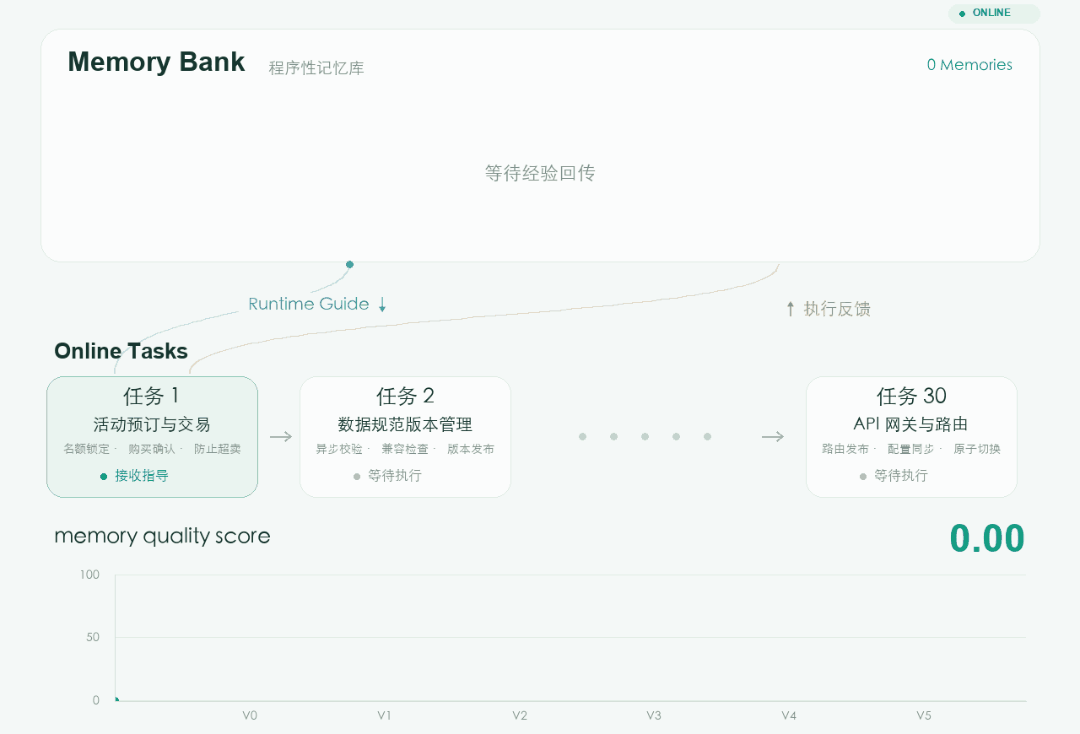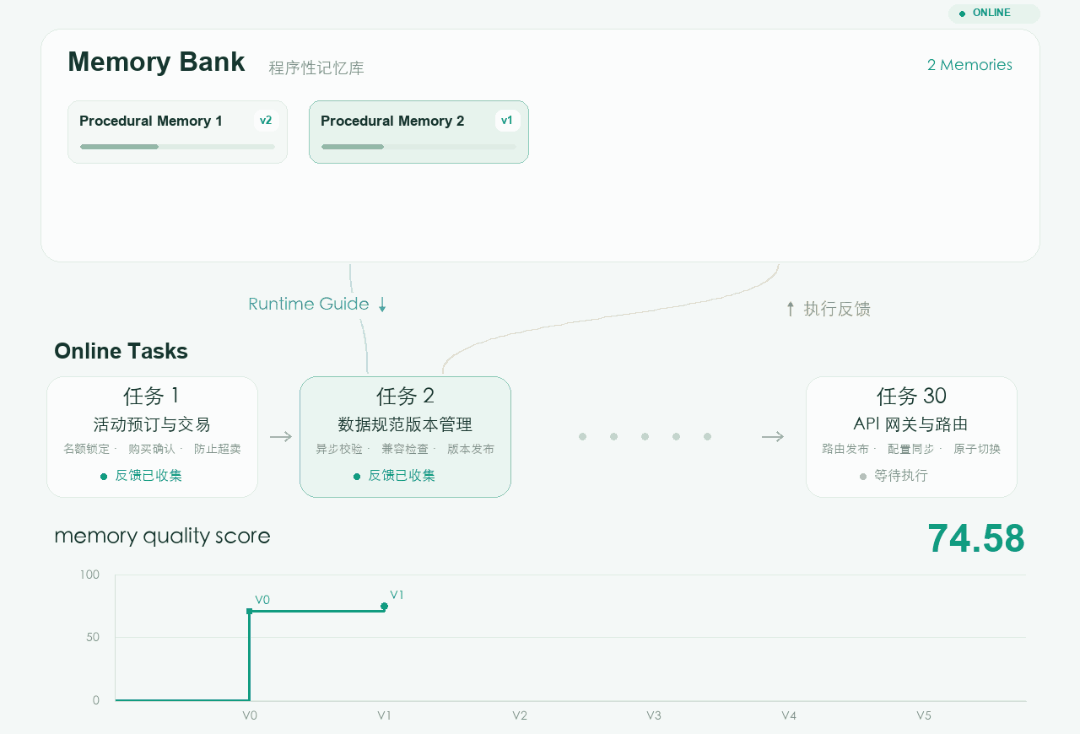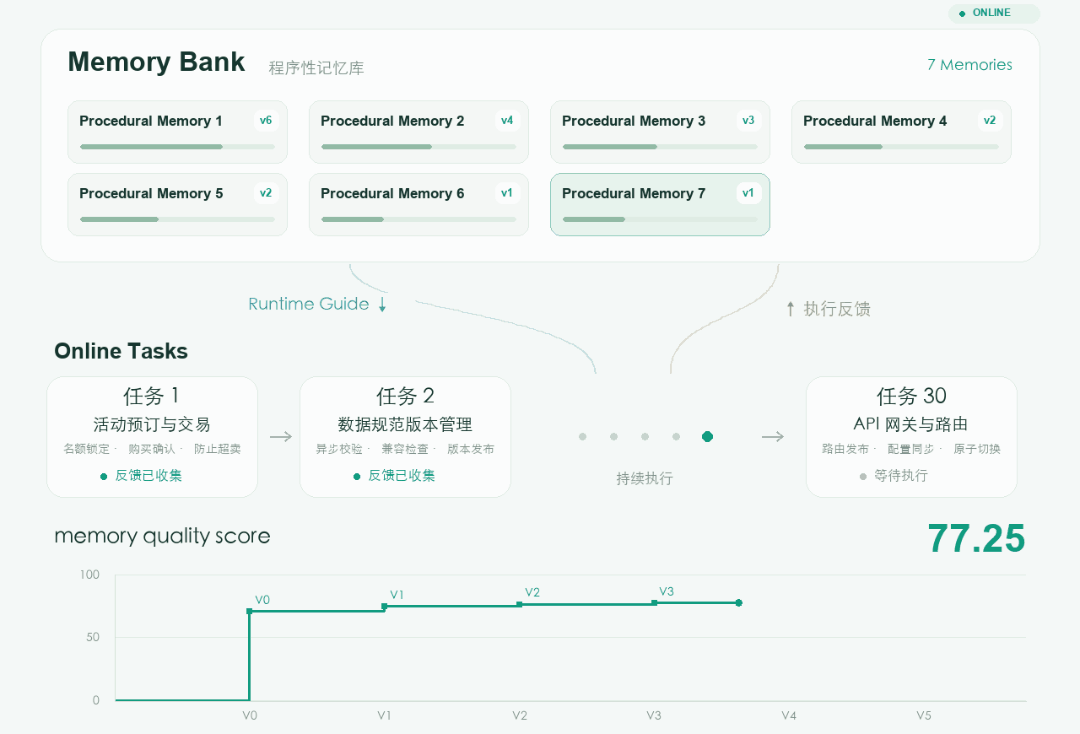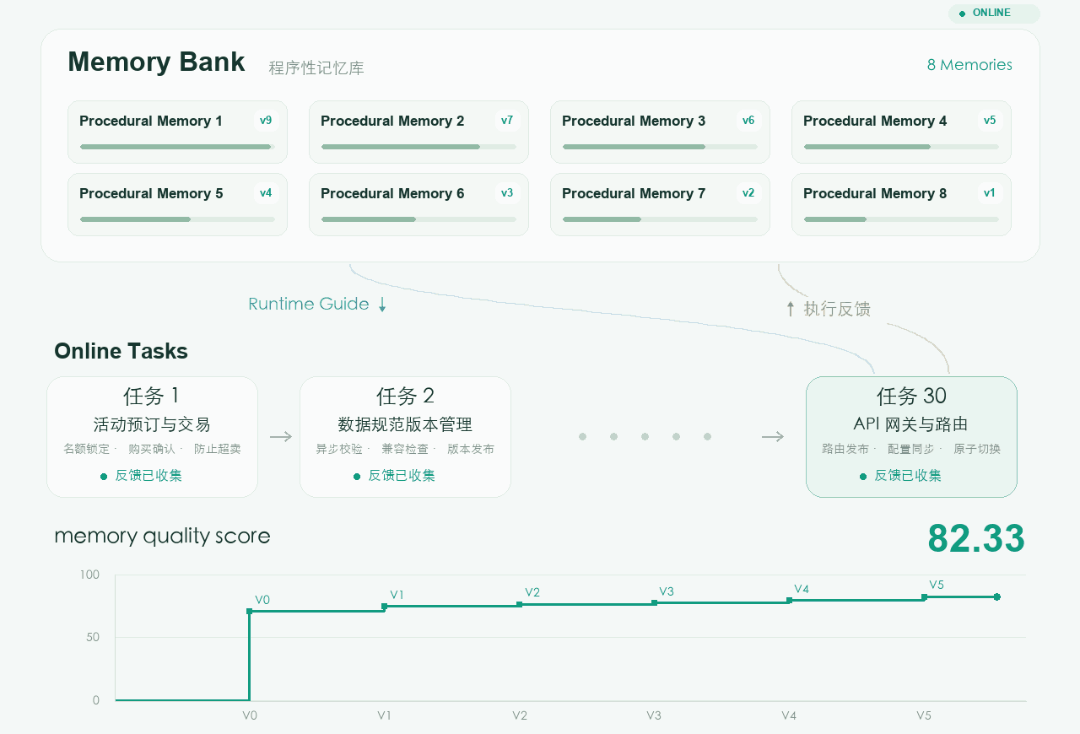
帶著反復迭代後的經驗,挑戰 335 小時的複雜工程開發
當積累下來的經驗脫離原來的學習任務,面對新的工程挑戰時,還能發揮多大的作用?
為此,將已經積累的經驗用於全新的複雜工程開發任務。在 13 項複雜軟件工程任務中,累計進行了 78 次開發運行,總開發時長超過 335 小時,單次最長超過 12 小時。這些任務遠不止簡單的代碼修改,而是涉及複雜業務邏輯、跨模塊依賴和大量測試的真實工程挑戰。
最終,通過率提升 20%+,同時 Coding Agent 的累計 Token 消耗合計減少 20%+。
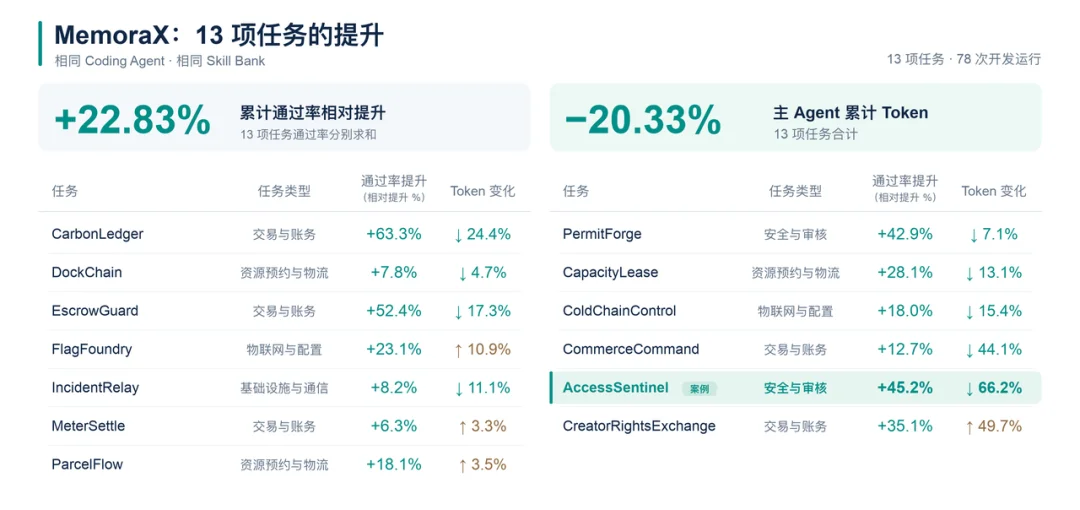
其中,AccessSentinel 是一個具有代表性的高難案例。Agent 需要構建一套完整的企業級權限控制系統,並確保嚴格的安全約束。
在記憶模型的幫助下,歷史經驗不再停留於靜態的信息參考,而是能夠隨著任務狀態變化,持續參與 Agent 的執行與驗證。從開發啓動後第 43 分鐘到第 2 小時 30 分鐘,記憶在不同關鍵節點主動提供針對性的指導:
- 設備權限撤銷時,不僅要禁止設備再次登錄,還要確保之前已經登錄的賬號無法繼續訪問系統。
- 安全策略恢復舊版本時,既要保留歷史記錄,也要防止已經取消的權限被意外恢復。
- 批量處理申請時,先檢查所有申請是否符合要求,只有全部通過才能統一執行,避免出現一部分成功、一部分失敗的情況。
在測試中,三次運行的平均通過率相對提升 45%+,而主 Coding Agent 累計 Token 消耗減少了 66%+。
(2)複雜金融分析:從證據積累到自主持續改進
金融研究需要從大量分散材料中形成完整、可靠的分析判斷。除了找到相關數據,Agent 還需要在複雜上下文下,準確理解主體、時間和統計口徑,建立不同證據之間的關聯,避免因信息遺漏或口徑混淆而影響最終結論。
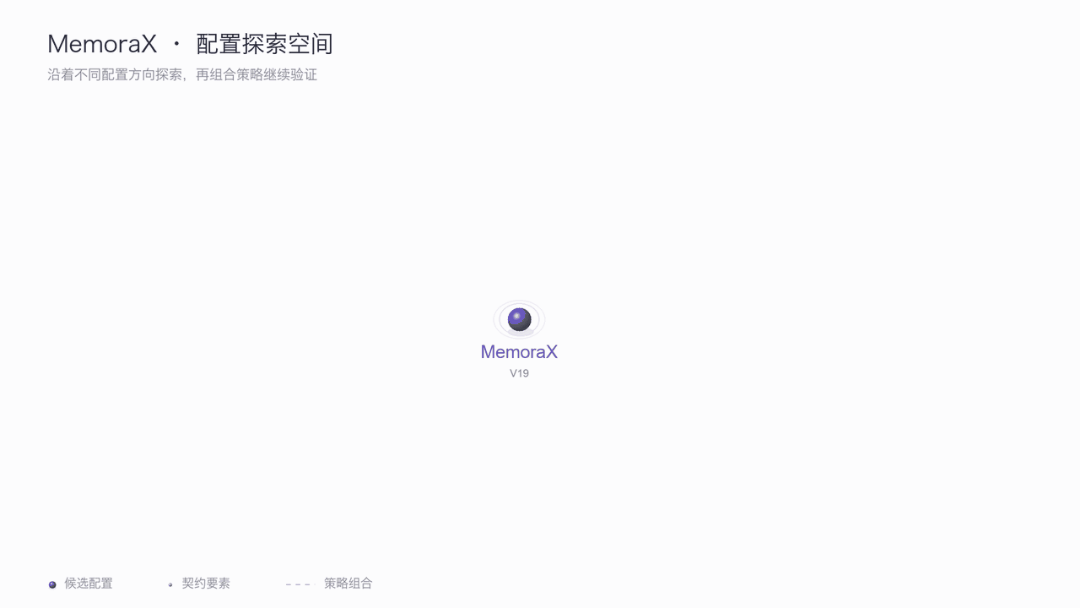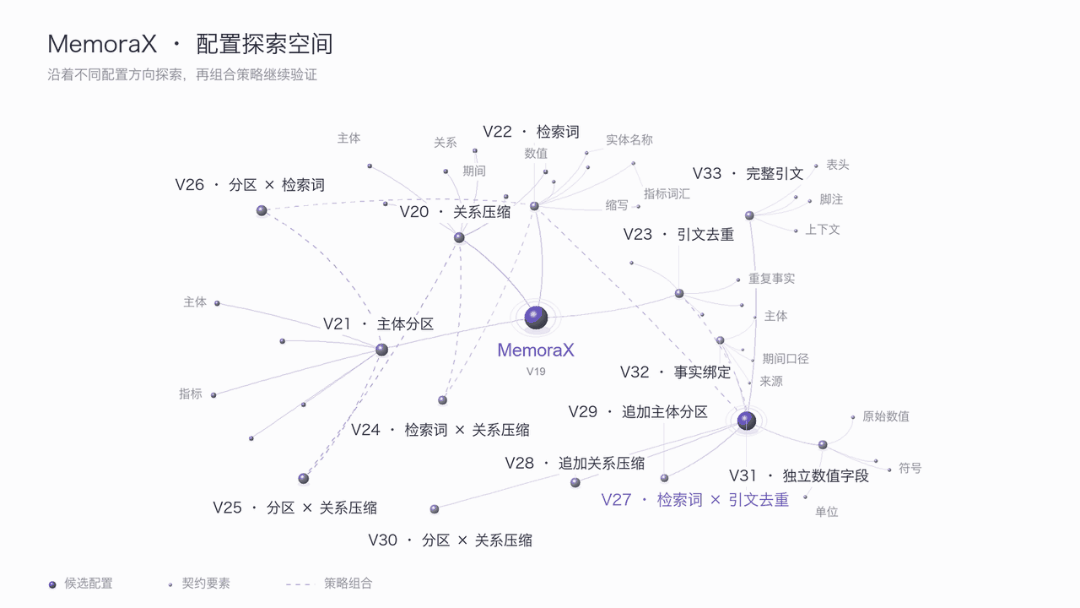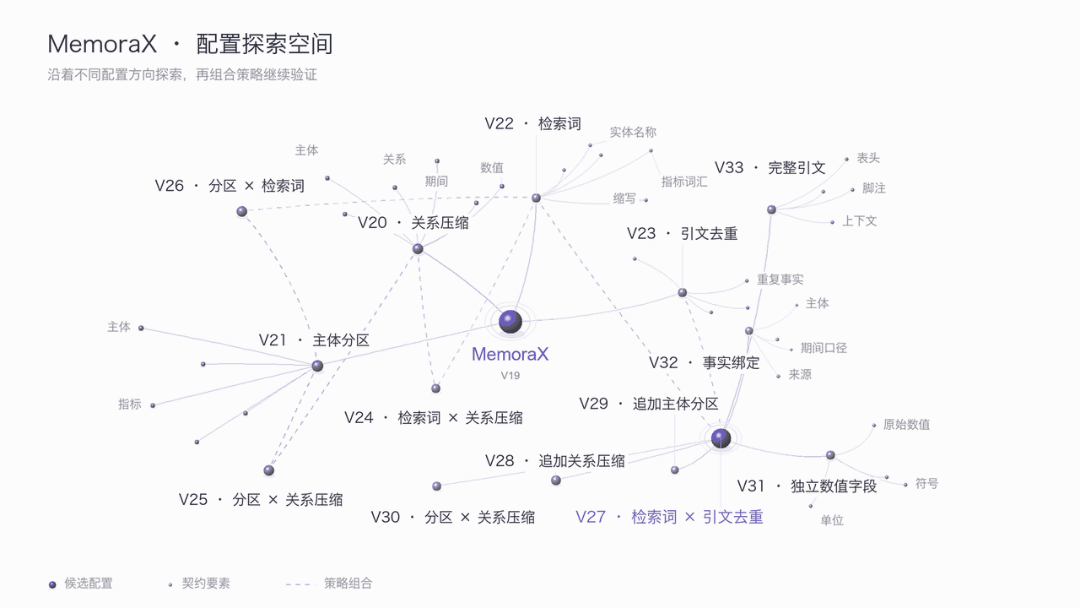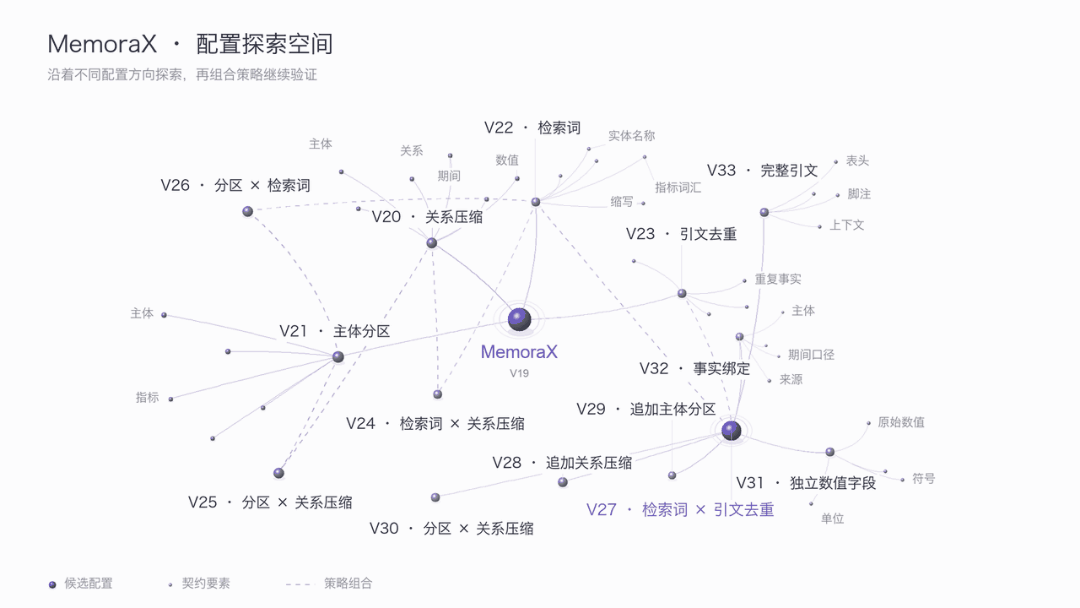
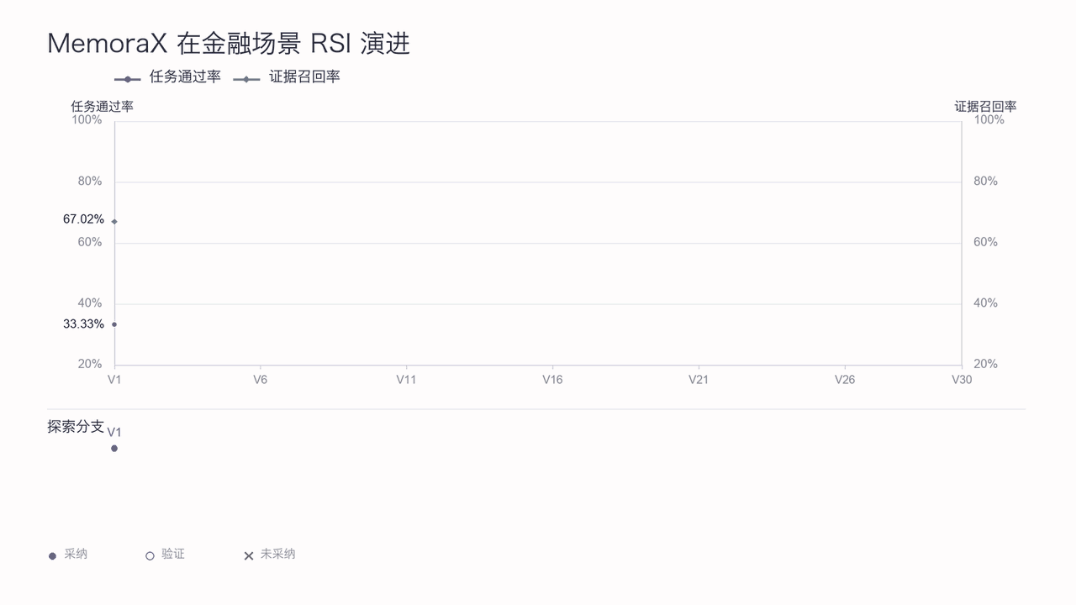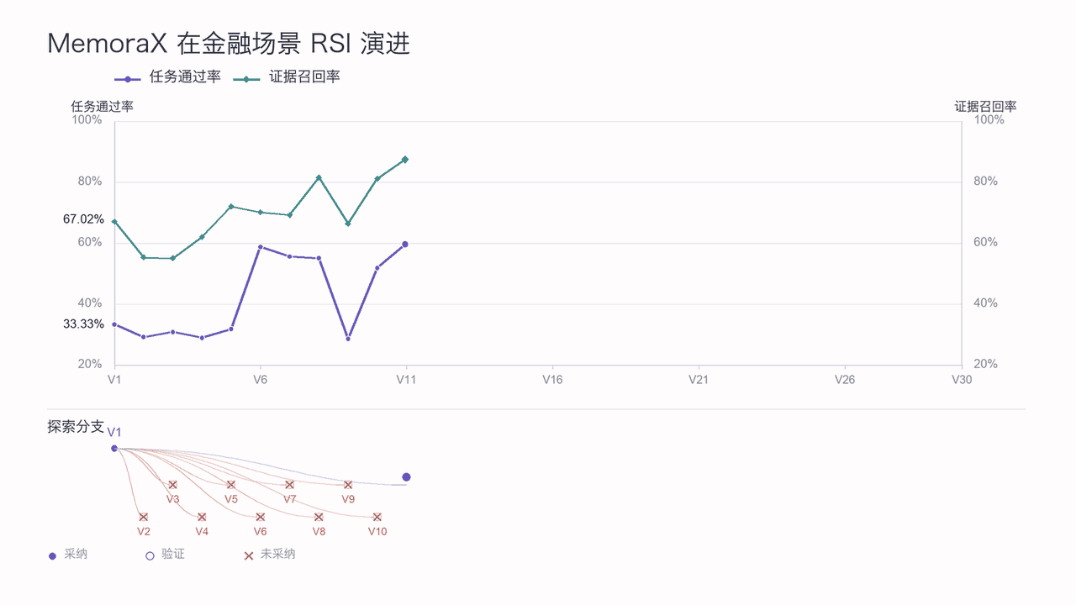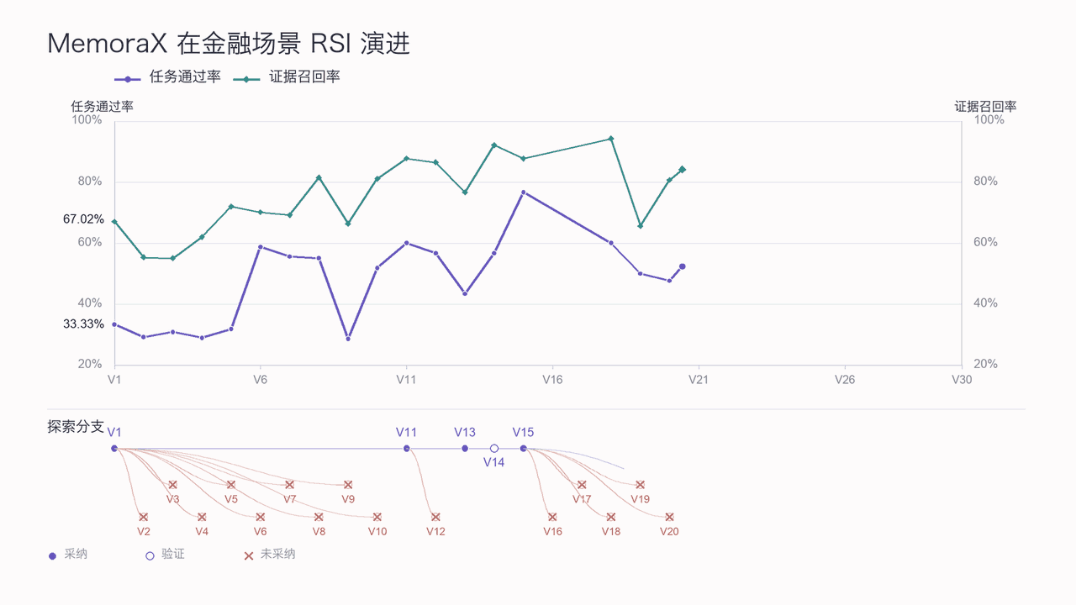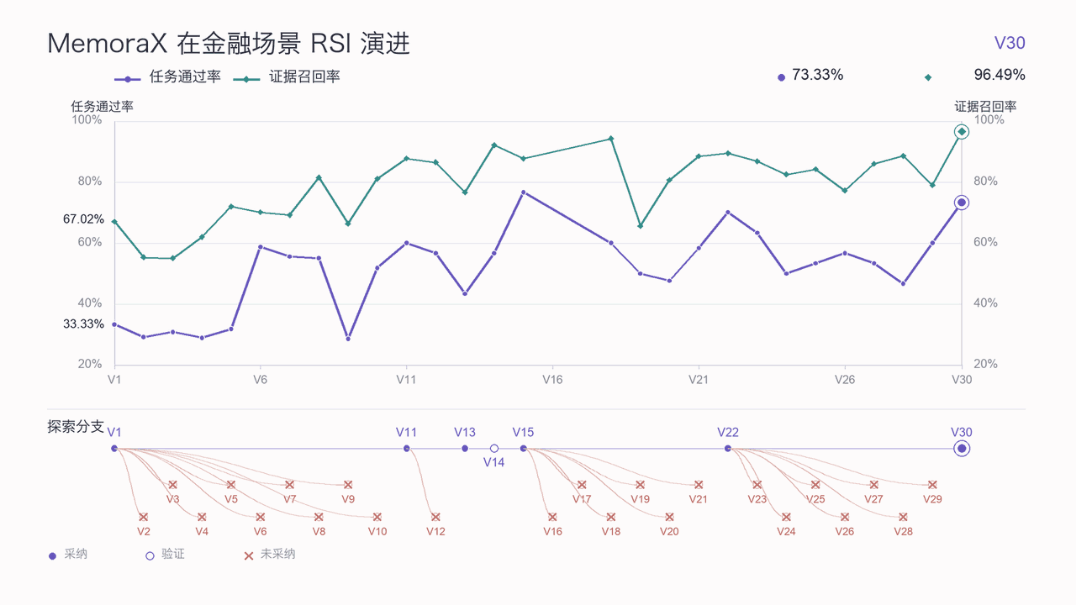
MemoraX 關注兩個相互銜接的問題:如何讓證據支撐完整回答,以及如何利用回答中的問題,反過來改進證據的保存與檢索方式。為此,MemoraX 基於金融領域權威基準 FinRank 開展實驗,該基準覆蓋制藥、油氣和汽車等行業 22 家美國上市公司真實財報,涵蓋大量跨公司、跨週期的複雜金融數據。圍繞這些任務,MemoraX 利用任務反饋持續優化記憶組織與檢索,形成 「執行 — 反饋 — 記憶改進 — 再執行」 的 RSI 迭代閉環。經 30 余次記憶模型和金融分析系統的協同迭代,最終證據鏈召回率接近 100%,相比於 CodeX 任務完成準確率提升 20%,成本降低了近 98%。
從找到數據,到組織能夠支持判斷的證據
以某大型製造企業的財務分析任務為例,任務相關證據分散在包含連續三年財務報表、供應商披露和風險說明的大量相似行業材料中。僅憑關鍵詞或語義相似度,容易找到主題相關、卻不屬於目標企業或報告期的內容;僅保留摘要,又可能遺漏數值口徑和風險成立的條件。
針對此,MemoraX 首先將上下文材料轉化為結構化記憶,並根據回答反饋迭代調整記憶組織方式,面向金融問答場景,逐步形成兼顧數值精確、口徑對齊與來源可追溯的記憶模型輸出表徵;檢索時,再圍繞當前問題關聯調用這些證據,把庫存現狀、採購結構和潛在風險放在一起分析。這種組織方式兼顧了金融任務對數值準確、口徑一致和來源可追溯的要求。
MemoraX 最終任務完成準確率較 Codex 對照提升近 20%。此外,按實際 API 用量統計,該方案成本相比於 Codex 對照方案降低了近 98%,在取得更高通過率的同時,顯著降低了調用費用。
從回答反饋到策略迭代:讓記憶改進 「如何保存、如何找回」
MemoraX 根據任務反饋,針對證據遺漏、關係混淆和引用冗余,不斷探索記憶的信息選擇與組織方式,並在訓練任務中持續積累關聯寫入決策、記憶內容與後續使用效果的交互樣本,用於優化記憶模型。訓練後的模型再參與新一輪任務,其執行反饋繼續用於改進寫入策略和後續訓練,形成任務交互與模型優化相互促進的 RSI 循環。在這一過程中,模型逐步湧現出適應金融場景的記憶表徵特性:將關鍵數值與適用條件關聯保存,區分不同主體、報告期和來源,並建立事實與原文證據之間的對應關係。經過 36 輪 RSI 迭代,MemoraX 證據召回率達到 96.49%,任務準確率從 33.33% 提升至 73.33%。
對於需要長期跟蹤財報與公告的研究者,同一批材料構建的記憶可以服務於不同問題,攤薄前期投入;後續分析中的反饋,又能繼續修正記憶內容與使用策略。讓答案更完整、讓使用更經濟、讓經驗能夠持續積累,共同構成了 MemoraX 在複雜金融任務中的實踐價值。
(3)複雜數學推理:從經驗反饋到求解策略自迭代
在高難度數學推理實驗中,MemoraX 進一步探索了利用歷史經驗與驗證反饋,支持 Agent 在複雜問題中持續修正推理、優化求解策略的能力。在 IMO (International Mathematical Olympiad) 難度的組合優化難題中,Agent 經過約 4 小時持續求解、600+ 次模型調用,最終找到了經過驗證的 21 塊矩形最優解。相比較 OpenAI Codex 方案,求解時間降低 13%,成本降低 98%。
從失敗證明到最優解:在反饋中持續改進推理
Matilda 16×16 是一道 IMO 級別的高難度組合優化問題:要求使用盡可能少的矩形覆蓋 16×16 網格中的 240 個方格,同時保證每行、每列恰好留下一個空洞。僅空洞位置就存在約 20.9 萬億種排列可能。難點不僅在於找到可行解,更在於證明不存在使用更少矩形的方案。
面對這一挑戰,Agent 圍繞構造搜索、形式證明、精確建模與獨立審計持續協作。系統最初找到 27 塊、23 塊的候選構造,但關於 23 塊全局最優性的論證被獨立審計否決。
MemoraX 能夠持續積累先前的候選方案、推理過程與驗證反饋,記憶基模從成功軌跡提取有效改進經驗,將失敗經驗轉化為後續調整求解策略的參考:
- 記憶自糾錯:從錯誤結論到記憶修正。 獨立審計否決了 23 塊的錯誤最優性證明,推動 Agent 重新審視已有結論,並將「可行解不等於最優解」的驗證反饋用於修正記憶,避免後續推理重復相同錯誤。
- 策略自優化:從記憶更新到方法改進。 基於記憶基模所提煉的此前候選方案與驗證反饋,指導 Agent 調整建模方法,將空洞位置與矩形邊界約束統一納入求解搜索,先後找到 22 塊、21 塊的更優方案。
- 記憶再迭代:從結果驗證到持續優化。 Agent 通過逐步檢查與調用工具進行精確求解,最終確認答案的最優性,並將新的驗證結果反饋記憶基模完善求解記憶構建,為後續類似問題提供參考。
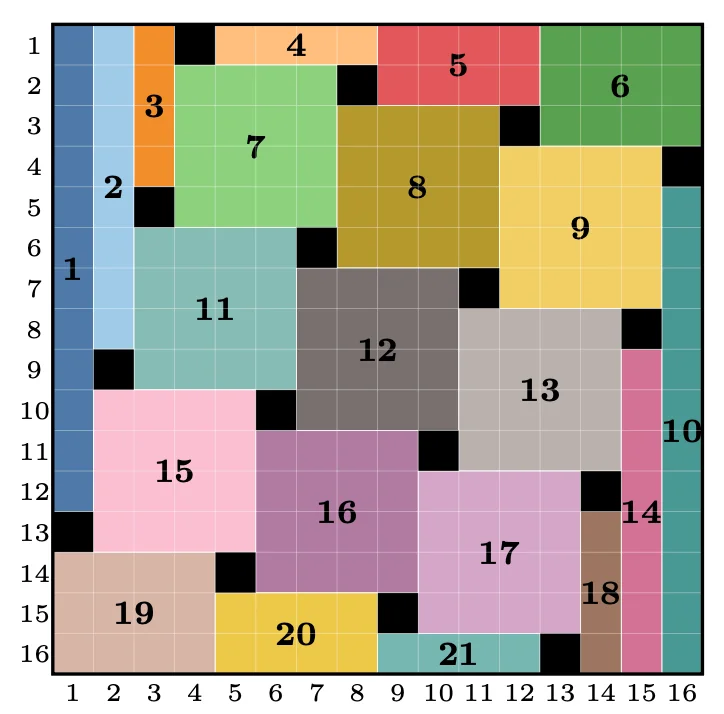
Matilda 16×16 問題的 21 塊矩形最優鋪法。黑色方格為空洞,不同顏色區域為矩形瓷磚
這展示了 Agent 在複雜數學任務中的持續迭代能力:歷史經驗不再只是靜態的推理記錄,而是能夠結合新的驗證反饋,持續參與後續求解策略的調整。
從記憶出發,走向持續進化的 Agent
MemoraX AI(憶紀元)由前華為決策與推理實驗室主任、大模型算法實驗室主任、智能決策方向首席專家郝建業創立,聚焦下一代可學習、可演化的 Agent 記憶模型。
團隊自主研發的基於 Agentic RL 技術的記憶模型在全球權威記憶榜單獲得冠軍,被麻省理工科技評論等國內外媒體廣泛報道和關注。團隊的記憶解決方案在編程、醫療、金融、安全、智能家居等行業頭部企業廣泛落地應用,是華為雲 / 騰訊雲戰略合作夥伴。
如今,團隊正進一步深入基於記憶基模的 RSI,讓 Agent 從積累和復用經驗,走向持續學習與自我進化,進一步夯實在 AI 記憶領域的領先優勢。同時,加速多場景落地應用,推進面向 B 端產業和 C 端產品的記憶模塊標準化研發與規模化商業化。
結束語
Agent RSI 的關鍵,不只是讓 AI 在單次任務中表現得更好,更在於讓每一次執行都能成為下一次能力提升的基礎。成功的方法、失敗的經驗與適用條件,通過長期記憶得以積累,並在新任務中轉化為可復用的行動指導;新的執行結果又反過來推動經驗更新、記憶策略優化與記憶基礎模型的持續學習。
MemoraX 正在探索的,是記憶與 Agent 自我改進相互促進的雙向演進路徑:一方面,讓記憶為 Agent RSI 提供持續積累、跨任務遷移的經驗基礎;另一方面,讓真實任務中的執行與反饋不斷反哺記憶自身的學習與進化。
當每一次任務都能留下經驗,每一次反饋都能推動改進,Agent 的能力提升就不再局限於單次執行,而有機會成為一個持續積累、自我演進的過程。
文章來自於"機器之心",作者 "機器之心"。
有用嗎?