Dari Memori ke Evolusi Mandiri: Langkah Kunci Agent Menuju RSI
Belakangan ini, laboratorium AI terkemuka di seluruh dunia sedang secara intensif mengirimkan sebuah sinyal:AI saat ini tidak hanya membantu manusia menyelesaikan tugas, tetapi juga mulai berpartisipasi dalam pengembangan dan peningkatan dirinya sendiri.
Pada bulan September, OpenAI mengumumkan bahwa mereka telah mencapai tujuan tahap demi tahap dalam program “Prajurit Penelitian AI Otomatis” dan berencana untuk menciptakan “Peneliti AI Otomatis” yang sebenarnya sebelum Maret 2028. Jakub Pachocki, ilmuwan utama OpenAI, juga menerbitkan artikel panjang pada periode yang sama, membahas prospek pengembangan teknologi Penyempurnaan Diri Recursif (Recursive Self-Improvement/RSI). Pada tanggal 21 September, OpenAI lebih lanjut menjadikan peneliti AI otomatis dan kemampuan pengembangan AI yang terus diperbaiki sebagai arah strategis penting untuk tahap berikutnya.
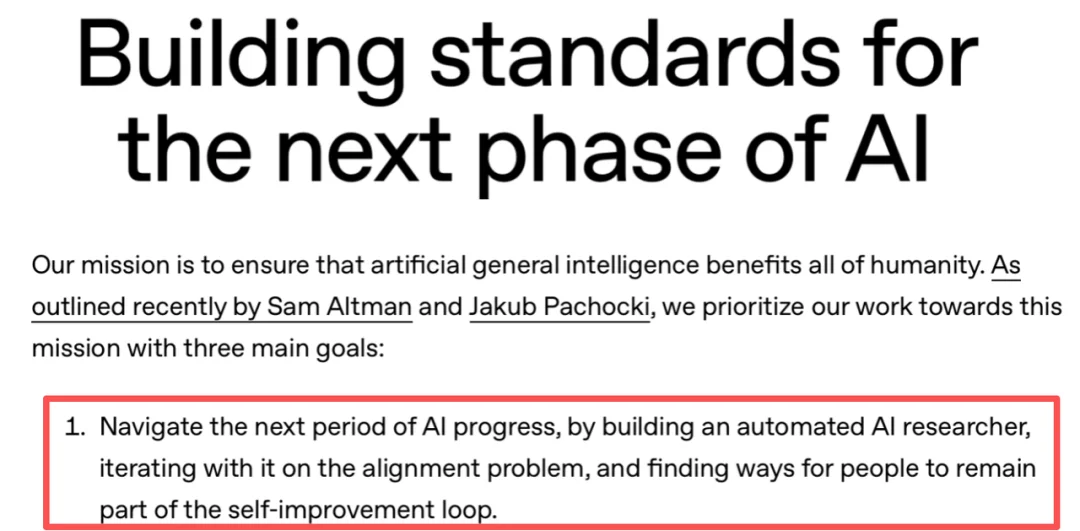
OpenAI merilis pernyataan strategis resmi pada tanggal 21 September 2026, di mana mereka menetapkan penelitian terhadap para peneliti AI otomatis dan kemampuan untuk melakukan perbaikan diri secara rekursif sebagai tujuan penting untuk tahap berikutnya.
Di sisi lain, Anthropic juga merilis serangkaian data yang menarik perhatian: hingga bulan Agustus tahun ini, Claude telah berhasil melakukan... 26% dari pekerjaan pengembangan AI internal memainkan peran utama.Semakin banyak tugas penelitian dan pengembangan yang sebelumnya dilakukan oleh para peneliti, kini mulai dikerjakan oleh AI di bawah pengawasan manusia.
Dari OpenAI ke Anthropic, RSI telah bergerak dari sekadar konsep teknis yang jauh di masa depan menjadi bagian inti dari agenda penelitian dan pengembangan di laboratorium-laboratorium terkemuka di seluruh dunia. AI tidak hanya lagi menjadi alat untuk menyelesaikan masalah eksternal, tetapi juga mulai berperan dalam mendorong pengembangan kemampuan dirinya sendiri.
Namun, kunci utama dari jalan evolusi yang berkelanjutan ini adalah:
Bagaimana AI dapat menjadikan eksplorasi dan percobaan yang telah dilakukan di masa lalu sebagai dasar untuk kemajuan berikutnya, bukan harus memulai dari awal setiap kali menghadapi tugas baru?
Memori adalah dasar kunci yang mendukung Agent untuk terus melakukan peningkatan diri secara berkelanjutan. Setiap kali melakukan eksplorasi, ia tidak hanya meninggalkan hasil tugas, tetapi juga pengalaman yang dapat diwarisi dan digunakan kembali oleh tugas-tugas berikutnya, sehingga kemampuan Agent memiliki kesempatan untuk berkembang melampaui batas satu tugas saja, dan terus berevolusi melalui akumulasi yang berkelanjutan.
01 | Dari Akumulasi Pengalaman Hingga Evolusi Berkelanjutan:
Bagaimana Memori Mendukung RSI
Untuk meningkatkan kemampuan Agent secara berkelanjutan selama proses eksekusi yang berkelanjutan, kuncinya adalah memastikan bahwa pengalaman yang diperoleh dapat diterapkan di berbagai tugas yang berbeda, bukan hanya pada satu tugas saja:Menggumpulkan metode-metode efektif dari eksplorasi sebelumnya, menerapkannya dengan akurat dalam tugas-tugas baru, dan terus memperbaiki serta mengoptimalkannya berdasarkan hasil pelaksanaan. Di dalamnya, proses penulisan data ke dalam memori (memori writing) dan pengambilan kembali data dari memori (memori retrieval) memainkan peran penting yang saling terkait.
Penulisan kembali memori memerlukan identifikasi metode yang efektif dari jalur eksekusi yang kompleks, kesimpulan kegagalan, serta kondisi di mana metode tersebut dapat diterapkan, sehingga tugas-tugas di masa lalu benar-benar meninggalkan pengalaman yang dapat digunakan kembali; sementara itu, pencarian kembali memori memerlukan penemuan metode historis dan bukti-bukti kunci yang sesuai berdasarkan kebutuhan tugas baru, untuk menghindari kehilangan pengalaman dan penerapan yang salah.
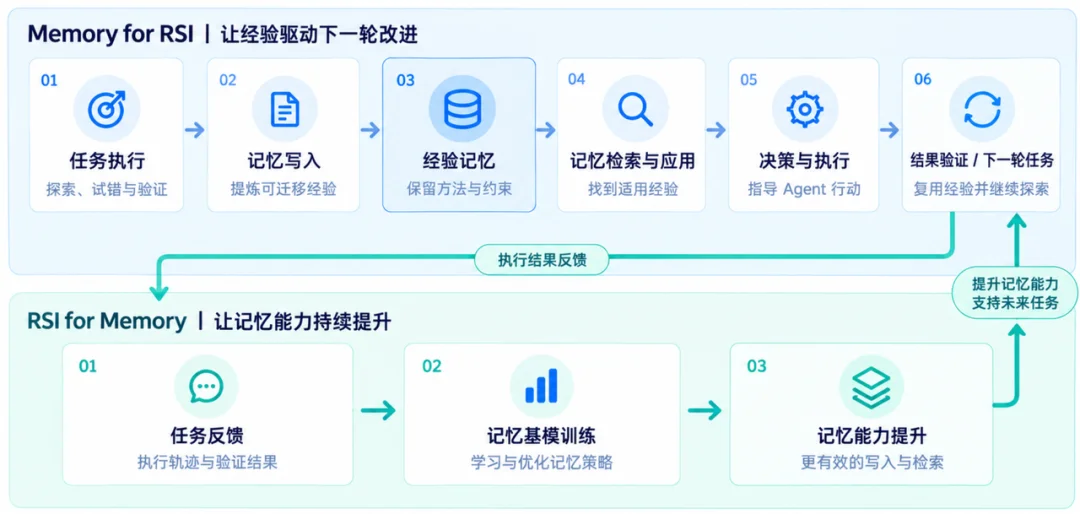
Selanjutnya, umpan balik dari tugas juga dapat digunakan untuk memverifikasi nilai praktis dari pengalaman tersebut. Dengan terus memperbarui isi memori dan menerapkan umpan balik yang efektif dalam pelatihan model dasar memori, kita dapat meningkatkan kemampuan memori itu sendiri, sehingga terbentuk proses saling memperkuat antara akumulasi pengalaman dan peningkatan kinerja Agent.
02 | Pembelajaran dan Evolusi Memori:
Biarkan Agent terus menjadi lebih kuat dari pengalaman yang didapatnya.
Mengingat kebutuhan untuk mengumpulkan pengalaman dalam Agent RSI, memanfaatkan kembali pengetahuan tersebut di berbagai tugas, dan terus melakukan perbaikan, MemoraX telah membangun sebuah sistem yang didasarkan pada...Pembelajaran berdasarkan pengalaman, transfer pengetahuan dari pengalaman, dan pengoptimalan berdasarkan umpan balikSistem kemampuan memori yang berfokus pada inti dari kemampuan mengingat, dengan membangun data memori berkualitas tinggi, mengorganisir memori secara dinamis, dan mengoptimalkannya berdasarkan umpan balik dari tugas nyata, terus melatih model dasar memori, sehingga Agent dapat terus belajar dan memperbaiki keputusan serta eksekusinya dari pengalaman historis.
Belajar dari tugas: Jadikan akumulasi pengalaman sebagai kemampuan model yang dapat ditingkatkan
Selama proses eksekusi tugas oleh agen, verifikasi hasil dan penyesuaian strategi akan terus menghasilkan pengalaman baru.Keputusan yang berhasil memberikan metode yang dapat digunakan kembali untuk tugas-tugas berikutnya, sementara kesimpulan kegagalan yang telah terverifikasi membantu Agent mengeliminasi solusi yang tidak efektif dan mengurangi upaya percobaan dan kesalahan yang berulang.Namun, nilai dari pengalaman seringkali baru terlihat dalam tugas-tugas berikutnya. Mampu merangkum masa lalu dengan akurat tidak berarti dapat mendukung masa depan dengan efektif. Oleh karena itu, proses pembelajaran melalui pengalaman tidak hanya memerlukan pengenalan pengalaman-pengalaman yang layak untuk dipertahankan, tetapi juga penyimpanan bukti-bukti verifikasi, batasan lingkungan, dan kondisi-kondisi yang berlaku, untuk menghindari pengalaman tersebut terlupakan atau digunakan secara salah. Hal ini jauh lebih kompleks daripada sekadar merangkum dan memadatkan informasi.
Menghadapi tantangan ini, MemoraX Mengubah ingatan menjadi strategi yang dapat dipelajari dan dirancang untuk menghasilkan manfaat di masa depan, serta terus membangun sistem yang komprehensif yang mencakup pembangunan lingkungan, pengumpulan data, konstruksi sampel, dan pelatihan RL (Reinforcement Learning) yang berskala besar dan mandiri.Dalam lingkungan tugas yang interaktif dan dapat diverifikasi, data jejak eksekusi, catatan penggunaan memori, serta umpan balik verifikasi dikumpulkan untuk membuat contoh pelatihan yang terkait dengan proses pengambilan keputusan dan efek penggunaan selanjutnya. Selanjutnya, sinyal penghargaan dirancang berdasarkan kualitas penyelesaian tugas berikutnya, efisiensi eksekusi, dan situasi percobaan dan kesalahan yang berulang, sehingga strategi penulisan memori dapat diperbaiki. Proses ini memperluas tujuan optimisasi model dari sekadar akurasi ekstraksi informasi menjadi aspek lainnya.Pengaruh nyata memori terhadap kualitas tugas selanjutnya, efisiensi eksekusi, dan proses percobaan dan kesalahan yang berulangBelajar lebih efektif dalam strategi penulisan memori untuk tugas-tugas di masa depan.
Migrasi dari pengalaman sebelumnya: Biarkan pengalaman historis membimbing tugas-tugas baru
Pengalaman dapat disimpan, tetapi hal tersebut tidak berarti bahwa pengalaman tersebut dapat langsung digunakan dalam tugas baru. Menghadapi berbagai tujuan tugas, batasan lingkungan, dan tahap pelaksanaan yang berbeda, Agent perlu secara akurat mengidentifikasi metode-metode historis yang relevan, serta menghindari gangguan dari informasi yang tidak terkait dan kesalahan dalam memindahkan pengalaman tersebut ke tugas baru.
Untuk itu, MemoraX akanDecoupling memory content from access structureMenyesuaikan akses memori dan hubungan terkait secara dinamis berdasarkan tugas saat ini, sehingga informasi historis yang sama dapat memenuhi berbagai kebutuhan penggunaan yang berbeda.
Pada tingkat pencarian (retrieval), lanjutkan lagi...Melalui pelatihan model, dipelajari hubungan antara kebutuhan tugas saat ini dan bukti-bukti kunci dari masa laluMenggabungkan identifikasi berbasis bukti detail dengan diskriminasi ingatan yang mirip untuk meningkatkan kemampuan penentuan pengalaman kunci, membedakan antara 'terkait topik' dan 'bukti yang benar'.
Pada tahap penggunaan berdasarkan pengalaman, MemoraX menggabungkan status tugas saat ini dengan kemajuan pelaksanaannya,Mengubah pengalaman umum yang telah terakumulasi sejak lama menjadi panduan tindakan yang memiliki tujuan yang jelas, batasan operasional, dan standar verifikasiDan disesuaikan secara dinamis sesuai dengan tahap-tahap tugas, sehingga pengalaman historis benar-benar dapat berpartisipasi dalam proses pengambilan keputusan dan pelaksanaan oleh Agent.
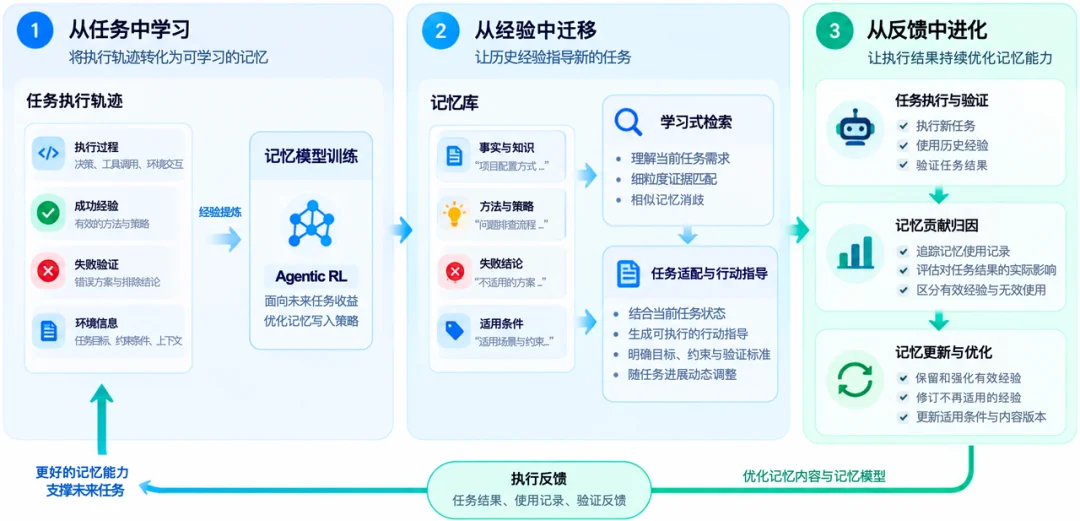
Evolusi berdasarkan umpan balik: Meningkatkan kemampuan memori secara berkelanjutan melalui hasil eksekusi
Dalam iterasi berkelanjutan dari RSI (Relative Strength Index), pengalaman historis tidak selalu efektif. Tugas-tugas baru dapat memverifikasi metode yang ada atau justru menunjukkan keterbatasannya.Bagaimana menggunakan umpan balik dari pelaksanaan untuk menilai nilai sebenarnya dari pengalaman, dan berdasarkan itu terus menyempurnakan ingatan, adalah bagian penting dari peningkatan diri yang berkelanjutan.
Tantangan utama di dalamnya adalah Pemetaan Kredit Memori (Memory Credit Assignment)Tugas jangka panjang mungkin memang memanfaatkan berbagai pengalaman historis, tetapi mana di antaranya yang benar-benar mempengaruhi keputusan Agent, dan mana yang hanya dibaca tanpa berdampak apa-apa? Meskipun tugas tersebut akhirnya berhasil, bagaimana menilai kontribusi nyata dari setiap pengalaman tersebut masih merupakan masalah yang perlu dipecahkan.
Mengingat tantangan ini, MemoraX akanMembangun koneksi antara versi memori, catatan penggunaan yang sebenarnya, dan umpan balik eksekusi tugasMengidentifikasi apakah pengalaman historis benar-benar berperan dalam tindakan Agent, serta kinerja tugas dan hasil verifikasi setelah penggunaannya. Berdasarkan ini, terus menilai dan mengiterasi ingatan yang ada,Pastikan pengalaman yang efektif dapat dipertahankan dan diperkuat, serta sesuaikan kembali pengalaman-pengalaman yang sudah tidak relevan berdasarkan umpan balik dari tugas-tugas baru.
Umpan balik nyata ini juga berkontribusi pada...Pelatihan berkelanjutan untuk model dasar memoriDiberikan dasar data dan sinyal optimisasi yang memungkinkan peningkatan kemampuan memori tidak hanya dari segi pembaruan konten, tetapi juga dari segi pembelajaran model memori terhadap nilai pengalaman dan strategi pengingatan.
03 | Dari Akumulasi Pengalaman ke Peningkatan Kemampuan:
Praktik Penggunaan RSI (Relative Strength Index) dalam Berbagai Scenario oleh MemoraX
Untuk Agent RSI, yang lebih penting untuk diperhatikan bukan hanya seberapa baik hasil dari suatu tugas, tetapi...Apakah pengalaman historis dapat terus dikumpulkan, diperbaiki, dan terus menghasilkan nilai dalam tugas-tugas berikutnya?
Dalam proses ini, kemampuan iterasi berkelanjutan dari pengalaman, migrasi antar-tugas, dan optimisasi berbasis umpan balik telah diverifikasi masing-masing dalam tiga kategori tugas yang kompleks, yaitu pemrograman jangka panjang, analisis keuangan, dan penalaran matematika yang rumit. Selain itu, juga diteliti lebih lanjut bagaimana memori mempengaruhi peningkatan kualitas dan efisiensi Agent dalam tugas-tugas jangka panjang.
(1)Pemrograman kompleks jangka panjang: Dari iterasi berdasarkan pengalaman hingga peningkatan kemampuan dalam proyek-proyek yang kompleks
Eksperimen pemrograman kompleks jangka panjang digunakan dalam bidang komunikasi, keuangan, logistik, dan lainnya. Dalam 5 sektor besar dan 13 tugas pengembangan sistem industri, telah dilakukan total 78 kali pengujian dan pelaksanaan pengembangan, dengan total waktu pengembangan lebih dari 300 jam, dengan durasi terpanjang per kali pengujian mencapai lebih dari 12 jam. Akhirnya, tingkat keberhasilan solusi penguatan memori MemoraX meningkat sebesar lebih dari 20%, sementara total konsumsi token oleh agen pemrograman utama (Coding Agent) juga berkurang sebesar lebih dari 20%.
Dari akumulasi pengalaman hingga peningkatan yang bersifat rekursif: Jalan iterasi diri memori
Untuk mengatasi masalah bahwa memori statis tradisional sulit untuk terus mengakumulasi dan mengoptimalkan pengalaman selama pelaksanaan tugas, tim MemoraX telah mengusulkanMetode RSI Berbasis Model Memori (Memory Model–Driven RSI)Dengan bekerja sama antara model memori yang dikembangkan sendiri dan sistem Agent, model memori khusus bertanggung jawab untuk mengekstrak dan memperbarui memori prosedural dari jejak eksekusi Agent serta umpan balik daring. Sistem Agent kemudian menerapkan memori tersebut ke dalam tugas-tugas nyata, membentuk sebuah mekanisme iteratif yang meliputi pengolahan pengalaman, penerapan tugas, verifikasi efek, dan pembaruan memori. Dengan demikian, pengalaman yang efektif dapat terus terakumulasi, diperbaiki, dan menjadi panduan untuk tugas-tugas berikutnya. Dalam kasus latihan yang terdiri dari tugas pemrograman jangka panjang,Setelah beberapa iterasi pengoptimalan pada proses pembentukan memori prosedural, kualitas memori tersebut meningkat lebih dari 10%.
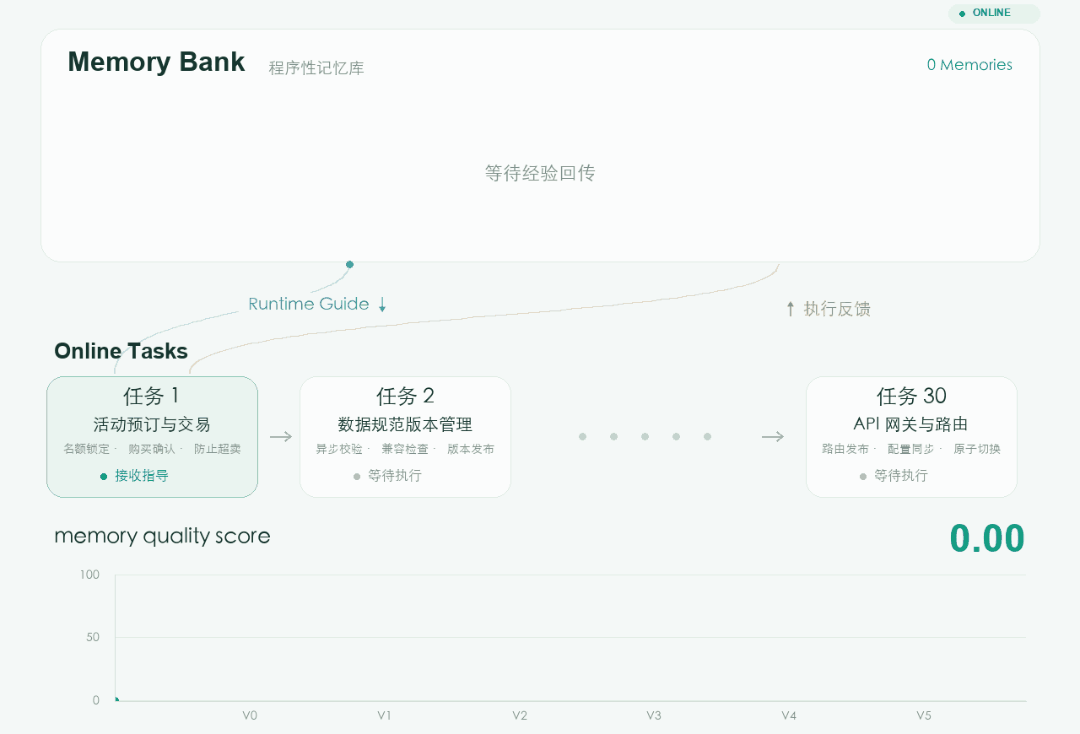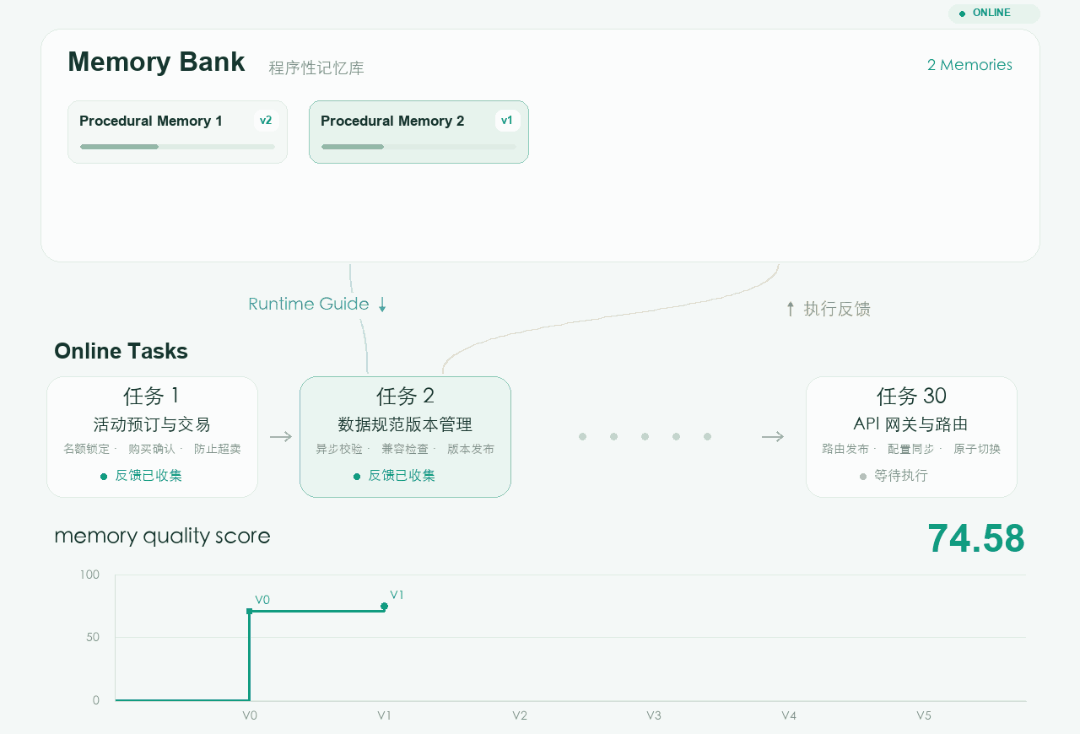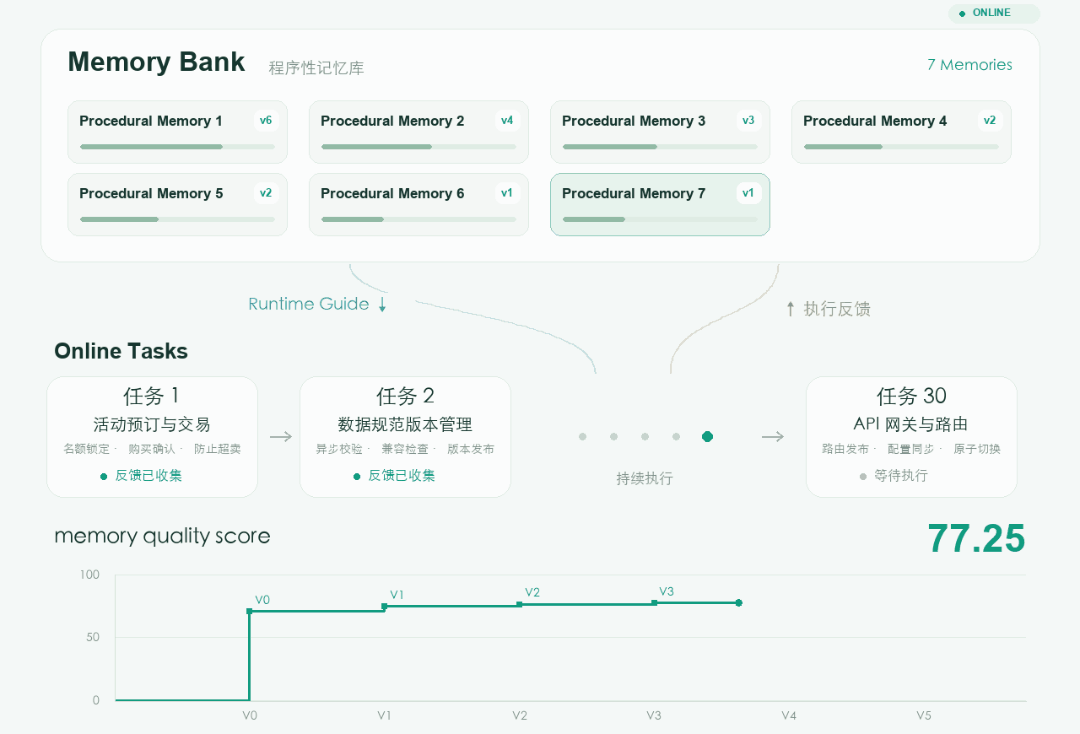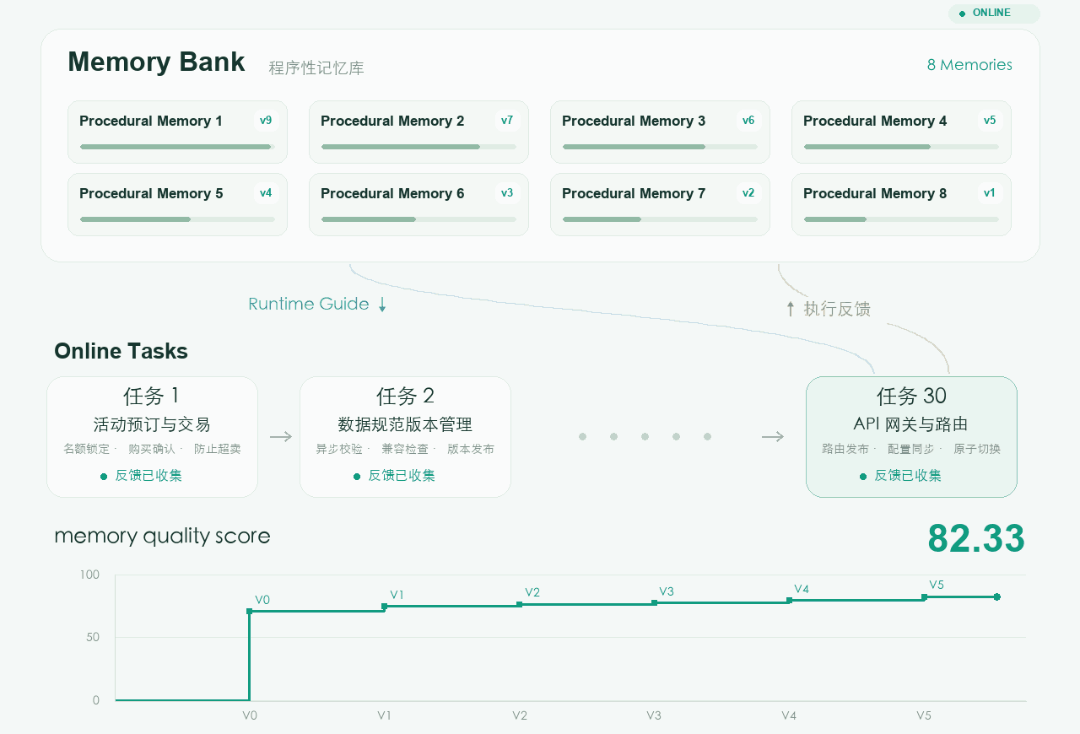
Dengan pengalaman yang diperoleh melalui iterasi berulang, menghadapi tantangan pengembangan proyek yang kompleks selama 335 jam
Seberapa besar peran yang masih dapat dimainkan oleh pengalaman yang telah terakumulasi ketika situasi tersebut berbeda dari tugas belajar awal, dan kita dihadapkan pada tantangan proyek yang baru?
Untuk itu, pengalaman yang telah terakumulasi akan digunakan dalam tugas pengembangan proyek kompleks yang baru.Dalam 13 tugas rekayasa perangkat lunak yang kompleks, telah dilakukan total 78 kali pengujian pengembangan, dengan total waktu pengembangan lebih dari 335 jam, dan durasi terpanjang untuk setiap pengujian adalah lebih dari 12 jam.Tugas-tugas ini jauh lebih dari sekadar modifikasi kode yang sederhana; melainkan merupakan tantangan rekayasa yang sebenarnya yang melibatkan logika bisnis yang kompleks, ketergantungan antar modul, dan sejumlah besar pengujian.
Pada akhirnya, tingkat keberhasilan meningkat sebesar lebih dari 20%, sementara total konsumsi token oleh Coding Agent juga berkurang sebesar lebih dari 20%.
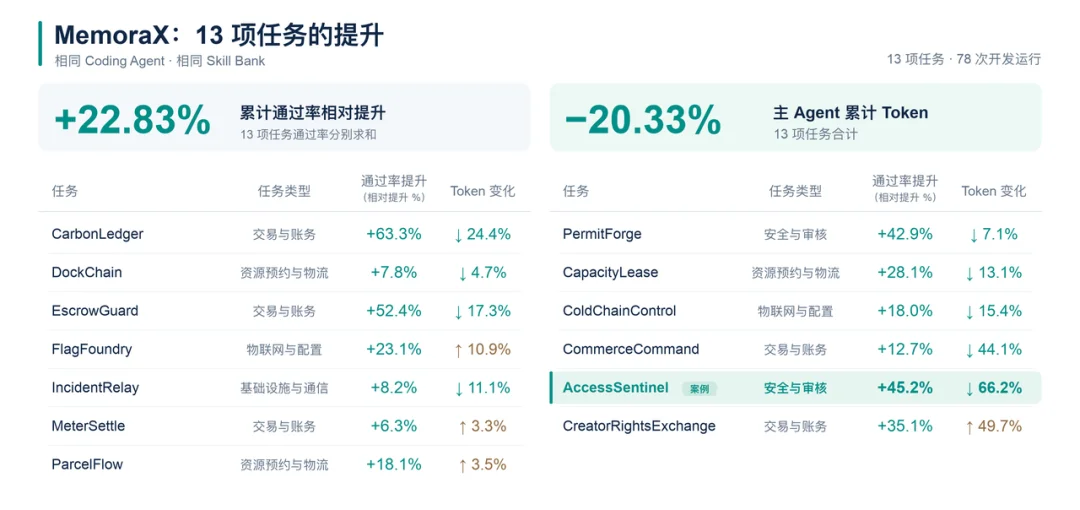
Di antaranya, AccessSentinel merupakan kasus yang sangat kompleks dan sulit untuk diatasi. Agen perlu membangun sistem kontrol akses tingkat perusahaan yang komprehensif, serta memastikan bahwa...Ketentuan Keamanan yang Ketat。
Dengan bantuan model memori,Pengalaman historis tidak lagi hanya berupa referensi informasi yang statis, tetapi dapat terus berpartisipasi dalam proses eksekusi dan verifikasi oleh Agent seiring dengan perubahan status tugas.Dari menit ke-43 setelah pengembangan dimulai hingga 2 jam 30 menit kemudian, ingatan tercatat pada berbagai titik kritis.Menawarkan secara proaktifPanduan yang ditujukan secara khusus:
- Ketika hak akses perangkat dicabut,Tidak hanya harus melarang perangkat untuk masuk log in lagi, tetapi juga harus memastikan bahwa akun-akun yang sebelumnya telah masuk log in tidak dapat terus mengakses sistem.
- Ketika strategi keamanan dikembalikan ke versi lama,Harus mempertahankan catatan sejarah, sekaligus mencegah agar hak akses yang telah dibatalkan tidak terjadi kembali secara tidak sengaja.
- Saat memproses aplikasi secara massal,Pertama-tama, periksa semua aplikasi untuk memastikan mereka memenuhi persyaratan. Hanya setelah semuanya lulus, barulah proses dapat dilakukan secara serentak, untuk menghindari situasi di mana sebagian berhasil dan sebagian lainnya gagal.
Selama pengujian,Rata-rata tingkat kelulusan pada tiga kali pelaksanaan meningkat sekitar 45%+, sementara konsumsi token secara kumulatif oleh agen pemrograman utama (main Coding Agent) berkurang sebesar 66%+.
(2) Analisis Keuangan Kompleks: Dari Akumulasi Bukti Hingga Pembaruan Mandiri yang Berkelanjutan
Penelitian keuangan memerlukan pengumpulan dan analisis informasi dari berbagai sumber yang tersebar untuk menghasilkan kesimpulan yang komprehensif dan dapat diandalkan. Selain menemukan data yang relevan, Agent juga perlu memahami dengan tepat subjek, waktu, dan metode statistik dalam konteks yang kompleks, serta membangun hubungan antar-bukti yang ada. Hal ini dilakukan untuk menghindari kesalahan dalam kesimpulan akhir akibat kelalaian informasi atau kesalahpahaman terhadap metode pengukuran.
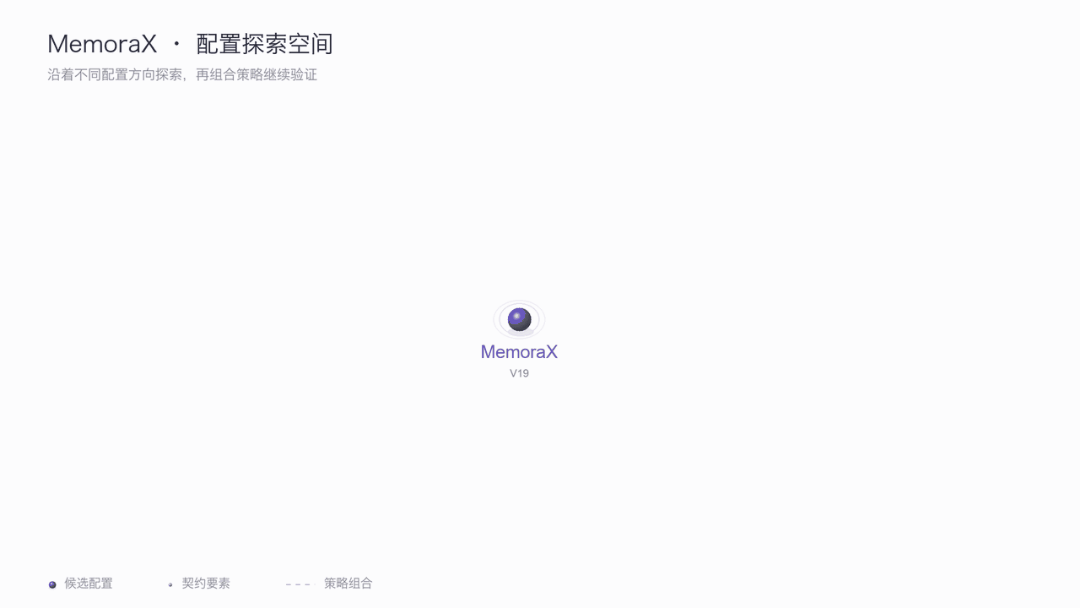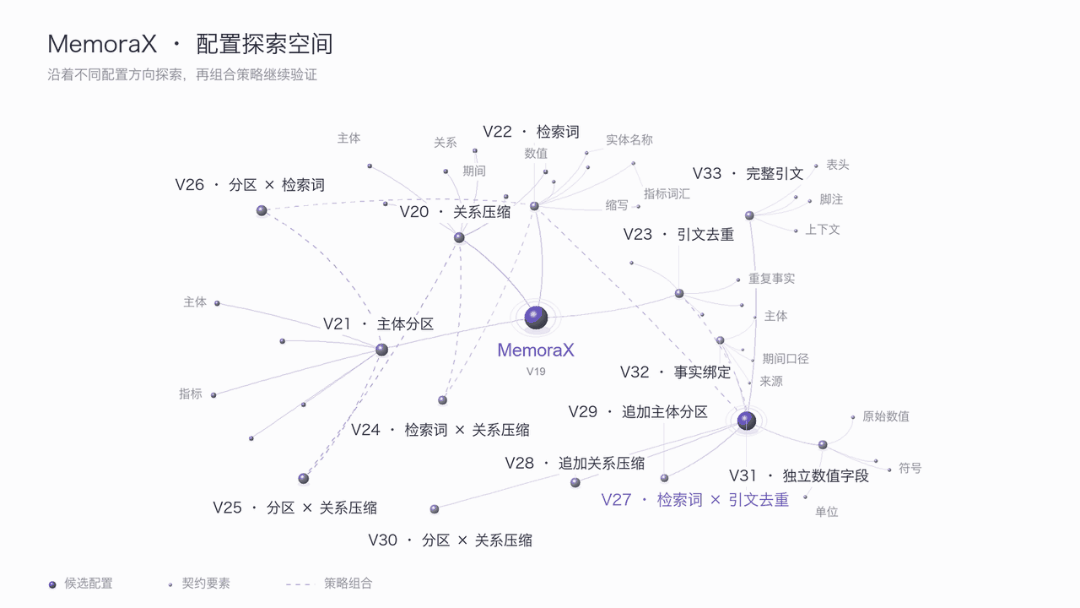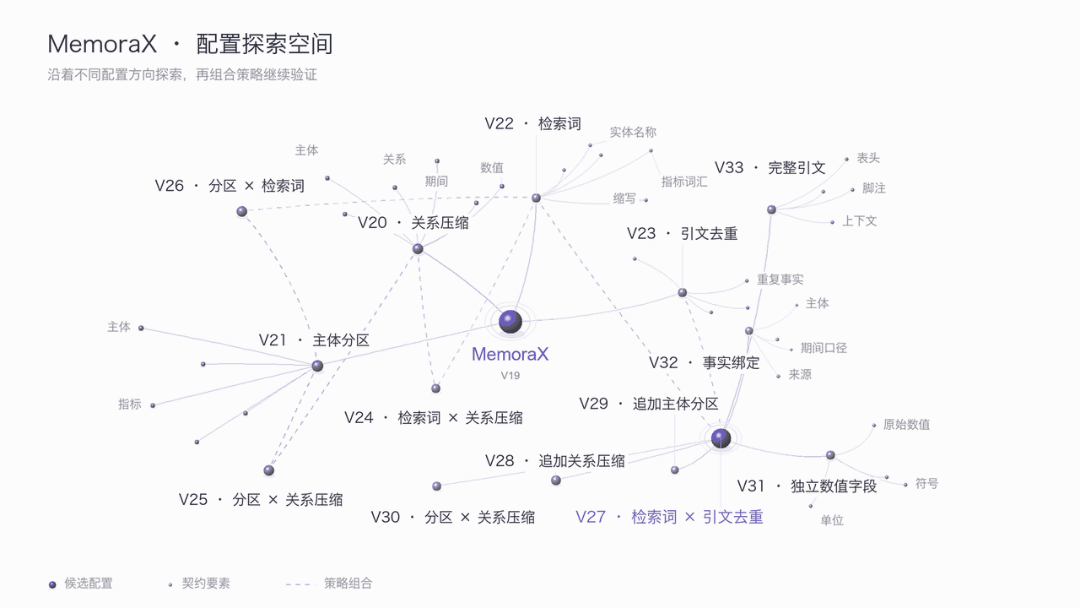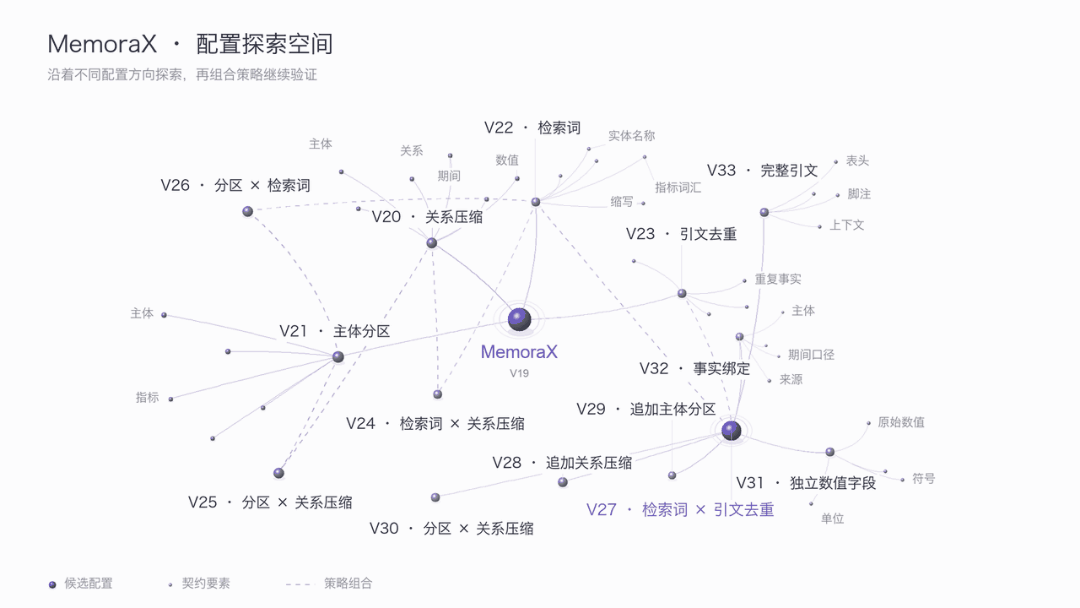
MemoraX memperhatikan dua masalah yang saling terkait:Bagaimana cara membuat bukti mendukung jawaban yang lengkap, serta bagaimana menggunakan pertanyaan-pertanyaan dalam jawaban tersebut untuk memperbaiki metode penyimpanan dan pengambilan kembali bukti?Untuk itu, MemoraX melakukan eksperimen berdasarkan patokan otoritas di bidang keuangan, yaitu FinRank, yang mencakup laporan keuangan aktual dari 22 perusahaan publik Amerika di industri farmasi, minyak dan gas, serta otomotif, serta data keuangan yang kompleks yang melintasi berbagai perusahaan dan periode waktu. Dalam rangka menyelesaikan tugas-tugas ini, MemoraX terus mengoptimalkan organisasi dan pengambilan informasi dari memori berdasarkan umpan balik dari proses tersebut, membentuk siklus iteratif RSI yang terdiri dari “eksekusi — umpan balik — perbaikan memori — eksekusi lagi”. Lebih dari 30 iterasi kolaboratif antara model memori dan sistem analisis keuanganPada akhirnya,Tingkat pengembalian rantai bukti mendekati 100%, yang merupakan peningkatan sebesar 20% dibandingkan dengan tingkat akurasi penyelesaian tugas CodeX, dan biayanya juga turun hampir 98%.
Dari menemukan data, hingga mengorganisir bukti-bukti yang dapat mendukung penilaian
Sebagai contoh, dalam tugas analisis keuangan sebuah perusahaan manufaktur besar, bukti-bukti yang terkait dengan tugas tersebut tersebar di berbagai materi industri yang serupa, yang mencakup laporan keuangan selama tiga tahun berturut-turut, pengungkapan dari pemasok, dan penjelasan risiko. Hanya dengan menggunakan kata kunci atau kemiripan semantik, mudah untuk menemukan konten yang relevan dengan topik tersebut, tetapi tidak berasal dari perusahaan atau periode laporan yang dituju; jika hanya menyimpan ringkasan saja, maka kemungkinan besar informasi mengenai unit pengukuran nilai dan kondisi risiko yang terjadi akan terlewat.
Untuk hal ini, MemoraX pertama-tama mengubah materi konteks menjadi ingatan yang terstruktur, kemudian secara iteratif menyesuaikan cara penyusunan ingatan berdasarkan umpan balik dari jawaban, dengan fokus pada skenario pertanyaan dan jawaban keuangan, sehingga secara bertahap terbentuk sistem yang memadai.Nilai numerik yang akurat, penyesuaian ukuran yang tepat, dan asal usul yang dapat dilacakRepresentasi keluaran dari model memori; saat melakukan pencarian, bukti-bukti ini dipanggil kembali berdasarkan pertanyaan yang ada, dan kemudian dianalisis bersama dengan status inventaris, struktur pembelian, serta risiko potensial. Pendekatan organisasi ini mempertimbangkan kebutuhan tugas keuangan.Angka yang akurat, konsistensi dalam metode pengukuran, dan asal-usul yang dapat dilacakPersyaratan dari <1/1>.
Akurasi penyelesaian tugas akhir MemoraX meningkat dibandingkan dengan Codex sebagai perbandingan.Hampir 20%Selain itu, berdasarkan statistik penggunaan API yang sebenarnya, biaya dari solusi tersebut...Dibandingkan dengan solusi kontrol Codex, biayanya telah dikurangi hampir 98%, sehingga tidak hanya mencapai tingkat kelulusan yang lebih tinggi, tetapi juga secara signifikan mengurangi biaya pemanggilan.
Dari umpan balik jawaban hingga iterasi strategi: Meningkatkan kemampuan mengingat “bagaimana cara menyimpan, bagaimana cara mengambil kembali”
MemoraX, berdasarkan umpan balik dari tugas-tugas yang dilakukan, terus menerus mengeksplorasi cara memilih dan mengorganisir informasi dalam ingatan terkait dengan kekurangan bukti, kebingungan hubungan, dan redundansi dalam referensi, serta terus menambahkan pengetahuan ini selama proses pelatihan.Contoh interaksi antara keputusan penulisan terkait, isi yang disimpan dalam memori, dan efek penggunaan selanjutnya,Digunakan untuk mengoptimalkan model memori. Setelah dilatih, model tersebut kembali berpartisipasi dalam siklus tugas baru, dan umpan balik dari eksekusinya terus digunakan untuk menyempurnakan strategi penulisan dan pelatihan selanjutnya, membentuk siklus RSI (Reinforcement Learning with Interaction) di mana interaksi antara tugas dan pengoptimalan model saling memperkuat. Dalam proses ini, model secara bertahap mengembangkan kemampuannya.Karakteristik representasi memori yang sesuai dengan skenario keuanganSimpan nilai kunci beserta kondisi yang berlaku, bedakan antara berbagai subjek, periode laporan, dan sumbernya, serta buat hubungan antara fakta dan bukti asli. Setelah itu... 36 Iterasi RSI (Relative Strength Index),MemoraX Tingkat pengambilan kembali bukti (evidence recall) mencapai 96,49%, dan tingkat akurasi tugas meningkat dari 33,33% menjadi 73,33%.
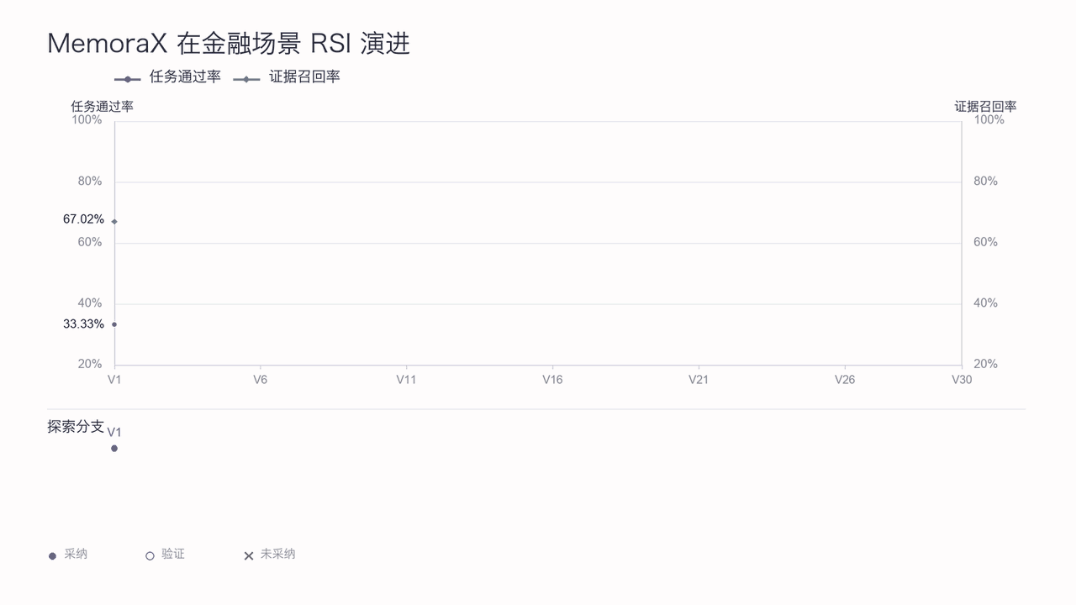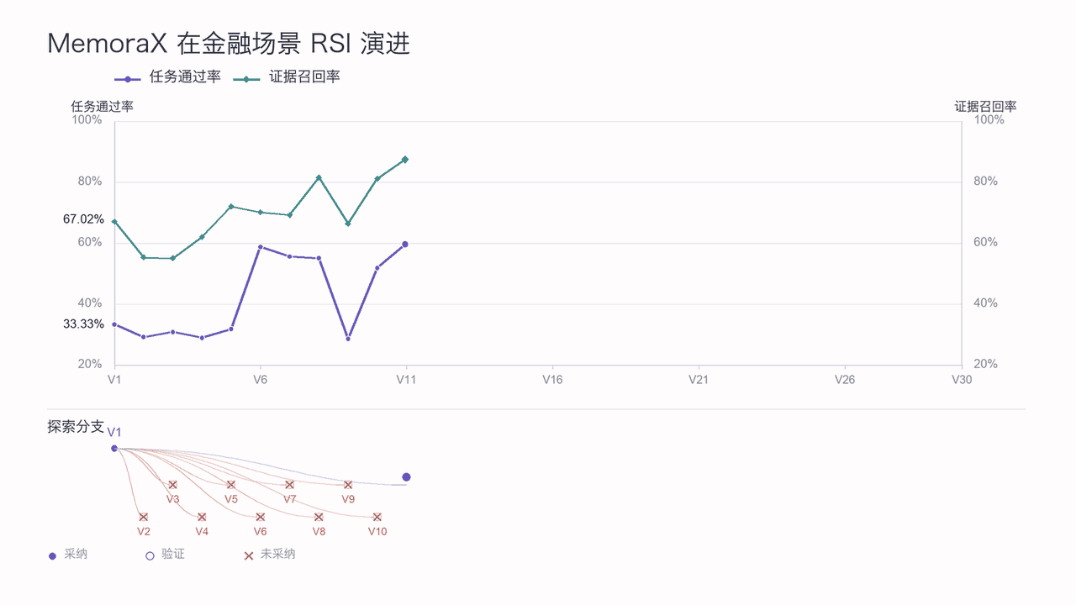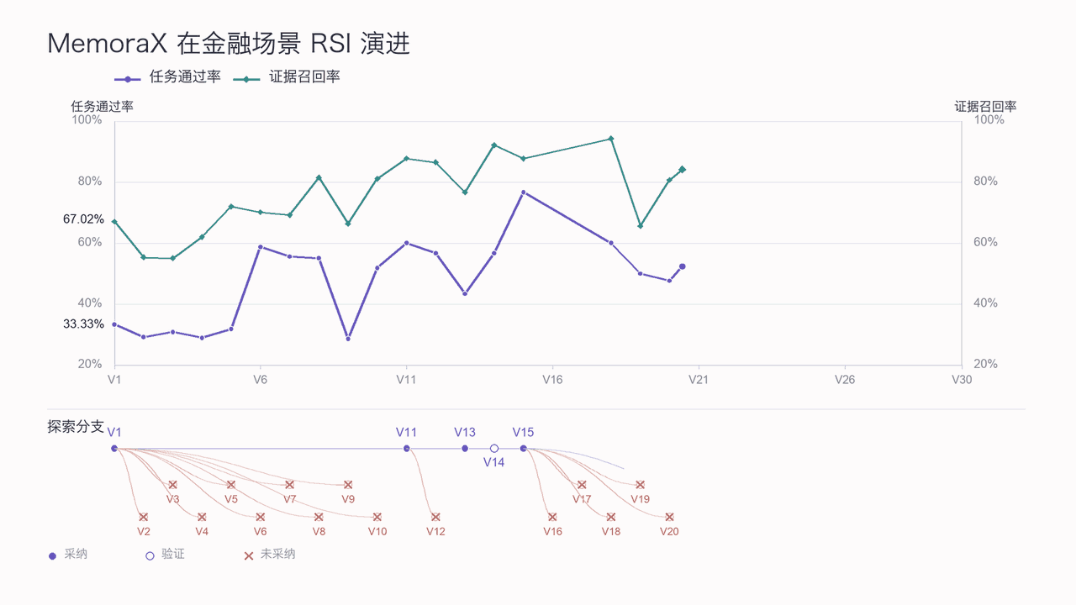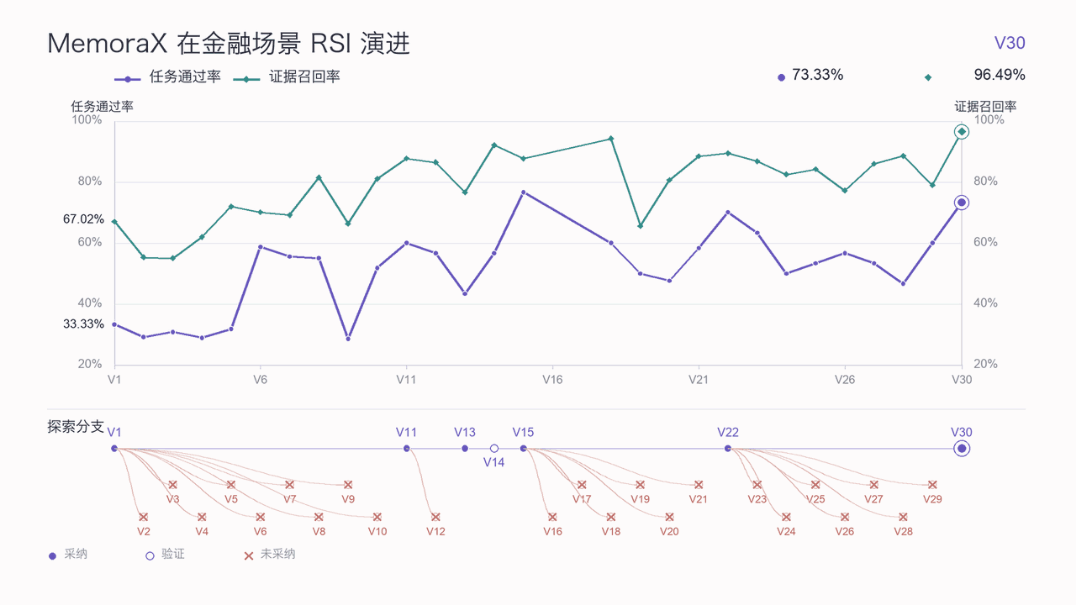
Bagi para peneliti yang perlu melacak laporan keuangan dan pengumuman secara berkelanjutan, ingatan yang dibangun dari serangkaian materi yang sama dapat digunakan untuk menangani berbagai pertanyaan, sehingga mengurangi biaya investasi awal; umpan balik dari analisis selanjutnya dapat digunakan untuk terus memperbaiki isi ingatan dan strategi penggunaannya.Membuat jawaban lebih lengkap, membuat penggunaan lebih ekonomis, dan memungkinkan pengalaman untuk terus terakumulasi,Bersama-sama, hal tersebut membentuk nilai praktis dari MemoraX dalam tugas-tugas keuangan yang kompleks.
(3) Penalaran Matematika yang Kompleks: Dari Umpan Balik Pengalaman ke Iterasi Strategi Penyelesaian
Dalam eksperimen penalaran matematika yang sangat sulit, MemoraX lebih lanjut mengeksplorasi penggunaan pengalaman historis dan umpan balik verifikasi untuk mendukung Agent dalam terus memperbaiki penalarannya dan mengoptimalkan strategi pemecahan masalah dalam situasi yang kompleks. Dalam soal kombinasi optimasi tingkat IMO (International Mathematical Olympiad), Agent berhasil melakukannya setelah... Pemecahan masalah berlangsung selama 4 jam, dengan lebih dari 600 kali pemanggilan model,Akhirnya ditemukan yang telah diverifikasi. Solusi optimal untuk 21 blok persegi panjang. Dibandingkan dengan skema OpenAI Codex, waktu pemecahan masalah berkurang sebesar 13%, dan biayanya berkurang sebesar 98%.
Dari Bukti Kegagalan ke Solusi Terbaik: Terus Meningkatkan Penalaran Melalui Umpan Balik
Matilda 16×16 adalah sebuah masalah optimisasi kombinasi yang sangat sulit menurut saya: diminta untuk menggunakan sebanyak mungkin persegi panjang untuk menutupi 240 kotak dalam grid 16×16, sambil memastikan bahwa setiap baris dan setiap kolom memiliki satu ruang kosong. Hanya posisi ruang kosong saja yang sudah cukup banyak untuk membuatnya menjadi masalah yang kompleks. 20,9 triliun kemungkinan kombinasiTantangannya tidak hanya terletak pada menemukan solusi yang layak, tetapi juga pada membuktikan bahwa tidak ada solusi lain yang menggunakan lebih sedikit persegi panjang.
Menghadapi tantangan ini, Agent terus bekerja sama dalam membangun algoritma pencarian, pembuktian formal, pemodelan yang akurat, dan audit independen. Awalnya, sistem menemukan 27 dan 23 kandidat konstruksi, namun argumen mengenai optimalitas global dari 23 kandidat tersebut ditolak oleh audit independen.
MemoraX mampu terus mengumpulkan solusi alternatif sebelumnya, proses penalaran, dan umpan balik verifikasi. Model memori tersebut mengekstrak pengalaman perbaikan yang efektif dari jalur keberhasilan, serta mengubah pengalaman kegagalan menjadi referensi untuk penyesuaian strategi pemecahan masalah di masa depan:
- Koreksi kesalahan berdasarkan ingatan: Dari kesimpulan yang salah hingga perbaikan ingatan. Audit independen menolak 23 bukti optimalitas yang salah, mendorong Agent untuk meninjau kembali kesimpulan yang telah dibuat, dan menggunakan umpan balik verifikasi bahwa “solusi yang layak tidak sama dengan solusi yang optimal” untuk memperbaiki memori, sehingga dapat menghindari kesalahan yang sama dalam penalaran selanjutnya.
- Optimisasi strategi: Dari pembaruan berdasarkan ingatan menjadi peningkatan metode. Berdasarkan skema dasar yang diperoleh dari memori dan kandidat solusi sebelumnya serta umpan balik verifikasi, Agent diarahkan untuk menyesuaikan metode pemodelannya, dengan mengintegrasikan keterbatasan posisi kosong dan batas persegi panjang ke dalam proses pencarian solusi. Akhirnya, ditemukan 22 dan 21 solusi yang lebih baik.
- Memori iterasi lagi: dari verifikasi hasil hingga pengoptimalan berkelanjutan. Agen melakukan penyelesaian yang akurat dengan memeriksa secara bertahap dan memanggil berbagai alat, sehingga dapat memastikan keoptimalan dari jawaban yang diperoleh. Setelah itu, hasil verifikasi yang baru dikembalikan ke model memori untuk menyempurnakan pembangunan memori penyelesaian, yang nantinya dapat dijadikan referensi untuk masalah serupa di masa depan.
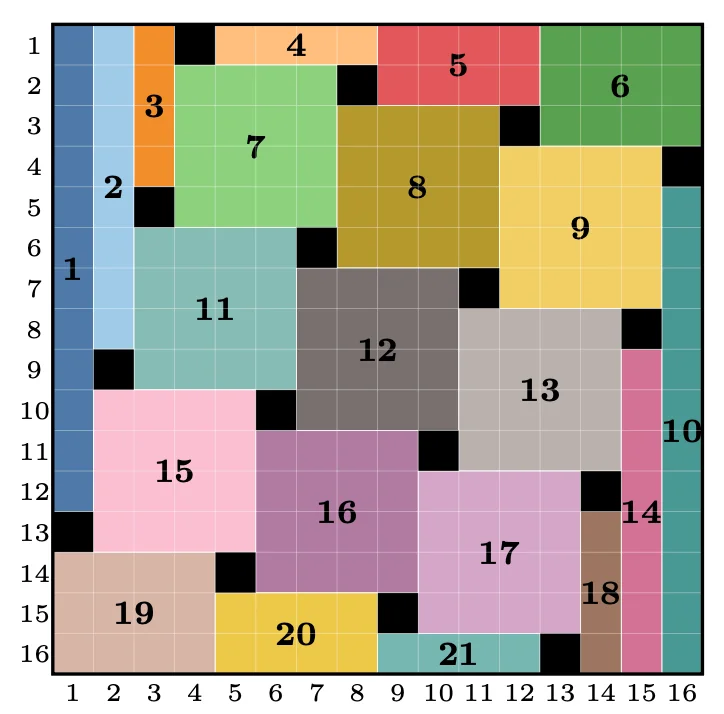
Pemetaan optimal dari 21 buah persegi panjang untuk masalah Matilda 16×16. Kotak hitam merupakan ruang kosong, sedangkan area dengan warna yang berbeda merupakan ubin persegi panjang.
Ini menunjukkan kemampuan Agent untuk terus beriterasi dalam tugas-tugas matematika yang kompleks:Pengalaman historis tidak lagi hanya merupakan catatan penalaran yang statis, tetapi dapat digabungkan dengan umpan balik verifikasi baru untuk terus berpartisipasi dalam penyesuaian strategi pemecahan masalah selanjutnya.
Memulai dari ingatan, menuju Agent yang terus berevolusi
MemoraX AI (MemoraX Artificial Intelligence) didirikan oleh Hao Jianye, mantan direktur Laboratorium Keputusan dan Penalaran di Huawei, direktur Laboratorium Algoritma Model Besar, serta ahli utama di bidang keputusan cerdas. Fokus utama MemoraX AI adalah pada pengembangan model memori Agent generasi berikutnya yang dapat belajar dan berevolusi.
Model memori yang dikembangkan secara independen oleh tim, berbasis pada teknologi Agentic RL, telah memenangkan juara di daftar memori terkemuka dunia dan mendapat liputan serta perhatian luas dari media domestik dan internasional seperti MIT Technology Review. Solusi memori tim ini telah diimplementasikan secara luas di perusahaan-perusahaan terkemuka di berbagai industri seperti pemrograman, medis, keuangan, keamanan, dan rumah pintar, dan merupakan mitra strategis dari Huawei Cloud / Tencent Cloud.
Saat ini, tim sedang lebih dalam mengeksplorasi RSI (Relative Strength Index) yang berbasis pada model memori, memungkinkan Agent untuk belajar secara berkelanjutan dan berevolusi dari pengalaman yang telah terakumulasi dan digunakan kembali, sehingga semakin memperkuat posisi terdepan mereka di bidang memori AI. Pada saat yang sama, mereka juga mempercepat penerapan dalam berbagai skenario, serta memajukan pengembangan dan komersialisasi modul memori yang terstandarisasi untuk produk industri B (Business) dan C (Consumer).
Kata Penutup
Kunci dari Agent RSI bukan hanya tentang membuat AI berperforma lebih baik dalam satu tugas saja, tetapi juga terletak pada...Jadikan setiap pelaksanaan sebagai dasar untuk peningkatan kemampuan berikutnya.Metode yang berhasil, pengalaman kegagalan, dan kondisi yang berlaku terakumulasi melalui ingatan jangka panjang, dan diubah menjadi panduan tindakan yang dapat digunakan kembali dalam tugas-tugas baru; hasil eksekusi yang baru kemudian mendorong pembaruan pengalaman, optimisasi strategi pengingatan, dan pembelajaran berkelanjutan dari model dasar pengingatan.
Yang sedang diteliti oleh MemoraX adalah...Jalur evolusi dua arah di mana memori dan peningkatan diri Agent saling mempromosikan satu sama lainDi satu sisi, memungkinkan memori untuk memberikan dasar pengalaman yang terus terakumulasi dan dapat dipindahkan antar-tugas bagi Agent RSI; di sisi lain, proses eksekusi dan umpan balik dalam tugas nyata terus mendorong pembelajaran dan evolusi memori itu sendiri.
Ketika setiap tugas dapat meninggalkan pengalaman, dan setiap umpan balik dapat mendorong perbaikan, kemampuan Agent tidak lagi terbatas pada pelaksanaan sekali saja, tetapi memiliki kesempatan untuk menjadi sebuah proses yang terus berkembang dan berevolusi secara mandiri.
Artikel ini berasal dari "Machine Heart", ditulis oleh "Machine Heart".
Tautan artikel:https://www.airai.cc/id/ai-news/54/
有用吗?