記憶から自己進化へ:AgentがRSIへと進む重要なステップ
最近、世界中のトップクラスのAI研究所から強いメッセージが次々と発信されています:AIは人間を助けてタスクを完了するだけでなく、自らの研究開発や改善にも参加するようになっています。
9月、OpenAIは「自動化されたAI研究インターン」の段階的な目標を達成したと発表し、2028年3月までに本格的な「自動化されたAI研究者」を創出する計画であると明らかにしました。OpenAIのチーフサイエンティストであるJakub Pachockiも同時に長文を発表し、再帰的自己改善(Recursive Self-Improvement、RSI)の発展の見通しについて論じました。9月21日には、自動化されたAI研究者の育成とAI研究開発能力の継続的な向上を、次の段階の重要な戦略的方向性としてさらに強調しました。
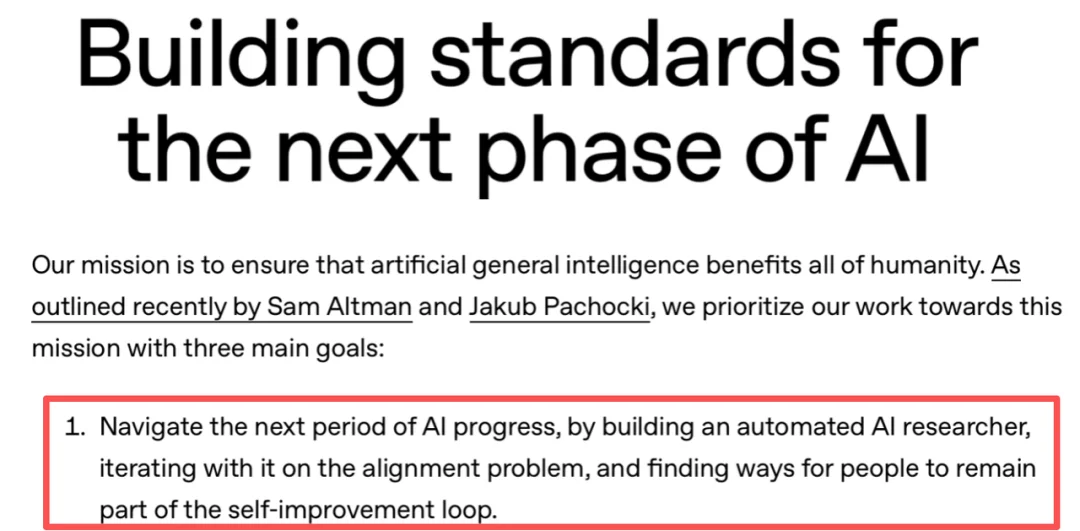
OpenAIは2026年9月21日に公式の戦略声明を発表し、自動化されたAI研究者と自己改善を繰り返す機能を次の段階の重要な目標として掲げました。
一方で、Anthropicも注目すべきデータを公開しました。今年の8月までに、Claudeは約 26%の内部AI研究開発作業において主導的な役割を果たしています。、研究者が行っていた研究開発のタスクが、ますます多くAIによって人間の監督の下で実行されるようになっています。
オープンAIからアンソロピックへと、RSIは遠い技術的構想から、世界のトップクラスの研究所の中心的な研究開発の議題へと進化しています。 AIはもはや外部の問題を解決するためのツールにとどまらず、自らの能力を向上させるための取り組みにも積極的に関与し始めています。
しかし、この継続的に進化する道のりにおいて、最も重要な鍵は以下の通りです:
AIは、過去の探求や試行錯誤をどのようにして次の進歩の基盤として活用できるのでしょうか?それとも、新しいタスクに直面するたびに毎回一から始めなければならないのでしょうか?
記憶は、エージェントが継続的に自己改善を遂げるための重要な基盤です。 それにより、各探求が残すのはタスクの結果だけでなく、後続のタスクで継承し再利用できる経験も含まれるため、エージェントの能力は単一のタスクを超えて向上する機会を持ち、継続的な蓄積の中で絶えず進化していきます。
01 |経験の蓄積から持続的な進化へ:
記憶がRSIをどのように支えているか
エージェントが継続的に能力を向上させるためには、経験が単一のタスクを超えて伝わることが鍵です:過去の探求から有効な方法を抽出し、新しいタスクで正確に適用し、実行結果に基づいて継続的に修正し最適化する。 その中で、記憶の書き込みと検索は、互いに関連する二つの重要なプロセスを担っています。
記憶の書き込みには、複雑な実行経路の中から有効な方法や失敗の結果、およびそれらが適用される条件を特定する必要があります。これにより、過去のタスクから実際に再利用可能な知識を得ることができます。一方、記憶の検索では、新しいタスクの要求に基づいて、適切な歴史的な方法や重要な証拠を正確に見つけ出し、知識の見落としや誤った適用を避ける必要があります。
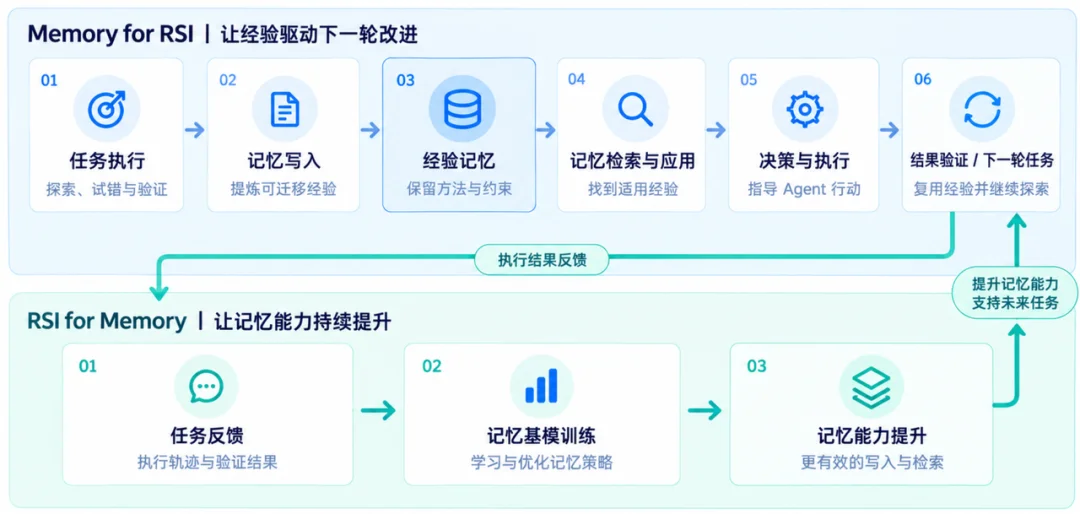
さらに、タスクのフィードバックは経験の実際の価値を逆に検証することもできます。記憶内容を継続的に更新し、有効なフィードバックを記憶の基礎モデルのトレーニングに利用することで、記憶自体の能力を向上させ、経験の蓄積とエージェントの改善が相互に促進し合うプロセスを形成します。
02 |記憶の学習と進化:
エージェントを経験を通じて継続的に強化していきましょう。
Agent RSIにおける経験の蓄積、タスク間での再利用、および継続的な改善のニーズを踏まえて、MemoraXは以下のように構築されました:経験に基づく学習、経験の移転、フィードバックによる最適化核心となる記憶能力システムにより、高品質な記憶データの構築、動的な記憶の組織化、そして実際のタスクフィードバックに基づく最適化を通じて、記憶の基本モデルを継続的に訓練します。これにより、エージェントは過去の経験から学び、意思決定や実行を絶えず改善していきます。
タスクから学ぶ:経験の蓄積を最適化可能なモデル能力に変える
エージェントがタスクを実行する過程での結果の検証や戦略の調整により、新たな経験が絶えず生み出されます。成功した意思決定は、後続のタスクに再利用可能な方法を提供し、検証された失敗の結論はエージェントが無効な案を排除し、繰り返しの試行錯誤を減らすのに役立ちます。しかし、経験の価値はしばしば後のタスクで初めて明らかになります。過去を正確に要約することができるからといって、将来を効果的にサポートできるとは限りません。したがって、記憶学習のプロセスでは、保持する価値のある経験を特定するだけでなく、その検証根拠、環境制約、適用条件も保存する必要があります。経験が見落とされたり誤用されたりするのを防ぐためです。これは、単なる情報の要約や圧縮では解決できない問題です。
この課題に対して、MemoraXは 記憶を、将来のタスクの利益に向けてモデル化された学習可能な戦略に書き込み、環境構築、データ収集、サンプル構築、そして大規模なエージェントベースのRL(強化学習)トレーニングをカバーする完全なシステムを継続的に構築していく。インタラクティブで検証可能なタスク環境の中で、実行軌跡、記憶使用記録、および検証フィードバックを収集し、それらを関連付けて意思決定やその後の使用効果に関するトレーニングサンプルを構築します。さらに、後続タスクの完了品質、実行効率、および繰り返し試行錯誤の状況を考慮して報酬シグナルを設計し、記憶の書き込み戦略を最適化します。このプロセスにより、モデルの最適化目標は情報抽出の正確性から、さらに進化します。記憶が後続のタスクの品質、実行効率、そして繰り返し試行錯誤に与える実際の影響、将来のタスクに役立つ記憶の書き込み戦略を学ぶことがより有益です。
経験からの移行:過去の経験を新しいタスクの指針として活用する
経験が保存されるからといって、それが新しいタスクで役立つとは限りません。異なるタスクの目標、環境の制約、実行段階に直面したとき、エージェントは適用可能な過去の方法を正確に識別し、不要な情報の干渉や経験の誤った移行を避ける必要があります。
そのために、MemoraXは記憶内容とアクセス構造の分離現在のタスクに応じてメモリアクセスのポイントと関連関係を動的に調整し、同じ歴史的情報が異なる使用ニーズに適応できるようにします。
検索の面では、さらにモデルのトレーニングを通じて、現在のタスクの要求と過去の重要な証拠との間のマッチング関係を学習する細かい証拠の識別と類似した記憶の曖昧さの解消を組み合わせることで、重要な経験の特定能力を向上させ、「テーマに関連している」か「証拠が正しい」かを区別する。
経験的な使用段階において、MemoraXは現在のタスク状態と実行進捗を組み合わせています。歴史的に蓄積された一般的な経験を、明確な目標、操作上の制約、および検証基準を持つ行動指針に変換するタスクの段階に応じて動的に調整し、歴史的な経験をエージェントの意思決定と実行に実際に活かすことができるようにします。
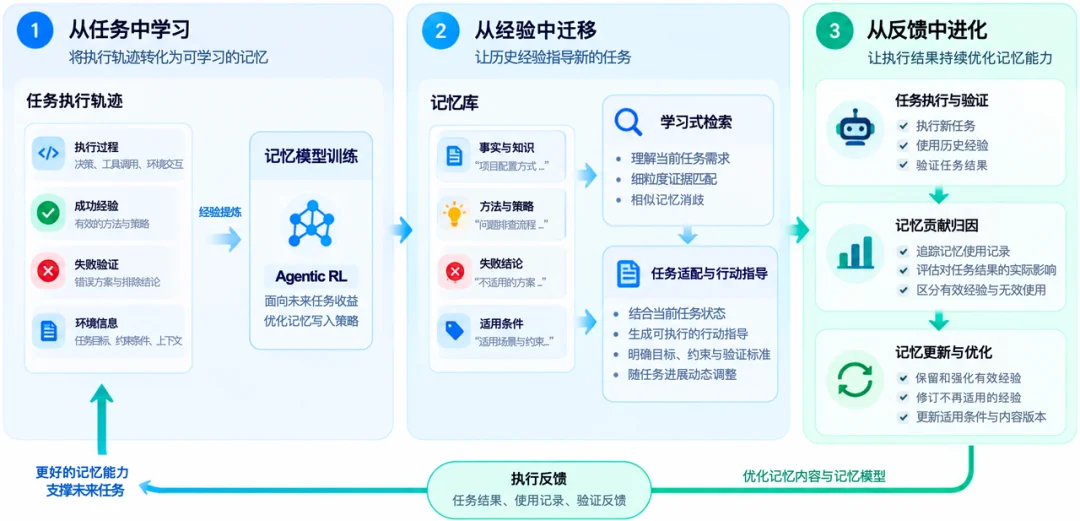
フィードバックから進化する:実行結果を通じて記憶能力を継続的に最適化する
RSI(Relative Strength Index)の継続的な改良の中で、過去の経験が常に有効であるとは限りません。新しいタスクによっては、既存の方法が検証されることもあれば、その限界が明らかになることもあります。実行フィードバックを利用して経験の真の価値を判断し、それに基づいて記憶を継続的に最適化することは、自己改善を続ける上で重要な要素です。
その中核的な課題は メモリクレジットの割り当て(Memory Credit Assignment)長期にわたるタスクでは、複数の過去の経験が呼び出されることがありますが、どの経験がエージェントの意思決定に実際に影響を与えたのか、またどの経験が単に読み取られただけで実際には機能しなかったのかを判断することは難しいです。最終的にタスクが成功したとしても、異なる記憶がどのように貢献したのかを評価する方法は依然として解決すべき問題です。
この課題を中心に、MemoraXは記憶バージョン、実際の使用記録、およびタスク実行のフィードバックを関連付ける、過去の経験がエージェントの行動に実際に影響を与えたかどうかを追跡し、使用後のタスクのパフォーマンスと検証結果を評価します。この基礎の上で、既存の記憶を継続的に評価し、改善していきます。有効な経験を保持し強化するとともに、新しいタスクのフィードバックに基づいて、もはや適用されない経験をタイムリーに修正する必要があります。
これらのリアルなフィードバックもまた、記憶基盤モデルの継続的なトレーニングデータの基盤と最適化されたシグナルが提供されることで、記憶の改善はコンテンツレベルの更新からさらに進み、記憶モデルが経験の価値や記憶戦略を学ぶまでに至ります。
03 |経験の積み重ねから能力の向上へ:
MemoraXの多シナリオRSI実践
Agent RSIにとって、重要なのは単にあるタスクでどれだけ良い結果を出したかということだけではありません。歴史的な経験は継続的に蓄積され、修正されることができるのでしょうか。そして、それらの経験が後続のタスクで継続的に価値を生み出すことができるのでしょうか。
このプロセスを通じて、長期的で複雑なコーディング、金融分析、複雑な数学的推論の3つのタスクにおいて、経験の継続的な反復、タスク間の知識の移転、フィードバックによる最適化の能力がそれぞれ検証されました。さらに、記憶がエージェントの長期的なタスクにおける品質と効率の向上をどのように促進するかもさらに検証されました。
(1)長距離複雑なコーディング:経験の積み重ねから複雑なエンジニアリング能力の向上へ
長距離複雑なコーディング実験は、通信、金融、物流などの分野で行われています。 5つの大きな業界において、13の産業レベルのシステム開発タスクが行われ、合計で78回の開発実行がありました。開発にかかった総時間は300時間を超え、1回あたりの最長時間は12時間を超えました。その結果、MemoraXのメモリ強化ソリューションの採用率は20%以上向上し、主なコーディングエージェントの累計トークン消費量も20%以上削減されました。
経験の蓄積から再帰的な改善へ:記憶の自己反復の道
伝統的な静的メモリでは、タスクの実行中に経験を継続的に蓄積し最適化することが困難であるという問題に対して、MemoraXチームはメモリモデル駆動型RSI(Memory Model-Driven RSI)アプローチ自社開発の記憶モデルをエージェントシステムと連携させることで、専用の記憶モデルがエージェントの実行軌跡やオンラインフィードバックからプログラム的な記憶を抽出・更新し、エージェントシステムがその記憶を実際のタスクに適用します。これにより、経験の抽出、タスクの適用、効果の検証、記憶の更新という閉じたループのイテレーションメカニズムが形成され、有効な経験が継続的に蓄積・最適化され、後続のタスクに役立てられます。長期的なコーディングタスクで構成されるトレーニングケースにおいても、このメカニズムが機能します。複数回の記憶の反復最適化を経て、プログラム的記憶の質が10%以上向上しました。
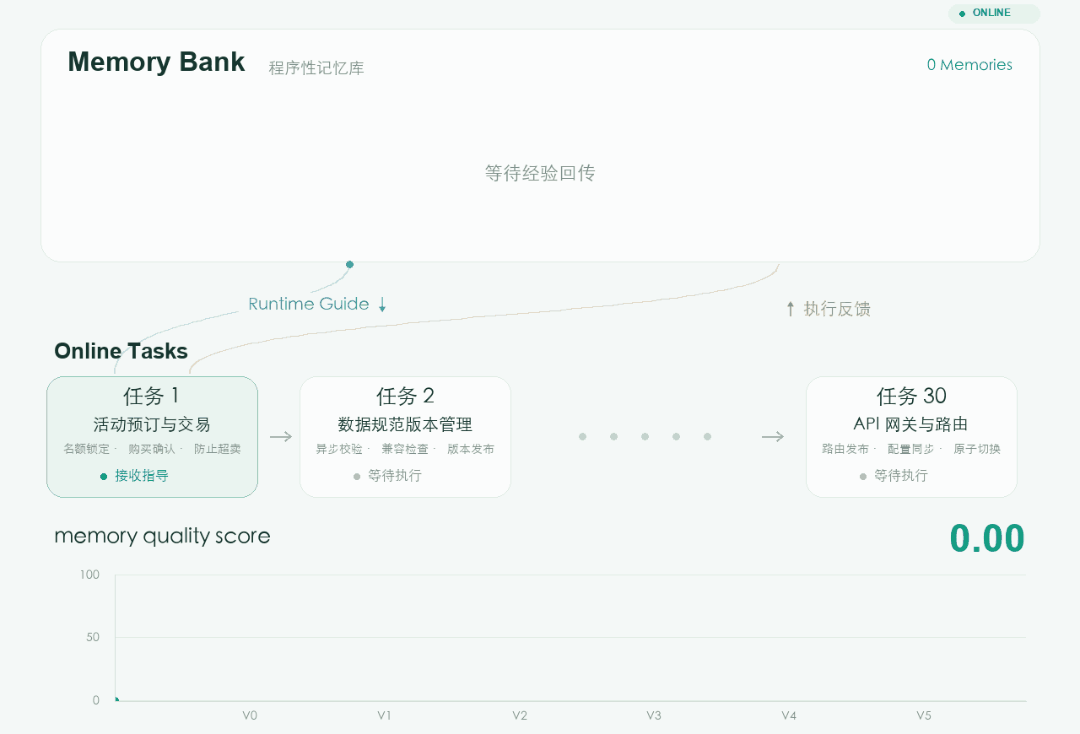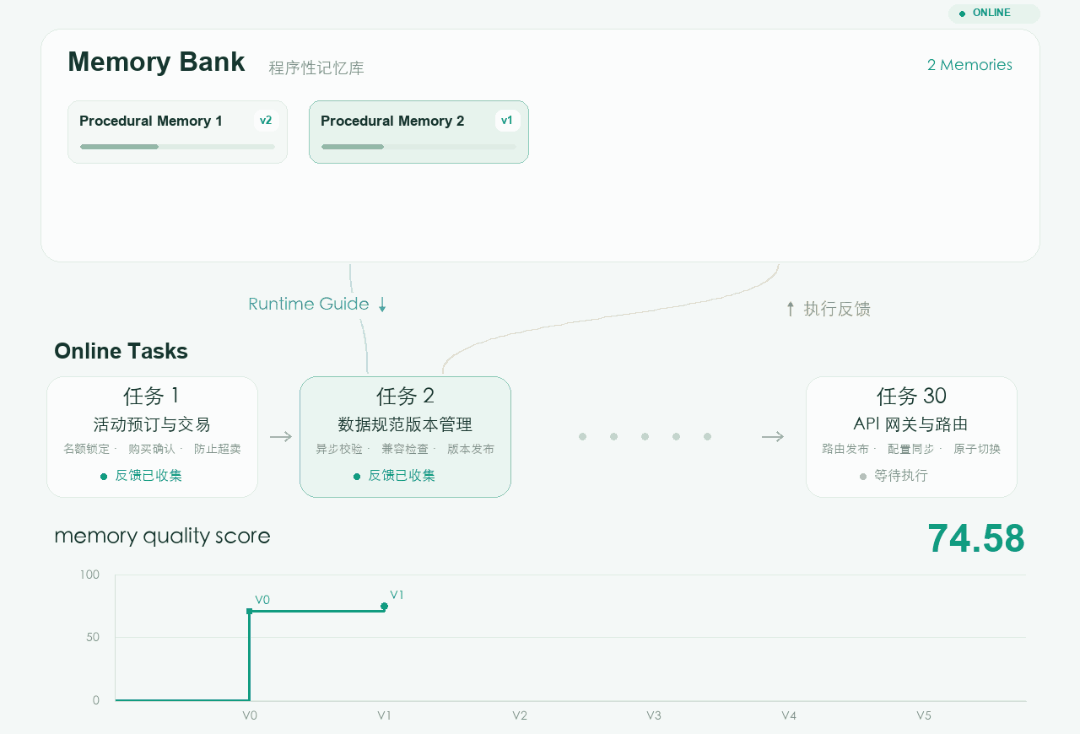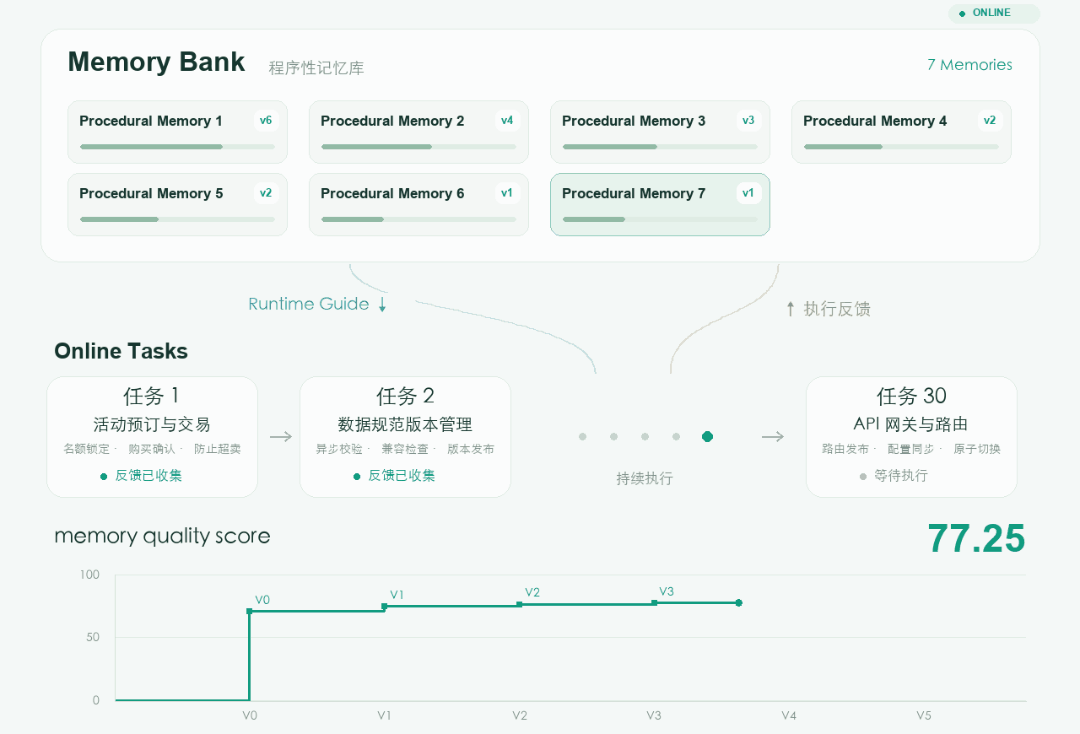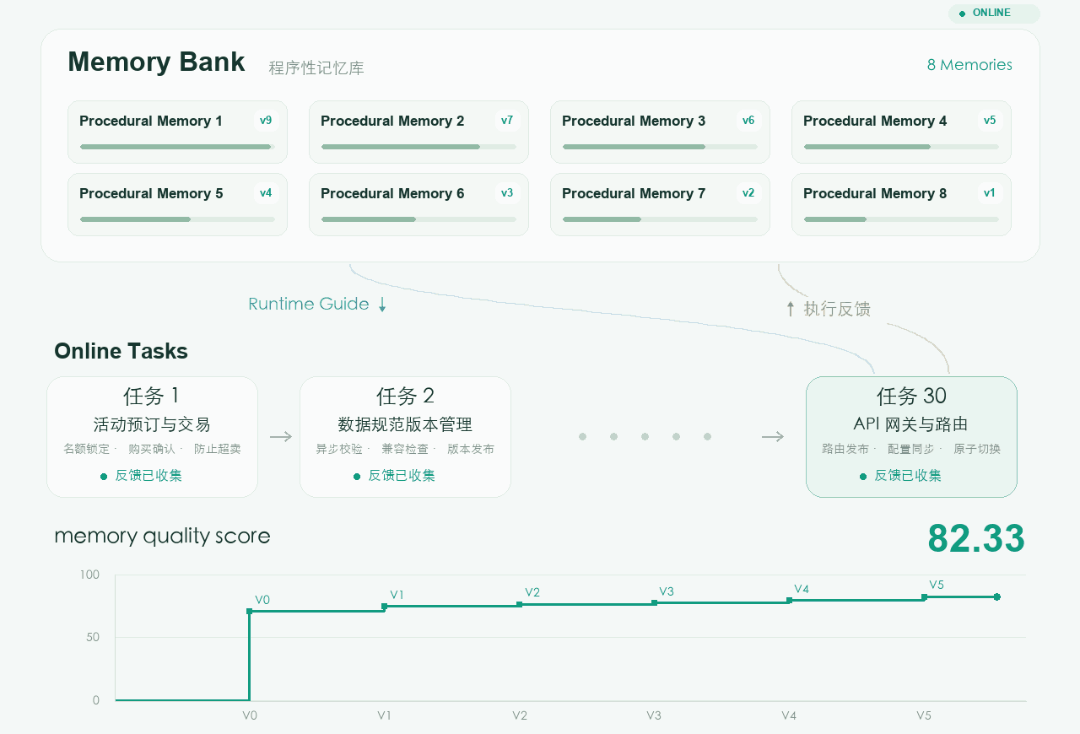
繰り返しの反復を経て得た経験を活かし、335時間に及ぶ複雑なエンジニアリング開発に挑戦します。
蓄積された経験が元の学習タスクから離れた場合、新しいエンジニアリングの課題に直面したときに、どれだけの役割を果たすことができるでしょうか?
そのために、これまでに蓄積された経験を全く新しい複雑なエンジニアリングプロジェクトの開発に活用します。13件の複雑なソフトウェアエンジニアリングタスクにおいて、合計78回の開発実行が行われ、開発にかかった総時間は335時間を超えています。そのうち1回の実行では12時間を超える長時間がかかりました。これらのタスクは単なるコードの修正を超えており、複雑なビジネスロジック、モジュール間の依存関係、そして多数のテストを伴う本格的なエンジニアリングの課題です。
最終的に、パス率が20%以上向上し、同時にCoding Agentの累計トークン消費量も20%以上削減されました。
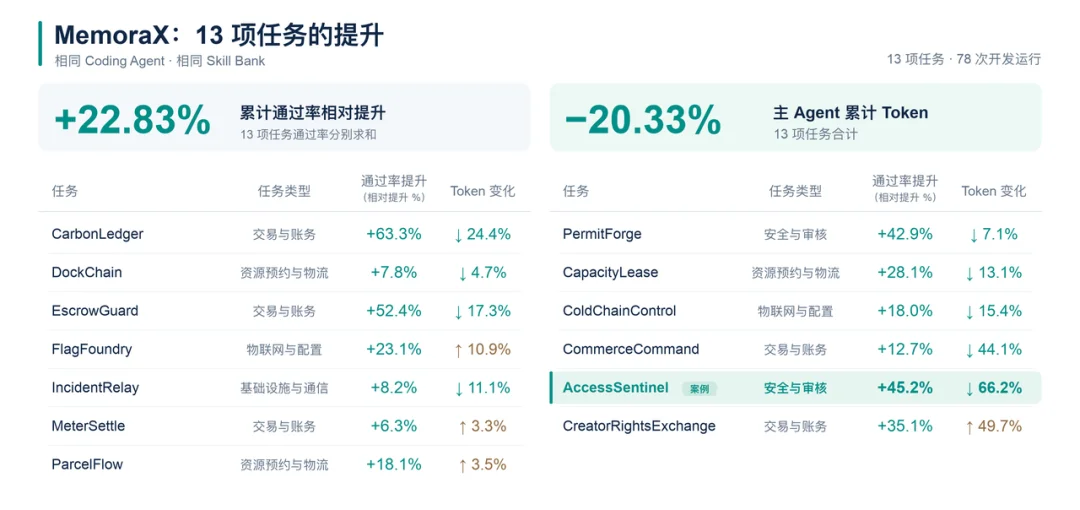
その中で、AccessSentinelは代表的な難易度の高いケースです。エージェントは、完全な企業向けの権限管理システムを構築し、それを確実に実行する必要があります。厳格なセキュリティ制約。
記憶モデルの助けを借りて、歴史的な経験はもはや静的な情報参照にとどまらず、タスクの状態が変化するにつれて、エージェントの実行や検証に継続的に関与することができるようになりました。開発開始から43分後から2時間30分後までの間に、記憶はいくつかの重要なタイミングで変化しました。積極的に提供するターゲット指向のガイダンス:
- デバイスの権限が取り消されたとき,デバイスの再ログインを禁止するだけでなく、以前にログインしていたアカウントもシステムにアクセスできないようにする必要があります。
- 安全ポリシーを旧バージョンに復元する際に、歴史記録を保持すると同時に、既に取り消された権限が誤って復元されるのを防ぐ必要があります。
- 大量の申請を一度に処理する際に,まず、すべての申請が要件を満たしているかを確認します。一部が成功し、一部が失敗することがないように、すべてが通過した場合にのみ一括で実行します。
テスト中、3回の実行における平均合格率は45%以上向上し、主要なコーディングエージェントの累計トークン消費量は66%以上削減されました。
(2)複雑な金融分析:証拠の蓄積から自主的かつ継続的な改善へ
金融研究では、大量で分散している資料から完全で信頼性の高い分析結論を導き出す必要があります。関連データを見つけるだけでなく、エージェントは複雑な文脈の中で、対象となる主体、時間、統計の基準を正確に理解し、異なる証拠間の関連性を築く必要があります。これにより、情報の欠落や基準の混乱が最終的な結論に影響を与えるのを防ぐことができます。
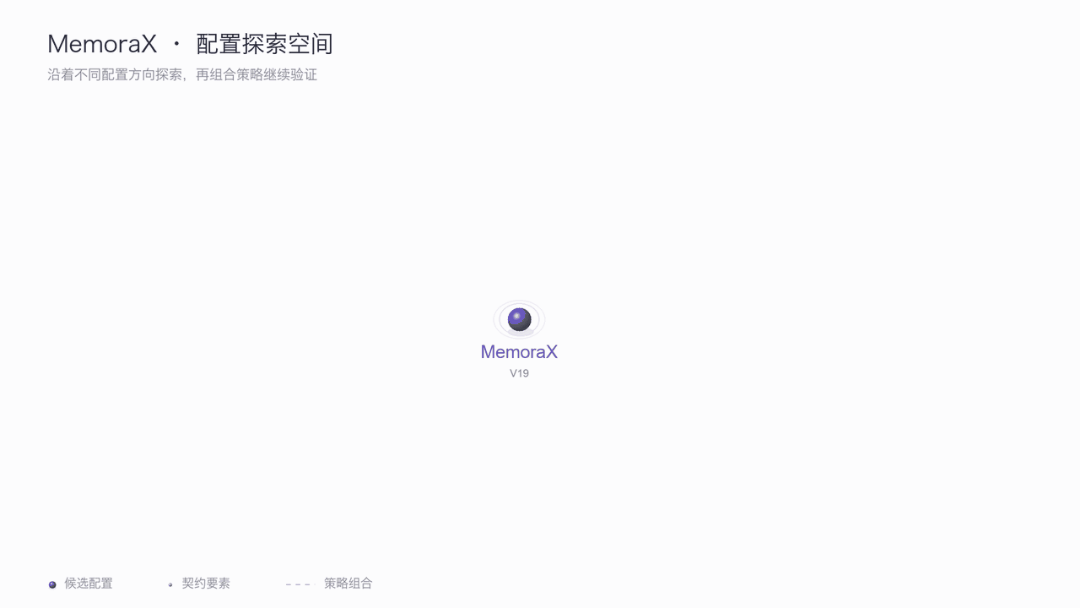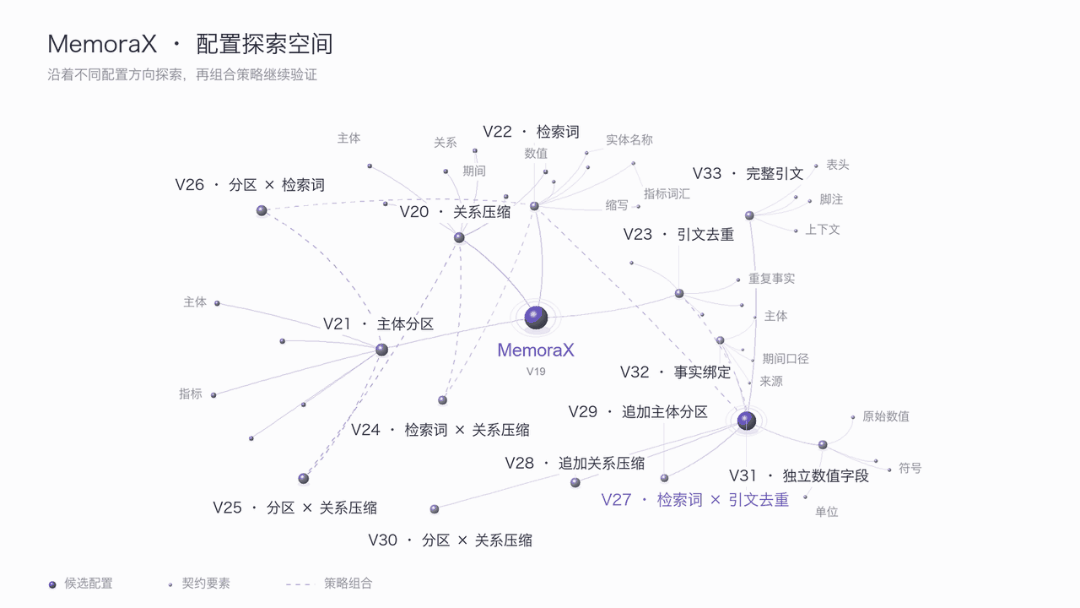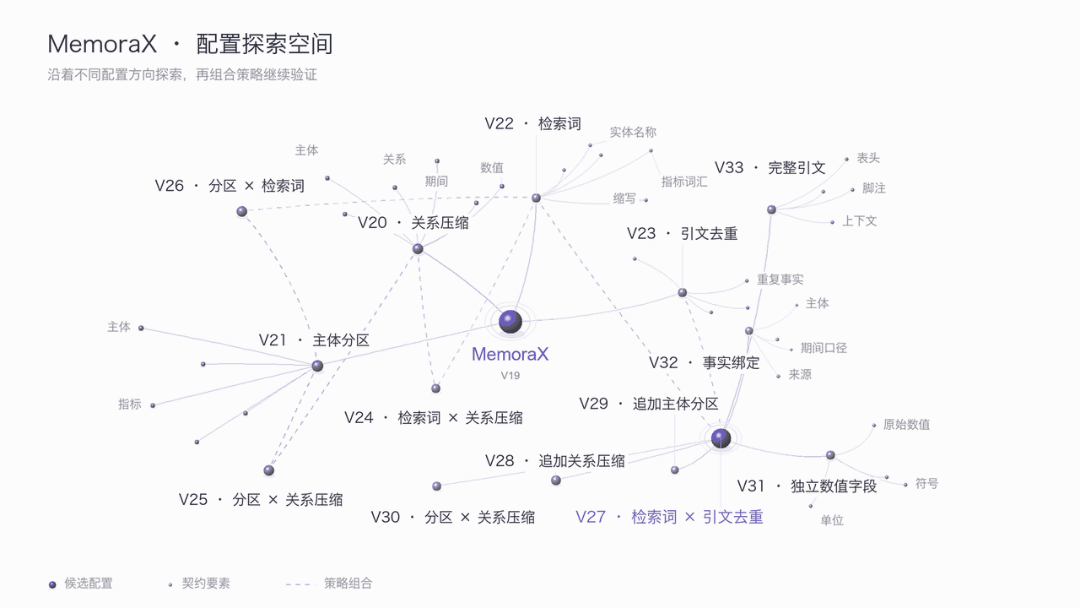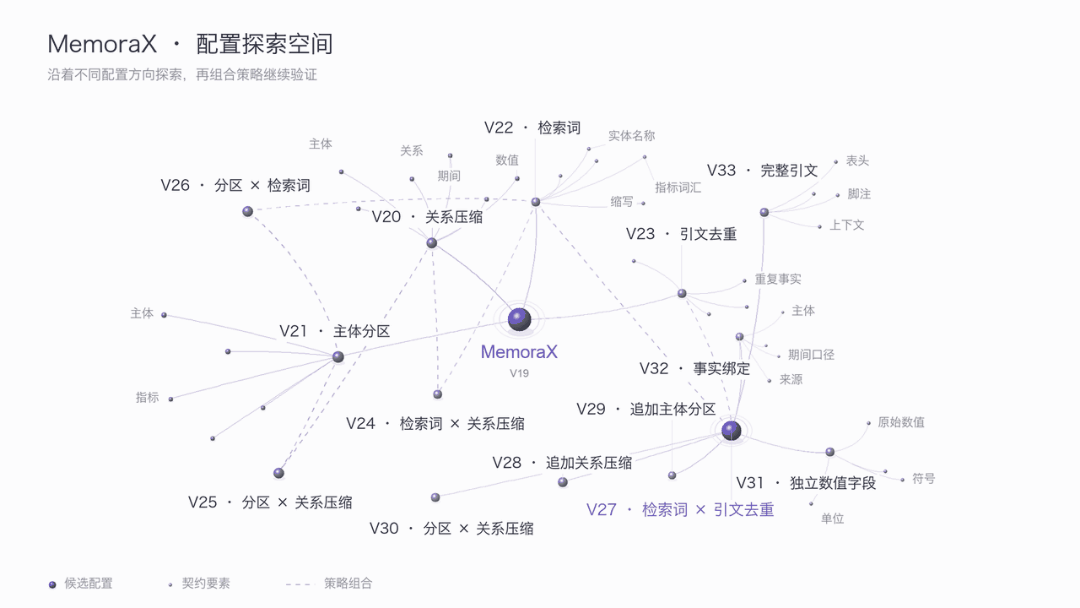
MemoraXは、2つの相互に関連する問題に注目しています:どのようにして証拠を使って完全な回答を支えるか、そしてその回答の中にある質問を利用して、証拠の保存と検索の方法を改善するか。そのため、MemoraXは金融分野の権威あるベンチマークであるFinRankを基に実験を行っています。このベンチマークは、製薬、石油・ガス、自動車などの業界に属する22のアメリカ上場企業の実際の財務報告を対象としており、多くの企業間、期間を超えた複雑な金融データを含んでいます。これらのタスクを中心に、MemoraXはタスクのフィードバックを利用して記憶の構造化と検索を継続的に最適化し、「実行 — フィードバック — 記憶の改善 — 再実行」というRSI(Reinforcement Learning with Iteration)の反復ループを形成しています。 30回以上にわたる記憶モデルと金融分析システムの協同イテレーション、最終的に証拠チェーンの呼び出し率は約100%に達し、CodeXタスクと比較して正確性が20%向上し、コストは約98%削減されました。
データを見つけることから、判断をサポートする証拠を組織できるまで
ある大手製造企業の財務分析タスクを例にとると、タスクに関連する証拠は、連続3年分の財務諸表、サプライヤーの開示資料、およびリスク説明を含む多数の類似する業界資料の中に散在しています。キーワードや意味の類似性だけに基づいて検索すると、ターゲット企業や報告期間には該当しないがテーマに関連する内容を見つけることが容易です。しかし、要約のみを保持すると、数値の単位やリスクが成立する条件を見落としてしまう可能性があります。
これに対して、MemoraXはまずコンテキスト素材を構造化された記憶に変換し、回答のフィードバックに基づいて記憶の組織方法を繰り返し調整します。金融に関するQ&Aのシナリオに特化して、徐々に以下のような特徴を備えた記憶システムを形成していきます:数値は正確で、口径が揃っており、出典も追跡可能です。記憶モデルの出力表現を活用し、検索時には現在の問題に関連するこれらの証拠を呼び出して、在庫状況、購買構造、および潜在的なリスクを一緒に分析します。このような組織方法は、金融タスクのニーズを考慮に入れています。数値が正確で、基準が統一され、出典が追跡可能です。要求。
MemoraXの最終タスク完了精度がCodexの対照値よりも向上しました。約20%。さらに、実際のAPI使用量に基づいた統計によると、この方案のコストはコデックスの対照案と比較して約98%削減され、より高い合格率を達成すると同時に、コール料金も大幅に削減されました。
回答フィードバックから戦略の反復まで:記憶力を向上させるために「どのように保存するか、どのように取り戻すか」
MemoraXは、タスクからのフィードバックに基づき、証拠の欠落、関係の混乱、引用の冗長さなどの問題に対処するために、記憶された情報の選択と組織化の方法を絶えず探求しており、トレーニングタスクを通じて継続的に知識を蓄積しています。関連する書き込み決定、記憶内容、およびその後の使用効果の相互作用のサンプル、記憶モデルを最適化するために使用されます。トレーニングされたモデルは新しいタスクに参加し、その実行フィードバックが書き込み戦略の改善や後続のトレーニングに引き続き使用されます。これにより、タスクの相互作用とモデルの最適化が相互に促進するRSIサイクルが形成されます。このプロセスの中で、モデルは徐々に進化していきます。金融シナリオに適応した記憶表現の特性重要な数値を適用条件と関連付けて保存し、異なる主体、報告期間、および情報源を区別するとともに、事実と原文の証拠との対応関係を確立する。 36回のRSIイテレーション,MemoraX 証拠の呼び出し率は96.49%に達し、タスクの正確率は33.33%から73.33%に向上しました。
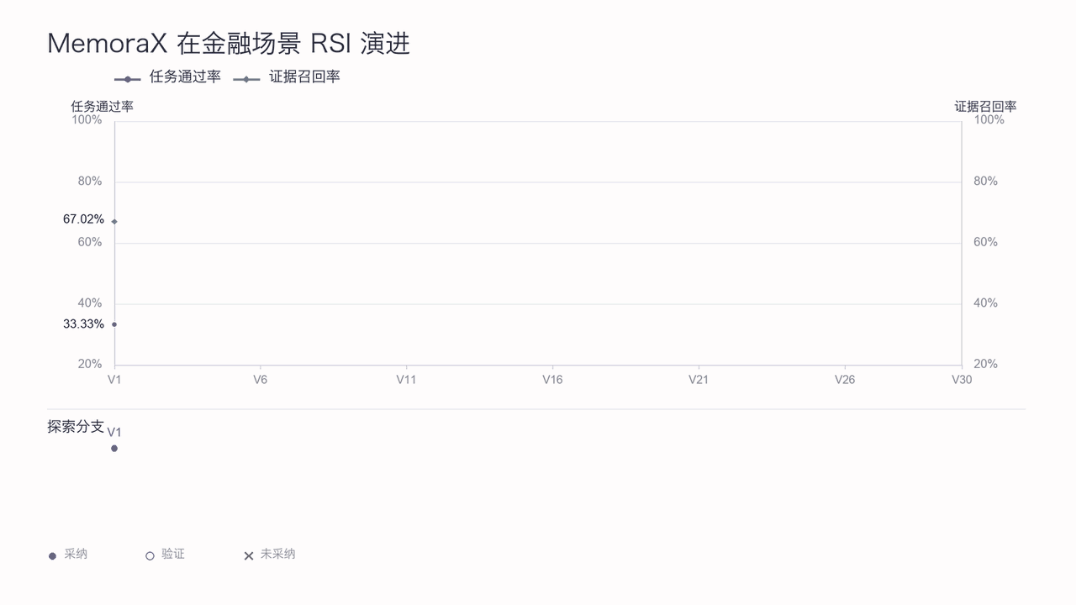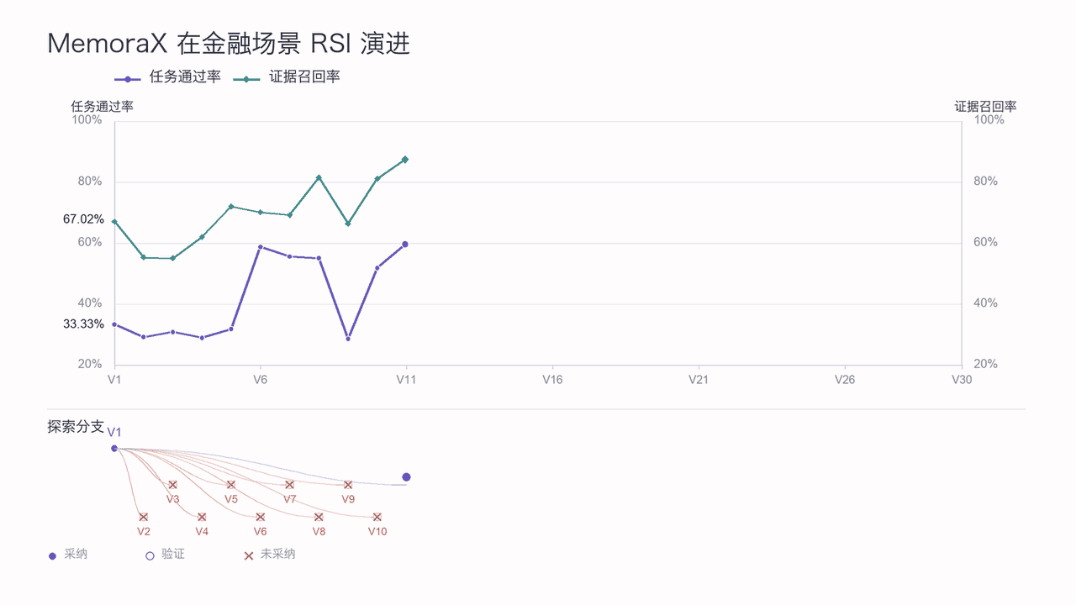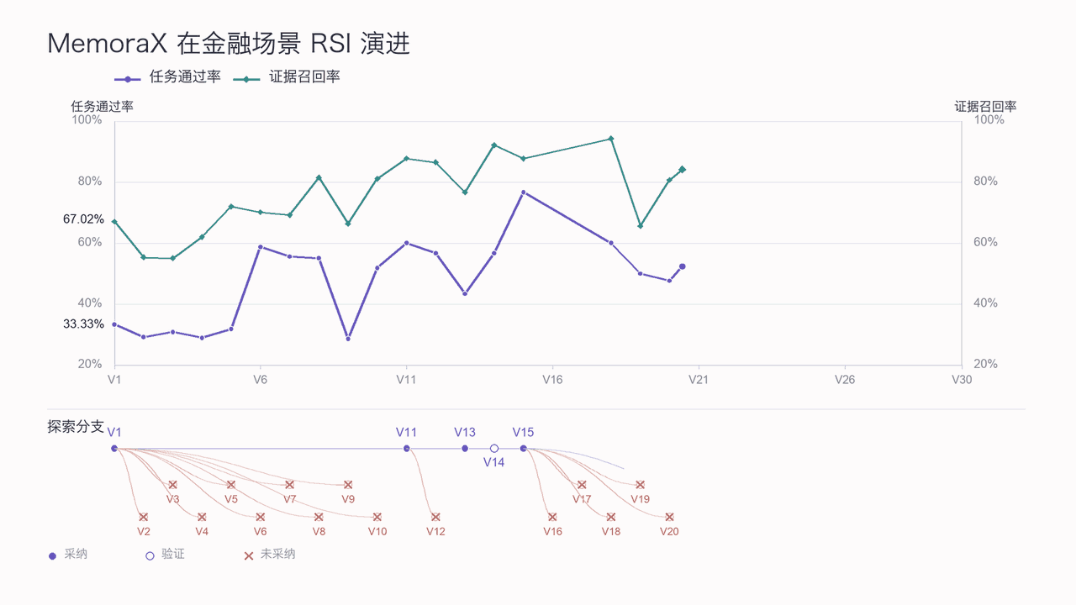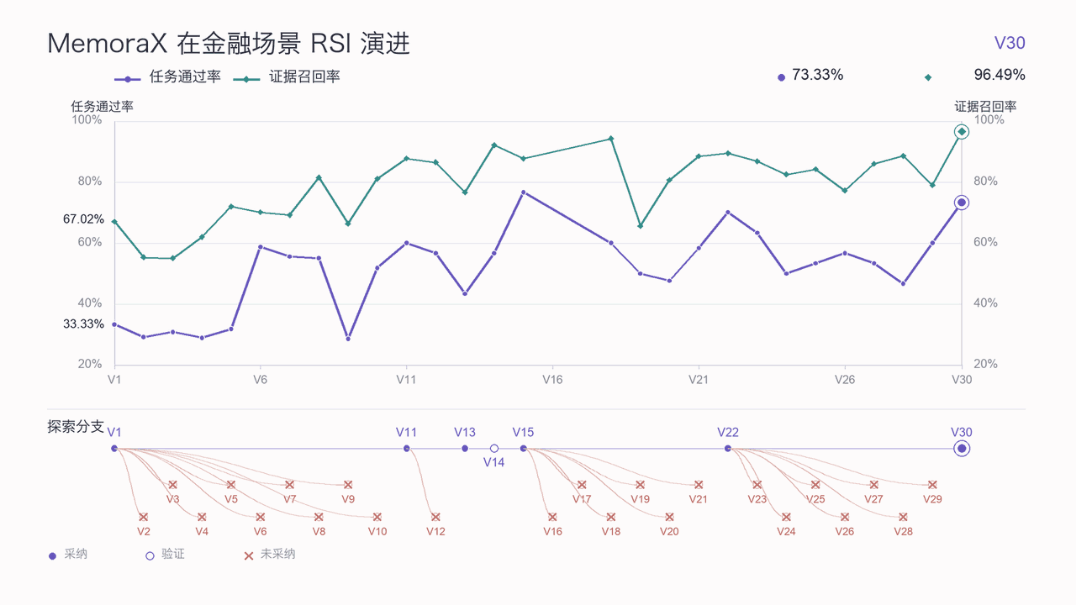
長期にわたって財務報告書や公告を追跡する必要がある研究者にとって、一度作成した資料に基づく記憶は、異なる問題に対応するのに役立ちます。これにより、初期の投資が分散されます。また、後続の分析で得られたフィードバックをもとに、記憶の内容や使用戦略をさらに修正することができます。答えをより完全なものにし、使用をより経済的にし、経験を継続的に蓄積できるようにする、これらが組み合わさることで、MemoraXが複雑な金融タスクにおいて実践的な価値を発揮するのです。
(3)複雑な数学的推論:経験からのフィードバックをもとに解決策を自己反復的に改善する
高難度の数学推論実験において、MemoraX は歴史的な経験と検証フィードバックを活用することで、エージェントが複雑な問題において推論を継続的に修正し、解決戦略を最適化する能力をさらに探求しました。IMO(国際数学オリンピアード)レベルの組み合わせ最適化問題において、エージェントは約 4時間にわたる継続的な計算処理、600回以上のモデル呼び出しが行われました。最終的に検証されたものが見つかりました。 21個の矩形に対する最適解が得られました。OpenAI Codexのソリューションと比較して、解決時間が13%短縮され、コストは98%削減されました。
失敗から最適解へ:フィードバックを通じて推論を継続的に改善する
Matilda 16×16は、IMOレベルの非常に難しい組み合わせ最適化問題です。16×16のグリッド内の240個のマスをできるだけ少ない数の長方形で覆い、かつ各行と各列にちょうど1つの空きスペースが残るようにする必要があります。空きスペースの位置だけでも数が多いです。 20.9兆億(20.9 trillion)の並び替えの可能性があります。。難しいのは、実行可能な解を見つけるだけでなく、より少ない矩形を使用する方案が存在しないことを証明することです。
この課題に直面して、エージェントは検索の構築、形式証明、精密なモデリング、および独立した監査について継続的に協力しています。システムは当初、27個と23個の候補構造を見つけましたが、23個についての全体的な最適性に関する論証は独立した監査によって却下されました。
MemoraXは、以前の候補案、推論プロセス、および検証フィードバックを継続的に蓄積することができます。記憶ベースのモデルは、成功した事例から有効な改善策を抽出し、失敗した事例を後続の調整や問題解決戦略の参考に変換します:
- 記憶の自己訂正:誤った結論から記憶の修正へ。 独立監査により23件の誤った最適性証明が否定され、エージェントは既存の結論を見直すことになりました。また、「実行可能な解が最適解とは等しくない」という検証結果をフィードバックとして利用し、記憶を修正することで、後続の推論で同じ誤りが繰り返されるのを防ぎます。
- 戦略の自己最適化:記憶の更新から方法の改善へ。 記憶ベースのモデルから抽出された以前の候補案と検証フィードバックに基づき、エージェントがモデリング手法を調整し、空洞部分と矩形の境界制約を統合して解決策の探索に取り入れました。その結果、22個と21個のより優れた案をそれぞれ見つけ出しました。
- 記憶の再反復:結果の検証から継続的な最適化へ。 エージェントは、段階的なチェックとツールの呼び出しを通じて正確な解を導き出し、最終的にその答えの最適性を確認します。そして、新しい検証結果をメモリベースのモデルにフィードバックして、解決策の記憶構築を完善します。これにより、後続の類似問題に対する参考情報が提供されます。
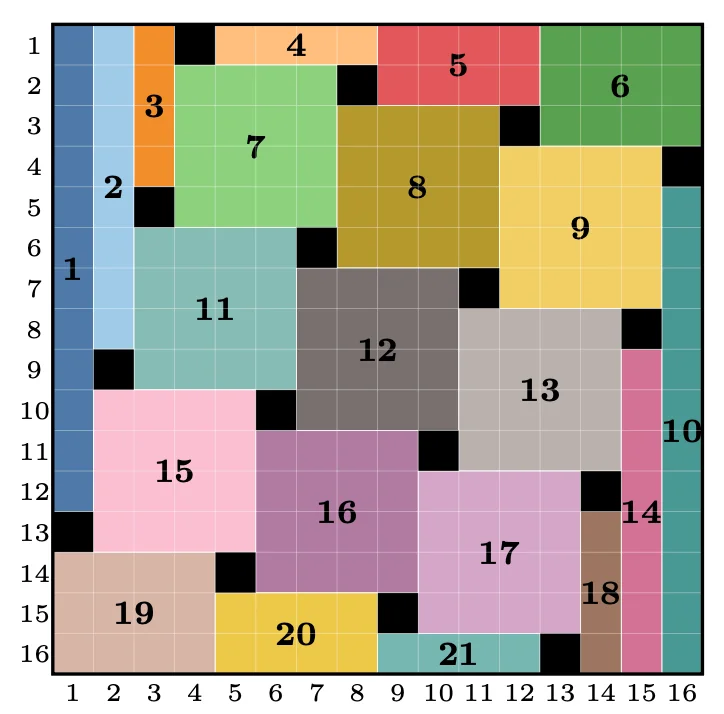
マチルダ16×16問題の21ブロックの矩形の最適な配置方法。黒いマスは空洞で、異なる色の領域は矩形のタイルです。
これは、エージェントが複雑な数学的タスクにおいて継続的に反復学習する能力を示しています:歴史的な経験はもはや静的な推論記録にとどまらず、新しい検証フィードバックを組み合わせて、後続の解決策の調整に継続的に参加することができるものになりました。
記憶から出発し、継続的に進化するエージェントへ
MemoraX AI(忆纪元)は、元華為の意思決定および推論ラボのディレクターであり、大規模モデルアルゴリズムラボのディレクター、そしてインテリジェントな意思決定分野のチーフエキスパートである郝建业によって設立されました。このAIは、次世代の学習可能で進化可能なエージェント記憶モデルに焦点を当てています。
チームが独自に開発した、Agenetic RL(エージェンティックRL)技術に基づく記憶モデルが、世界的に権威のある記憶関連のランキングで優勝し、MIT Technology Reviewをはじめとする国内外のメディアから広く報じられ、注目を集めています。この記憶ソリューションは、プログラミング、医療、金融、セキュリティ、スマートホームなどの業界のトップ企業で広く導入されており、Huawei CloudやTencent Cloudの戦略的パートナーとなっています。
現在、チームは記憶ベースのモデルに基づいたRSIをさらに深く研究しており、エージェントが蓄積した経験を再利用するだけでなく、継続的な学習と自己進化を実現し、AI記憶分野でのリーダーシップをさらに強化しています。同時に、複数のシナリオでの応用を加速し、Bサイドの産業やCサイドの製品向けの記憶モジュールの標準化開発と規模化された商業化を推進しています。
結びの言葉
Agent RSIの鍵となるのは、AIが単一のタスクでより良いパフォーマンスを発揮するだけでなく、毎回の実行を、次の能力向上の基盤にしましょう。成功した方法、失敗した経験、そして適用条件は、長期的な記憶を通じて蓄積され、新しいタスクにおいて再利用可能な行動指針として活用されます。新たな実行結果は、さらに経験の更新、記憶戦略の最適化、そして記憶の基礎モデルの継続的な学習を促進します。
MemoraXが現在探求しているのは記憶とエージェントの自己改善が相互に促進し合う双方向の進化の道筋一方で、記憶がAgent RSIに持続的な経験の蓄積とタスク間での知識の移行を可能にし、もう一方で、実際のタスクでの実行とフィードバックが記憶自体の学習と進化を促進するのです。
タスクをこなすたびに経験が積み重なり、フィードバックを通じて改善が促されると、エージェントの能力向上は単発の実行にとどまらず、継続的に蓄積され、自己進化するプロセスへと変わります。
この記事は「機械の心」からのもので、著者は「機械の心」です。
有用吗?