De la mémoire à l'évolution autonome : Un pas clé pour que l'Agent atteigne le niveau RSI
Récemment, les laboratoires de recherche en IA de premier plan à l’échelle mondiale diffusent activement un message :L'IA passe de l'aide à l'humanité dans l'exécution de tâches à la participation à son propre développement et à son amélioration.
En septembre, OpenAI a annoncé avoir atteint l'objectif intermédiaire de la création d'« stagiaires de recherche en intelligence artificielle automatisés » et prévoit de développer de véritables « chercheurs en intelligence artificielle automatisés » d'ici mars 2028. Jakub Pachocki, le scientifique en chef d'OpenAI, a publié un article détaillé à cette occasion, abordant les perspectives de développement de la technique d'amélioration récursive (Recursive Self-Improvement, RSI). Le 21 septembre, OpenAI a encore souligné que la création de chercheurs en intelligence artificielle automatisés et le renforcement continu des capacités de recherche et développement en IA constituent des directions stratégiques importantes pour la prochaine étape de son développement.
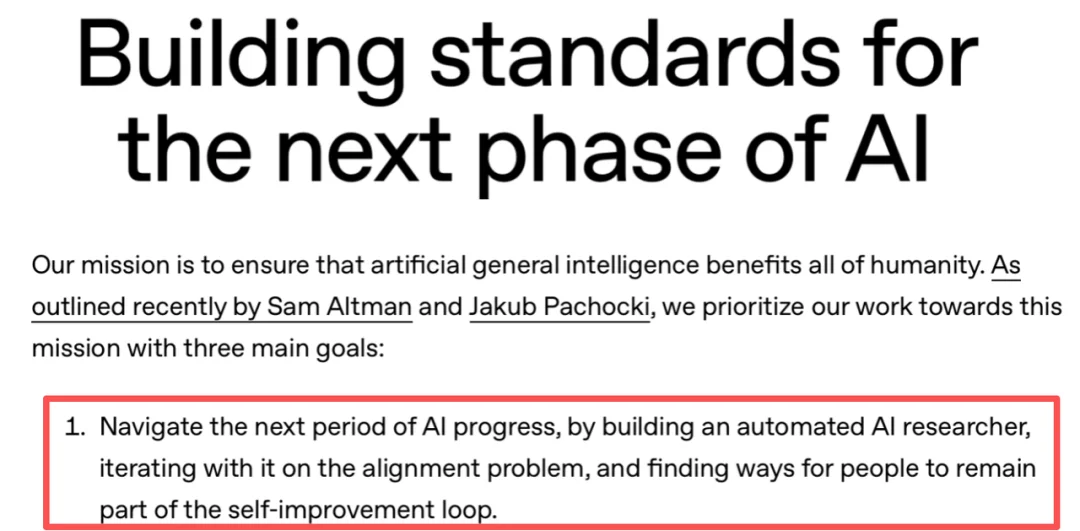
OpenAI a publié une déclaration stratégique officielle le 21 septembre 2026, dans laquelle il a indiqué que la recherche sur les chercheurs en IA automatisés et l'amélioration récursive de soi-même étaient des objectifs importants pour la prochaine étape de son développement.
D'un autre côté, Anthropic a également publié un ensemble de données intéressantes : en août de cette année, Claude avait déjà parcouru environ... 26 % du travail de recherche et développement en intelligence artificielle interne est mené de manière dominante.De plus en plus de tâches de recherche et développement, qui étaient auparavant réalisées par des chercheurs, sont maintenant confiées à l'IA sous la supervision humaine.
De OpenAI à Anthropic, le RSI passe d'une idée technologique lointaine à un sujet central des programmes de recherche et développement des laboratoires de pointe mondiaux. L'IA n'est plus seulement un outil pour résoudre des problèmes externes, elle commence également à jouer un rôle dans le développement de ses propres capacités.
Mais la clé la plus essentielle de ce chemin d'évolution continue réside dans :
Comment l'IA peut-elle faire en sorte que les explorations et les essais et erreurs du passé deviennent réellement la base du progrès suivant, plutôt que de devoir tout recommencer à chaque fois qu'une nouvelle tâche est abordée ?
La mémoire est la base essentielle qui permet à l'Agent d'améliorer constamment lui-même. Il permet que chaque exploration ne laisse derrière elle non seulement les résultats des tâches effectuées, mais aussi des expériences qui peuvent être héritées et réutilisées par des tâches ultérieures, offrant ainsi à l'Agent la possibilité d'améliorer ses capacités au-delà d'une seule tâche et d'évoluer continuellement grâce à une accumulation progressive.
01 | De l'accumulation d'expérience à l'évolution continue :
Comment la mémoire soutient le RSI
Pour que l'Agent améliore constamment ses capacités tout en exécutant de manière continue, il est essentiel que l'expérience acquise puisse être transférée au-delà d'une seule tâche :Développer des méthodes efficaces à partir des explorations passées, les appliquer avec précision dans de nouvelles tâches, et les améliorer et les optimiser en fonction des résultats obtenus. Parmi ces processus, l'écriture dans la mémoire et la récupération des données jouent un rôle clé en tant que deux éléments interconnectés.
L'écriture dans la mémoire nécessite d'identifier des méthodes efficaces, des conclusions d'échec et leurs conditions d'application à partir de trajectoires d'exécution complexes, afin que les tâches passées laissent réellement des expériences réutilisables ; la récupération de la mémoire, quant à elle, doit permettre de trouver avec précision les méthodes historiques et les preuves clés adaptées aux besoins de nouvelles tâches, pour éviter les omissions d'expériences et les transferts erronés.
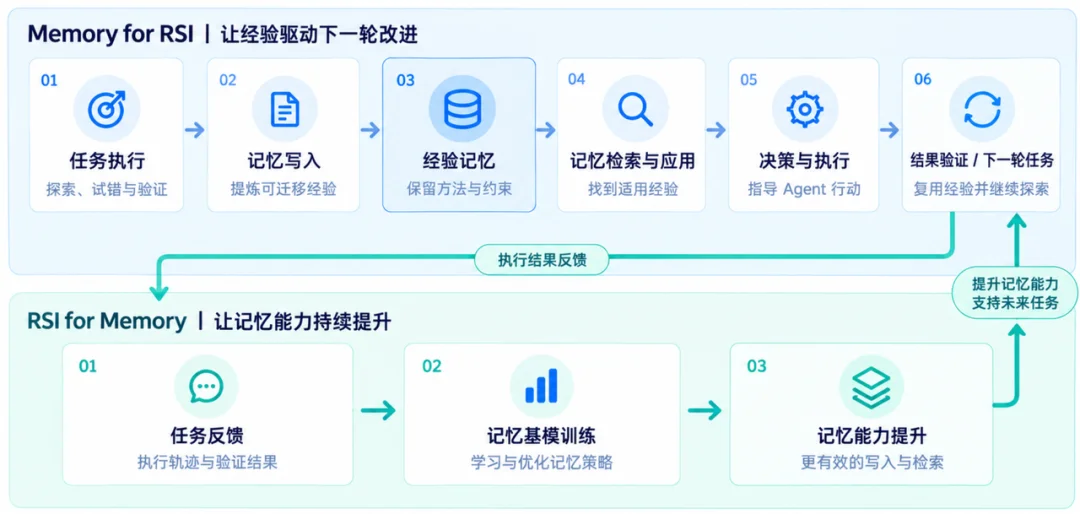
De plus, les retours sur les tâches peuvent également servir à vérifier la valeur réelle de l'expérience. En mettant à jour constamment le contenu de la mémoire et en utilisant les retours efficaces pour entraîner le modèle de base de la mémoire, on peut améliorer les capacités de la mémoire elle-même, créant ainsi un processus dans lequel l'accumulation d'expérience et l'amélioration de l'Agent se renforcent mutuellement.
02 | L'apprentissage et l'évolution de la mémoire :
Améliorer constamment l'Agent grâce à son expérience
Conformément aux besoins d'accumulation d'expérience, de réutilisation entre tâches et d'amélioration continue dans Agent RSI, MemoraX a construit un système basé surApprentissage expérientiel, transfert des connaissances issues de l'expérience et optimisation grâce aux retoursUn système de capacité de mémorisation centré sur l'agent, qui construit des données de mémorisation de haute qualité, organise la mémorisation de manière dynamique et l'optimise en fonction des retours de tâches réelles, entraînant constamment le modèle de base de mémorisation. Cela permet à l'agent d'apprendre et d'améliorer continuellement ses décisions et ses actions à partir de l'expérience passée.
Apprendre de la tâche : faire en sorte que l'accumulation d'expérience devienne une capacité du modèle pouvant être optimisée
Lors de l'exécution des tâches par l'agent, la validation des résultats et l'ajustement des stratégies génèrent constamment de nouvelles expériences.Les décisions réussies fournissent des méthodes réutilisables pour les tâches ultérieures, tandis que les conclusions d'échec vérifiées aident l'Agent à éliminer les solutions inappropriées et à réduire les essais et erreurs répétés.Mais la valeur de l'expérience ne se révèle souvent que dans les tâches ultérieures. Résumer avec précision le passé ne signifie pas nécessairement pouvoir soutenir efficacement l'avenir. Par conséquent, le processus d'apprentissage par la mémoire nécessite non seulement de reconnaître les expériences dignes d'être conservées, mais aussi de préserver les preuves de leur validité, les contraintes environnementales et les conditions d'application, afin d'éviter que ces expériences ne soient oubliées ou mal utilisées. Cela dépasse de loin la simple réduction en résumé ou la compression des informations.
Face à ce défi, MemoraX Intégrer la mémoire dans des stratégies apprenables conçues pour maximiser les bénéfices des tâches futures, et continuer à développer un système complet couvrant la construction de l'environnement, la collecte de données, la construction d'échantillons et l'entraînement à l'apprentissage automatique agissant à grande échelle.Dans un environnement de tâches interactif et vérifiable, les traces d'exécution, les enregistrements d'utilisation de la mémoire et les retours de validation sont collectés pour construire des échantillons d'entraînement associés aux décisions de écriture et aux effets ultérieurs de l'utilisation. Ensuite, en combinant la qualité de réalisation des tâches suivantes, l'efficacité d'exécution et les tentatives et erreurs répétées, des signaux de récompense sont conçus pour optimiser la stratégie d'écriture dans la mémoire. Ce processus élargit l'objectif d'optimisation du modèle de l'exactitude de l'extraction d'informations à d'autres aspects.L'impact réel de la mémoire sur la qualité des tâches ultérieures, l'efficacité de l'exécution et la capacité à réessayer et à corriger des erreursApprendre est plus bénéfique pour la mise en œuvre de stratégies de mémorisation pour les tâches futures.
Migrer de l'expérience acquise : Laisser l'expérience passée guider de nouvelles tâches
L'expérience peut être conservée, mais cela ne signifie pas nécessairement qu'elle pourra être efficace dans de nouvelles tâches. Face à des objectifs de tâche différents, des contraintes environnementales et des étapes d'exécution variées, l'Agent doit identifier avec précision les méthodes historiques applicables, afin d'éviter les interférences de informations inutiles et les transferts erronés d'expérience.
Pour cela, MemoraX vaDécouplage du contenu mémorisé de la structure d'accèsAjustez dynamiquement les points d'accès à la mémoire et les relations associées en fonction de la tâche en cours, afin que les mêmes informations historiques puissent répondre à différentes besoins d'utilisation.
Au niveau de la recherche, en allant plus loin…Apprendre la relation de correspondance entre les exigences de la tâche actuelle et les preuves clés historiques grâce à l'entraînement du modèleAméliorer la capacité de localisation des expériences clés en combinant l'identification de preuves à fine granularité avec la disambiguation des souvenirs similaires, afin de distinguer entre ce qui est 'relatif au sujet' et ce qui est 'correctement prouvé'.
Lors de l'étape d'utilisation pratique, MemoraX prend en compte l'état actuel de la tâche ainsi que l'avancement de son exécution,Transformer les expériences générales accumulées au fil du temps en directives d'action avec des objectifs clairs, des contraintes opérationnelles et des normes de validationEt s'ajuster dynamiquement en fonction des étapes de la tâche, afin que l'expérience acquise puisse réellement participer aux décisions et à l'exécution de l'Agent.
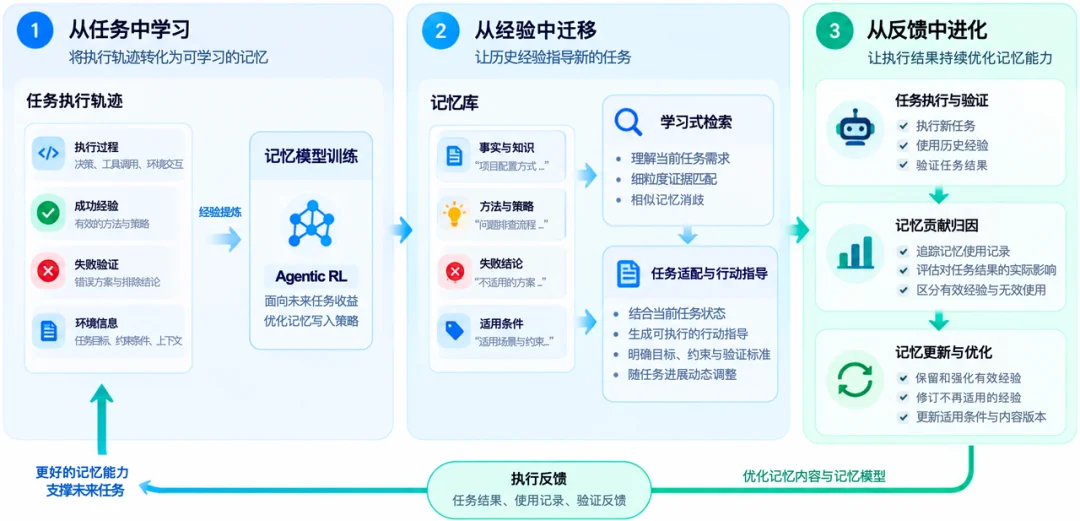
Évoluer à partir des retours : améliorer continuellement les résultats de l'exécution pour renforcer la capacité de mémorisation
Dans l'itération continue de l'RSI, l'expérience historique n'est pas toujours efficace. De nouvelles tâches peuvent soit confirmer les méthodes existantes, soit révéler leurs limites.Comment utiliser les retours d'exécution pour juger la véritable valeur de l'expérience et en tirer des leçons afin d'améliorer constamment sa mémoire est un élément essentiel pour une auto-amélioration continue.
Le défi principal est Attribution of Memory CreditsLes tâches à long terme peuvent faire appel à de nombreuses expériences historiques, mais lesquelles ont réellement influencé la décision de l'Agent, et lesquelles n'ont été que lues sans avoir d'impact ? Même si la tâche est finalement réussie, il reste un problème à résoudre de déterminer la contribution réelle de chacune de ces mémoires.
Face à ce défi, MemoraX vaAssocier les versions mémorielles, les enregistrements d'utilisation réelle et les retours d'exécution des tâchesIl s'agit de suivre si l'expérience historique a réellement influencé les actions de l'Agent, ainsi que de l'évaluation des performances de la tâche et des résultats de validation après son utilisation. Sur cette base, il est nécessaire de continuer à évaluer et d'iterer les mémoires existantes.Permettre que les expériences efficaces soient préservées et renforcées, et ajuster en temps opportun celles qui ne sont plus pertinentes en fonction des nouveaux retours d'expérience des tâches.
Ces retours réels contribuent également àFormation continue des modèles de base de la mémoireLes données de base et les signaux d'optimisation fournis permettent d'étendre les améliorations de la mémoire, passant d'une mise à jour au niveau du contenu, à un apprentissage par le modèle de mémoire des valeurs expérientielles et des stratégies de mémorisation.
03 | De l'accumulation d'expérience à l'amélioration des compétences :
Pratiques de RSI multi-scénarios avec MemoraX
Pour l'Agent RSI, ce qui est plus important de connaître, ce n'est pas seulement le résultat d'une tâche particulière, mais plutôt...Les expériences historiques peuvent-elles être constamment accumulées, améliorées et continuer à être précieuses dans les tâches futures ?
Dans le cadre de ce processus, les capacités d'itération continue de l'expérience, de migration entre tâches et d'optimisation par feedback ont été vérifiées séparément dans trois types de tâches complexes : le codage à long terme, l'analyse financière et la réflexion mathématique avancée. De plus, il a été démontré comment la mémoire contribue à améliorer la qualité et l'efficacité de l'Agent dans les tâches à long terme.
(1) Programmation complexe à long terme : de l'itération basée sur l'expérience à l'amélioration des compétences en ingénierie complexe
Les expériences de codage complexes à longue portée sont utilisées dans les domaines de la communication, de la finance, de la logistique, etc. Dans 5 grands secteurs industriels et 13 tâches de développement de systèmes de niveau industriel, un total de 78 exécutions de développement ont été effectuées, avec une durée totale de développement dépassant 300 heures, et la durée maximale pour une seule exécution dépassant 12 heures. En fin de compte, le taux de réussite du programme d'amélioration de la mémoire MemoraX a augmenté de plus de 20 %, tandis que la consommation totale de tokens par l'agent de codage principal a diminué de plus de 20 %.
De l'accumulation d'expérience à l'amélioration récursive : le chemin de l'itération de soi de la mémoire
Face au problème du fait que la mémoire statique traditionnelle ne permet pas d'accumuler et d'optimiser continuellement l'expérience au cours de l'exécution des tâches, l'équipe MemoraX a proposéMéthode RSI (Recursive Self-Improvement) pilotée par le modèle de mémoireGrâce à la collaboration entre un modèle de mémoire développé en interne et le système Agent, le modèle de mémoire spécialisé est chargé d'extraire et de mettre à jour la mémoire procédurale à partir des trajectoires d'exécution de l'Agent et des retours en ligne. Le système Agent applique ensuite cette mémoire aux tâches réelles, créant ainsi un mécanisme itératif fermé qui permet d'accumuler, d'optimiser l'expérience acquise et de guider les tâches ultérieures. Cela est particulièrement vrai dans les cas d'entraînement composés de tâches de codage à long terme.Après plusieurs itérations d'optimisation de la mémoire procédurale, la qualité de cette mémoire a été améliorée de plus de 10 %.
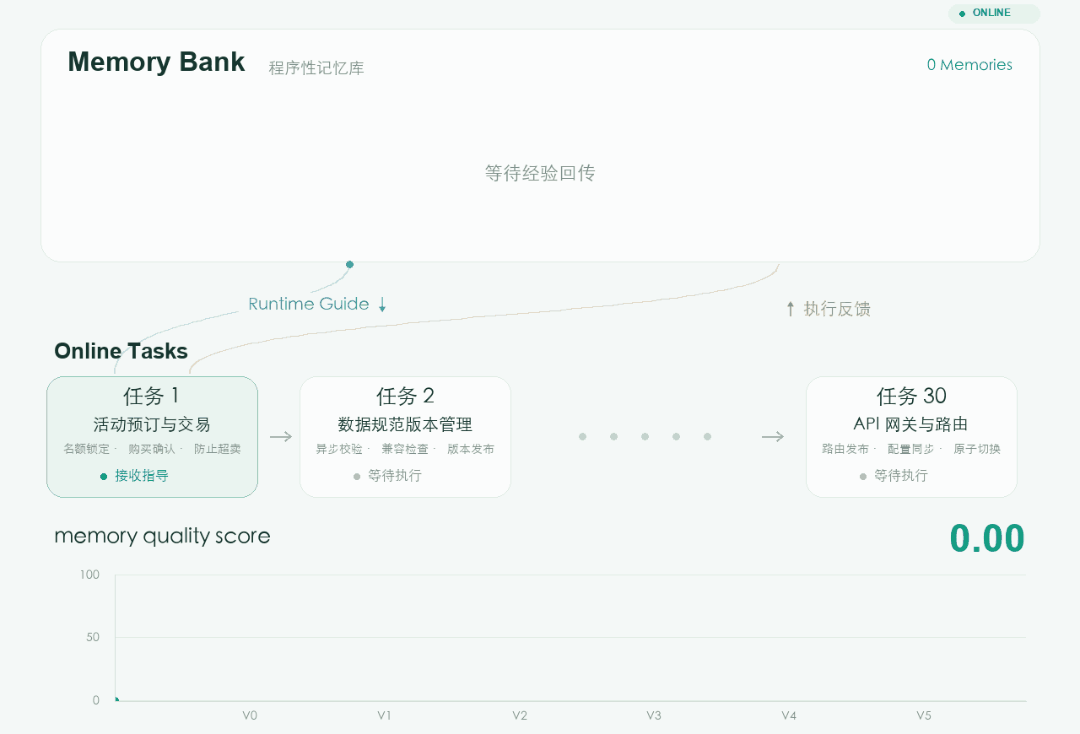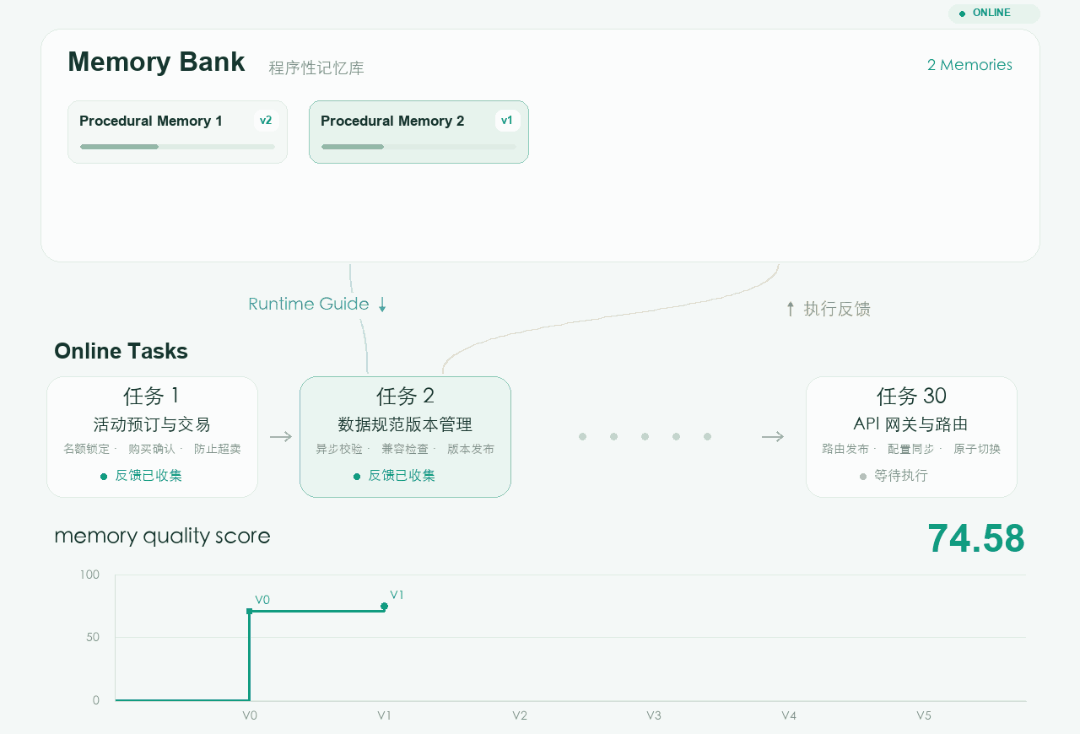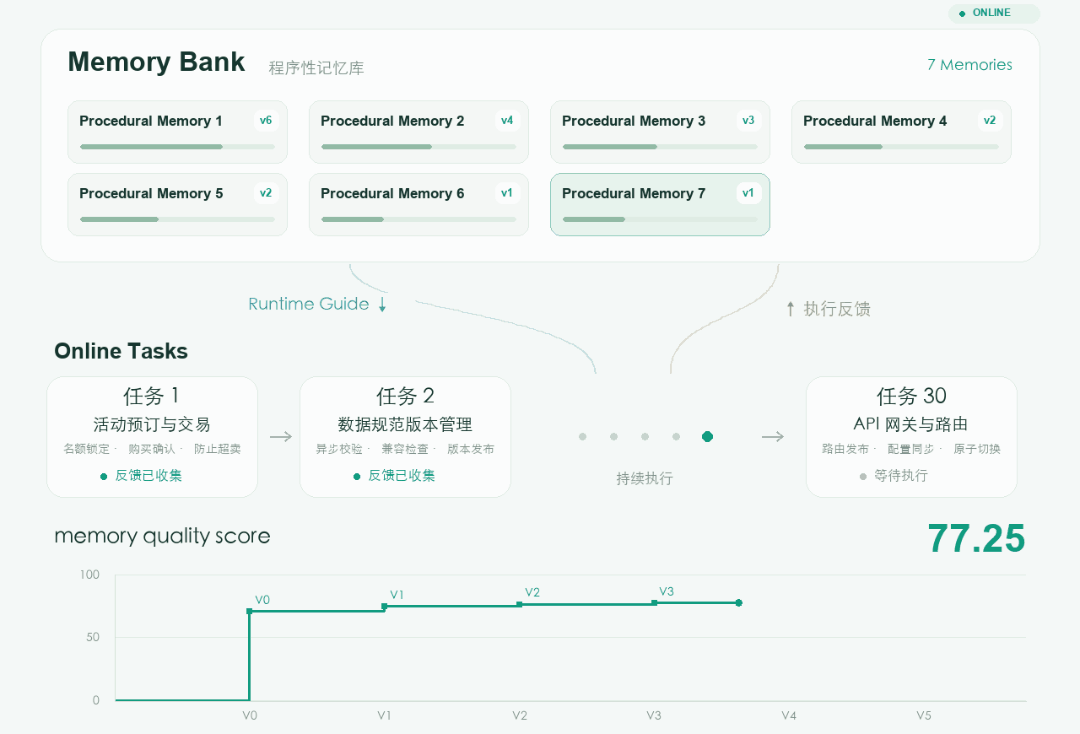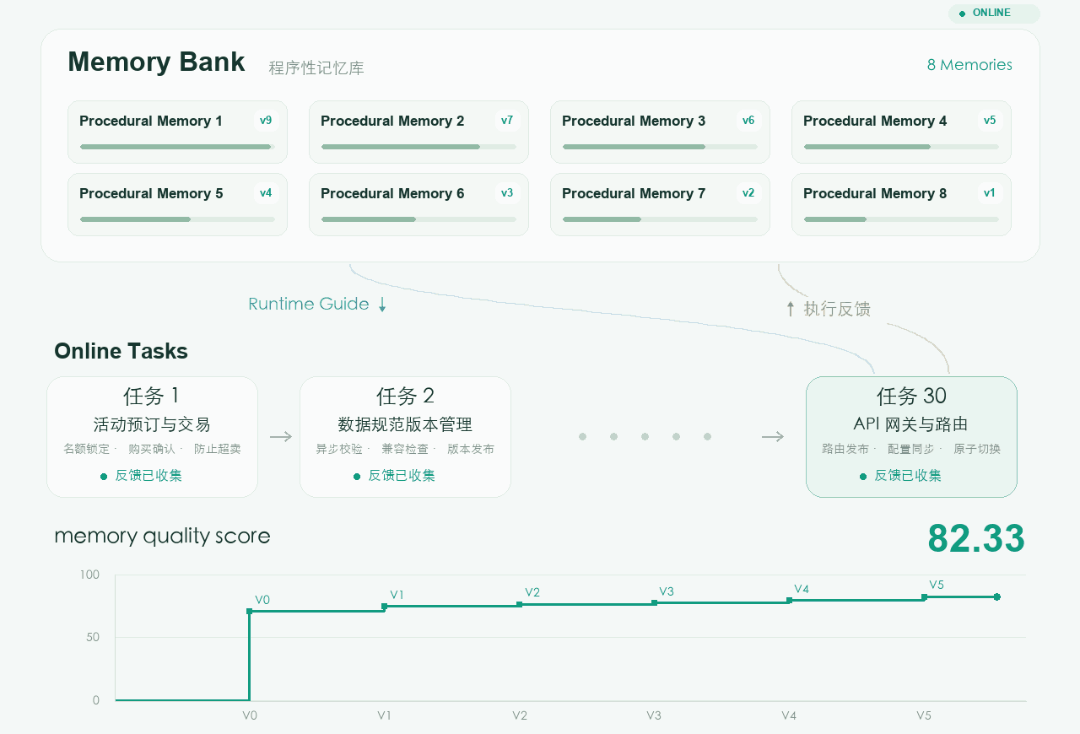
Avec l'expérience acquise à travers des itérations répétées, relever le défi de développer un projet complexe sur une période de 335 heures
Combien de valeur peut l'expérience accumulée jouer lorsqu'elle est séparée de la tâche d'apprentissage originale et qu'il s'agit de faire face à de nouveaux défis techniques ?
Pour cela, nous utilisons l'expérience accumulée pour des tâches de développement d'ingénierie complexes entièrement nouvelles.Lors de 13 tâches complexes d'ingénierie logicielle, 78 exécutions de développement ont été effectuées, pour une durée totale de développement dépassant 335 heures, avec la durée maximale pour une seule exécution atteignant 12 heures.Ces tâches ne sont pas simplement des modifications de code simples, mais représentent de véritables défis d'ingénierie qui impliquent une logique commerciale complexe, des dépendances entre modules et un grand nombre de tests.
En fin de compte, le taux de réussite a augmenté de plus de 20 %, tandis que la consommation totale de tokens par le Coding Agent a diminué de plus de 20 %.
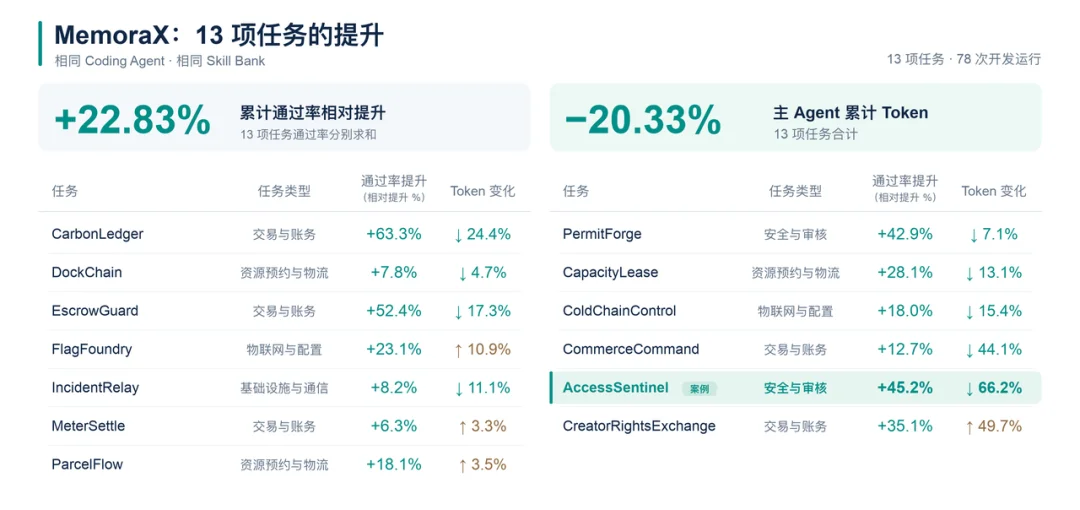
Parmi eux, AccessSentinel est un cas représentatif de grande complexité. L'Agent doit mettre en place un système complet de contrôle des droits au niveau de l'entreprise et s'assurer que...Contraintes de sécurité strictes。
Avec l'aide des modèles de mémoire,L'expérience historique n'est plus simplement une référence d'informations statiques, mais elle peut participer de manière continue à l'exécution et à la validation de l'Agent en fonction des changements d'état de la tâche.De la 43e minute après le démarrage du développement à 2 heures et 30 minutes, la mémoire est enregistrée à différents points clés.Offrir de manière proactiveConseils ciblés :
- Lorsque les autorisations de l'appareil sont révoquées,Il ne suffit pas d'interdire aux appareils de se connecter à nouveau, il faut également s'assurer que les comptes qui se sont déjà connectés ne puissent plus accéder au système.
- Lors du rétablissement d'une ancienne version de la stratégie de sécurité,Il est nécessaire de conserver les archives historiques tout en empêchant que les droits qui ont été supprimés ne soient rétablis par erreur.
- Lors du traitement en masse des demandes,Vérifiez d’abord si toutes les demandes répondent aux exigences ; seule une exécution unifiée est possible pour éviter des situations où certaines réussissent et d’autres échouent.
Pendant les tests,L'augmentation moyenne du taux de réussite après trois exécutions est de plus de 45 %, tandis que la consommation totale de tokens par l'agent de codage principal a diminué de plus de 66 %.
(2) Analyse financière complexe : de l'accumulation de preuves à une amélioration continue et autonome
La recherche financière nécessite de former des jugements analytiques complets et fiables à partir d'une grande quantité de matériaux dispersés. En plus de trouver les données pertinentes, l'Agent doit également comprendre avec précision les sujets, les périodes et les méthodes statistiques dans un contexte complexe, établir des liens entre les différentes preuves, et éviter que des omissions d'informations ou des confusions de méthodes n'affectent les conclusions finales.
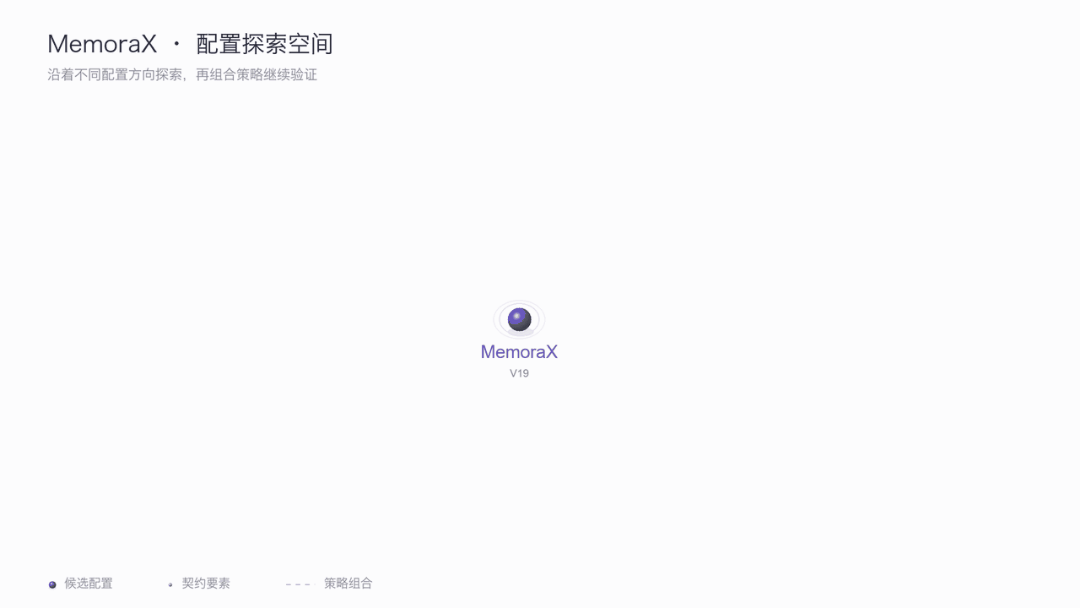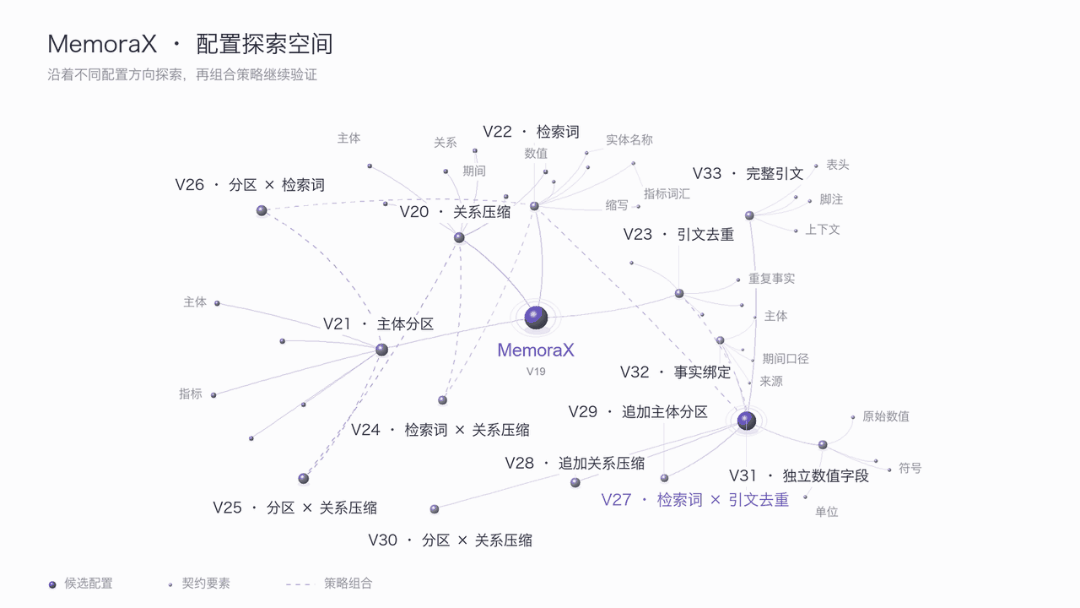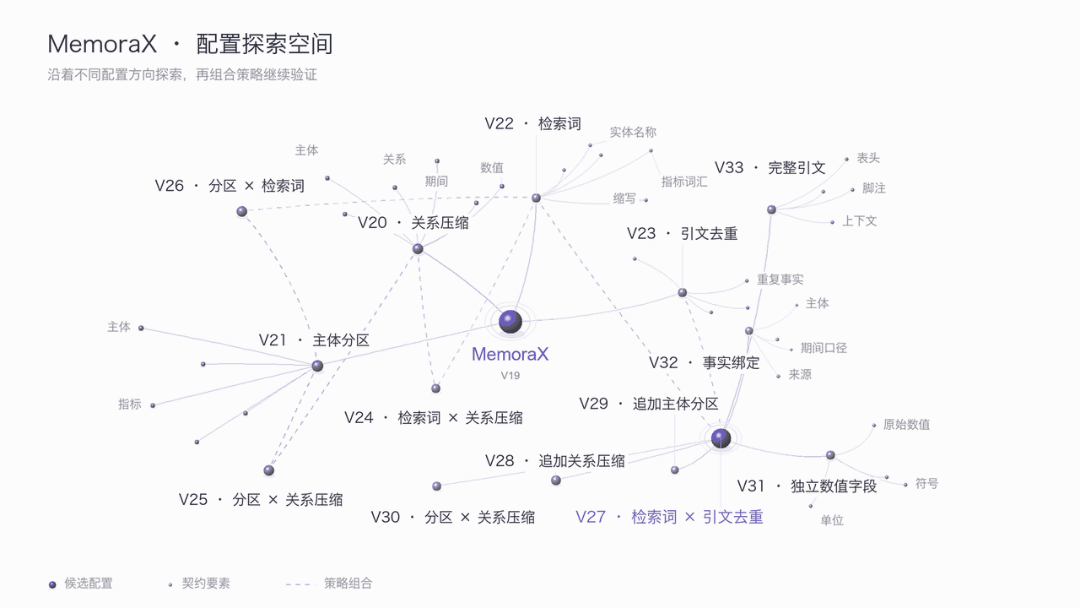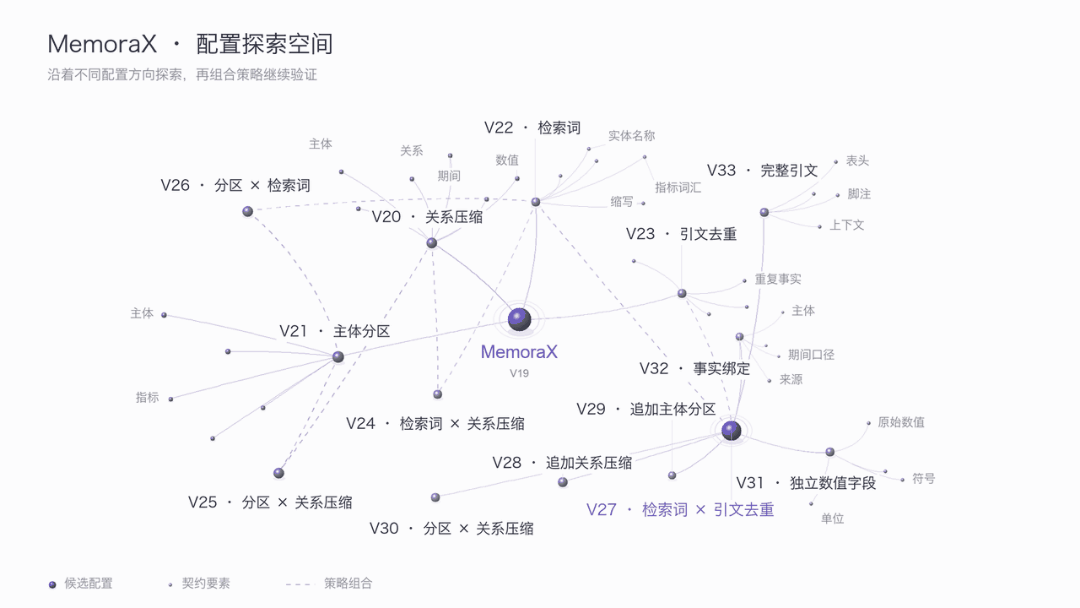
MemoraX se concentre sur deux problèmes qui sont étroitement liés :Comment faire en sorte que les preuves soutiennent une réponse complète, et comment utiliser les questions contenues dans la réponse pour améliorer à leur tour les méthodes de conservation et de recherche des preuves.Pour cela, MemoraX mène des expériences basées sur le référentiel autorisé du secteur financier FinRank, qui couvre les rapports financiers réels de 22 entreprises américaines cotées en bourse dans des secteurs tels que la pharmacie, le pétrole et le gaz, ainsi que l'automobile, et comprend une grande quantité de données financières complexes à travers différentes entreprises et périodes. Dans le cadre de ces tâches, MemoraX utilise les retours des tâches pour optimiser continuellement l'organisation et la recherche dans sa mémoire, créant ainsi un cycle itératif RSI de « exécution — retour — amélioration de la mémoire — réexécution ». Plus de 30 itérations collaboratives entre les modèles de mémoire et les systèmes d'analyse financièreFinalement,Le taux de rappel de la chaîne de preuves est proche de 100 %, ce qui représente une amélioration de 20 % par rapport à la précision de réalisation des tâches CodeX, et une réduction des coûts de près de 98 %.
De la recherche des données à l'organisation des preuves permettant de soutenir un jugement
Prenons comme exemple une tâche d'analyse financière pour une grande entreprise manufacturière, où les preuves pertinentes sont dispersées dans une grande quantité de documents similaires provenant de l'industrie, comprenant des états financiers sur trois années consécutives, des informations divulguées par les fournisseurs et des descriptions des risques. Il est facile de trouver du contenu pertinent par rapport au thème, mais qui ne concerne pas l'entreprise ciblée ou la période de rapport, en se basant uniquement sur des mots-clés ou une similitude sémantique. Cependant, si l'on ne retient que les résumés, on risque de manquer les unités de mesure des chiffres et les conditions dans lesquelles les risques sont établis.
Pour cela, MemoraX convertit d'abord les matériaux contextuels en mémoire structurée et ajuste progressivement la manière d'organiser cette mémoire en fonction des retours des réponses, en se concentrant sur les scénarios de questions et de réponses financières, afin de développer une approche qui prend en compte...Précision des valeurs, alignement des calibres et traçabilité des sourcesReprésentation des sorties du modèle de mémoire ; lors de la recherche, ces preuves sont mobilisées en fonction de la question en cours, et la situation actuelle des stocks, la structure des achats ainsi que les risques potentiels sont analysés ensemble. Cette approche organisationnelle tient compte des exigences des tâches financières.Les valeurs sont précises, les critères sont uniformes et les sources sont traçables.Les exigences de la demande.
La précision de l'accomplissement de la tâche finale par MemoraX a été améliorée par rapport à celle de Codex.Près de 20 %De plus, en fonction des statistiques de l'utilisation réelle de l'API, le coût de cette solution...Par rapport à la solution de référence Codex, les coûts d'appel ont été réduits de près de 98 %, tout en obtenant un taux d'acceptation plus élevé.
De la rétroaction des utilisateurs à l'itération des stratégies : améliorer la mémoire "Comment conserver, comment retrouver"
MemoraX, en fonction des retours des tâches, explore constamment les méthodes de sélection et d'organisation des informations mémorielles en cas d'omission de preuves, de confusion des relations et de redondance des références, et accumule continuellement ces connaissances lors des tâches d'entraînement.Échantillons d'interaction entre les décisions de écriture associées, le contenu mémorisé et les effets de l'utilisation ultérieure,Conçu pour optimiser les modèles de mémoire. Le modèle, une fois entraîné, participe à une nouvelle série de tâches, et les retours de son exécution sont à nouveau utilisés pour améliorer la stratégie d'écriture et les entraînements ultérieurs, créant ainsi un cycle RSI dans lequel l'interaction entre les tâches et l'optimisation du modèle se renforcent mutuellement. Au cours de ce processus, le modèle émerge progressivement.Caractéristiques de représentation de la mémoire adaptées aux scénarios financiersAssocier les valeurs clés aux conditions applicables pour les enregistrer, distinguer les différents sujets, les périodes de rapport et les sources, et établir une correspondance entre les faits et les preuves originales. Après Itération de l'RSI sur 36 périodes,MemoraX Le taux de rappel des preuves a atteint 96,49 %, et la précision de la tâche est passée de 33,33 % à 73,33 %.
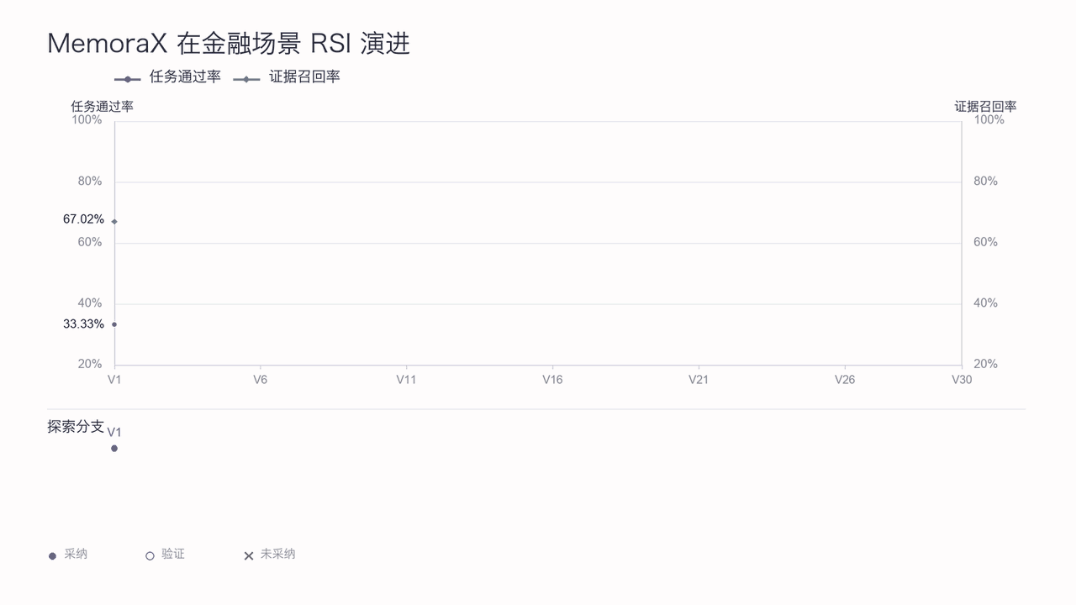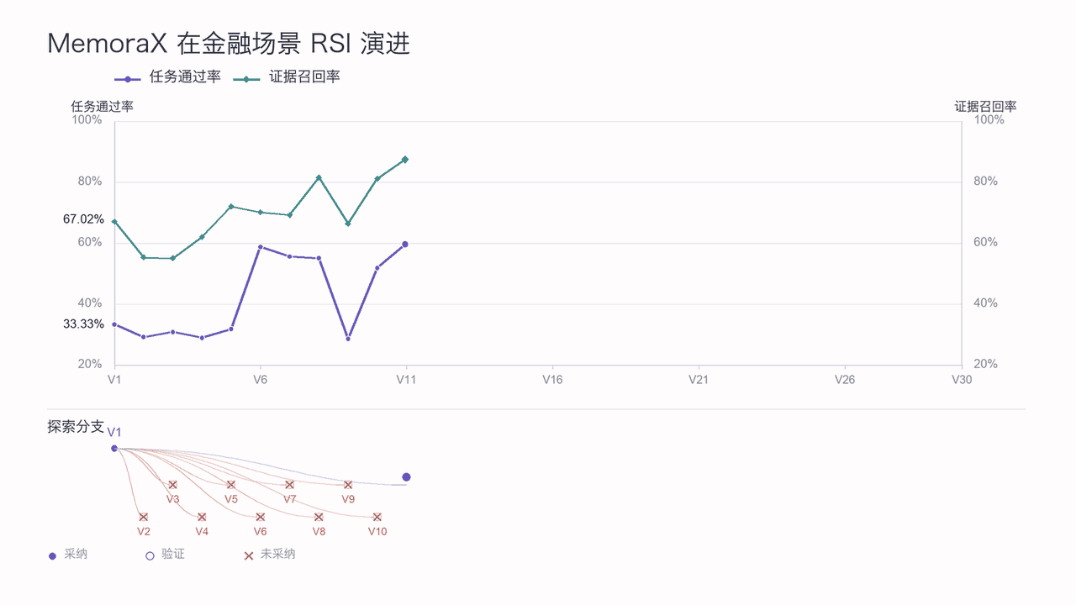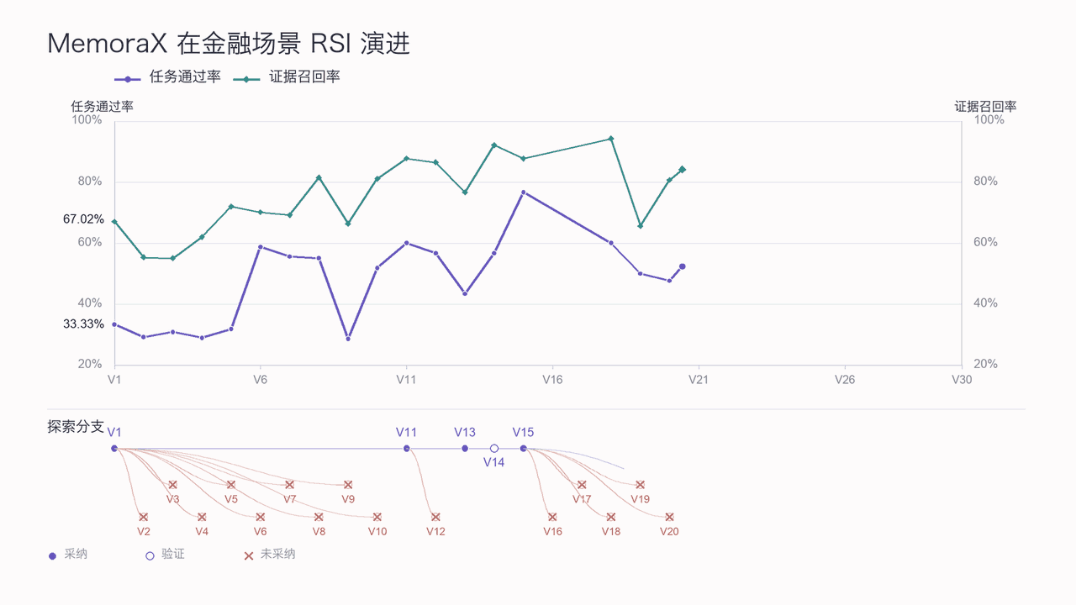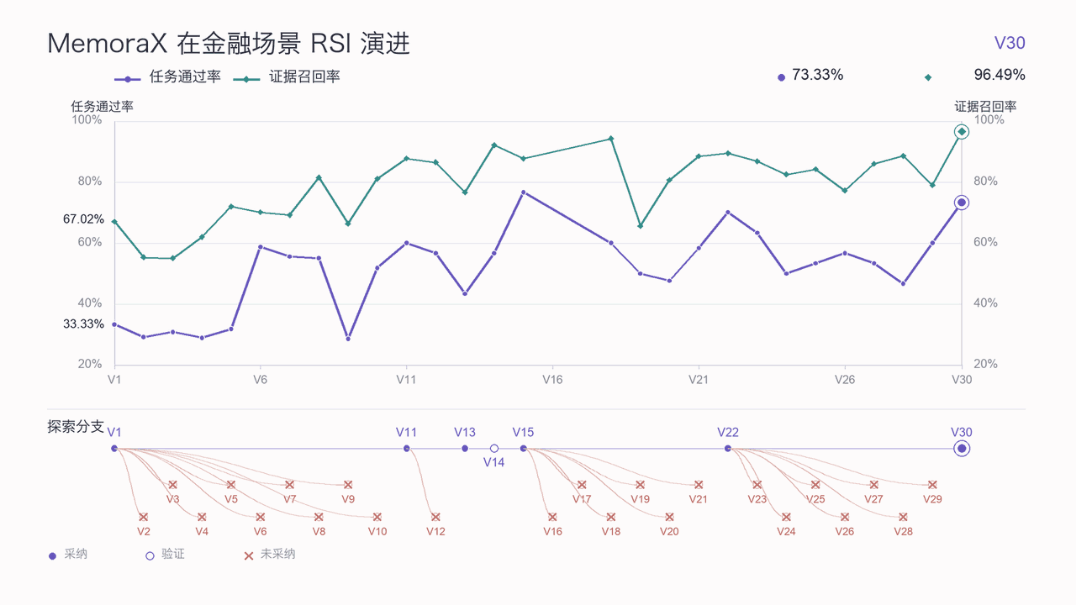
Pour les chercheurs qui doivent suivre de manière continue les rapports financiers et les annonces, les connaissances acquises à partir d'un même ensemble de documents peuvent être utilisées pour répondre à différentes questions, ce qui permet de répartir les investissements initiaux sur une plus longue période. Les retours issus des analyses ultérieures peuvent ensuite être utilisés pour ajuster le contenu de ces connaissances et les stratégies d'utilisation correspondantes.Rendre les réponses plus complètes, rendre l'utilisation plus économique, et permettre à l'expérience de s'accumuler de manière continue,Cela constitue ensemble la valeur pratique de MemoraX dans les tâches financières complexes.
(3) Résolution mathématique complexe : de la rétroaction empirique à l'itération autonome des stratégies de résolution
Dans des expériences de raisonnement mathématique de haute difficulté, MemoraX a approfondi son exploration de l'utilisation de l'expérience historique et des retours de validation pour aider les agents à corriger continuellement leur raisonnement et à optimiser leurs stratégies de résolution face à des problèmes complexes. Dans des problèmes d'optimisation combinée au niveau de l'IMO (International Mathematical Olympiad), l'agent a réussi, après environ... 4 heures de résolution continue, plus de 600 appels de modèle,Le résultat finalement trouvé a été vérifié. Solution optimale pour 21 rectangles. Par rapport à la solution OpenAI Codex, le temps de résolution a été réduit de 13 % et le coût de 98 %.
De la preuve de l'échec à la solution optimale : améliorer continuellement la réflexion grâce aux retours
Matilda 16×16 est un problème de complexe optimisation de niveau IMO (Impossible Mission) : il s'agit de couvrir les 240 cases d'un réseau de 16×16 avec le plus petit nombre possible de rectangles, tout en veillant à ce qu'il reste une case vide dans chaque ligne et chaque colonne. Le nombre de positions vides est déjà assez élevé. 20,9 billions de permutations possiblesLa difficulté ne réside pas seulement dans la recherche d'une solution viable, mais aussi dans la démonstration qu'il n'existe pas de solution utilisant moins de rectangles.
Face à ce défi, l'Agent a collaboré de manière continue sur la construction des recherches, la preuve formelle, le modélage précis et l'audit indépendant. Le système a initialement trouvé 27 et 23 candidats de construction, mais l'argumentation concernant l'optimalité globale des 23 candidats a été rejetée par l'audit indépendant.
MemoraX est capable d'accumuler de manière continue les solutions proposées précédemment, les processus de raisonnement ainsi que les retours d'information sur la validation. Les modèles de mémoire extraient des expériences d'amélioration efficaces à partir des trajectoires réussies et transforment les échecs en références pour ajuster les stratégies de résolution ultérieures :
- Correction de la mémoire à partir de conclusions erronées : de la conclusion erronée à la correction de la mémoire. L'audit indépendant a rejeté 23 preuves d'optimisme erronées, incitant l'Agent à reconsidérer ses conclusions préexistantes, et à utiliser les retours de validation selon lesquels "une solution viable n'est pas nécessairement la meilleure solution" pour corriger sa mémoire, afin d'éviter que les raisonnements ultérieurs ne reproduisent les mêmes erreurs.
- Optimization of strategies: From memory updates to method improvements. Basé sur les solutions proposées précédemment et les retours de validation issus des modèles de mémoire, l'Agent a été guidé pour ajuster sa méthode de modélisation afin d'intégrer de manière cohérente les contraintes des emplacements vides et des bords rectangulaires dans la recherche de solutions. Il a ainsi trouvé successivement 22 et 21 solutions améliorées.
- Iterations sur la mémoire : de la validation des résultats à l'optimisation continue. L'agent effectue une résolution précise en vérifiant progressivement et en utilisant des outils d'appel, afin de confirmer en fin de compte l'optimisme de la réponse. Il renvoie ensuite les nouveaux résultats de validation au modèle de mémoire pour améliorer la construction de la mémoire de résolution, ce qui fournira une référence pour des problèmes similaires à l'avenir.
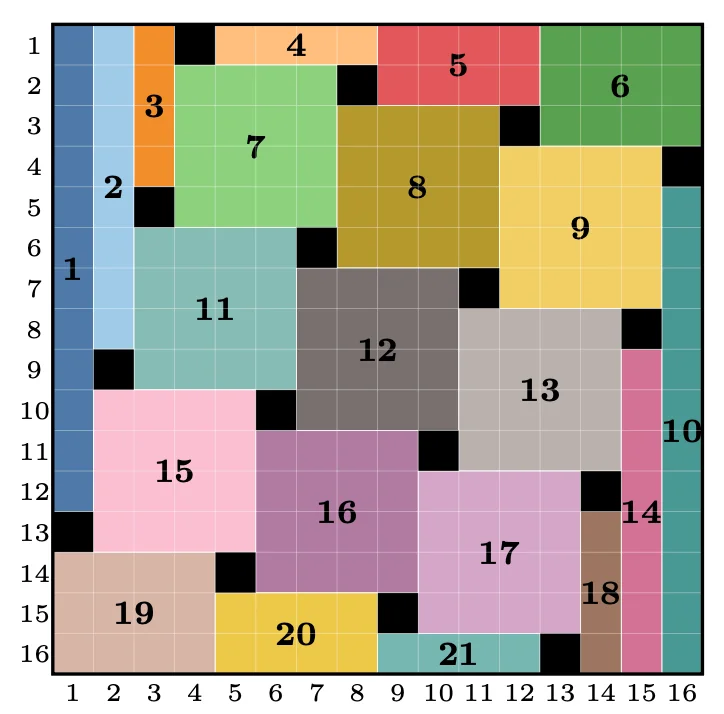
Optimal placement of 21 rectangles for the Matilda 16×16 problem. The black squares represent empty spaces, and the areas of different colors represent rectangular tiles.
Cela montre la capacité d'itération continue de l'Agent dans des tâches mathématiques complexes :L'expérience historique n'est plus simplement un enregistrement de raisonnements statiques, mais elle peut être intégrée à de nouveaux retours de validation pour participer de manière continue à l'ajustement des stratégies de résolution ultérieures.
Partant de la mémoire, vers un Agent en évolution continue
MemoraX AI a été créé par Hao Jianye, ancien directeur du laboratoire de décision et de raisonnement chez Huawei, directeur du laboratoire d'algorithmes de grands modèles et expert en décision intelligente. L'entreprise se concentre sur le développement de la prochaine génération de modèles de mémoire d'agents qui sont capables d'apprendre et d'évoluer.
Le modèle de mémoire développé indépendamment par l'équipe, basé sur la technologie Agentic RL, a remporté la première place dans les classements mondiaux de mémoire les plus reconnus et a été largement couvert et suivi par des médias nationaux et internationaux tels que le MIT Technology Review. La solution de mémoire de l'équipe est largement mise en œuvre dans des entreprises leaders des secteurs de la programmation, de la santé, de la finance, de la sécurité, de la maison intelligente, etc., et est un partenaire stratégique de Huawei Cloud et Tencent Cloud.
Aujourd'hui, l'équipe approfondit davantage le RSI basé sur des modèles mémoriels, permettant aux agents d'évoluer de l'accumulation et du réutilisation de l'expérience vers un apprentissage continu et une auto-amélioration, renforçant ainsi leur avance dans le domaine de la mémoire artificielle. En même temps, l'équipe accélère la mise en œuvre de ces technologies dans divers scénarios et promeut le développement standardisé et la commercialisation à grande échelle des modules de mémoire pour les produits destinés aux secteurs B2B et B2C.
Conclusion
La clé de l'Agent RSI réside non seulement dans le fait de permettre à l'IA de performer mieux dans une tâche unique, mais aussi dans...Faire en sorte que chaque exécution devienne la base pour une amélioration de nos capacités la prochaine fois.Les méthodes réussies, les expériences d'échec et les conditions d'application s'accumulent grâce à la mémoire à long terme et se transforment en directives d'action réutilisables dans de nouvelles tâches ; les nouveaux résultats de l'exécution contribuent à leur tour à l'actualisation des expériences, à l'amélioration des stratégies de mémorisation et à l'apprentissage continu du modèle de base de la mémoire.
Ce que MemoraX explore, c'est...Une voie d'évolution bidirectionnelle où la mémoire et l'amélioration de soi de l'Agent se renforcent mutuellementD'une part, permettre à la mémoire de fournir une base d'expérience continue et transférable entre différentes tâches pour l'Agent RSI ; d'autre part, permettre à l'exécution et aux retours des tâches réelles de nourrir constamment l'apprentissage et l'évolution de la mémoire elle-même.
Chaque fois qu'une tâche laisse derrière elle de l'expérience et que chaque retour d'information contribue à l'amélioration, les capacités de l'Agent ne se limitent plus à une exécution unique, mais offrent l'opportunité de devenir un processus d'accumulation continue et d'évolution autonome.
L'article provient de "Machine Heart", l'auteur étant "Machine Heart".
Lien de l’article :https://www.airai.cc/fr/ai-news/54/
有用吗?