From Memory to Self-Evolution: A Critical Step in Agent's Journey Towards RSI
Recentemente, os principais laboratórios de IA do mundo têm vindo a divulgar intensivamente uma mensagem:A IA está passando de ajudar os humanos a completar tarefas para participar do próprio desenvolvimento e aprimoramento.
Em setembro, a OpenAI anunciou que havia alcançado os objetivos preliminares da criação de “estagiários de pesquisa em IA automatizados” e planeja desenvolver verdadeiros “pesquisadores em IA automatizados” até março de 2028. Jakub Pachocki, cientista-chefe da OpenAI, publicou um artigo extenso na mesma época, discutindo as perspectivas de desenvolvimento da Recursiva Auto-Melhoria (Recursive Self-Improvement, RSI). Em 21 de setembro, a OpenAI listou a criação de pesquisadores em IA automatizados e a capacidade contínua de aprimoramento da pesquisa e desenvolvimento em IA como as principais direções estratégicas para a próxima fase.
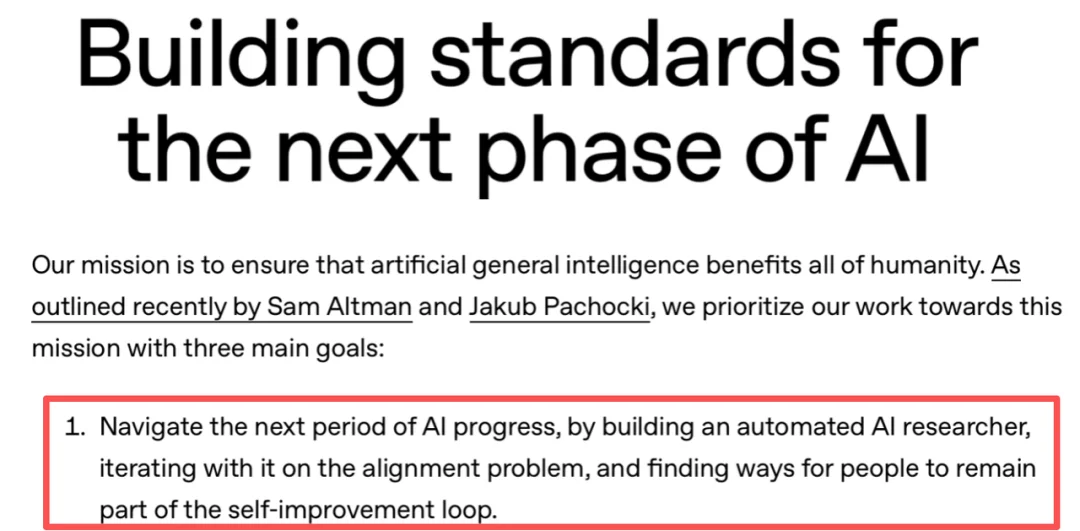
A OpenAI publicou uma declaração estratégica oficial em 21 de setembro de 2026, listando a pesquisa em pesquisadores de IA automatizados e a autoaperfeiçoamento recursivo como objetivos importantes para a próxima fase.
Por outro lado, a Anthropic também publicou um conjunto de dados interessantes: até agosto deste ano, o Claude já havia processado (ou realizado tarefas) em aproximadamente... 26% do trabalho de pesquisa e desenvolvimento de IA interno desempenha um papel de liderança.Cada vez mais tarefas de pesquisa e desenvolvimento que antes eram realizadas por pesquisadores estão sendo executadas por IA sob a supervisão humana.
De OpenAI para Anthropic, o RSI está passando de uma ideia tecnológica distante para um tópico central de pesquisa e desenvolvimento nos principais laboratórios do mundo. A IA não é mais apenas uma ferramenta para resolver problemas externos; ela também começa a participar do desenvolvimento de suas próprias capacidades.
Mas a chave mais importante nesse caminho de evolução contínua é:
Como a IA pode transformar as explorações e tentativas e erros do passado em uma base para o próximo avanço, em vez de começar do zero a cada vez que enfrenta uma nova tarefa?
A memória é a base fundamental que sustenta a contínua autoaperfeiçoação do Agente. Cada exploração não deixa apenas os resultados das tarefas, mas também experiências que podem ser herdadas e reutilizadas por tarefas futuras, proporcionando oportunidades para o aprimoramento das capacidades do Agente. Isso permite que o Agente evolua continuamente através da acumulação contínua de conhecimento.
01 | Da acumulação de experiência à evolução contínua:
Como a memória suporta o RSI
Para que o Agente continue aprimorando suas capacidades durante a execução contínua, é essencial que a experiência adquirida possa ser transferida para além de uma única tarefa:Consolidar métodos eficazes provenientes de explorações anteriores, aplicá-los com precisão em novas tarefas e continuamente aprimorá-los e otimizá-los com base nos resultados da execução. Nesse processo, a gravação da memória e a sua recuperação desempenham dois papéis essenciais e interligados.
Para a gravação da memória, é necessário identificar métodos eficazes, conclusões de falhas e suas condições de aplicação a partir de trajetórias de execução complexas, permitindo que as tarefas passadas deixem experiências reutilizáveis; para a recuperação da memória, é necessário encontrar com precisão os métodos históricos e evidências-chave aplicáveis de acordo com as novas necessidades da tarefa, evitando a omissão de experiências e a migração errônea de informações.
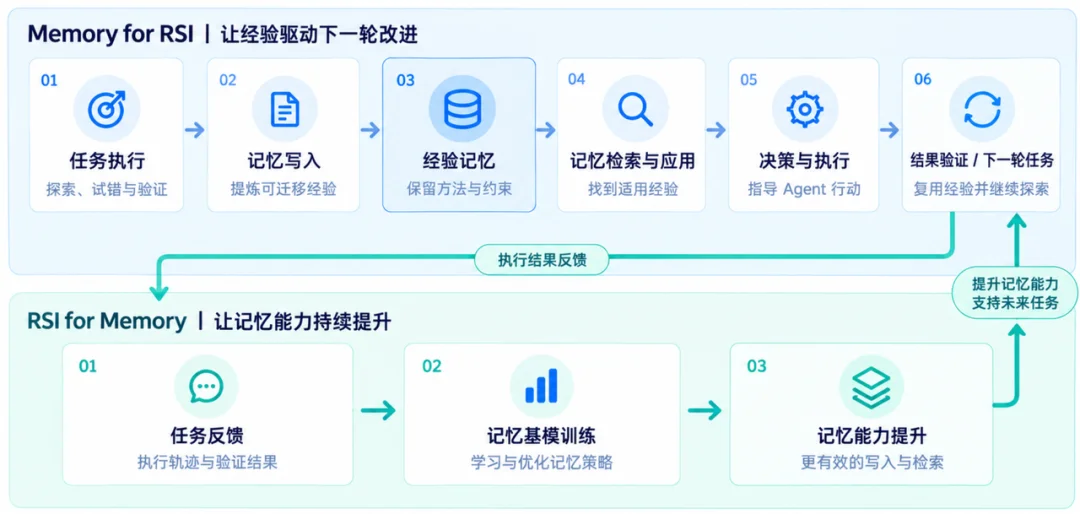
Além disso, o feedback da tarefa também pode ser usado para verificar o valor real da experiência. Ao atualizar continuamente o conteúdo da memória e utilizar o feedback eficaz no treinamento dos modelos de base de memória, é possível promover o aprimoramento da própria capacidade de memória, criando um processo em que a acumulação de experiência e a melhoria do Agente se estimulam mutuamente.
02 | A Aprendizagem e a Evolução da Memória:
Melhore continuamente o Agente com base na sua experiência.
Devido à necessidade de acumular experiência, reutilizar conhecimentos entre tarefas e realizar melhorias contínuas no Agent RSI, a MemoraX construiu um sistema baseado emAprendizado baseado em experiência, migração de conhecimentos adquiridos e otimização através de feedbackUm sistema de capacidade de memória centrado no cérebro humano, que constrói dados de memória de alta qualidade, organiza a memória dinamicamente e a otimiza com base no feedback de tarefas reais, treinando continuamente o modelo básico de memória. Isso permite que o Agente aprenda e melhore suas decisões e ações a partir da experiência histórica.
Aprender com as tarefas: transformar a acumulação de experiência em uma capacidade do modelo que possa ser otimizada
Durante a execução das tarefas do agente, a verificação dos resultados e o ajuste das estratégias geram continuamente novas experiências.Decisões bem-sucedidas fornecem métodos reutilizáveis para tarefas futuras, enquanto conclusões de falhas verificadas ajudam o Agente a eliminar soluções ineficazes e reduzir tentativas e erros repetidos.Mas o valor da experiência muitas vezes só se torna evidente em tarefas futuras. Resumir com precisão o passado não significa necessariamente ser capaz de apoiar com eficácia o futuro. Portanto, o processo de aprendizado baseado na memória não só requer a identificação de experiências que valem a pena ser preservadas, como também a manutenção das evidências de sua validade, das restrições ambientais e das condições de aplicação, a fim de evitar que essas experiências sejam esquecidas ou utilizadas de forma errada. Isso é muito mais complexo do que simplesmente resumir e compactar informações.
Diante desse desafio, a MemoraX Transforme a memória em estratégias aprendíveis projetadas para gerar benefícios em tarefas futuras, construindo continuamente um sistema completo que abrange a criação de ambientes, a coleta de dados, a construção de amostras e o treinamento em RL (Reinforcement Learning) em escala.Em um ambiente de tarefas interativo e verificável, coletamos trajetórias de execução, registros de uso da memória e feedback de verificação para construir amostras de treinamento relacionadas à tomada de decisões e aos efeitos subsequentes do uso; em seguida, combinamos a qualidade de conclusão das tarefas subsequentes, a eficiência de execução e as situações de tentativa e erro repetidas para projetar sinais de recompensa, aprimorando assim a estratégia de gravação na memória. Esse processo amplia os objetivos de otimização do modelo da precisão na extração de informações para outros aspectos.O impacto real da memória na qualidade das tarefas subsequentes, na eficiência de execução e no processo de tentativa e erro repetidoA aprendizagem é mais benéfica para o desenvolvimento de estratégias de gravação de memória para tarefas futuras.
Migração da experiência: Use a experiência passada para orientar novas tarefas
A experiência pode ser preservada, mas isso não significa que ela possa ser diretamente aplicada em novas tarefas. Diante de diferentes objetivos de tarefa, restrições ambientais e fases de execução, o Agente precisa identificar com precisão os métodos históricos que são relevantes, evitando a interferência de informações irrelevantes e a transferência incorreta de experiências.
Para isso, a MemoraX iráDecoupling memory content from access structureAjuste dinamicamente as entradas de acesso à memória e as relações associadas de acordo com a tarefa atual, para que as mesmas informações históricas possam atender a diferentes necessidades de uso.
No nível de busca, avançamos ainda mais.Através do treinamento do modelo, aprende-se a relação de correspondência entre as exigências atuais da tarefa e as evidências-chave históricas.Combinação de evidências de detalhe com a disambiguação de memórias semelhantes para melhorar a capacidade de localização de experiências críticas, distinguindo entre 'relacionado ao tema' e 'evidência correta'.
Durante a fase de uso prático, o MemoraX combina o estado atual da tarefa com o progresso da execução,Transformar a experiência geral acumulada ao longo do tempo em orientações de ação com objetivos claros, restrições operacionais e padrões de verificaçãoE ajusta dinamicamente de acordo com as fases da tarefa, permitindo que a experiência histórica participe efetivamente da tomada de decisões e da execução pelo Agente.
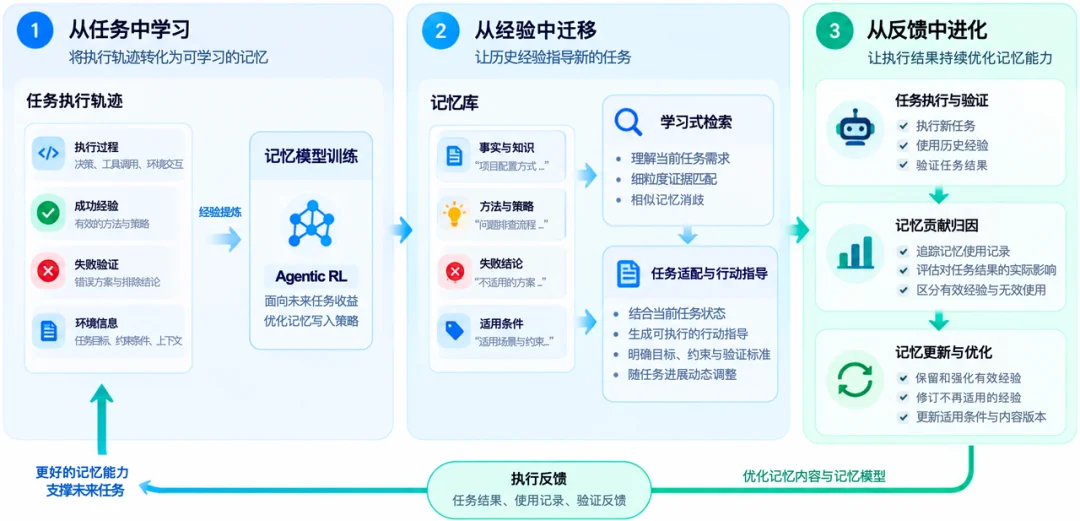
Evoluindo a partir dos feedbacks: Melhorando continuamente a capacidade de memória dos resultados da execução
Durante a iteração contínua do RSI, a experiência histórica nem sempre é válida. Novas tarefas podem tanto verificar os métodos existentes quanto revelar suas limitações.Como utilizar o feedback da execução para julgar o verdadeiro valor da experiência e, com base nisso, aprimorar continuamente a memória, é um aspecto importante da autoaperfeiçoamento contínuo.
O desafio central é Atribuição de Crédito de Memória (Memory Credit Assignment)Tarefas de longo alcance podem invocar várias experiências históricas, mas quais delas realmente afetam a decisão do Agente, e quais são apenas lidas sem exercer nenhum efeito? Mesmo que a tarefa final seja bem-sucedida, como determinar a contribuição real de cada memória ainda é um problema que precisa ser resolvido.
Em torno deste desafio, a MemoraX iráAssocie as versões da memória, os registros de uso real e os feedbacks da execução das tarefasVerificar se a experiência histórica realmente influenciou as ações do Agente, bem como o desempenho da tarefa após o uso e os resultados da validação. Com base nisso, continuar avaliando e iterando as memórias existentes.Assegure-se de que a experiência válida seja preservada e aprimorada, e, com base nos novos feedbacks das tarefas, corrija prontamente as práticas que não sejam mais adequadas.
Esses feedbacks reais também contribuem para...Treinamento contínuo do modelo de base de memóriaForneceu a base de dados e os sinais de otimização, permitindo que a melhoria da memória se estenda da atualização no nível do conteúdo para o aprendizado do modelo de memória sobre o valor da experiência e as estratégias de memorização.
03 | Da acumulação de experiência ao aprimoramento das habilidades:
Práticas de RSI em múltiplos cenários com o MemoraX
Para o Agente RSI, o que é mais importante não é apenas o quão bem um determinado trabalho foi realizado, mas sim...A experiência histórica pode ser continuamente acumulada e aprimorada, e continuar a gerar valor em tarefas futuras.
Durante este processo, foram verificadas as capacidades de iteração contínua da experiência, migração entre tarefas e otimização por meio de feedback em três tipos de tarefas: programação de longo alcance e complexa, análise financeira e raciocínio matemático complexo. Além disso, foi comprovado como a memória contribui para a melhoria da qualidade e eficiência do Agente em tarefas de longo prazo.
(1) Programação complexa de longo alcance: da iteração baseada na experiência ao aprimoramento das capacidades de engenharia
Experimentos de programação complexa de longo alcance são utilizados em áreas como comunicações, finanças e logística. Em 5 grandes setores e 13 tarefas de desenvolvimento de sistemas de nível industrial, foram realizadas um total de 78 execuções de desenvolvimento, com um tempo total de desenvolvimento superior a 300 horas, sendo a duração máxima de uma execução de mais de 12 horas. No final, a taxa de sucesso do plano de aprimoramento da memória MemoraX aumentou em mais de 20%, e o consumo total de tokens pelo principal Coding Agent foi reduzido em mais de 20%.
Da acumulação de experiência à melhoria recursiva: o caminho da autoiteração da memória
Para resolver o problema de que a memória estática tradicional tem dificuldade em acumular e otimizar experiências de forma contínua durante a execução de tarefas, a equipe MemoraX propôsMétodo RSI Orientado ao Modelo de Memória (Memory Model–Driven RSI)Através da colaboração entre um modelo de memória desenvolvido internamente e o sistema de Agentes, o modelo de memória dedicado é responsável por extrair e atualizar a memória procedural a partir das trajetórias de execução dos Agentes e dos feedbacks em tempo real. O sistema de Agentes, por sua vez, aplica essa memória em tarefas reais, criando um ciclo iterativo de extração de experiências, aplicação em tarefas, verificação de resultados e atualização da memória. Isso permite que as experiências eficazes sejam continuamente acumuladas, otimizadas e utilizadas para orientar tarefas futuras. Nos casos de treinamento compostos por tarefas de programação de longo prazo,Após várias iterações de otimização do processo de memorização, a qualidade da memória programática aumentou em mais de 10%.
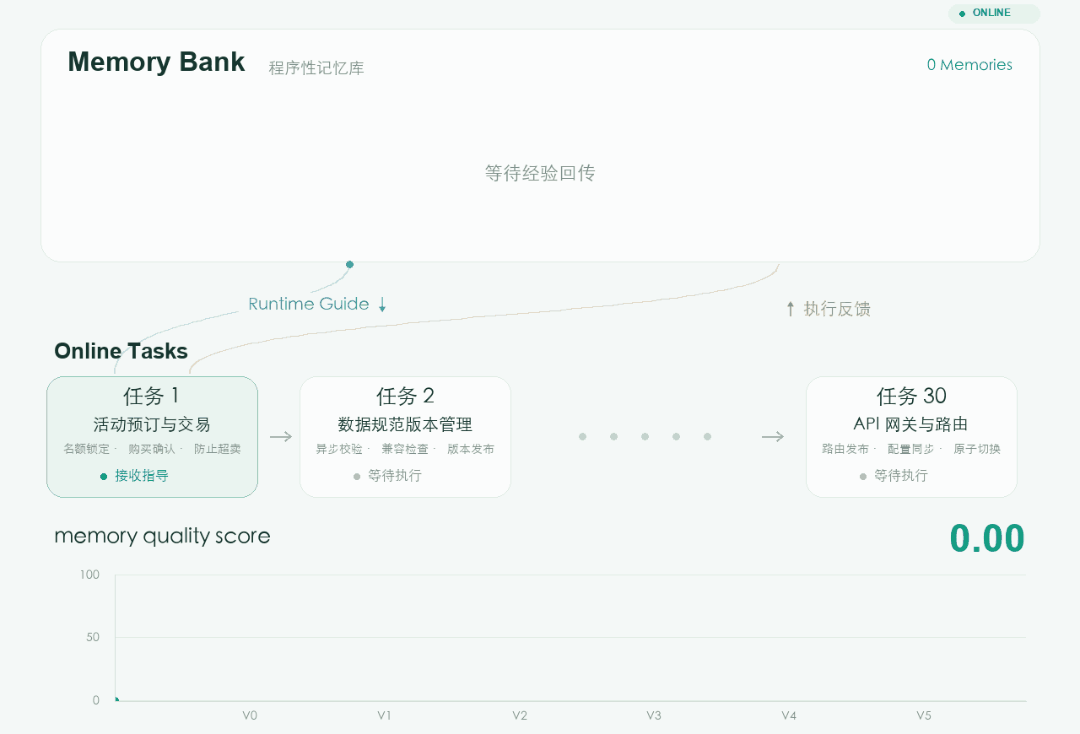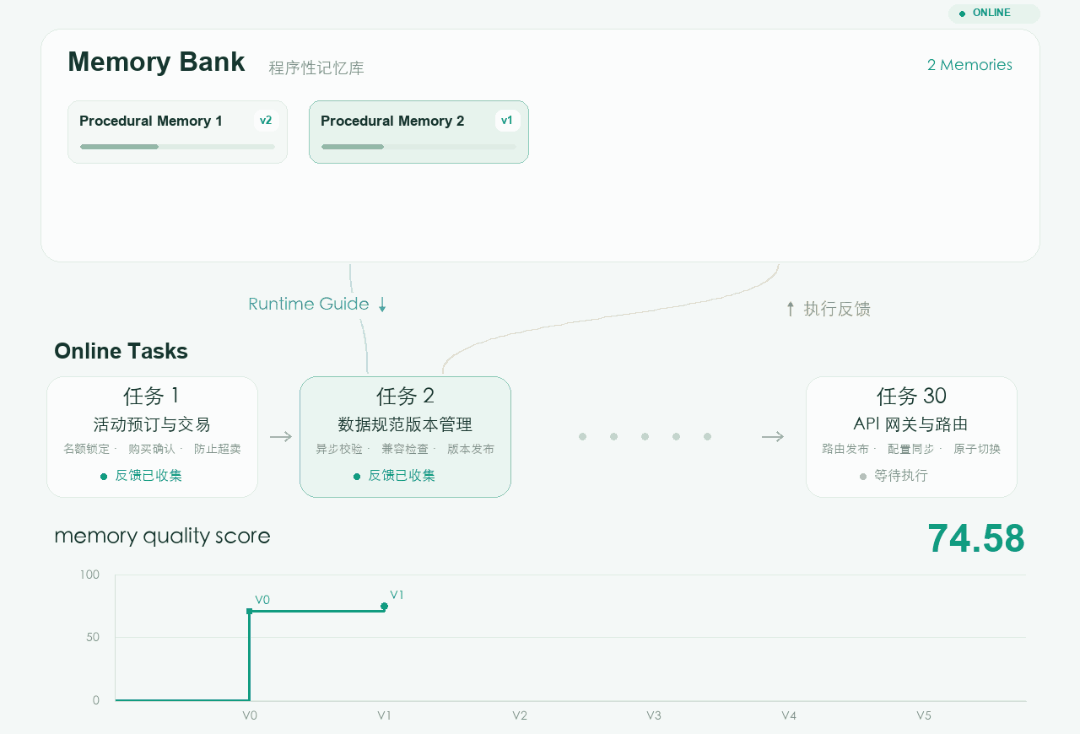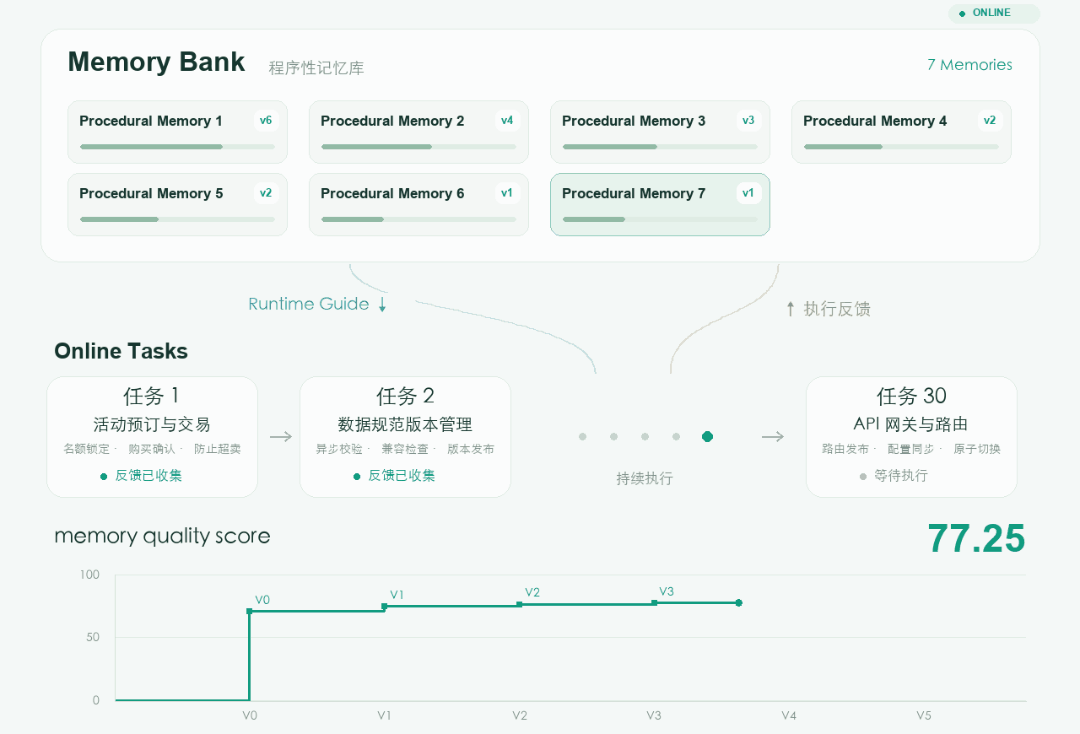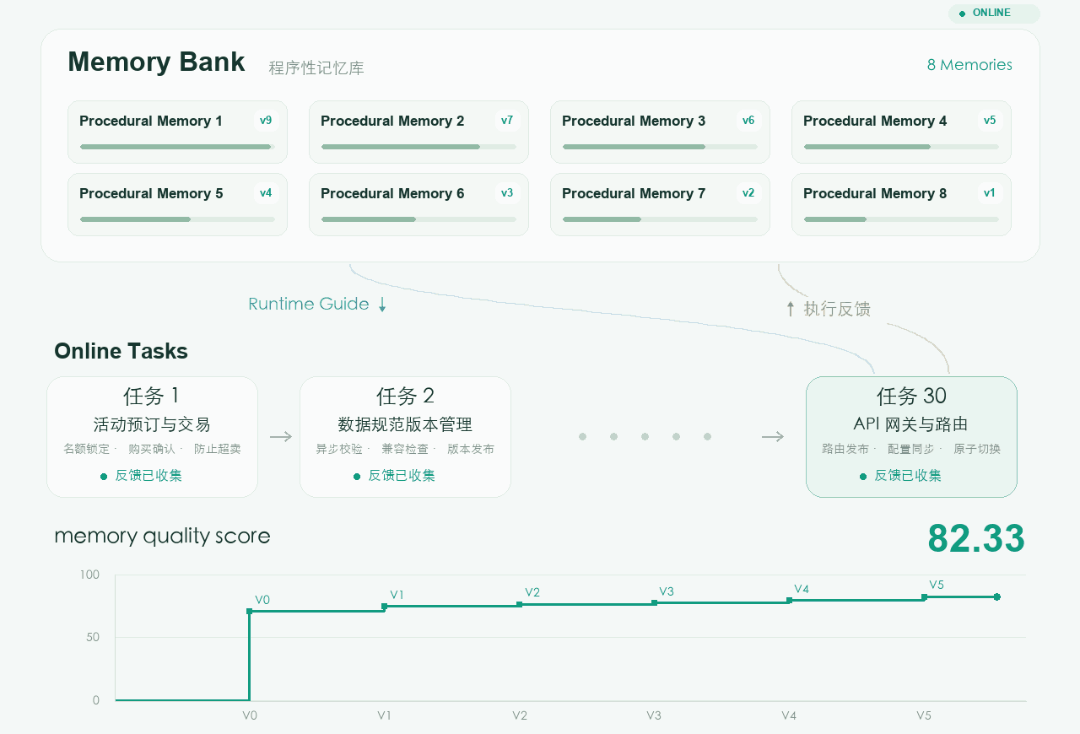
Com a experiência adquirida após várias iterações, enfrentamos o desafio do desenvolvimento de um projeto complexo que exigiu 335 horas de trabalho.
Quanto papel ainda pode desempenhar a experiência acumulada quando se afasta das tarefas de aprendizado originais e se depara com novos desafios de engenharia?
Para isso, utilizaremos a experiência acumulada em novas e complexas tarefas de desenvolvimento de engenharia.Em 13 tarefas complexas de engenharia de software, foram realizadas um total de 78 execuções de desenvolvimento, com um tempo total de desenvolvimento superior a 335 horas, sendo a execução mais longa de 12 horas.Essas tarefas vão muito além de simples modificações de código; elas envolvem desafios reais de engenharia, como lógicas de negócios complexas, dependências entre módulos e um grande número de testes.
Finalmente, a taxa de sucesso aumentou em mais de 20%, e o consumo total de tokens pelo Coding Agent também diminuiu em mais de 20%.
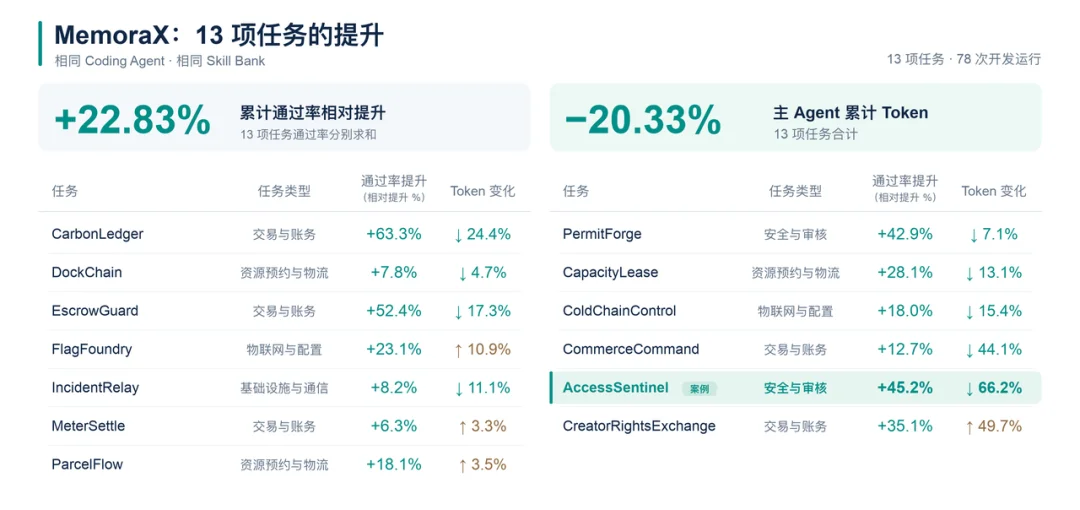
Dentre eles, o AccessSentinel é um caso representativo de alta complexidade. O Agente precisa construir um sistema completo de controle de permissões de nível empresarial e garantir que...Restrições de segurança rigorosas。
Com a ajuda do modelo de memória,A experiência histórica não se limita mais a ser um mero referencial de informações estáticas, mas pode participar continuamente da execução e verificação do Agente à medida que o status da tarefa muda.Desde o 43º minuto após o início do desenvolvimento até 2 horas e 30 minutos, a memória foi registrada em diferentes pontos-chave.Oferecer proativamenteOrientação direcionada:
- Quando os privilégios do dispositivo são revogados,Não só é necessário proibir que o dispositivo faça login novamente, mas também garantir que as contas que já estavam logadas não possam mais acessar o sistema.
- Quando a política de segurança é restaurada para uma versão anterior,É necessário manter os registros históricos, além de evitar que permissões que já foram canceladas sejam restauradas acidentalmente.
- Ao processar pedidos em lote,Primeiro, verifique se todas as solicitações atendem aos requisitos. Somente após a aprovação de todas elas é que a execução pode ser realizada de forma unificada, para evitar situações em que algumas tenham sucesso e outras falhem.
Durante os testes,A taxa média de sucesso após três execuções aumentou em mais de 45%, enquanto o consumo acumulado de tokens pelo principal Agente de Codificação diminuiu em mais de 66%.
(2) Análise Financeira Complexa: Desde a acumulação de evidências até a melhoria contínua e autônoma
A pesquisa financeira requer a formação de julgamentos analíticos completos e confiáveis a partir de uma grande quantidade de materiais dispersos. Além de encontrar os dados relevantes, o Agente também precisa entender com precisão os sujeitos, os períodos de tempo e as definições estatísticas no contexto complexo, estabelecendo conexões entre diferentes evidências para evitar que omissões de informações ou confusão de definições afetem as conclusões finais.
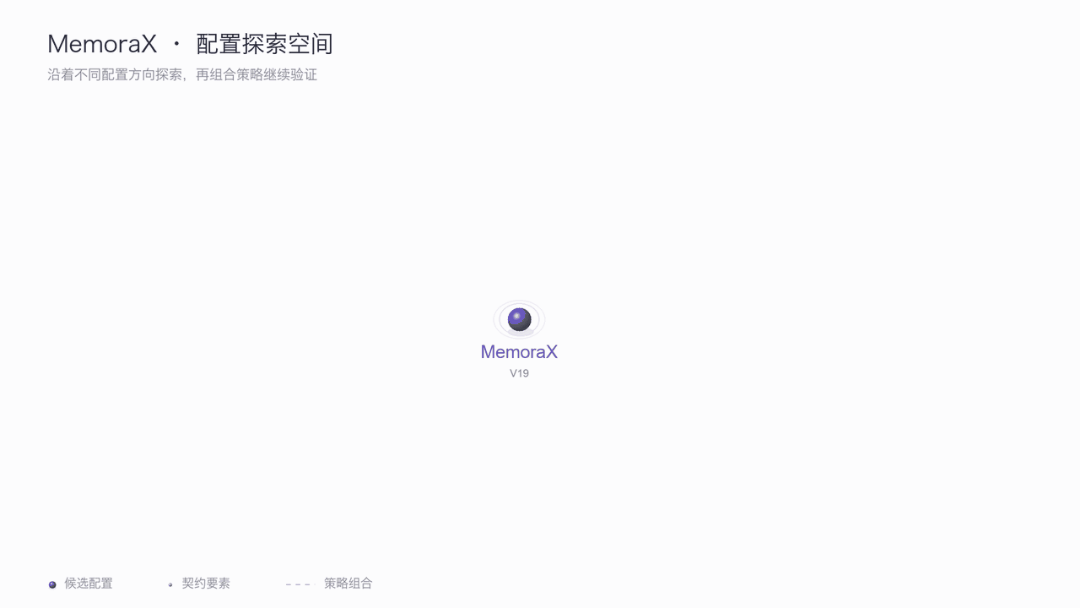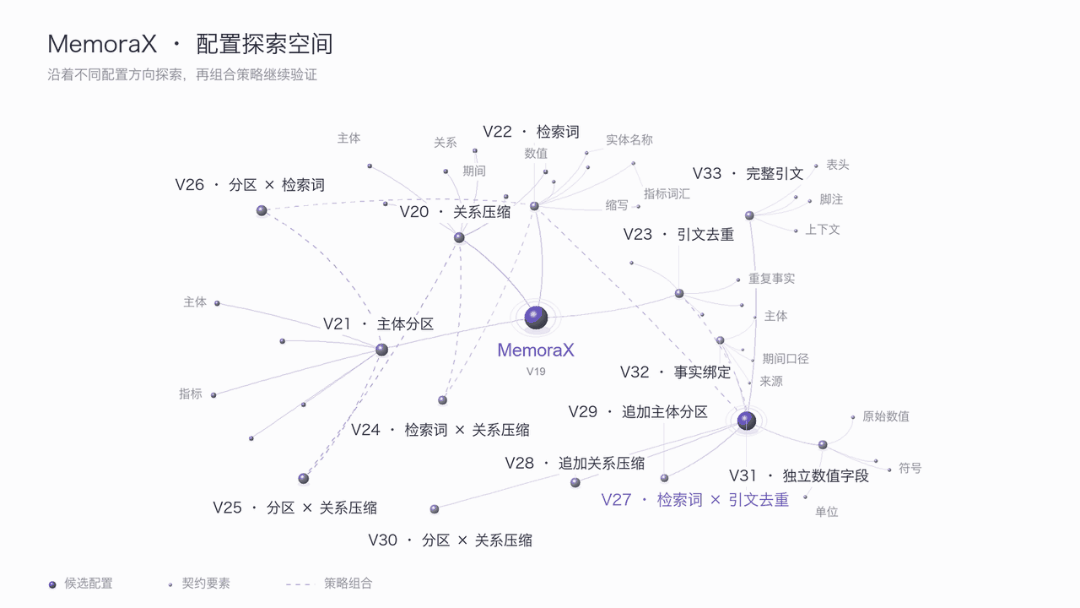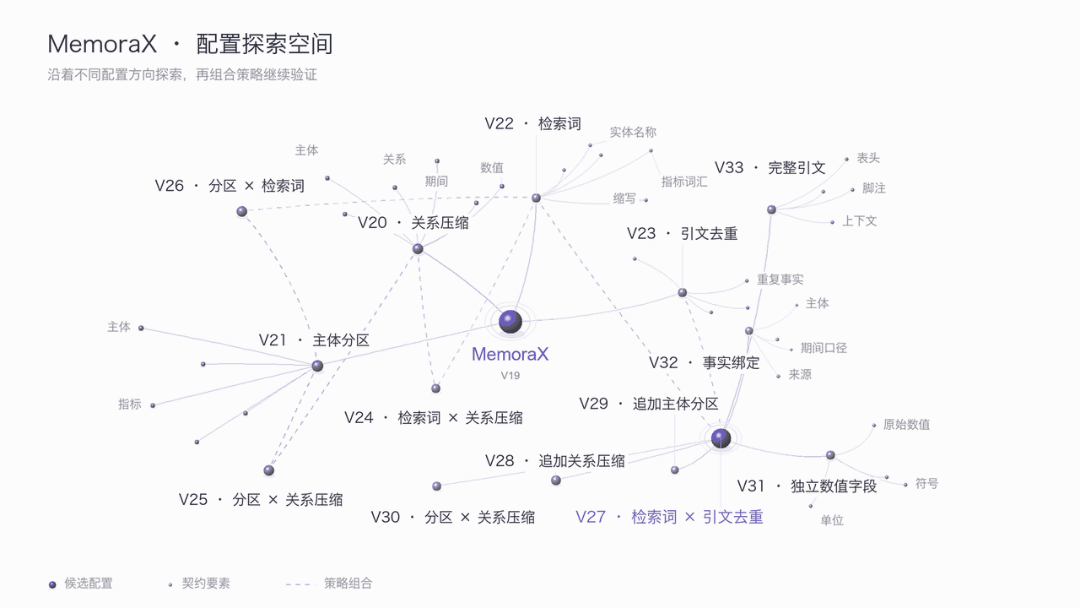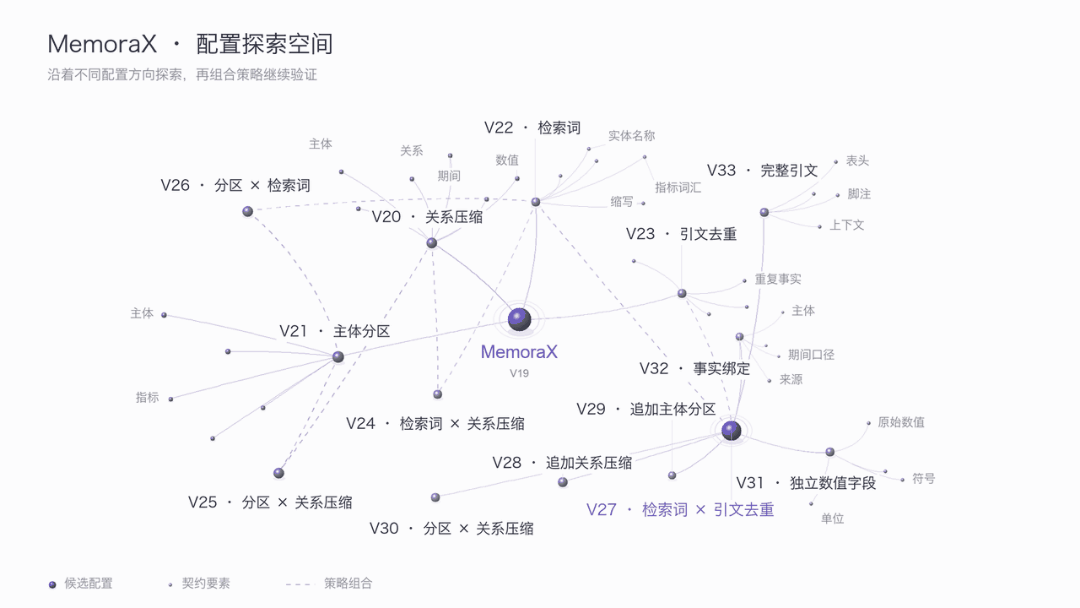
A MemoraX se concentra em dois problemas interligados:Como fazer com que as evidências sustentem uma resposta completa, e como utilizar as perguntas presentes na resposta para, por sua vez, aprimorar os métodos de armazenamento e busca das evidências.Para isso, a MemoraX realizou experimentos com base no padrão de referência autoritário do setor financeiro, o FinRank, que abrange relatórios financeiros reais de 22 empresas listadas nos Estados Unidos em setores como farmacêutico, petróleo e gás, e automóveis, incluindo uma grande quantidade de dados financeiros complexos entre empresas e períodos diferentes. Em torno dessas tarefas, a MemoraX utiliza o feedback das tarefas para otimizar continuamente a organização da memória e a recuperação de informações, formando um ciclo iterativo de “execução — feedback — aprimoramento da memória — execução novamente”. Mais de 30 iterações colaborativas entre modelos de memória e sistemas de análise financeira,finalmenteA taxa de recall da cadeia de evidências é quase de 100%, o que representa um aumento de 20% na precisão da conclusão das tarefas em comparação com o CodeX, e uma redução de custos de quase 98%.
Desde encontrar os dados até organizar evidências que possam sustentar uma decisão
Tomando como exemplo uma tarefa de análise financeira de uma grande empresa manufatureira, as evidências relacionadas à tarefa estão dispersas em um grande número de materiais do setor semelhante, que incluem relatórios financeiros de três anos consecutivos, informações divulgadas por fornecedores e descrições de riscos. É fácil encontrar conteúdo relevante ao tema apenas com base em palavras-chave ou semelhança semântica, mas esse conteúdo pode não pertencer à empresa-alvo ou ao período do relatório; além disso, se apenas resumos forem mantidos, podem ser perdidos os detalhes sobre as unidades de medida dos valores e as condições em que os riscos se aplicam.
Para isso, o MemoraX primeiro converte o material contextual em memória estruturada e, com base no feedback das respostas, ajusta iterativamente a forma como a memória é organizada, visando cenários de perguntas e respostas financeiras, desenvolvendo gradualmente uma abordagem que leve em conta...Precisão numérica, alinhamento dos parâmetros e rastreabilidade da origemRepresentação de saída do modelo de memória; durante a busca, essas evidências são associadas e chamadas com base na questão atual, analisando a situação atual dos estoques, a estrutura de compras e os riscos potenciais. Esse método de organização leva em conta as exigências das tarefas financeiras.Valores precisos, consistência nos métodos utilizados e rastreabilidade das fontesRequisitos do cliente.
A taxa de acerto na conclusão da tarefa final do MemoraX aumentou em comparação com o Codex.Quase 20%Além disso, com base na contagem real do uso do API, o custo desse plano é...Em comparação com a solução de referência do Codex, houve uma redução de quase 98%, o que resultou em uma taxa de aprovação mais alta, além de uma significativa redução nos custos de chamada.
From feedback on responses to strategy iteration: Improving memory through "how to save, how to retrieve"
O MemoraX, com base no feedback das tarefas, continua a explorar maneiras de selecionar e organizar informações de memória em relação a omissões de evidências, confusão de relações e redundância de referências, e acumula conhecimento continuamente durante as tarefas de treinamento.Amostras de interação que relacionam a tomada de decisões de escrita, o conteúdo memorizado e os efeitos subsequentes do uso,Utilizado para otimizar os modelos de memória. Após o treinamento, o modelo participa de uma nova rodada de tarefas, e o feedback da sua execução é novamente utilizado para aprimorar a estratégia de escrita e os treinamentos subsequentes, formando um ciclo de RSI (Reinforcement Learning with Interaction) em que a interação entre tarefas e a otimização do modelo se promovem mutuamente. Nesse processo, o modelo vai se desenvolvendo gradualmente.Características de representação da memória adaptadas a cenários financeirosAssocie os valores-chave com as condições aplicáveis e armazene-os de forma separada, identificando diferentes entidades, períodos de relatório e fontes. Além disso, estabeleça uma correspondência entre os fatos e as evidências originais. Após Iteração do RSI em 36 rodadas,MemoraX A taxa de recall de evidências atingiu 96,49%, e a precisão da tarefa aumentou de 33,33% para 73,33%.
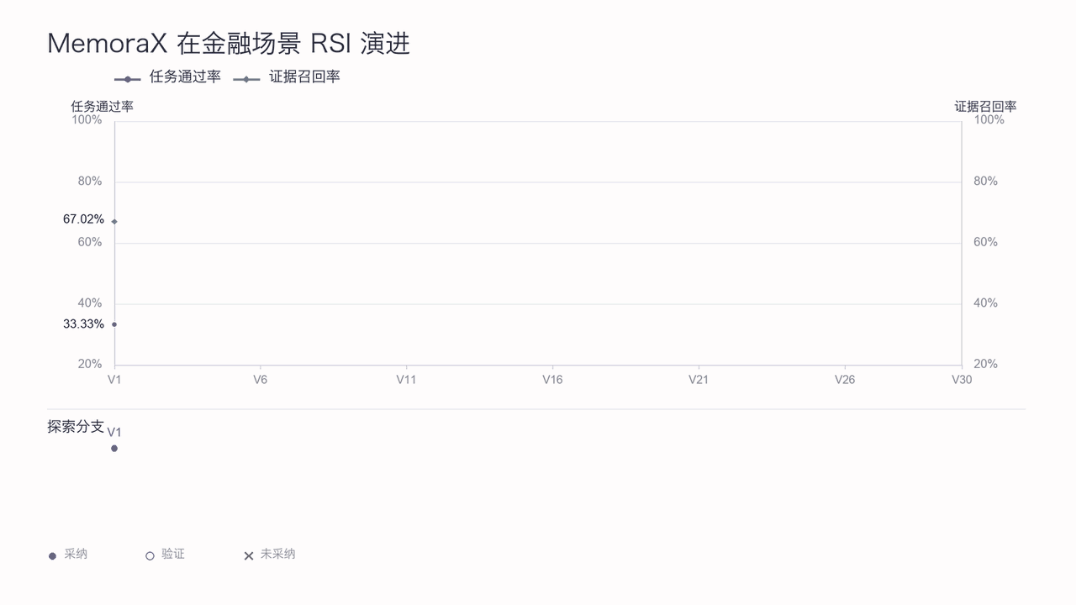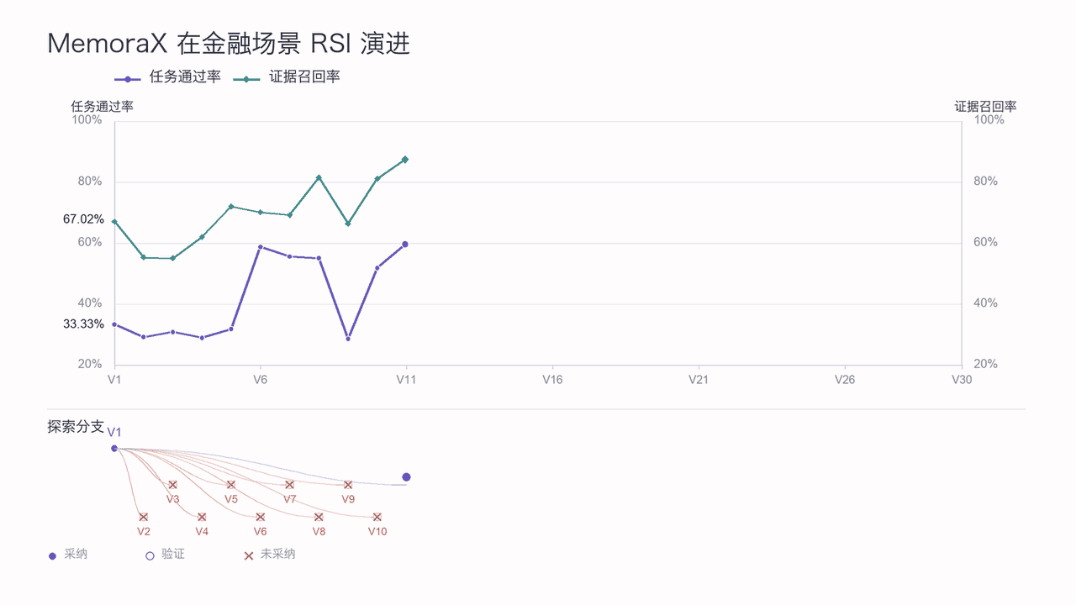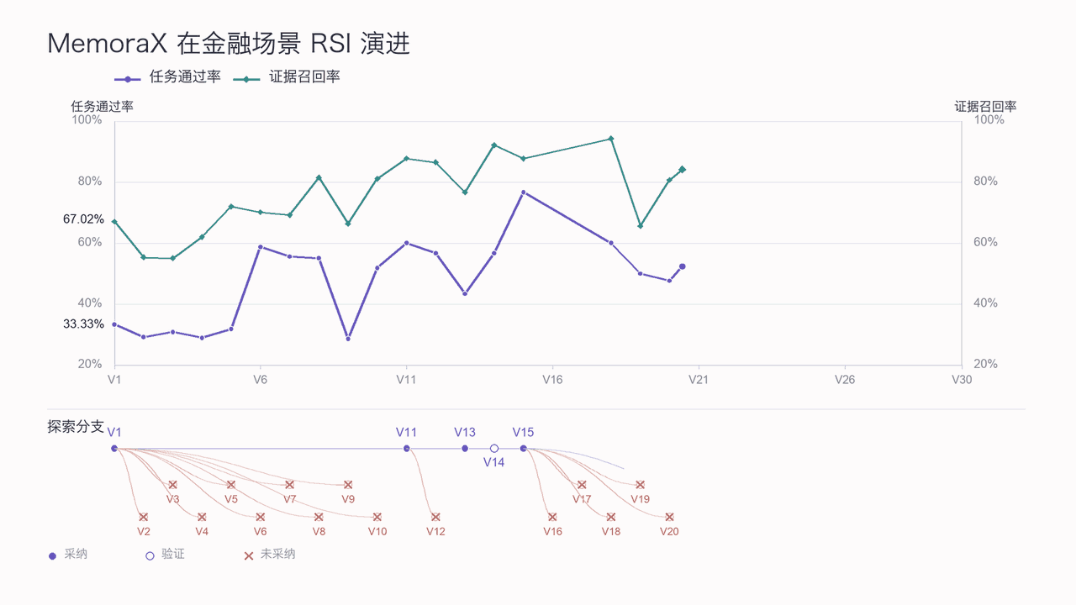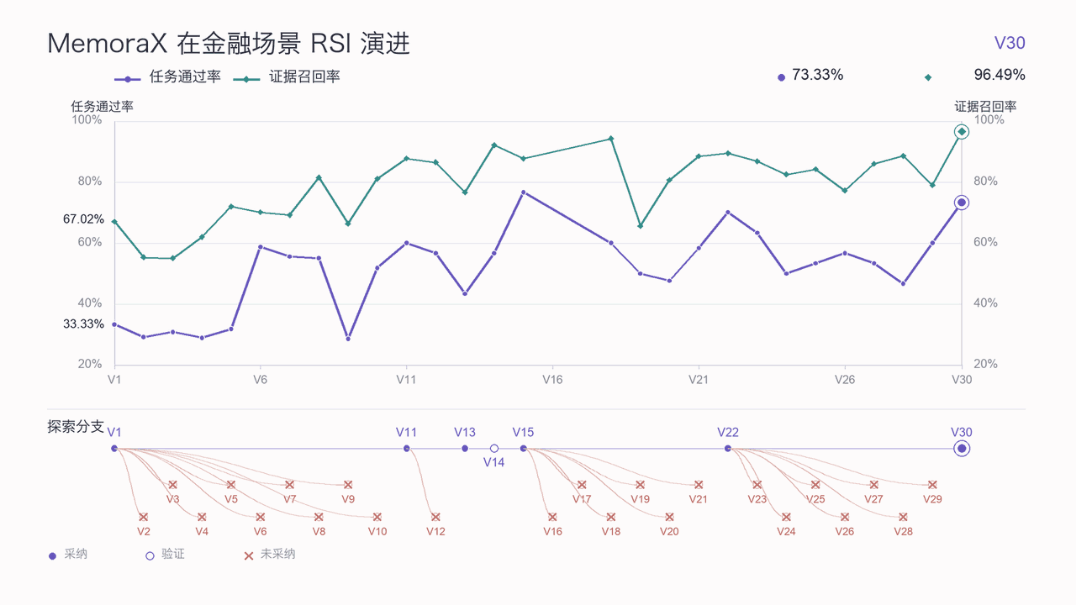
Para pesquisadores que precisam acompanhar relatórios financeiros e anúncios a longo prazo, a memória construída a partir do mesmo conjunto de materiais pode ser utilizada para responder a diferentes questões, diluindo o investimento inicial; os feedbacks obtidos nas análises subsequentes podem, por sua vez, ajudar a aprimorar o conteúdo da memória e as estratégias de uso.Torne as respostas mais completas, torne o uso mais econômico e permita que a experiência seja acumulada continuamente,Juntos, eles constituem o valor prático da MemoraX em tarefas financeiras complexas.
(3) Raciocínio matemático complexo: da retroalimentação experiencial à iteração autônoma das estratégias de resolução
Em experimentos de raciocínio matemático de alta dificuldade, o MemoraX explorou ainda mais o uso de experiências históricas e feedback de validação para apoiar os Agentes a corrigir continuamente seus raciocínios e a otimizar suas estratégias de resolução em problemas complexos. Em problemas de otimização combinada do nível IMO (International Mathematical Olympiad), o Agent conseguiu... 4 horas de resolução contínua, mais de 600 chamadas ao modelo,Finalmente encontramos o que foi verificado. A solução ótima para 21 retângulos. Em comparação com o plano do OpenAI Codex, o tempo de resolução foi reduzido em 13% e o custo foi reduzido em 98%.
From proof of failure to the optimal solution: continuously improving reasoning through feedback
Matilda 16×16 é um problema de otimização combinada de alto nível, na minha opinião: exige que se use o menor número possível de retângulos para cobrir as 240 células de uma grade de 16×16, garantindo que cada linha e cada coluna tenha exatamente uma célula vazia. Somente as posições das células vazias já representam um desafio significativo. 20,9 trilhões de possíveis combinaçõesA dificuldade não reside apenas em encontrar uma solução viável, mas também em provar que não existe uma solução que utilize menos retângulos.
Diante desse desafio, os Agentes colaboraram continuamente na construção de algoritmos de busca, provas formais, modelagem precisa e auditorias independentes. O sistema inicialmente encontrou 27 e 23 candidatos para a construção desejada, mas a argumentação sobre a otimidade global desses 23 candidatos foi rejeitada pela auditoria independente.
O MemoraX consegue acumular continuamente as soluções propostas anteriores, os processos de raciocínio e os feedbacks de validação. O modelo de memória extrai experiências de melhoria eficazes a partir dos caminhos de sucesso e transforma as experiências de fracasso em referências para ajustes futuros nas estratégias de resolução de problemas:
- Correção de erros na memória: de conclusões errôneas à correção da memória. A auditoria independente rejeitou 23 provas de otimidade incorretas, levando o Agente a reavaliar as conclusões anteriores e a utilizar o feedback de verificação de que “uma solução viável não é necessariamente a solução ótima” para corrigir suas memórias, evitando que raciocínios futuros repitam os mesmos erros.
- Otimização automática de estratégias: de atualizações baseadas na memória para melhorias nos métodos. Com base nos candidatos anteriores extraídos do modelo de memória e nas feedbacks de validação, o Agente foi orientado a ajustar o método de modelagem, integrando as restrições de posições vazias e bordas retangulares na busca de soluções. Foram encontrados sucessivamente 22 e 21 soluções mais apropriadas.
- Iteração da memória: da verificação dos resultados à otimização contínua. O Agente realiza uma solução precisa através de uma verificação gradual e da chamada de ferramentas, confirmando finalmente a optimidade da resposta. Em seguida, os novos resultados de validação são enviados de volta ao modelo de memória para aperfeiçoar a construção da memória de solução, fornecendo referências para problemas semelhantes no futuro.
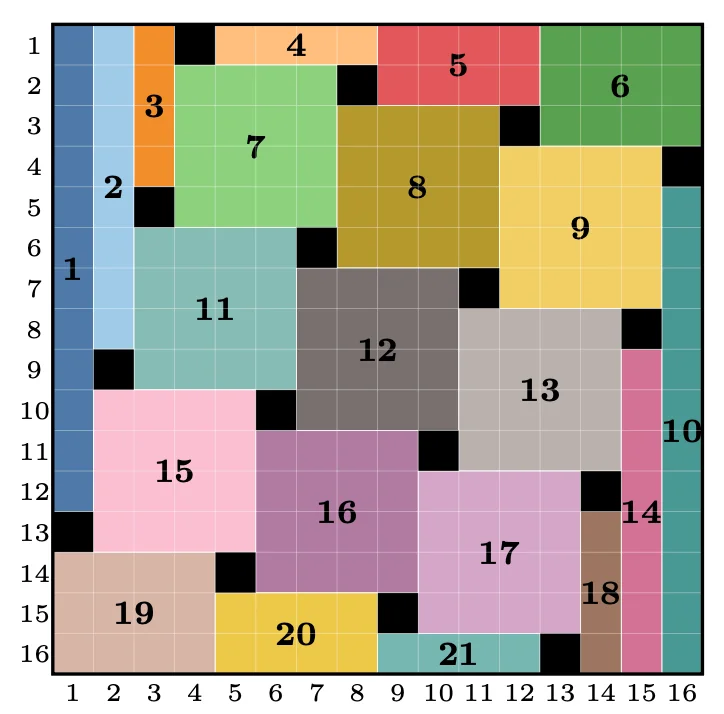
O melhor arranjo de 21 retângulos para o problema Matilda de 16×16. Os quadrados pretos são vazios, e as áreas de cores diferentes representam azulejos retangulares.
Isso demonstra a capacidade contínua de iteração do Agente em tarefas matemáticas complexas:A experiência histórica não é mais apenas um registro de raciocínio estático, mas sim algo que pode ser combinada com novos feedbacks de verificação para continuar a participar do ajuste das estratégias de resolução subsequentes.
Partindo da memória, rumo a um Agente em constante evolução
A MemoraX AI (MemoraX Inteligência Artificial) foi fundada por Hao Jianye, ex-diretor do Laboratório de Decisão e Raciocínio da Huawei, ex-diretor do Laboratório de Algoritmos de Grandes Modelos e especialista principal em decisão inteligente. A empresa se concentra no desenvolvimento da próxima geração de modelos de memória de Agentes que são capazes de aprender e evoluir.
O modelo de memória desenvolvido de forma independente pela equipe, baseado na tecnologia Agentic RL, conquistou o primeiro lugar em listas globais de memória autorizadas e recebeu ampla cobertura e atenção de mídias nacionais e internacionais, como a MIT Technology Review. A solução de memória da equipe foi amplamente implementada em empresas líderes dos setores de programação, saúde, financeiro, segurança e residências inteligentes, e é parceira estratégica da Huawei Cloud e Tencent Cloud.
Atualmente, a equipe está aprofundando ainda mais o RSI baseado em modelos de memória, permitindo que os Agentes passem da acumulação e reutilização de experiências para um aprendizado contínuo e auto-evolução, fortalecendo assim a liderança no campo da memória artificial. Ao mesmo tempo, está acelerando a implementação em várias cenários e promovendo o desenvolvimento padronizado e a comercialização em larga escala dos módulos de memória para produtos de mercado B e C.
Conclusão
A chave do Agente RSI não é apenas fazer com que a IA se comporte melhor em uma única tarefa, mas também...Faça com que cada execução seja a base para a próxima melhoria em habilidades.Métodos de sucesso, experiências de fracasso e condições de aplicação são acumulados através da memória de longo prazo e transformados em orientações de ação reutilizáveis em novas tarefas; os novos resultados da execução, por sua vez, promovem a atualização da experiência, a otimização das estratégias de memória e o aprendizado contínuo dos modelos de base da memória.
O que a MemoraX está explorando é...Um caminho de evolução bidirecional em que a memória e a auto-melhoria do Agente se promovem mutuamentePor um lado, permite que a memória forneça uma base de experiência contínua e transferível entre tarefas para o Agent RSI; por outro lado, a execução e o feedback em tarefas reais contribuem constantemente para o aprendizado e a evolução da própria memória.
Quando cada tarefa deixa experiência para trás e cada feedback impulsiona a melhoria, a capacidade do Agente não se limita mais a uma execução única, mas tem a oportunidade de se tornar um processo contínuo de acumulação e auto-evolução.
O artigo é do "Machine Heart", escrito pelo "Machine Heart".
Link do artigo:https://www.airai.cc/pt/ai-news/54/
有用吗?