Dalla memoria all'auto-evoluzione: Un passo cruciale per l'Agent verso l'RSI
Di recente, i principali laboratori di intelligenza artificiale di tutto il mondo stanno diffondendo intensamente un messaggio:L'AI sta passando dallo aiutare gli esseri umani a completare compiti al partecipare allo sviluppo e al miglioramento di sé stesso.
A settembre, OpenAI ha annunciato di aver raggiunto l’obiettivo preliminare di creare “stagiari di ricerca in AI automatizzati” e di pianificare di sviluppare veri e propri “ricercatori in AI automatizzati” entro marzo 2028. Jakub Pachocki, il principale scienziato di OpenAI, ha pubblicato un articolo in cui discuteva le prospettive di sviluppo dell’auto-miglioramento ricorsivo (Recursive Self-Improvement, RSI). Il 21 settembre, OpenAI ha ulteriormente definito i ricercatori in AI automatizzati e la capacità di miglioramento continuo nel campo della ricerca e dello sviluppo dell’IA come direzioni strategiche fondamentali per la fase successiva.
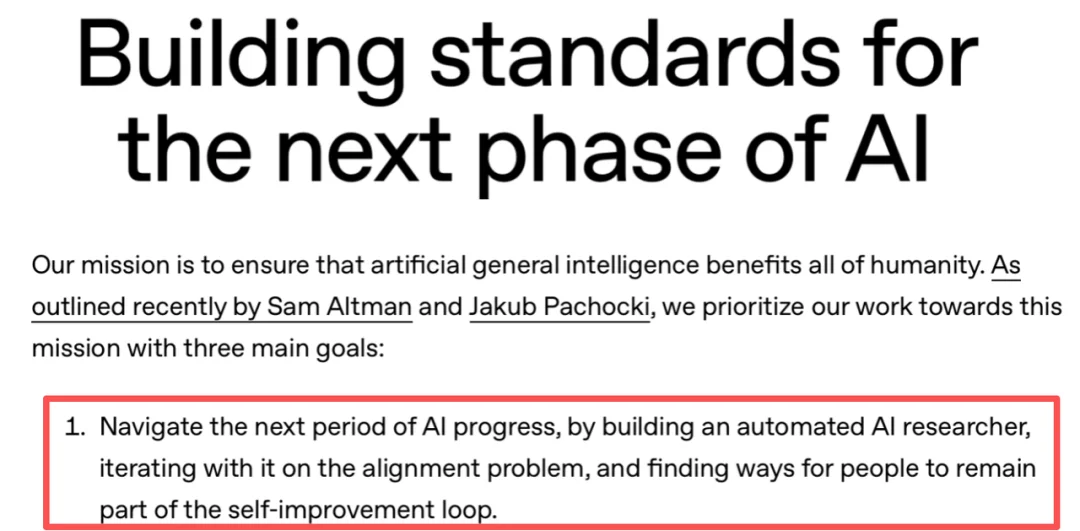
OpenAI ha pubblicato una dichiarazione strategica ufficiale il 21 settembre 2026, in cui ha definito la ricerca su ricercatori AI automatizzati e l’auto-miglioramento ricorsivo come obiettivi importanti per la prossima fase di sviluppo.
Dall'altra parte, Anthropic ha anche pubblicato un insieme di dati interessanti: ad agosto di quest'anno, Claude ha già raggiunto circa... Il 26% del lavoro di ricerca e sviluppo interno nell'ambito dell'intelligenza artificiale svolge un ruolo di guida.Sempre più compiti di ricerca e sviluppo, che in precedenza venivano eseguiti dai ricercatori, stanno ora venendo affidati all'AI sotto la supervisione umana.
Dall'OpenAI all'Anthropic, il RSI sta passando da un'idea tecnologica lontana a un argomento centrale nelle attività di ricerca e sviluppo dei principali laboratori mondiali. L'AI non è più solo uno strumento per risolvere problemi esterni, ma inizia anche a contribuire allo sviluppo delle proprie capacità.
Ma la chiave più importante di questo percorso di continua evoluzione è:
Come può l’AI trasformare le esplorazioni e gli errori del passato in una base concreta per il prossimo passo avanti, invece di dover ricominciare da zero ogni volta che si affronta un nuovo compito?
La memoria è la base fondamentale che sostiene il continuo miglioramento dell'Agent. Lascia che ogni esplorazione non solo porti a risultati concreti, ma anche a esperienze che possono essere ereditate e riutilizzate da missioni successive, offrendo all’Agent la possibilità di migliorare le proprie capacità oltre il contesto di una singola missione e di evolversi attraverso un accumulo continuo.
01 | Dalla raccolta di esperienze all'evoluzione continua:
Come la memoria supporta l’RSI
Per permettere all'Agent di migliorare continuamente le proprie capacità durante l'esecuzione continua, è fondamentale che l'esperienza acquisita possa essere trasferita al di fuori di un singolo compito:Estraiere metodi efficaci dalle esplorazioni passate, applicarli con precisione nelle nuove attività, e continuare a modificare e ottimizzare in base ai risultati ottenuti. In questo contesto, la scrittura nella memoria e il recupero dei dati svolgono due ruoli fondamentali e interconnessi.
La scrittura nella memoria richiede l'identificazione di metodi efficaci, conclusioni di fallimento e le condizioni in cui questi si applicano all'interno di traiettorie di esecuzione complesse, in modo che i compiti del passato lascino davvero esperienze riutilizzabili; la ricerca nella memoria, invece, deve individuare con precisione i metodi storici e le prove chiave appropriati in base alle nuove esigenze del compito, per evitare omissioni di esperienze e trasferimenti errati.
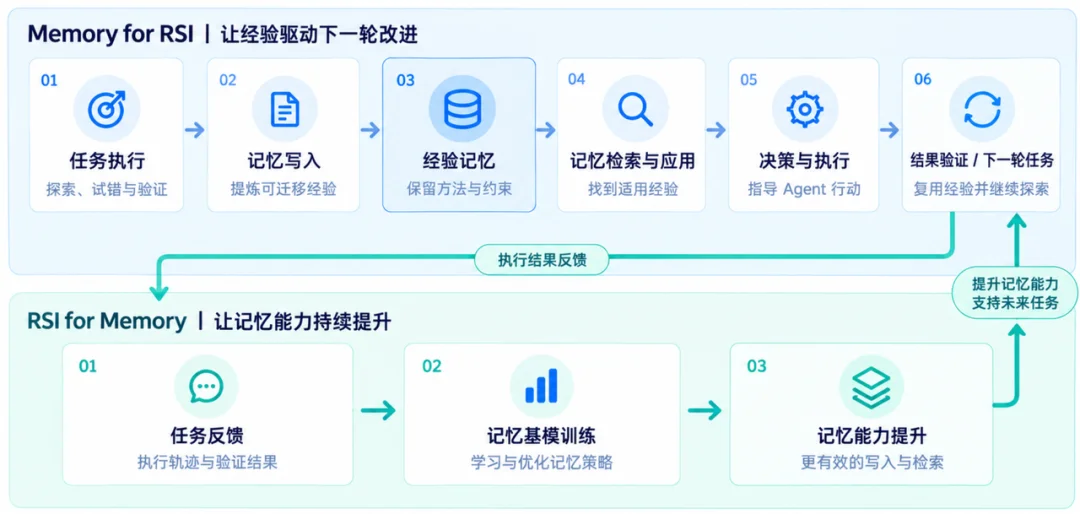
Inoltre, i feedback relativi alle attività possono essere utilizzati per verificare il reale valore dell’esperienza acquisita. Aggiornando costantemente i contenuti della memoria e utilizzando i feedback efficaci per l’addestramento dei modelli di base della memoria, è possibile migliorare le capacità stesse della memoria, creando un processo in cui l’accumulo di esperienza e il miglioramento dell’Agent si promuovono a vicenda.
02 | L'apprendimento e l'evoluzione della memoria:
Migliora continuamente l'Agente attraverso l'esperienza.
In risposta alle esigenze di accumulo di esperienza, riutilizzo tra compiti diversi e miglioramento continuo nell'ambito di Agent RSI, MemoraX ha sviluppato un sistema basato suApprendimento basato sull'esperienza, trasferimento delle conoscenze acquisite e ottimizzazione attraverso i feedbackUn sistema di capacità di memoria incentrato sulle competenze fondamentali, che attraverso la costruzione di dati di memoria di alta qualità, l'organizzazione dinamica della memoria e l'ottimizzazione basata sul feedback di compiti reali, continua ad addestrare il modello di base della memoria, permettendo all'Agent di imparare e migliorare continuamente le proprie decisioni e azioni grazie all'esperienza storica.
Imparare dalle attività: trasformare l'accumulo di esperienza in una capacità del modello ottimizzabile
Durante l'esecuzione dei compiti dell'agente, la verifica dei risultati e l'aggiustamento delle strategie generano continuamente nuove esperienze.Le decisioni corrette forniscono metodi riutilizzabili per le attività successive, mentre le conclusioni negative verificate aiutano l’Agente ad escludere soluzioni inefficaci e ridurre i tentativi falliti.Tuttavia, il valore dell’esperienza spesso si manifesta solo nelle attività successive; riassumere con precisione il passato non significa necessariamente essere in grado di fornire un supporto efficace per il futuro. Pertanto, il processo di apprendimento basato sulla memoria richiede non solo di individuare le esperienze degne di essere conservate, ma anche di salvaguardarne le basi di verifica, i vincoli ambientali e le condizioni di applicabilità, per evitare che vengano trascurate o utilizzate in modo errato. Questo non è affatto un semplice compito di riassunto o compressione delle informazioni.
Di fronte a questa sfida, MemoraX Scrivere la memoria in strategie apprendibili progettate per ottenere benefici futuri, continuando a costruire un sistema completo che copre la creazione dell’ambiente, la raccolta dei dati, la costruzione degli esempi e l’addestramento su larga scala dell’RL Agente.In un ambiente di task interattivo e verificabile, vengono raccolti i tracciati di esecuzione, i registri di utilizzo della memoria e i feedback di verifica per creare campioni di addestramento correlati alle decisioni di scrittura e agli effetti successivi dell’utilizzo; inoltre, tenendo conto della qualità di completamento dei task successivi, dell’efficienza di esecuzione e delle situazioni di tentativi e errori ripetuti, vengono progettati segnali di ricompensa per ottimizzare la strategia di scrittura nella memoria. Questo processo estende l’obiettivo di ottimizzazione del modello dalla semplice accuratezza nell’estrazione delle informazioni a aspetti più complessi.L'impatto reale della memoria sulla qualità delle attività successive, sull'efficienza dell'esecuzione e sul processo di tentativi e errori ripetutiImparare è più vantaggioso per lo sviluppo di strategie di memorizzazione utili per compiti futuri.
Migrare dall'esperienza passata: lasciare che l'esperienza accumulata guidi le nuove attività
L'esperienza può essere conservata, ma questo non significa che possa essere efficace in nuovi compiti. Di fronte a diversi obiettivi di lavoro, vincoli ambientali e fasi di esecuzione, l'Agent deve identificare con precisione i metodi storici applicabili, evitando interferenze da informazioni irrilevanti e trasferimenti errati di esperienza.
Per questo motivo, MemoraX realizzerà...Decoupling memory content from access structureAdatta dinamicamente gli ingressi di accesso alla memoria e le relazioni associate in base alle attuali esigenze del compito, in modo che le stesse informazioni storiche possano soddisfare diversi requisiti di utilizzo.
A livello di ricerca, andiamo oltre…Imparare la relazione di corrispondenza tra le esigenze attuali del compito e le prove chiave storiche attraverso l'addestramento del modelloUtilizzando l'identificazione di prove a livello di dettaglio e la disambiguità dei ricordi simili, si migliora la capacità di localizzazione delle esperienze chiave, distinguendo tra "relativo al tema" e "prove corrette".
Nella fase di utilizzo pratico, MemoraX integra lo stato attuale del compito e i progressi nell’esecuzione,Trasformare l'esperienza accumulata nel corso del tempo in linee guida pratiche che abbiano obiettivi chiari, vincoli operativi e standard di verificaE si adatta dinamicamente alle fasi del compito, permettendo alle esperienze passate di partecipare effettivamente alle decisioni e all'esecuzione dell'Agent.
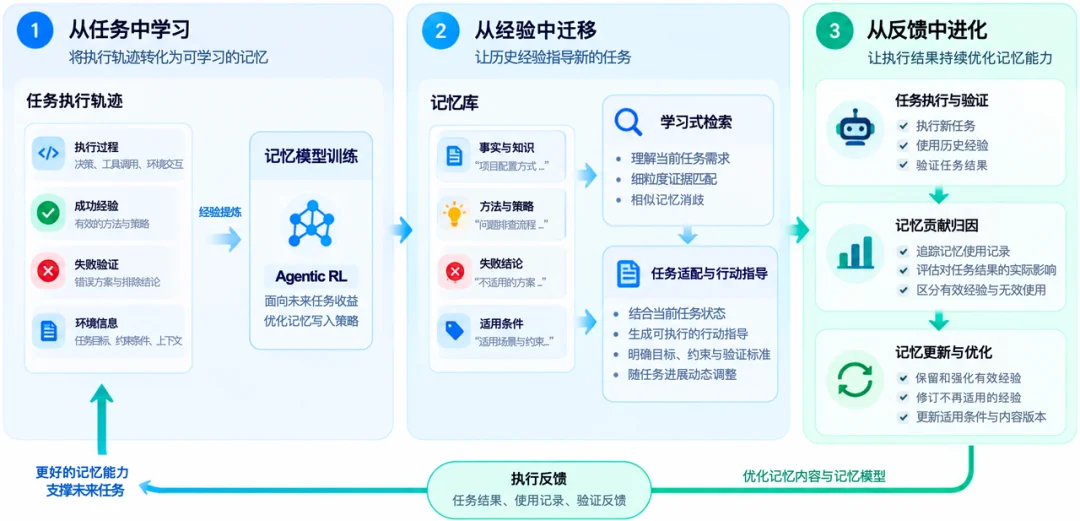
Evoluendo grazie ai feedback: migliorare continuamente le capacità di memoria dei risultati eseguiti
Nelle continue iterazioni dell'RSI, l'esperienza storica non è sempre efficace. I nuovi compiti possono sia confermare i metodi esistenti che rivelarne i limiti.Come utilizzare i feedback ricevuti dall’esecuzione per valutare il vero valore dell’esperienza e, di conseguenza, ottimizzare continuamente la memoria, è un aspetto fondamentale per il miglioramento personale costante.
La sfida principale è Assegnazione dei crediti per il contributo alla memoria (Memory Credit Assignment)Le missioni a lungo termine possono richiamare diverse esperienze storiche, ma quali di queste hanno effettivamente influenzato le decisioni dell’Agente e quali sono state semplicemente lette senza avere alcun impatto? Anche se la missione ha successo, determinare il reale contributo di ciascuna memoria rimane un problema da risolvere.
Riguardo a questa sfida, MemoraX farà...Associazione tra versioni della memoria, registri di utilizzo effettivo e feedback sull'esecuzione dei compitiValutare se l'analisi delle esperienze storiche abbia effettivamente influenzato le azioni dell'Agent, nonché il rendimento delle attività svolte e i risultati delle verifiche successive all'uso di tali informazioni. Sulla base di questo, continuare a valutare e migliorare le memorie esistenti.Conservare e rafforzare le esperienze efficaci, e modificare tempestivamente quelle che non sono più pertinenti in base ai nuovi feedback ricevuti dai compiti.
Questi feedback reali sono anche utili per...Continuo addestramento dei modelli di base sulla memoriaVengono fornite le basi di dati e i segnali di ottimizzazione che consentono di estendere i miglioramenti della memoria da aggiornamenti a livello di contenuto fino all'apprendimento da parte del modello di memoria dei valori esperienziali e delle strategie di memorizzazione.
03 | Dalla raccolta di esperienze al miglioramento delle capacità:
Pratica dell'RSI in diversi scenari con MemoraX
Per l'Agent RSI, ciò che è più importante non è solo il risultato ottenuto in una singola missione, ma...È possibile accumulare e modificare continuamente l'esperienza storica, in modo che possa continuare a generare valore nelle attività successive.
Durante questo processo, sono state verificate le capacità di iterazione continua dell'esperienza, di trasferimento tra compiti diversi e di ottimizzazione attraverso il feedback in tre tipi di attività: programmazione complessa a lungo termine, analisi finanziaria e ragionamento matematico avanzato. Inoltre, è stato ulteriormente dimostrato come la memoria influisca positivamente sulla qualità e sull'efficienza dell'agente nell'esecuzione di compiti di lunga durata.
(1) Programmazione complessa a lungo termine: dall'iterazione basata sull'esperienza al miglioramento delle capacità ingegneristiche
Esperimenti di programmazione complessa a lungo raggio sono utilizzati in settori come le comunicazioni, la finanza e la logistica. In 5 grandi settori industriali, durante lo sviluppo di 13 sistemi di livello industriale, sono state effettuate un totale di 78 esecuzioni di sviluppo, con una durata complessiva di oltre 300 ore, e la durata massima di un singola esecuzione ha superato le 12 ore. Di conseguenza, l'efficacia del piano di potenziamento della memoria MemoraX è aumentata di oltre il 20%, mentre il consumo totale di token da parte dell'agente principale di codifica (Coding Agent) è diminuito di oltre il 20%.
Dalla raccolta di esperienze all'ottimizzazione ricorsiva: il percorso di auto-iterazione della memoria
Per risolvere il problema legato al fatto che la memoria statica tradizionale non sia in grado di accumulare e ottimizzare continuamente esperienze durante l'esecuzione dei compiti, il team MemoraX ha proposto...Metodo RSI basato sul modello di memoria (Memory Model–Driven RSI)Attraverso la collaborazione tra un modello di memoria sviluppato internamente e il sistema Agent, il modello di memoria dedicato è responsabile di estrarre e aggiornare la memoria procedurale dalle tracce di esecuzione dell'Agent e dai feedback in tempo reale, mentre il sistema Agent applica questa memoria alle attività pratiche, creando un ciclo iterativo che include l'elaborazione dell'esperienza, l'applicazione delle attività, la verifica degli effetti e l'aggiornamento della memoria. Questo permette all'esperienza efficace di accumularsi continuamente, di essere ottimizzata e di guidare le attività successive. Nei casi di studio di formazione composti da compiti di programmazione a lungo termine,Dopo molte iterazioni di ottimizzazione della memoria procedurale, la qualità della memoria stessa è migliorata di oltre il 10%.
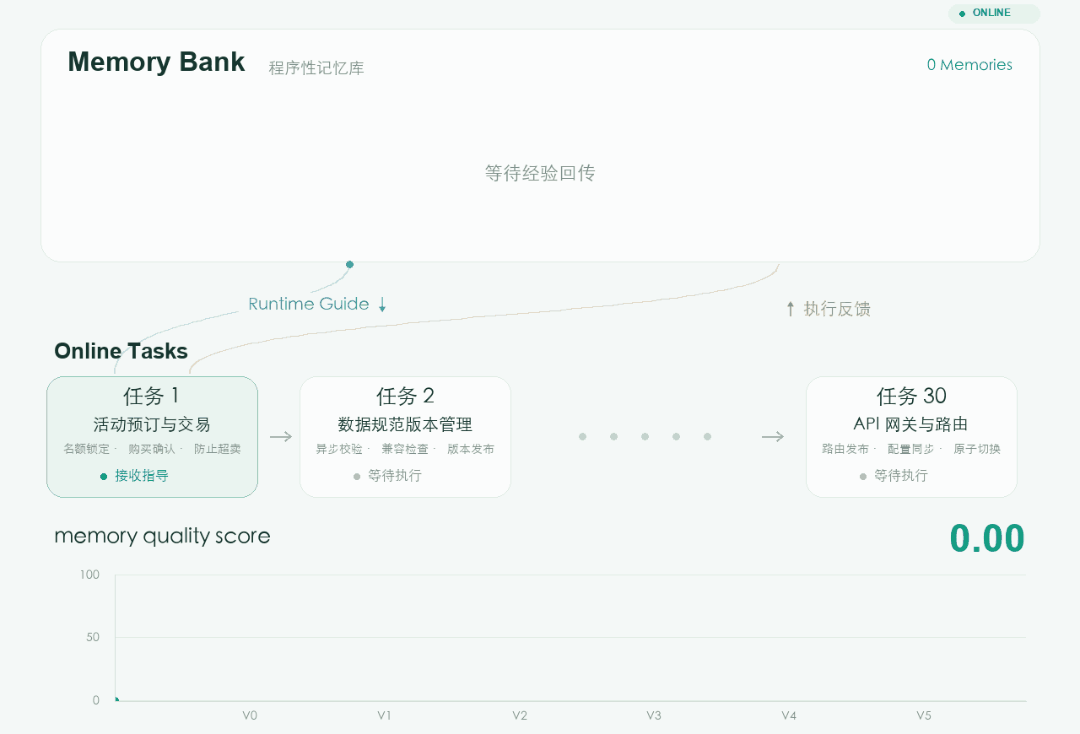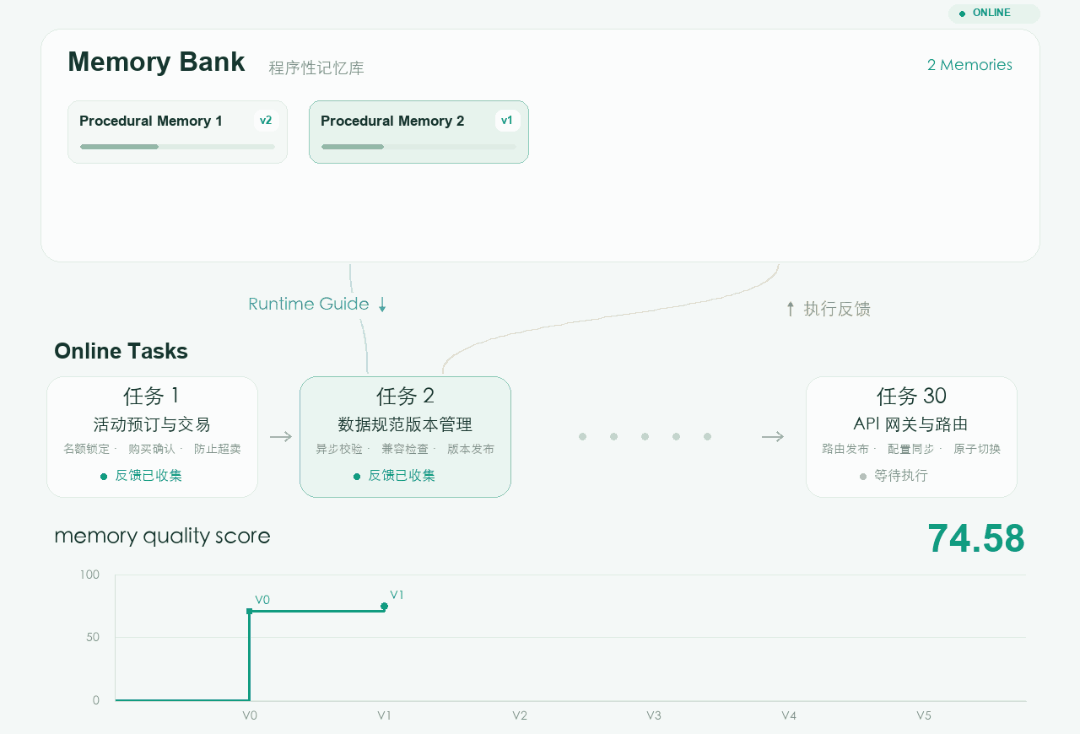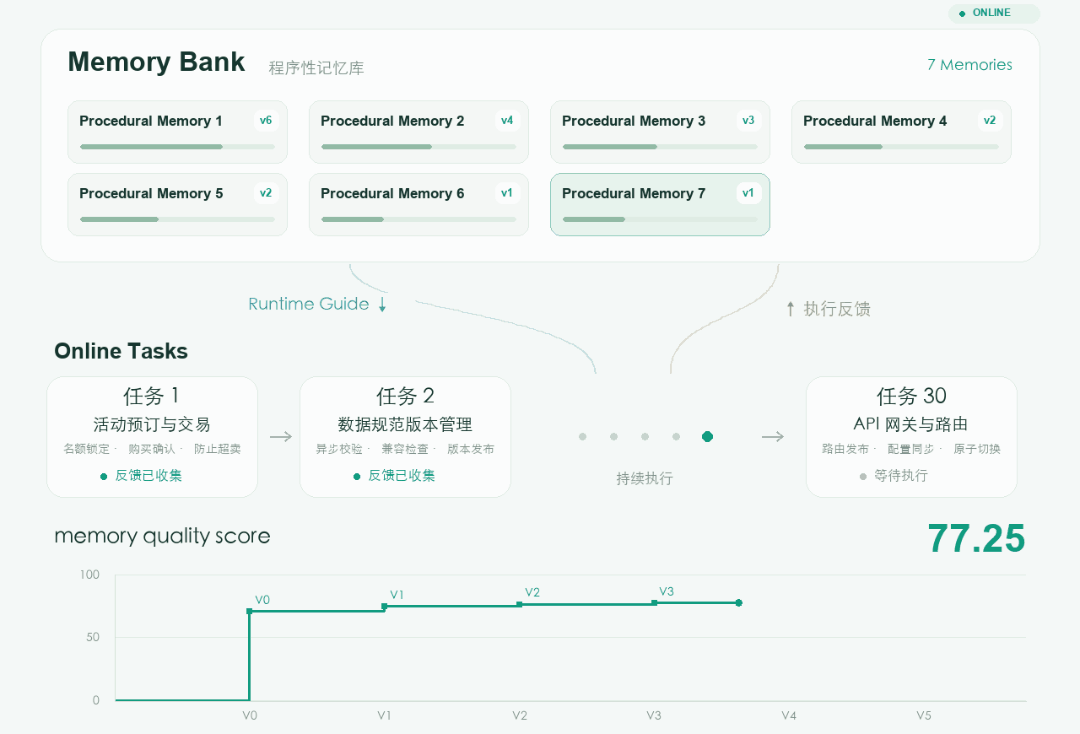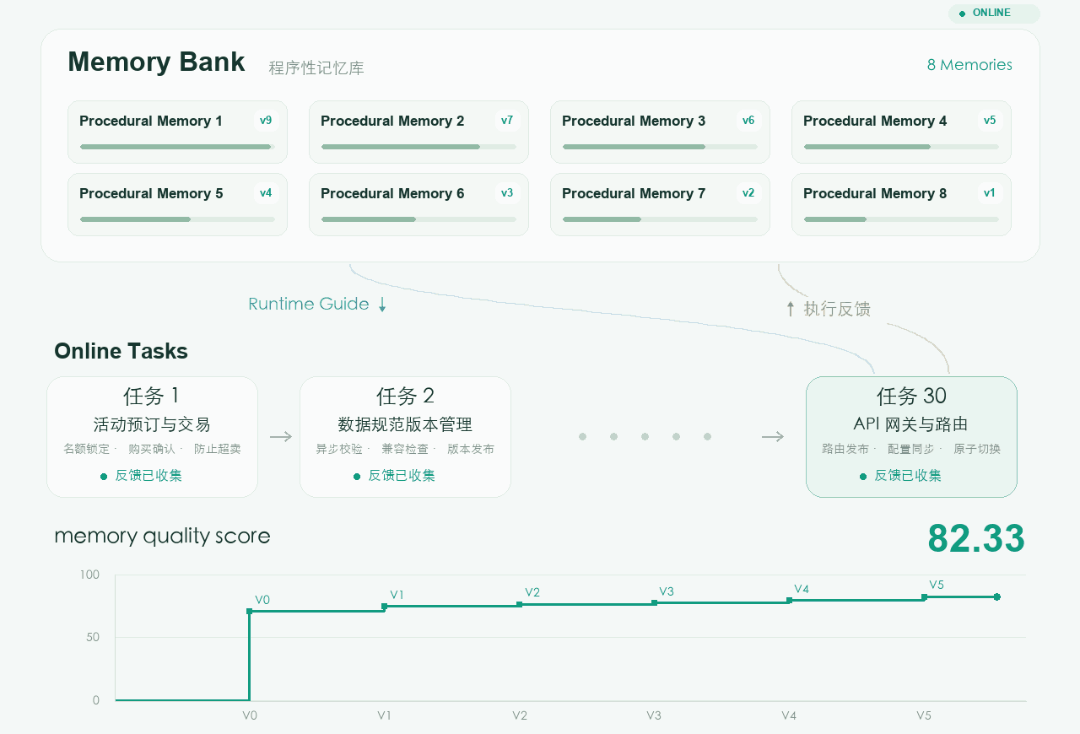
Con l'esperienza acquisita attraverso iterazioni ripetute, affrontiamo lo sviluppo di un progetto complesso che richiede 335 ore di lavoro.
Quanto può essere efficace l'esperienza accumulata quando questa si discosta dalle attività di apprendimento originali e si trova di fronte a nuove sfide ingegneristiche?
Per questo, utilizzare l'esperienza accumulata per nuovi e complessi progetti di sviluppo ingegneristico.In 13 complesse attività di ingegneria software, sono state eseguite un totale di 78 sessioni di sviluppo, con una durata complessiva di oltre 335 ore; la sessione più lunga ha durato più di 12 ore.Questi compiti non sono semplici modifiche di codice, ma rappresentano vere sfide ingegneristiche che coinvolgono logiche aziendali complesse, dipendenze tra moduli e un gran numero di test.
Alla fine, l'efficienza complessiva è aumentata del 20% o più, mentre il consumo totale di token da parte di Coding Agent è diminuito del 20% o più.
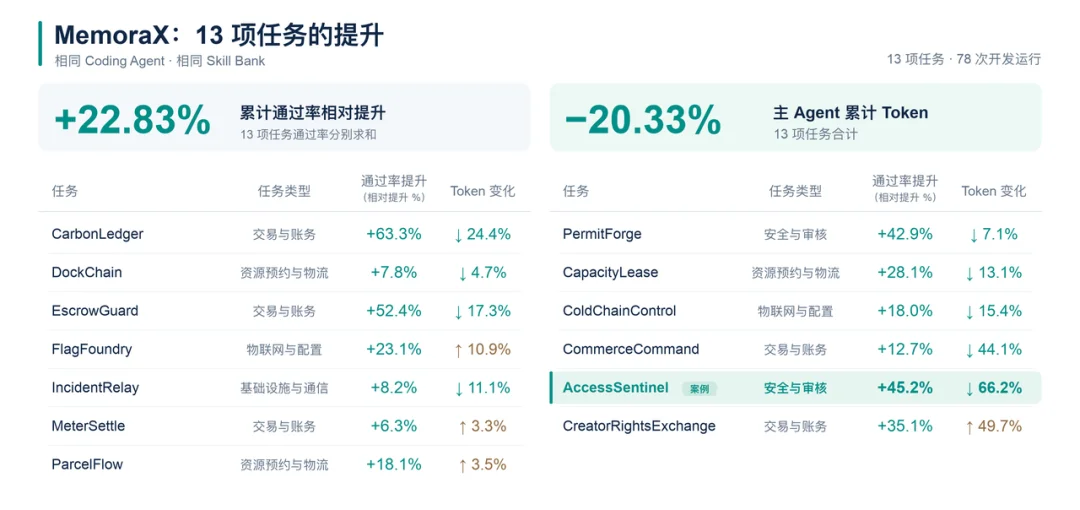
Tra questi, AccessSentinel rappresenta un caso particolarmente complesso e di alto livello di difficoltà. L'agente deve creare un sistema completo di controllo degli accessi a livello aziendale e garantire che...Rigidi vincoli di sicurezza。
Con l’aiuto dei modelli di memoria,L'esperienza storica non si limita più a essere un riferimento informativo statico, ma può partecipare continuamente all'esecuzione e alla verifica dell'Agent in base ai cambiamenti dello stato del compito.Dai 43 minuti dopo l'avvio dello sviluppo fino a 2 ore e 30 minuti dopo, la memoria è stata monitorata in diversi punti chiave.Offrire attivamenteGuida mirata:
- Quando i permessi del dispositivo vengono revocati,Non solo è necessario impedire che i dispositivi accedano di nuovo al sistema, ma anche assicurarsi che gli account che sono già stati connessi non possano più accedervi.
- Quando si ripristina una versione precedente della politica di sicurezza,È necessario mantenere i record storici, al contempo per evitare che i permessi annullati vengano ripristinati accidentalmente.
- Durante l'elaborazione in batch delle richieste,Prima di tutto, verificare se tutte le richieste soddisfano i requisiti; solo dopo aver ottenuto l’approvazione per tutte è possibile procedere all’esecuzione unificata, per evitare situazioni in cui alcune richieste siano accettate e altre no.
Durante i test,Il tasso di successo medio delle tre esecuzioni è aumentato del 45%+, mentre il consumo totale di token dell'agente di codifica principale è diminuito del 66%+.
(2) Analisi finanziaria complessa: dall'accumulo di evidenze al miglioramento continuo e autonomo
La ricerca finanziaria richiede la capacità di formulare giudizi analitici completi e affidabili a partire da un gran numero di materiali dispersi. Oltre a individuare i dati pertinenti, l’Agente deve anche comprendere con precisione i soggetti coinvolti, i tempi e le metodologie statistiche all’interno di contesti complessi, stabilendo collegamenti tra le diverse prove disponibili. Questo è essenziale per evitare che errori di informazione o ambiguità nelle metodologie influenzino le conclusioni finali.
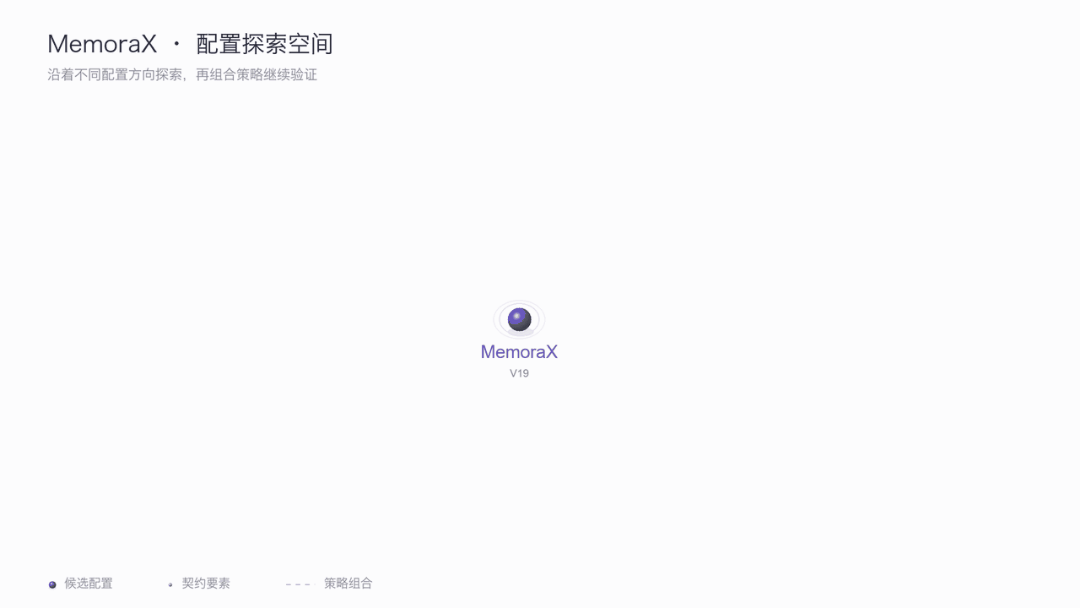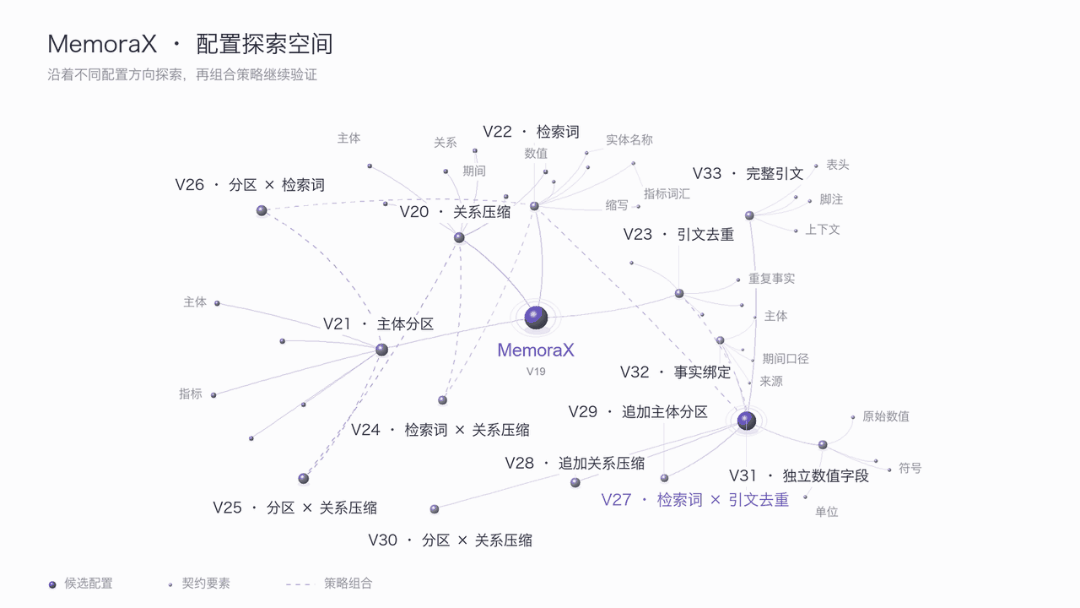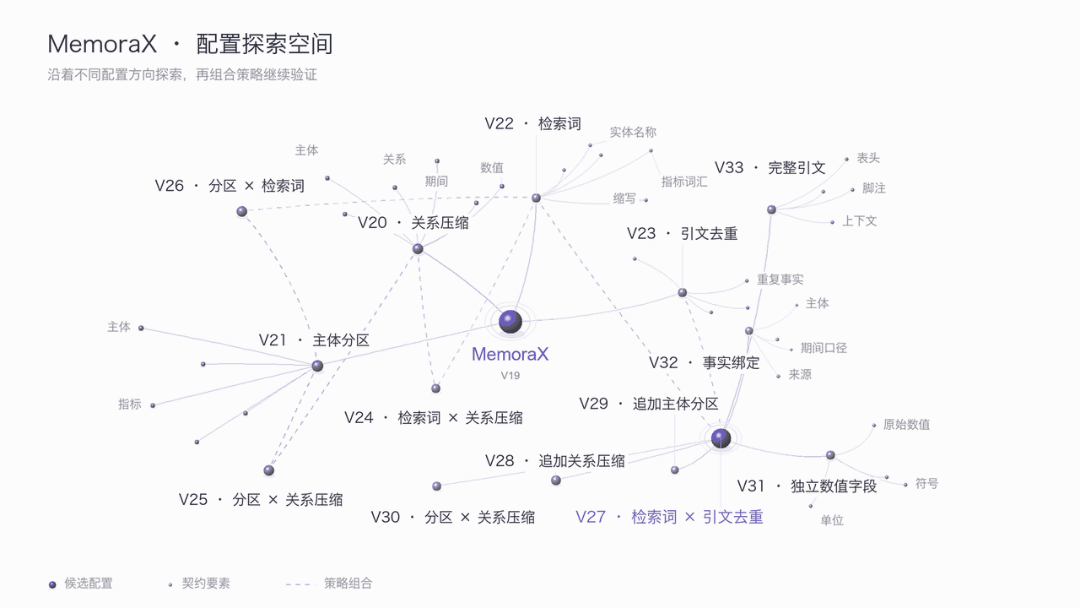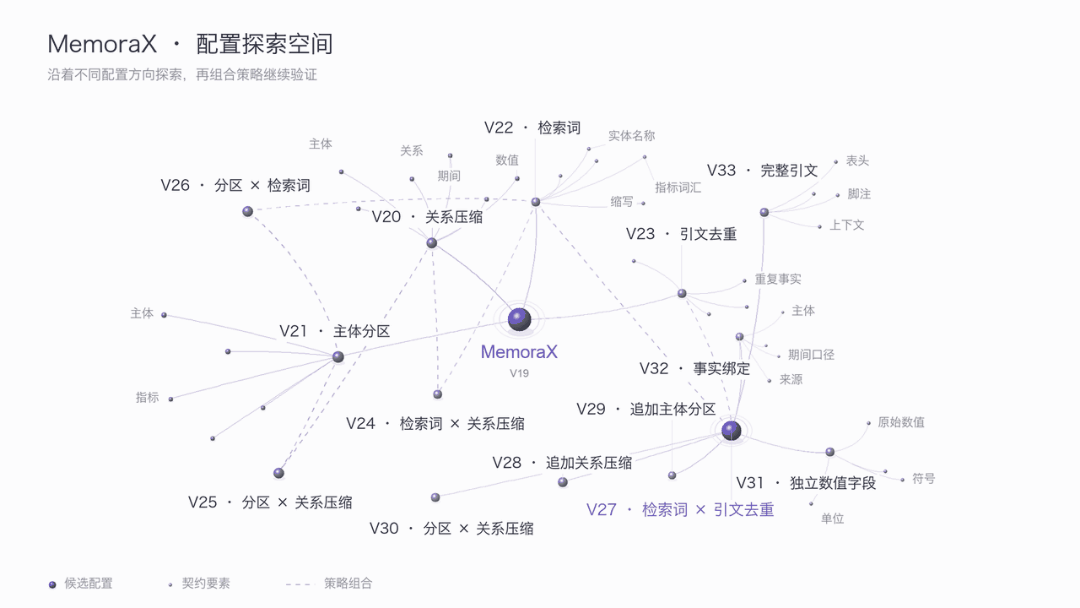
MemoraX si concentra su due problemi strettamente collegati tra loro:Come far sì che le prove sostengano una risposta completa, e come utilizzare le domande presenti nella risposta per migliorare a loro volta i metodi di conservazione e recupero delle prove.Per questo motivo, MemoraX ha condotto esperimenti basati sull'autorevole benchmark finanziario FinRank, che copre i bilanci reali di 22 società quotate in borsa statunitensi nei settori farmaceutico, petrolifero e automobilistico, includendo una grande quantità di dati finanziari complessi che attraversano diverse aziende e periodi temporali. Attorno a queste attività, MemoraX utilizza i feedback ricevuti per ottimizzare continuamente l'organizzazione e la ricerca nella memoria, creando un ciclo iterativo di “esecuzione – feedback – miglioramento della memoria – nuova esecuzione”. Più di 30 iterazioni collaborative tra modelli di memoria e sistemi di analisi finanziariaDopo tutto,Il tasso di richiamo della catena di prove è vicino al 100%, il che rappresenta un aumento dell’accuratezza del 20% rispetto ai compiti CodeX e una riduzione dei costi di quasi il 98%.
Dalla ricerca dei dati alla raccolta di prove utili per supportare una valutazione
Ad esempio, considerando il compito di analisi finanziaria di un'azienda manifatturiera di grandi dimensioni, le prove relative al compito sono distribuite in un gran numero di materiali dello stesso settore che includono i bilanci finanziari per tre anni consecutivi, le informazioni fornite dai fornitori e le descrizioni dei rischi. È facile trovare contenuti correlati al tema, ma che non appartengono all'azienda target o al periodo di riferimento del rapporto, utilizzando solo parole chiave o somiglianze semantiche; tuttavia, se si conservano solo i riassunti, è possibile tralasciare le unità di misura dei valori e le condizioni in cui i rischi si verificano.
In questo contesto, MemoraX converte innanzitutto i materiali di contesto in memoria strutturata e, in base ai feedback ricevuti dalle risposte, aggiusta iterativamente il modo in cui l'informazione è organizzata. Questo processo è rivolto alle scenari di domande e risposte finanziarie, al fine di sviluppare un sistema in grado di tenere conto di diversi aspetti.Valori numerici precisi, allineamento dei parametri e tracciabilità della fonteLa rappresentazione dell’output del modello di memoria; durante la ricerca, questi elementi di prova vengono nuovamente collegati e utilizzati in relazione al problema attuale, analizzando allo stesso tempo lo stato attuale delle scorte, la struttura degli acquisti e i rischi potenziali. Questo approccio organizzativo tiene conto delle esigenze delle attività finanziarie.Valori numerici accurati, criteri di misurazione coerenti e fonti tracciabiliLe richieste del cliente.
La precisione con cui MemoraX ha completato l'ultima attività è migliorata rispetto a quella di Codex.Circa il 20%Inoltre, calcolando il costo in base all'uso effettivo dell'API, questo approccio risulta più economico.Rispetto al piano di controllo Codex, il costo è stato ridotto di quasi il 98%, ottenendo al contempo un tasso di approvazione più elevato.
Dalla feedback delle risposte all'iterazione delle strategie: migliorare la memoria "come conservare, come recuperare"
MemoraX, in base ai feedback ricevuti sulle attività svolte, continua a esplorare i metodi di selezione e organizzazione delle informazioni memorizzate in relazione a omissioni di prove, confusione nelle relazioni e ridondanza nelle citazioni, accumulando costantemente conoscenze durante i processi di addestramento.Esempi di interazione tra la decisione di scrivere informazioni correlate, i contenuti memorizzati e gli effetti successivi dell’utilizzo,Utilizzato per ottimizzare i modelli di memorizzazione. Dopo l'addestramento, il modello partecipa a un nuovo ciclo di compiti, e i feedback ottenuti durante l'esecuzione vengono utilizzati per migliorare le strategie di scrittura e i successivi processi di addestramento, creando un ciclo RSI in cui interazione tra compiti e ottimizzazione del modello si promuovono a vicenda. In questo processo, il modello evolve gradualmente.Caratteristiche di rappresentazione della memoria adattate ai contesti finanziariAssocia i valori chiave alle condizioni applicabili, distingui tra diversi soggetti, periodi di riferimento e fonti, e stabilisci una corrispondenza tra i fatti e le prove originali. Dopo Iterazione del RSI a 36 cicli,MemoraX Il tasso di richiamo delle prove ha raggiunto il 96,49%, mentre l'accuratezza del compito è aumentata dal 33,33% al 73,33%.
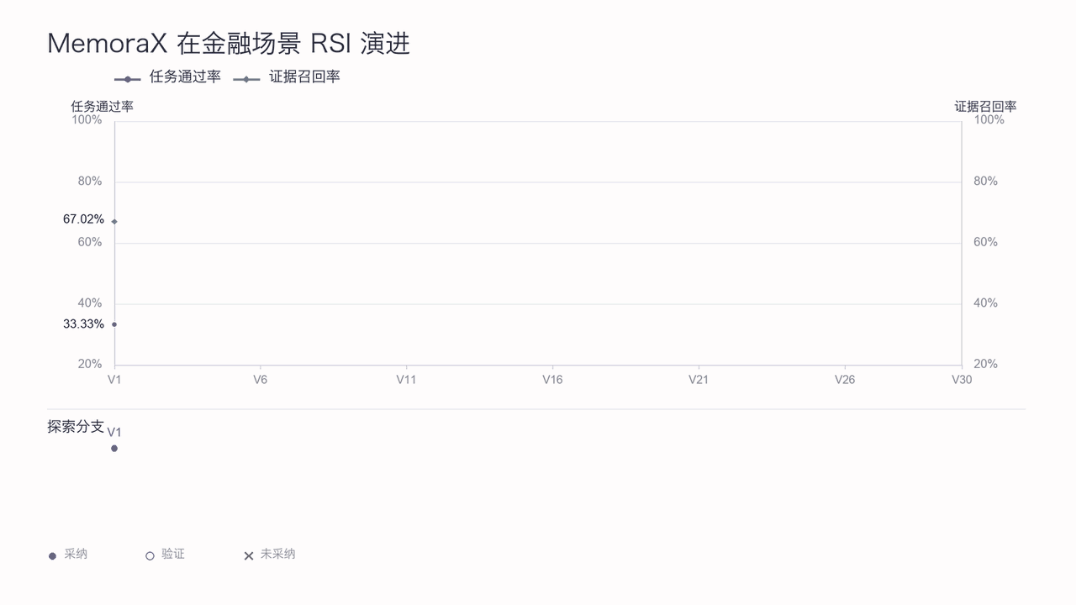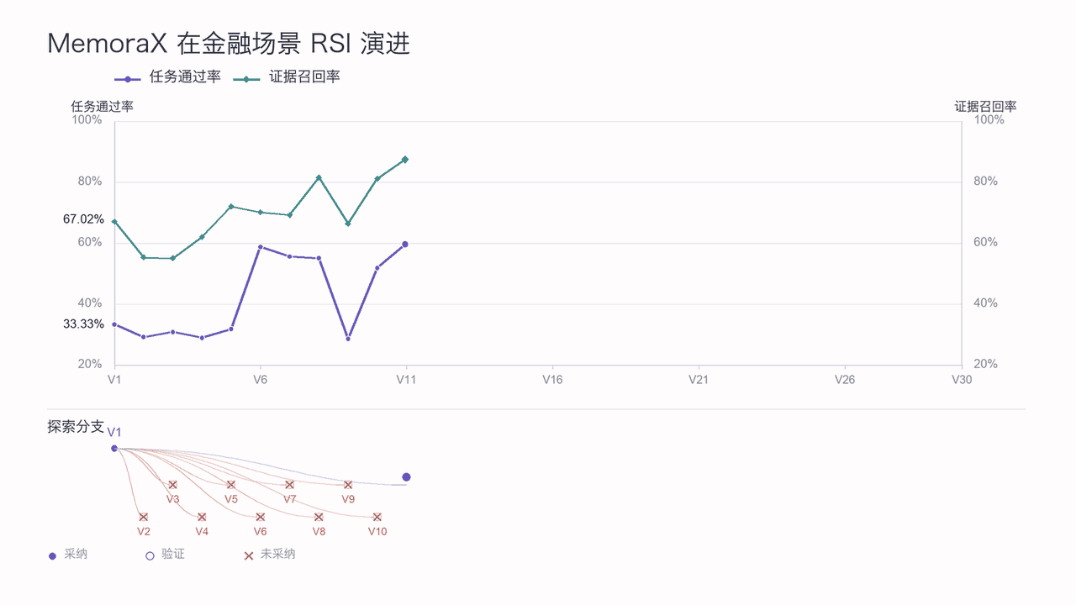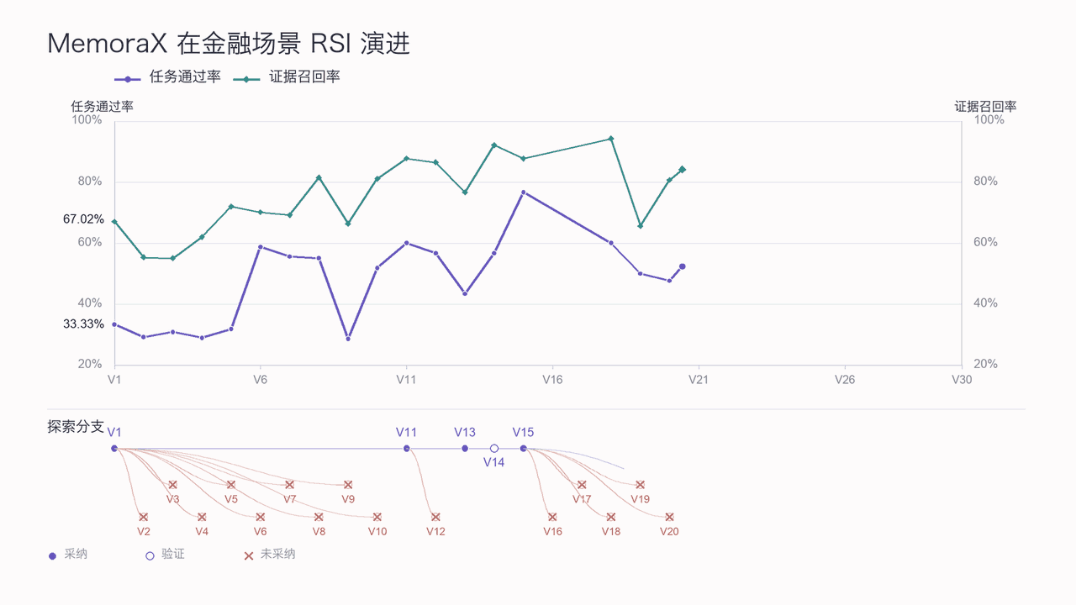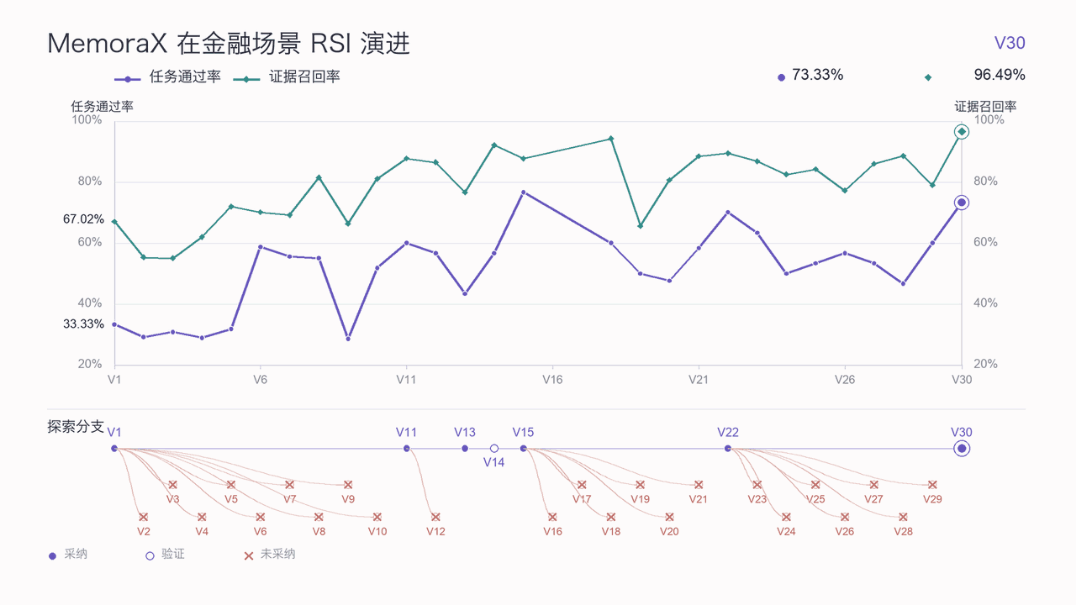
Per i ricercatori che hanno bisogno di monitorare a lungo termine i rapporti finanziari e gli annunci aziendali, le informazioni memorizzate da un gruppo di materiali simili possono essere utilizzate per rispondere a diverse domande, riducendo così gli investimenti iniziali; inoltre, i feedback ottenuti dalle analisi successive possono aiutare a modificare ulteriormente il contenuto della memoria e le strategie di utilizzo.Rendere le risposte più complete, rendere l'uso più economico e permettere all'esperienza di accumularsi continuamente,Condividono insieme il valore pratico di MemoraX nelle complesse attività finanziarie.
(3) Ragionamento matematico complesso: dall'feedback empirico all'iterazione autonoma delle strategie di risoluzione
Nell’ambito di esperimenti di ragionamento matematico di alta difficoltà, MemoraX ha ulteriormente esplorato l’utilizzo di esperienze storiche e feedback di verifica per supportare l’agente nella correzione continua del ragionamento e nell’ottimizzazione delle strategie di risoluzione di problemi complessi. Nei problemi di ottimizzazione combinata di livello IMO (International Mathematical Olympiad), l’agente, dopo aver ricevuto tali informazioni, è stato in grado di... 4 ore di soluzione continua, oltre 600 chiamate al modello,Finalmente è stato trovato quello verificato. La soluzione ottimale per 21 rettangoli. Rispetto al piano OpenAI Codex, il tempo di risoluzione è stato ridotto del 13% e i costi del 98%.
Dalla prova del fallimento all'ottimo soluzione: migliorare continuamente il ragionamento attraverso il feedback
Matilda 16×16 è un problema di ottimizzazione complessa di livello IMO: richiede di utilizzare il minor numero possibile di rettangoli per coprire 240 caselle all’interno di una griglia 16×16, assicurando che ogni riga e ogni colonna lasci esattamente una casella vuota. Solo le posizioni delle caselle vuote rappresentano un elemento di complessità significativo nel problema. 20,9 trilioni di possibili combinazioniLa difficoltà non risiede solo nel trovare una soluzione fattibile, ma anche nel dimostrare che non esista un piano che utilizza un numero minore di rettangoli.
Di fronte a questa sfida, l'Agent ha collaborato continuamente nella costruzione di algoritmi di ricerca, nella dimostrazione formale, nella modellazione precisa e nell'audit indipendente. Il sistema ha inizialmente trovato 27 e 23 candidati per la costruzione, ma l'argomentazione riguardante l'ottimalità globale di questi 23 candidati è stata respinta dall'audit indipendente.
MemoraX è in grado di accumulare continuamente i precedenti candidati a soluzioni, i processi di ragionamento e i feedback di verifica; i modelli di memoria estraggono esperienze di miglioramento efficaci dai percorsi di successo, trasformando gli errori in riferimenti per l’adattamento delle strategie di risoluzione in seguito:
- Correzione degli errori nella memoria: dal ragionamento errato alla correzione dei ricordi. L'audit indipendente ha respinto 23 prove di ottimalità errate, spingendo l'Agent a riconsiderare le conclusioni preesistenti e ad utilizzare i feedback di verifica che indicano come "una soluzione fattibile non sia necessariamente l'ottimale" per correggere i propri ricordi, al fine di evitare che le successive inferenze ripetano gli stessi errori.
- Optimizzazione automatica delle strategie: dal rinnovo della memoria all' miglioramento dei metodi. Basandosi sui candidati precedenti elaborati dal modello basato sulla memoria e sulle feedback di verifica, si guida l'Agent ad adattare il metodo di modellazione per includere sia le posizioni vuote che i vincoli dei bordi rettangolari nell'algoritmo di ricerca. Sono stati trovati rispettivamente 22 e 21 soluzioni migliori.
- Iterazione della memoria: dalla verifica dei risultati all’ottimizzazione continua. L'agente effettua un'analisi graduale e utilizza strumenti di chiamata per ottenere una soluzione precisa, confermando infine l'ottimalità della risposta. I nuovi risultati di verifica vengono poi utilizzati per migliorare la struttura della memoria di risoluzione, fornendo un riferimento per problemi simili in futuro.
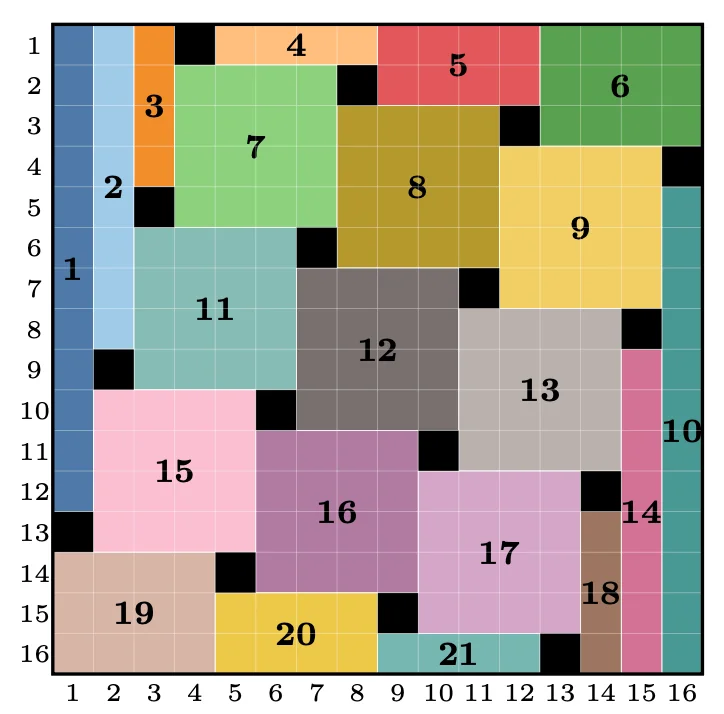
L'ottimale disposizione di 21 quadrati rettangolari per il problema Matilda 16×16. I quadrati neri sono vuoti, mentre le aree di colori diversi rappresentano piastrelle rettangolari.
Questo dimostra la capacità di iterazione continua dell’Agent in compiti matematici complessi:L'esperienza storica non è più solo un record di ragionamenti statici, ma può essere integrata con nuovi feedback di verifica per partecipare continuamente all'adattamento delle strategie di risoluzione successive.
Partendo dalla memoria, verso un Agent in continua evoluzione
MemoraX AI è stato fondato da Hao Jianye, ex direttore del Laboratorio di Decisione e Ragionamento di Huawei, direttore del Laboratorio di Algoritmi per Grandi Modelli e principale esperto nel campo delle decisioni intelligenti. Si concentra sullo sviluppo di modelli di memoria per agenti che siano capaci di apprendere e evolversi nel prossimo futuro.
Il modello di memoria sviluppato autonomamente dal team, basato sulla tecnologia Agentic RL, ha vinto il primo posto nella classifica mondiale dei modelli di memoria più autorevoli ed è stato ampiamente riportato e seguito da media nazionali e internazionali come il MIT Technology Review. La soluzione di memoria del team è stata applicata in modo diffuso in aziende leader dei settori della programmazione, sanità, finanza, sicurezza, smart home, ed è partner strategico di Huawei Cloud/Tencent Cloud.
Oggi, il team sta approfondendo ulteriormente il RSI basato su modelli di memoria, permettendo agli Agent di passare dall'accumulo e dal riutilizzo dell'esperienza all'apprendimento continuo e all'auto-evoluzione, rafforzando così il proprio vantaggio leader nel campo della memoria artificiale. Allo stesso tempo, si sta accelerando l'integrazione di tali tecnologie in diversi scenari, promuovendo lo sviluppo standardizzato dei moduli di memoria per prodotti destinati al settore B2B e al mercato consumer (B2C), nonché la loro commercializzazione su larga scala.
Conclusione
La chiave dell'Agent RSI non consiste solo nel far sì che l'AI si comporti meglio in un singolo compito, ma anche nel...Fare in modo che ogni esecuzione diventi la base per il miglioramento delle proprie capacità.I metodi di successo, le esperienze di fallimento e le condizioni di applicabilità vengono accumulati attraverso la memoria a lungo termine e trasformati in linee guida azionali riutilizzabili per nuovi compiti; i nuovi risultati dell’esecuzione, a loro volta, stimolano l’aggiornamento delle esperienze, l’ottimizzazione delle strategie di memorizzazione e l’apprendimento continuo del modello di base della memoria.
Quello che MemoraX sta esplorando è...Un percorso di evoluzione bidirezionale in cui la memoria e il miglioramento dell'agente stesso si promuovono a vicendaDa un lato, permettere alla memoria di fornire una base di esperienza continua e trasferibile tra compiti per l'Agent RSI; dall'altro lato, far sì che l'esecuzione e i feedback nei compiti reali alimentino costantemente l'apprendimento e l'evoluzione della memoria stessa.
Quando ogni compito lascia alle spalle esperienza e ogni feedback contribuisce al miglioramento, le capacità dell'Agent non sono più limitate all'esecuzione singola, ma hanno l'opportunità di diventare un processo di accumulo continuo e di auto-evoluzione.
L'articolo proviene da "Machine Heart", scritto da "Machine Heart".
Link dell’articolo:https://www.airai.cc/it/ai-news/54/
有用吗?